 Epoch AIby Epoch AI · 推文AI评分:50/100
GPT-5.6 Sol 玩《杀戮尖塔》:策略是主要短板
过去几周,我们非正式测试了 GPT-5.6 Sol 的计算机使用能力,让它玩《杀戮尖塔》。发现其限制不在操作,而在战术与策略,表现优于新手但低于专家。
 Epoch AIby Epoch AI · 推文AI评分:50/100
过去几周,我们非正式测试了 GPT-5.6 Sol 的计算机使用能力,让它玩《杀戮尖塔》。发现其限制不在操作,而在战术与策略,表现优于新手但低于专家。
 Artificial Analysisby Artificial Analysis · 推文AI评分:70/100
Artificial Analysis 通过 NVIDIA 提供的私有演示端点,对 Groq 3 LPX 推理机架进行了基准测试。在 10k 和 100k 输入序列长度下,Gemma 4 31B 的中位输出速度约为 3400 tokens/s,创下该模型在 100k 上下文下的最高记录。NVIDIA 宣布该机架已全面投产,将于今年晚些时候投入运营。
 NVIDIA AIby NVIDIA AI · 推文AI评分:50/100
Nemotron 3.5 Lightning 在 Pinchbench 开源模型评测中排名前四,在标准化 OpenClaw 智能体测试中平均成功率达 86.4%。Nemotron 3 Ultra 仍保持第一。
 Artificial Analysisby Artificial Analysis · 推文AI评分:50/100
现在可以用 Optima 对 Qwen3.8 27B 进行基准测试,查看这款可在笔记本上运行的模型在性能、成本和速度上的表现。同时为需要构建基准测试的企业提供积分和免费咨询。
 Artificial Analysisby Artificial Analysis · 推文AI评分:70/100
Artificial Analysis 与 Liquid AI 合作,推出针对手机端小模型的智能与推理性能评测,覆盖 iPhone 17 Pro 和 Galaxy S26 Ultra 上的多款 4-bit 或更低精度模型。评测结合智能评估与推理性能,提供端到端生成时间、输出速度、峰值内存等指标。初步结果显示,Nanbeige4.2-3B 和 LFM2.5-2.6B 在 16K 上下文限制下并列智能得分第一,但 LFM2.5-2.6B 效率更高。评测应用 Pipette 已免费开放下载。

 OpenRouterby OpenRouter · 推文AI评分:50/100
新的视觉基准测试,用于评估图像模型在多种挑战性提示下的表现。

 Clément Delangueby Clément Delangue · 推文AI评分:70/100
英伟达自建编码框架优化CUDA GPU内核,在ARC-AGI-3的25个公开游戏中取得100%得分,解决全部183个关卡。随着智能体发展,我们将从难以运行、优化、后训练自己的AI模型和内核的世界,迈向几乎人人都能做的世界。何时能有一亿AI构建者?

 Jerry Liuby Jerry Liu · 推文AI评分:50/100
在模式引导的复杂文档提取任务中,编码代理(如Claude Code和Codex)在长文档上展现出良好的成本/准确率平衡。短文档上,专用OCR工具成本更低且准确率相当或更高;长文档上,编码代理更接近帕累托最优。该结果来自ParseBench论文附录D。

 Elon Muskby Elon Musk · 推文AI评分:50/100
Grok 4.6 在超高思考模式下于 CursorBench 基准测试中取得第一名的成绩。
Artificial Analysisby Artificial Analysis · 推文AI评分:70/100Artificial Analysis 发布了针对 Wisedocs 的 MLCR(医疗长上下文推理)基准的排行榜 MLCR-AA,测试模型在长医疗案例文件上的推理能力。排行榜使用最难的保留问题集,Claude Fable 5 以 64.4% 的得分领先,Kimi K3 是领先的开源模型。结果显示,当前模型在医疗记录审查中部分可行,但成本高且完整性不足。
 Artificial Analysisby Artificial Analysis · 推文AI评分:70/100
Hugging Face 发布了语音智能体竞技场,用于在真实世界场景中评估语音到语音模型。该竞技场通过人类参与者与模型进行实时对话,比较模型的对话偏好和任务成功率。初步结果显示,Gemini 3.1 Flash 在偏好上领先,而 Grok Voice 在任务成功率上最高。该平台旨在提供更贴近实际使用的评估,并计划扩展更多模型和场景。
 NVIDIA AIby NVIDIA AI · 推文AI评分:70/100
NVIDIA 的通用编码智能体 AVO 在 ARC-AGI-3 交互推理基准上获得 100% 分数,完成了全部 25 个公共环境中的 183 个关卡,无需指令、明确规则或既定目标即可自主理解任务。
 Artificial Analysisby Artificial Analysis · 推文AI评分:50/100
在旧金山的 Inference, Measured 活动中,我们发布了端点准确率指数,通过自托管权重作为参考,对多个提供商的端点进行相同评估,得分从73%到100%不等。量化、KV缓存压缩和上下文限制都会影响质量,即使定价页未显示。


 Meta AIby Meta AI · 推文AI评分:70/100
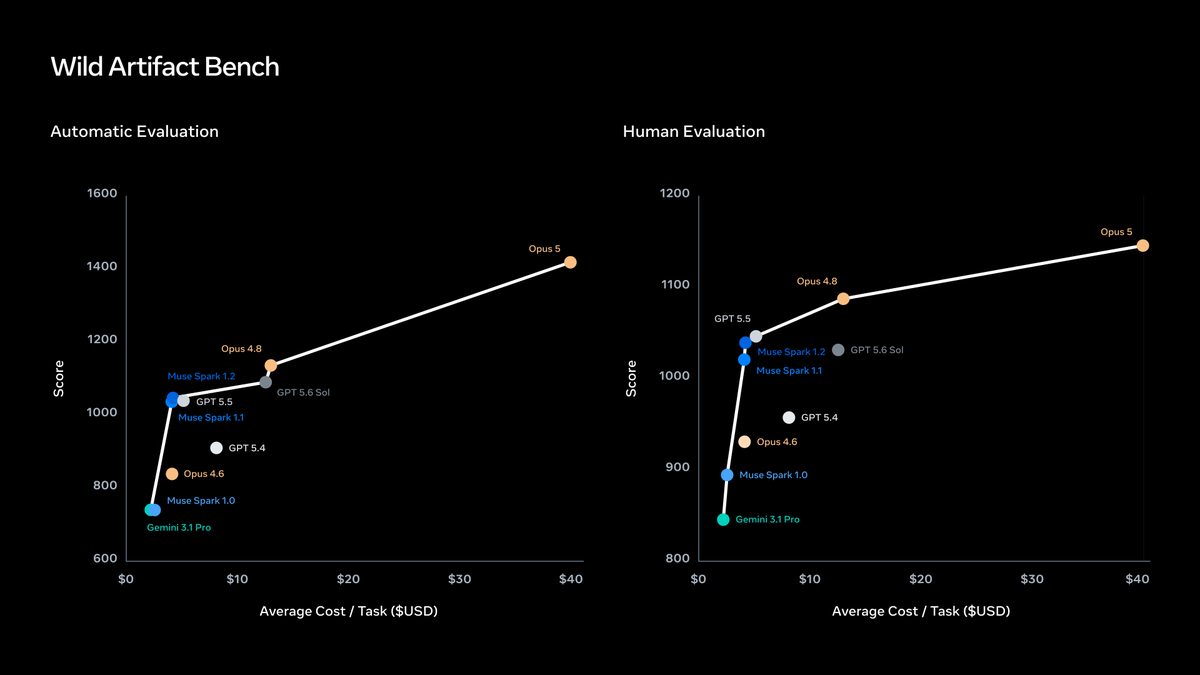
Meta 今日预览 WildArtifactBench,一个内部评估框架,用于评估多模态智能体在复杂真实任务中的表现。它采用胜率和 Elo 评分,由人类和智能体偏好裁判评判,而非严格的标准答案,从而扩展了实际多模态工作流的任务覆盖。Meta 已发布其中 10 个任务。
 NVIDIA AIby NVIDIA AI · 推文AI评分:70/100
NVIDIA cuOpt 在 Hans Mittelmann 基准测试的三个优化问题类别中被评为最快的开源求解器。

