WorldArena 2.0 挑战赛开赛:JEPA 路线在机器人世界模型评测中领先
IROS 2026 期间,WorldArena 2.0 挑战赛正式开启,聚焦评估世界模型能否被机器人真正应用。视启未来与晨昏线分别在 Track 1 和 Track 2 取得领先,标志着世界模型竞争从单纯的生成能力转向实际落地效能。


IROS 2026 期间,WorldArena 2.0 挑战赛正式开启,聚焦评估世界模型能否被机器人真正应用。视启未来与晨昏线分别在 Track 1 和 Track 2 取得领先,标志着世界模型竞争从单纯的生成能力转向实际落地效能。
联想天禧AI自主研发的代码智能体框架TianxiCode在SWE-bench-Live基准测试中取得71%的问题解决率,登顶全球第一名。


PaperBenchX基准测试显示,尽管ChatGPT能解决部分千禧年数学难题,但其生成的论文复现率低至13.98%,揭示了当前AI在科研能力上的局限性。
彭博行业研究指出,随着 DeepSeek 发布 V4.1 Flash,中国顶尖 AI 模型在 LiveBench 基准测试中与美国竞争对手的性能差距已缩小至 3%,创历史新低。此前该差距为 9% 至 15%。报告认为,得益于对国产硬件的优化及专业能力深化,中国模型正扩大市场份额,引发对美国 AI 科技主导地位长期性的质疑。

独立AI影视公司Utopai Studios的定制视频生成模型Utopai X在Artificial Analysis的全球文生视频排行榜中排名升至第二,位列全美第一。该榜单采用盲评机制,由观众对同一提示词生成的视频进行偏好评价,这是首次有影视公司定制模型取得如此佳绩。
作者 Rhea 对 GPT-6 Astra、Claude Fable 5.1 和 Sol 三个模型进行了真实云台机械臂的对比测试。虽然三个模型都能让机器转动,但在“完成”任务的标准上存在显著差异,揭示了不同模型在具身智能控制能力上的实际表现差距。

作者吴海明对比了 Seedance 2.5 与可灵 3.0 两款 AI 视频生成工具。文章指出两者的差距不仅在于画质,更体现在工作流效率上,探讨了降低影像生产门槛对创作者的影响。

Epoch AI 发布家具组装基准测试(FAB),评估多模态 AI 结合说明书与照片识别装配错误的能力。OpenAI GPT-6 Astra 在该测试中准确率达 80%,较此前提升近三倍,展现了强大的视觉与空间推理能力。


OpenAI 推出 MentalHealthBench,这是一个包含 1215 段合成心理健康对话的开放式基准测试。该数据集由来自 22 个国家和地区的 80 多名持证心理学家参与制定,覆盖 19 种语言和近 20 个专业领域,旨在评估 AI 系统在从日常话题到紧急事件等不同场景下的应对能力。此举旨在填补现有评估多集中于紧急情况的空白,并邀请研究人员进行独立审查与进一步研究。


Saturn研究测试ChatGPT、Claude等18种AI模型,发现其在回答财务问题时平均57%存在计算错误或幻觉。付费及推理模式表现更优但仍有缺陷,依赖AI处理税务可能引发经济损失。
OceanBase团队提交的Data Agent方案在国际数据智能体基准测试Data Agent Benchmark中登顶。


OceanBase团队基于国产大模型GLM-5.2构建的Data Agent方案Scout,在国际数据智能体基准DAB中以90.62%的准确率位列第一,成为首个突破90%的方案。该评测由UC Berkeley EPIC Data Lab推出,覆盖多领域及多种数据库。OceanBase方案超越了多项基于GPT、Claude Opus等海外模型的参评方案,相关能力将融入OceanBase DataPilot产品。

9月20日,B站宣布上线「AI无限竞技场」大模型测评榜。该榜单汇集UP主对上百个大模型的真实场景实测,涵盖代码、推理等主题,不设固定维度限制,排名实时更新。首轮测评中,GPT-6 Astra在10位UP主测试中拿下榜首,打败GLM-5.3;前5名中国产大模型占据3席,包括DeepSeek、Kimi、千问等主流模型均参与对比。
MLCommons 发布 MLPerf Inference v6.1,重点考察 AI 推理吞吐、扩展效率与不同 GPU 配置表现。AMD 提交迄今最大规模结果:512 个 Instinct MI355X 在 DeepSeek R1 测试中离线吞吐 290 万 tokens/s、服务器场景 240 万 tokens/s,并称以 575 万 tokens/s 创下新纪录。英伟达同场提交,Vera Rubin 平台首次现身。


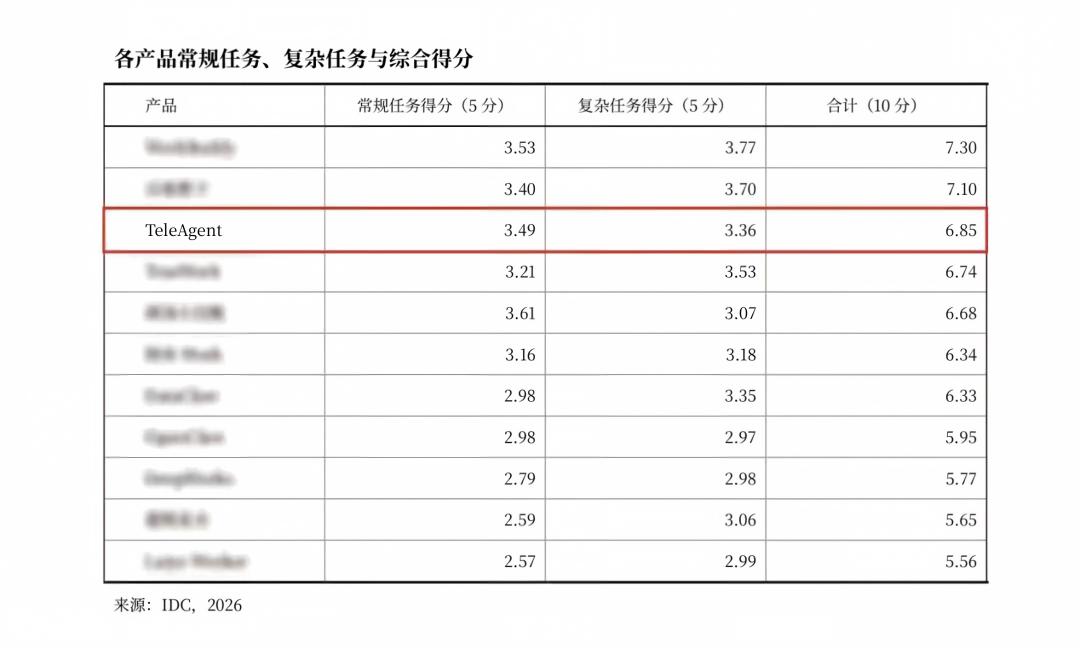
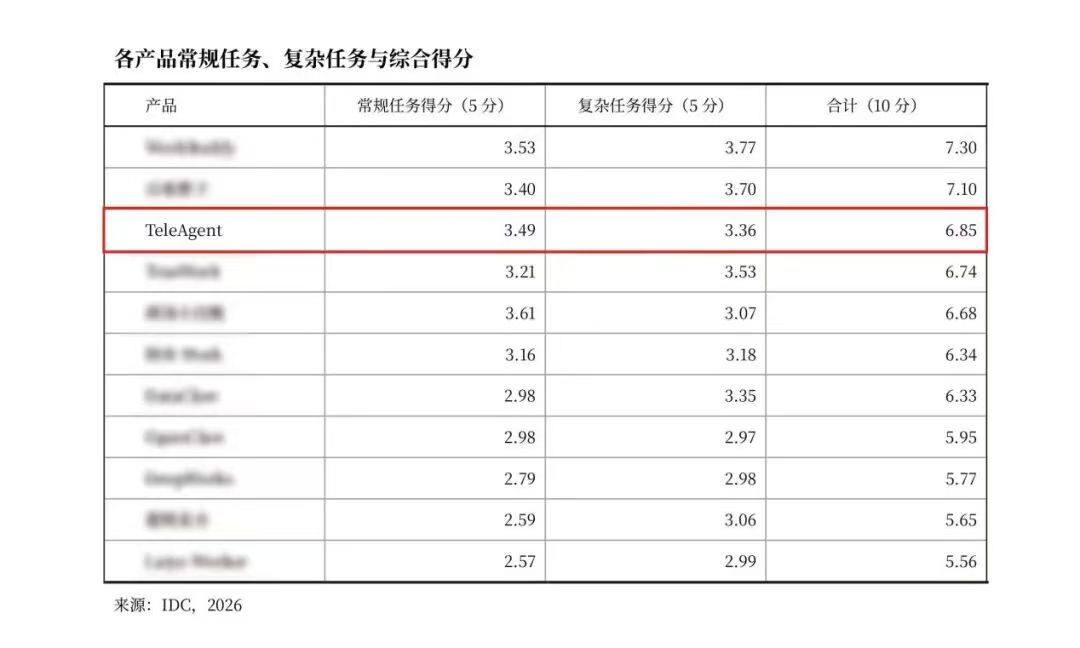
IDC 发布《中国企业级通用 Agent 产品技术评估》报告,在统一仿真环境中从任务表现、成本效率、交互体验、安全可控、生态开放性等九大维度实测国内主流通用智能体,并加入脏数据、权限约束、模糊指令等干扰条件。中国电信星辰超级智能体 TeleAgent 综合得分 6.85 分,成本效率、安全可控、任务表现等维度高于行业普遍水平,Token 消耗优于同类产品,常规办公任务能力进入国内第一梯队。其背后是中国电信在算力、平台、数据、模型、应用上的全栈布局,星辰实验室基于国产算力与框架自研十亿至千亿参数语义大模型并开源,Hugging Face 等社区总下载量已破百万。
9月16日,B站「AI无限竞技场」正式上线,首期大模型测评榜单同步公布。全球百大AI模型同场竞技,GPT-6高居榜首。


IT之家 9 月 15 日消息,网友 u/EcstaticDentist 昨日(9 月 14 日)在 Reddit 社区发帖,在单张超频 RTX 3090 显卡上,耗时约 5 小时,通过 2 套 Harness 方案,调用 Q4KM 量化版 Qwen3.8-27B 模型,成功打造出可玩的第一人称僵尸射击游戏。IT之家曾于 8 月报道,阿里开源 Qwen3.8-27B 模型,较 Qwen3.6-27B,新模型在编程和办公场景的性能大幅提升,表现甚至超越了 Qwen3.7-Plus;同时,模型还新增了 reasoning_effort 功能,根据任务难度控制思考深度,更省资源。该网友表示为了测试 Qwen3.8-27B 模型的性能极限,耗时约 5 小时成功打造出可玩的第一人称僵尸射击游戏。在硬件配置方面,消息源只透露采用单张 RTX 3090 显卡,并使用微星的 MSI Afterburner 工具超频,性能提升约 12%。在模型方面,本次测试的是 Q4KM 量化版本,通常是指 GGUF 格式模型中的一种 4-bit 混合量化档位。


GeekBench AI 平台出现苹果 iPhone 18 Pro(iPhone19,2)跑分记录,搭载 A20 Pro 芯片。Core ML 调用 GPU 得分为 12,775 / 24,077 / 26,951,Neural Engine 为 7,002 / 55,720 / 75,810,单精度 5,144 分,NPU 最高增幅 51.53%。这是端侧 AI 算力架构的实测数据,反映苹果新一代神经引擎性能提升。


Mod 开发者将 FP8 与 NVFP4 混合精度应用于英伟达 DLSS 5 神经渲染模型,在 RTX 50 系列(Blackwell)显卡上测试。结果显示 4K 分辨率下神经渲染阶段耗时仅降低约 1% 至 2%,开发者称改进非常有限;该数据并非整款游戏帧率提升。实验由 OptiScaler-DLSSNR-PreSR-Multipass 项目 0.7.1 版本引入,不支持的模型形状仍回退至 FP8。


蚂蚁集团AI安全实验室的天工Cyber模型与天工Harness在AI安全评测基准CyberGym上以98.5%的漏洞验证成功率位列全球第一。天工Harness融合自研天工Cyber模型及DeepSeek V4 Pro、Qwen 3.8 Max等国产大模型,可完成漏洞分析、PoC构造与结果验证的端到端流程。
Arena平台发布第36周AI大模型盲测排名,国产模型在细分榜单表现亮眼。前端开发榜中,阿里qwen3.8-max-0902首次入榜即位列第4,腾讯hy4-preview、智谱glm-5.3-flash等也首次入榜。AI视频榜中,阿里wan3.0首次入榜即冲进前三。头部格局仍以海外模型为主,但国产模型进步速度值得关注。
中国信通院启动“方升”智能体基准测试任务征集,该基准围绕基础能力、典型场景和复杂综合任务构建分层测试框架,旨在推动智能体测试向综合能力测量、过程分析和问题诊断拓展。现面向社会公开征集测试任务,以完善测试任务、环境和评价方法。
德国科技媒体 ComputerBase 通过首款支持 DLSS 5 的《NBA 2K27》游戏测试发现,开启 DLSS 5 后显卡功耗显著增加,且显卡越强增幅越大。RTX 5090 在 4K 下功耗从 417 瓦升至 561 瓦,增幅 34%;WQHD 下增幅达 66%。RTX 5080 等型号也有类似增长。该测试揭示了 DLSS 5 在提升画质的同时可能带来更高的功耗。


海致科技自研的AtlasGraphRAG在GraphRAG-Bench评测基准的Novel和Medical两大赛道中均获第一名,超越微软MS-GraphRAG和HippoRAG2等国际主流框架。GraphRAG-Bench是学术界首个系统性验证图检索增强生成有效性的基准,涵盖事实检索、复杂推理、上下文摘要和创意生成四大任务。
Arena平台发布2026年第35周AI大模型盲测排行榜,国产模型表现亮眼:GLM-5.3-Flash首次进入代码榜前十,Qwen3.8-Max-0902登顶前端开发榜,Kimi-K3-Max稳居综合榜前十。榜单基于匿名盲测投票,反映用户主观偏好。
OPPO与OpenKG社区联合推出行业首个端侧AI记忆评测基准MobileMem,携手浙江大学等高校共同建设。该基准包含累计百万词元的评测数据集,模拟真实用户长期使用,聚焦端侧AI真实场景与长期个性化需求。
中国信通院公布可信AI大模型基准测试MCP专项结果,StartLux-V1.0-27B-Preview以27B参数量综合排名第二,超越DeepSeek-V4-Flash,进入万亿参数模型能力区间。测试涵盖6类专项任务,参测模型包括DeepSeek-V4-Pro等。
原力灵机在机器人评测基准RoboDojo中登顶,该基准旨在去除机器人演示中的“化妆”成分,测试真实能力。文章指出,尽管机器人运动会和展会展示了各种技能,但具身模型需在全面能力上优秀,才能实现百万小时级别的实际应用。

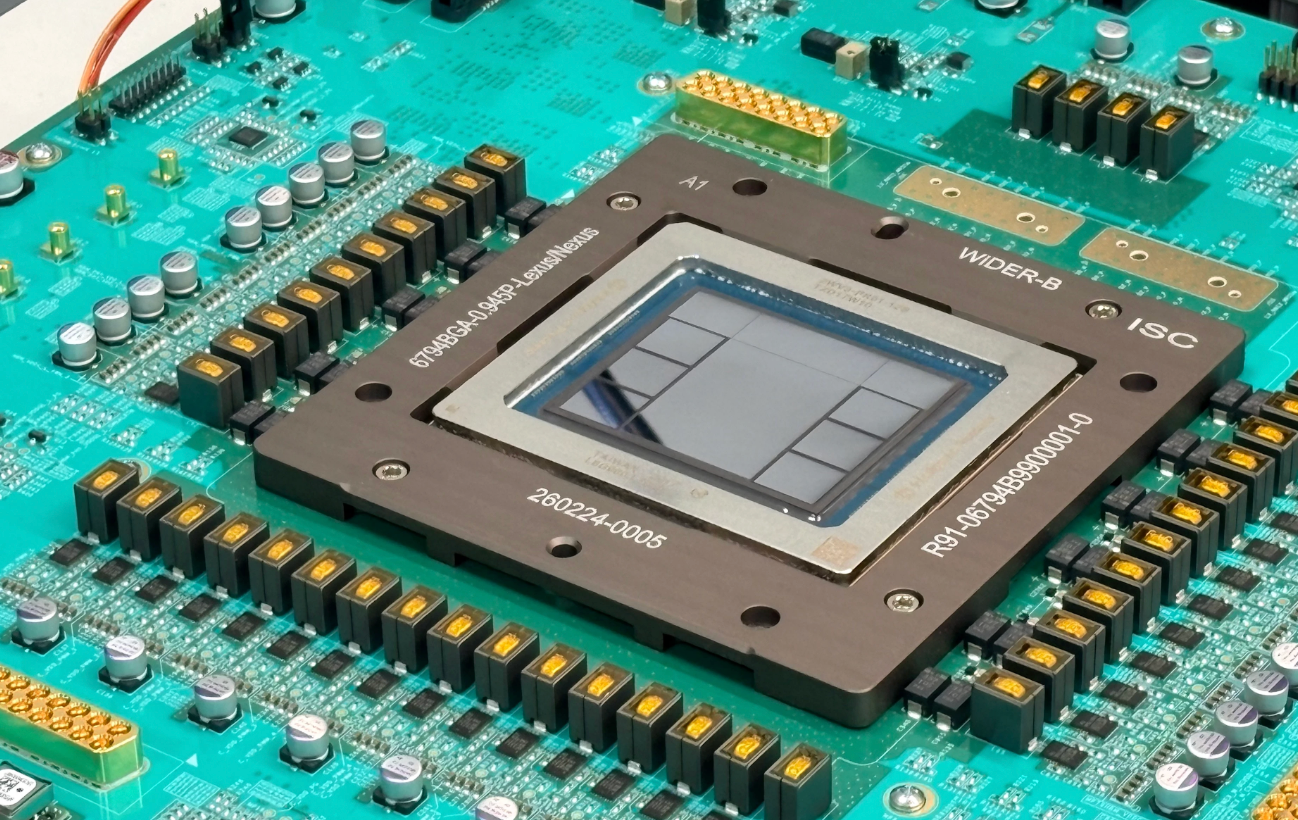
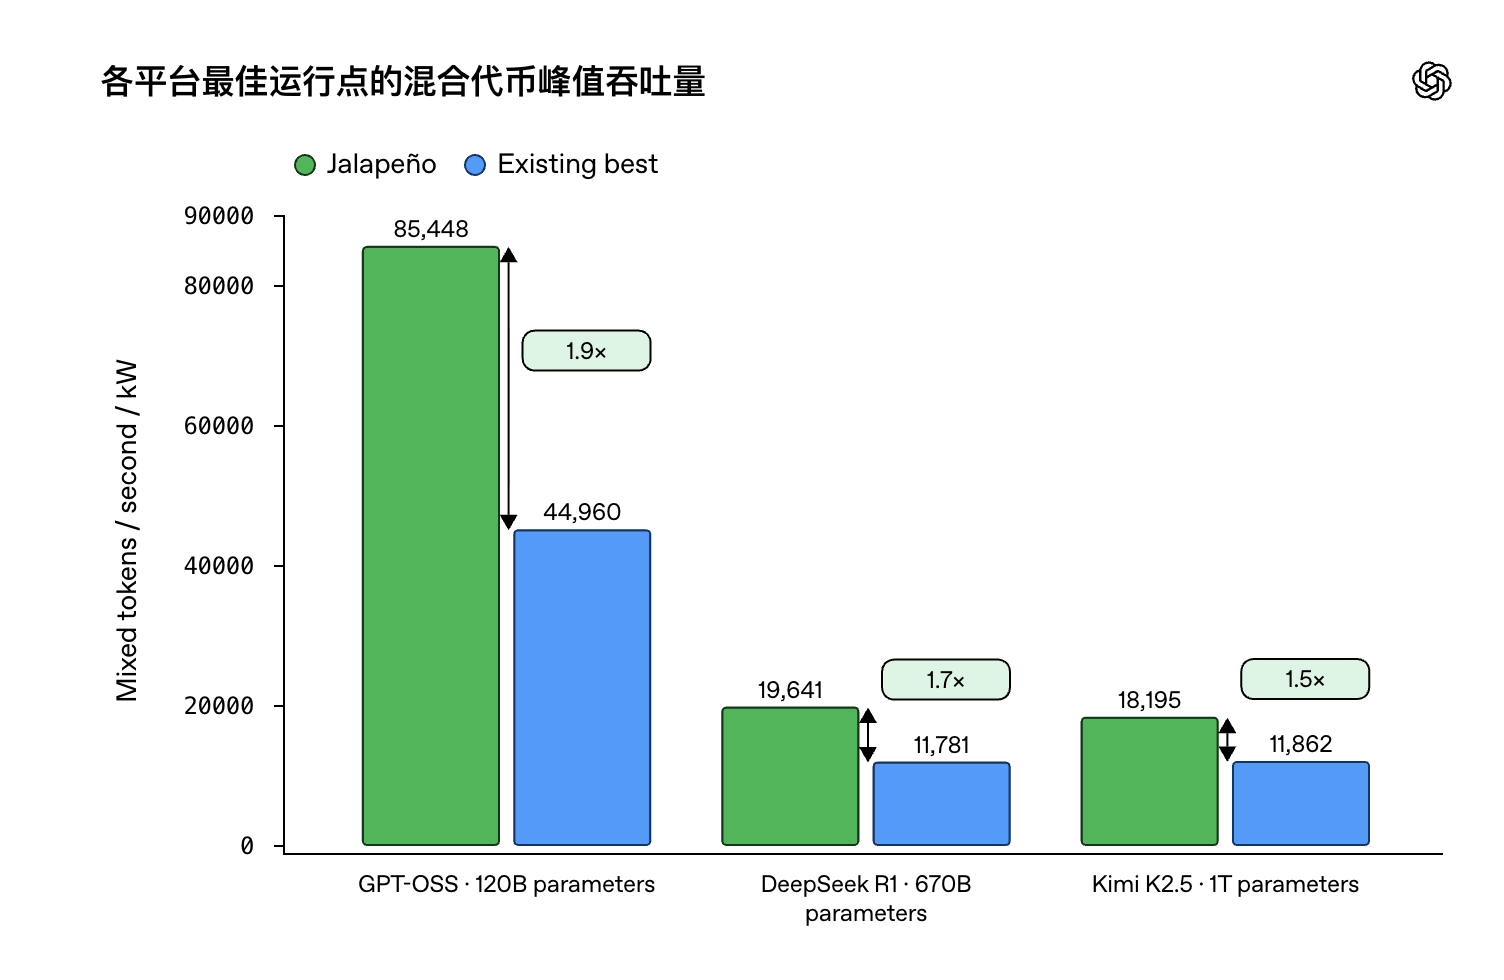
在 Hot Chips 大会上,OpenAI 硬件负责人 Richard Ho 公布了其与博通联合打造的推理芯片 Jalapeño 的首份公开跑分。在 SemiAnalysis 的 InferenceX 基准测试中,该芯片在每用户 token 数和每千瓦吞吐量上均超越英伟达 Blackwell,峰值每瓦吞吐量是后者的 1.5 至 1.9 倍,低延迟场景下优势更大。
昆仑行机器人研发的昆仑世界模型 GeWu 在 WorldArena 2.0 Track 1 评测中,以 69.58 分获图像质量单项冠军,综合得分 65.91 获全球亚军,并在物理一致性、可控性等维度大幅领先,是唯一在 6 大评测维度中 4 项进入前四的模型。
