字节 Seed 团队发现 DeepSeek“抽风”原因,长上下文可能性能漂移
字节 Seed 团队在 arXiv 发表论文,揭示 DeepSeek-V4 系列模型因分块 KV 缓存压缩引入的相位敏感性导致长上下文检索性能周期性波动。研究发现相同信息在不同相位检索准确度相差高达 40 个百分点,解释了平均基准分数掩盖的系统性不对称弱点。


字节 Seed 团队在 arXiv 发表论文,揭示 DeepSeek-V4 系列模型因分块 KV 缓存压缩引入的相位敏感性导致长上下文检索性能周期性波动。研究发现相同信息在不同相位检索准确度相差高达 40 个百分点,解释了平均基准分数掩盖的系统性不对称弱点。
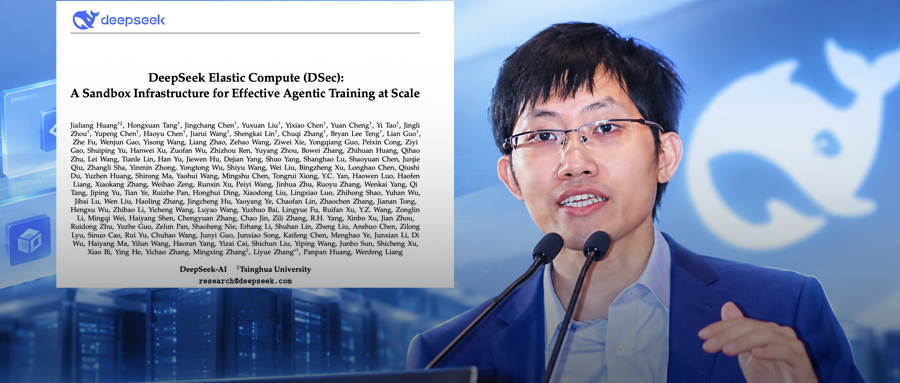
DeepSeek创始人梁文锋署名的最新论文公开,详细披露了Agent训练沙盒平台DSec的技术架构。该平台支撑了从V3.2到V4.1的RL训练,具备单日服务300万沙盒、峰值并发超38万及秒级创建能力,为大规模智能体训练提供基础设施保障。
宁波大学王宏伟联合宁波东方理工大学李润伟、中科院宁波材料所何日等,以双层氮化硼为模型,用第一性原理计算结合AI深度势能分子动力学模拟追踪百万原子飞秒级运动,再沿单一方向施加单轴应变打破三重旋转对称性,首次实现原子层厚度滑移铁电体的精准定向滑移,成果发表于《物理评论快报》。


Meta 的研究发现,对字节跳动模型进行知识蒸馏后,学生模型的能力上限被打破,突破了以往蒸馏中教师模型设定的性能天花板。该工作揭示了蒸馏过程中能力迁移的新机制,为小模型超越教师模型提供了方法参考。


阿尔伯塔大学团队提出 FAME 框架,针对持续强化学习中的灾难性遗忘问题,给出一个可求解的公式化方法。核心思路是把持续学习目标转化为可优化的数学形式,从而在学新任务时保留旧任务能力,缓解「学新忘旧」。


苹果研究人员以预印本形式发布蛋白质设计模型 SimpleDesign,可端到端联合生成氨基酸序列与三维结构,省去传统多阶段流程中的自编码器与离散潜在表示转换。模型直接在序列和连续三维坐标上训练,使用超 200 万组序列-结构配对数据(主要来自 AFESM 数据集),训练时随机遮盖序列并给结构加噪。该工作延续 SimpleFold 的简化思路,把流匹配架构从结构预测扩展到蛋白质设计。


斯坦福吴佳俊团队提出一种基于物理的多模态融合思路:视觉、听觉、触觉三种数据本质上是同一组物理属性在不同感官通道上的投影,因此可以借助物理规律而非单纯堆叠 Transformer 结构来实现跨模态对齐与融合。该工作将在 ECCV 2026 上报告,为多模态表征学习提供了新的归纳偏置视角。

国际研究团队提出将大语言模型视为“认知病毒”的理论框架,认为其通过文化传播扩散,可能导致人类将思考外包给外部工具,削弱自主思考能力,形成恶性循环。该论文尚未经同行评审,旨在解释人们对AI依赖加深的现象及其社会影响。

研究用模拟孕期持续高雌激素的小鼠模型发现,高雌激素会造成可逆的记忆损伤,但不影响情绪与探索动机,属特异性认知效应。机制上,外侧下丘脑以GABA能神经元上的雌激素受体为主,高雌激素抑制其GABA-A受体信号,使自发放电频率升高;敲除这些受体可恢复高雌激素及孕期引起的记忆损伤。环路追踪显示这些过度活跃神经元直接投射到海马CA3区,化学遗传学实验进一步验证该下丘脑-海马环路是记忆受损的关键通路,为「孕傻」提供了机制解释。
腾讯混元、清华和南洋理工联合提出Spatial-TTT方法,为2B小模型引入流式空间记忆,解决空间智能中长序列处理时的算力与记忆断裂问题。在空间基准测试中,该方法超越了GPT-5,展示了小模型通过高效记忆机制也能达到顶尖空间推理能力。

IJCAI 2026 论文提出 S²-VLA,引入信念状态和自适应动态门控,仅用 2B 参数、7GB 显存,在长程操控任务上超越 7B 模型,解决了机械臂长程任务中错误累积的问题。

研究人员开发了深度学习模型PathStAR,分析2.5万余张活检图像,发现人体组织衰老存在三种模式:早期衰老型(如血管)、晚期衰老型(如子宫)和双相衰老型(如卵巢,在35-40岁和55-60岁加速)。衰老加速期伴随炎症基因上调及能量代谢基因下调。
纽娲机器人、上海交通大学和山东大学的研究者提出 Video2DoorTraversal 框架,利用单段 RGB 视频重建门的数字孪生 DoorTwin,在仿真中生成并筛选轨迹,训练轮足移动操作机器人完成接近、开门和穿越任务。在五扇门上的 175 次测试中,平均成功率达 96.57%,并验证了对未见过的相似门的泛化能力。

 Gorden Sunby Gorden Sun · 推文AI评分:70/100
Google 团队发布了 GlucoFM,一个针对连续血糖监测(CGM)数据的基础模型。该模型利用超过 10 万小时无标注的真实血糖数据进行训练,能够将血糖走势分解为基础水平和突发波动两个信号。在预测糖尿病风险、胰岛素抵抗等 7 种代谢健康问题上,其准确度优于现有模型;还能根据餐前血糖和饮食信息预测餐后血糖,且在小样本和跨机构场景下具有较好的适应性。模型目前未开源。

清华大学与香港科技大学提出LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法采用因果、分块的方式处理持续输入的视频,在4步/视频块的推理条件下实现12.66 FPS的流式编辑,同时保持编辑区域准确性和未编辑区域一致性,解决了高质量视频扩散模型依赖双向时空注意力导致的高延迟问题。

该研究提出将动作生成从输出端移至调度端,在不降低精度的前提下将VLA模型推理速度提升1.79倍,为具身智能机器人的实时响应提供了新方案。

纽约大学阿布扎比分校等机构在ACL 2026 Findings发表论文,构建了首个多语言医疗错误检测基准MedErrBench,覆盖英、中、阿三语,测试GPT-4o、DeepSeek等模型。结果发现:医疗专用模型表现不如通用模型,且英文原生模型在中文数据上表现更好。研究强调推理能力比领域知识更关键,并计划用Agentic AI提升效果。

美图影像研究院提出BridgeRemoval框架,首次将视频目标移除定义为视频到视频的翻译任务,采用随机桥模型直接从源视频先验生成目标,避免扩散模型丢弃结构先验的问题。该方法在DAVIS和BridgeRemoval-Bench数据集上取得最优PSNR,并已落地于美图秀秀、Wink和开拍APP。论文被ICML 2026录用。


中国人民大学高瓴人工智能学院与至知创新研究院团队提出ClawGym II,一个面向复杂Agent Harness的黑盒强化学习框架。该框架无需修改Claude Code、OpenClaw等Harness内部实现,即可让模型通过真实执行过程进行强化学习,并支持多个异构Harness联合训练同一策略模型。实验表明,黑盒RL能稳定提升模型Agent能力,且共享策略模型可同时从多个Harness中学习。

