精选Google Research Blog论文
迈向可证明隐私的联邦数据学习
该研究针对联邦学习场景,旨在解决数据隐私保护问题。文章提出了一个理论框架,致力于在分布式数据训练过程中提供可证明的隐私保证,探索如何在利用多方数据的同时确保个体数据的不可追溯性。
我们宣布推出一种全新的联邦学习系统,该系统在将计算任务转移至服务器以提升训练速度、准确性和设备覆盖范围的同时,提供了可外部验证的隐私保障。
快速链接
- 论文
- 分享 复制链接 ×
2017年,谷歌推出了联邦学习(FL),这是一种在去中心化、私密数据上训练模型的机器学习技术。它已被用于支持日常实用功能,包括 Gboard 上的下一词预测和智能撰写、Google 信息中的回复建议以及 Android 上的智能文本选择。
我们的联邦学习系统开发遵循四项核心隐私原则:(1) 数据最小化,(2) 数据匿名化,(3) 透明度与控制权,以及 (4) 可验证性与可审计性。多年来对匿名化的研究与发展,通过矩阵分解差分隐私(MF-DP-FTRL)算法以及结合安全聚合的分布式差分隐私等技术,为生产模型带来了强有力的差分隐私(DP)保障。2025年,我们引入了一种基于这四项原则的进化版联邦学习定义:
联邦学习(FL)是一种机器学习场景,其中多个实体(客户端)在服务提供商的协调下协作解决机器学习问题。一个完整的联邦学习系统应使客户端能够完全控制其数据、允许访问其数据的负载集合,以及这些负载的匿名化属性。联邦学习系统应为其数据由联邦学习客户端管理的用户提供适当的透明度和控制权。
在《迈向从联邦数据中进行可证明隐私保护的学习》一文中,我们宣布了下一代联邦学习系统的发布,该系统利用可信执行环境(TEEs)提供完全可验证且可审计的数据匿名化保障。在 TEEs 中运行的逻辑是远程可证明的(第三方可以验证正在执行的逻辑),并且它还具备机密性(其内部状态无法被观察)和完整性(逻辑不会被破坏),尽管受到当前一代 TEE 限制的影响。我们新的基于 TEE 的联邦学习系统建立在 TEEs 在单机层面提供的这些特性之上,构建了一个完全可验证的端到端联邦学习系统,实现了更强的隐私保障和更高的准确性。Gboard 已经采用了新系统,并受益于比之前联邦学习系统显著更快的计算时间。
利用单个 TEE 构建可验证私密的联邦学习系统
我们的基于 TEE 的联邦学习系统建立在我们早期关于机密联邦分析和可证明隐私洞察的研究成果所采用的技术基础之上。
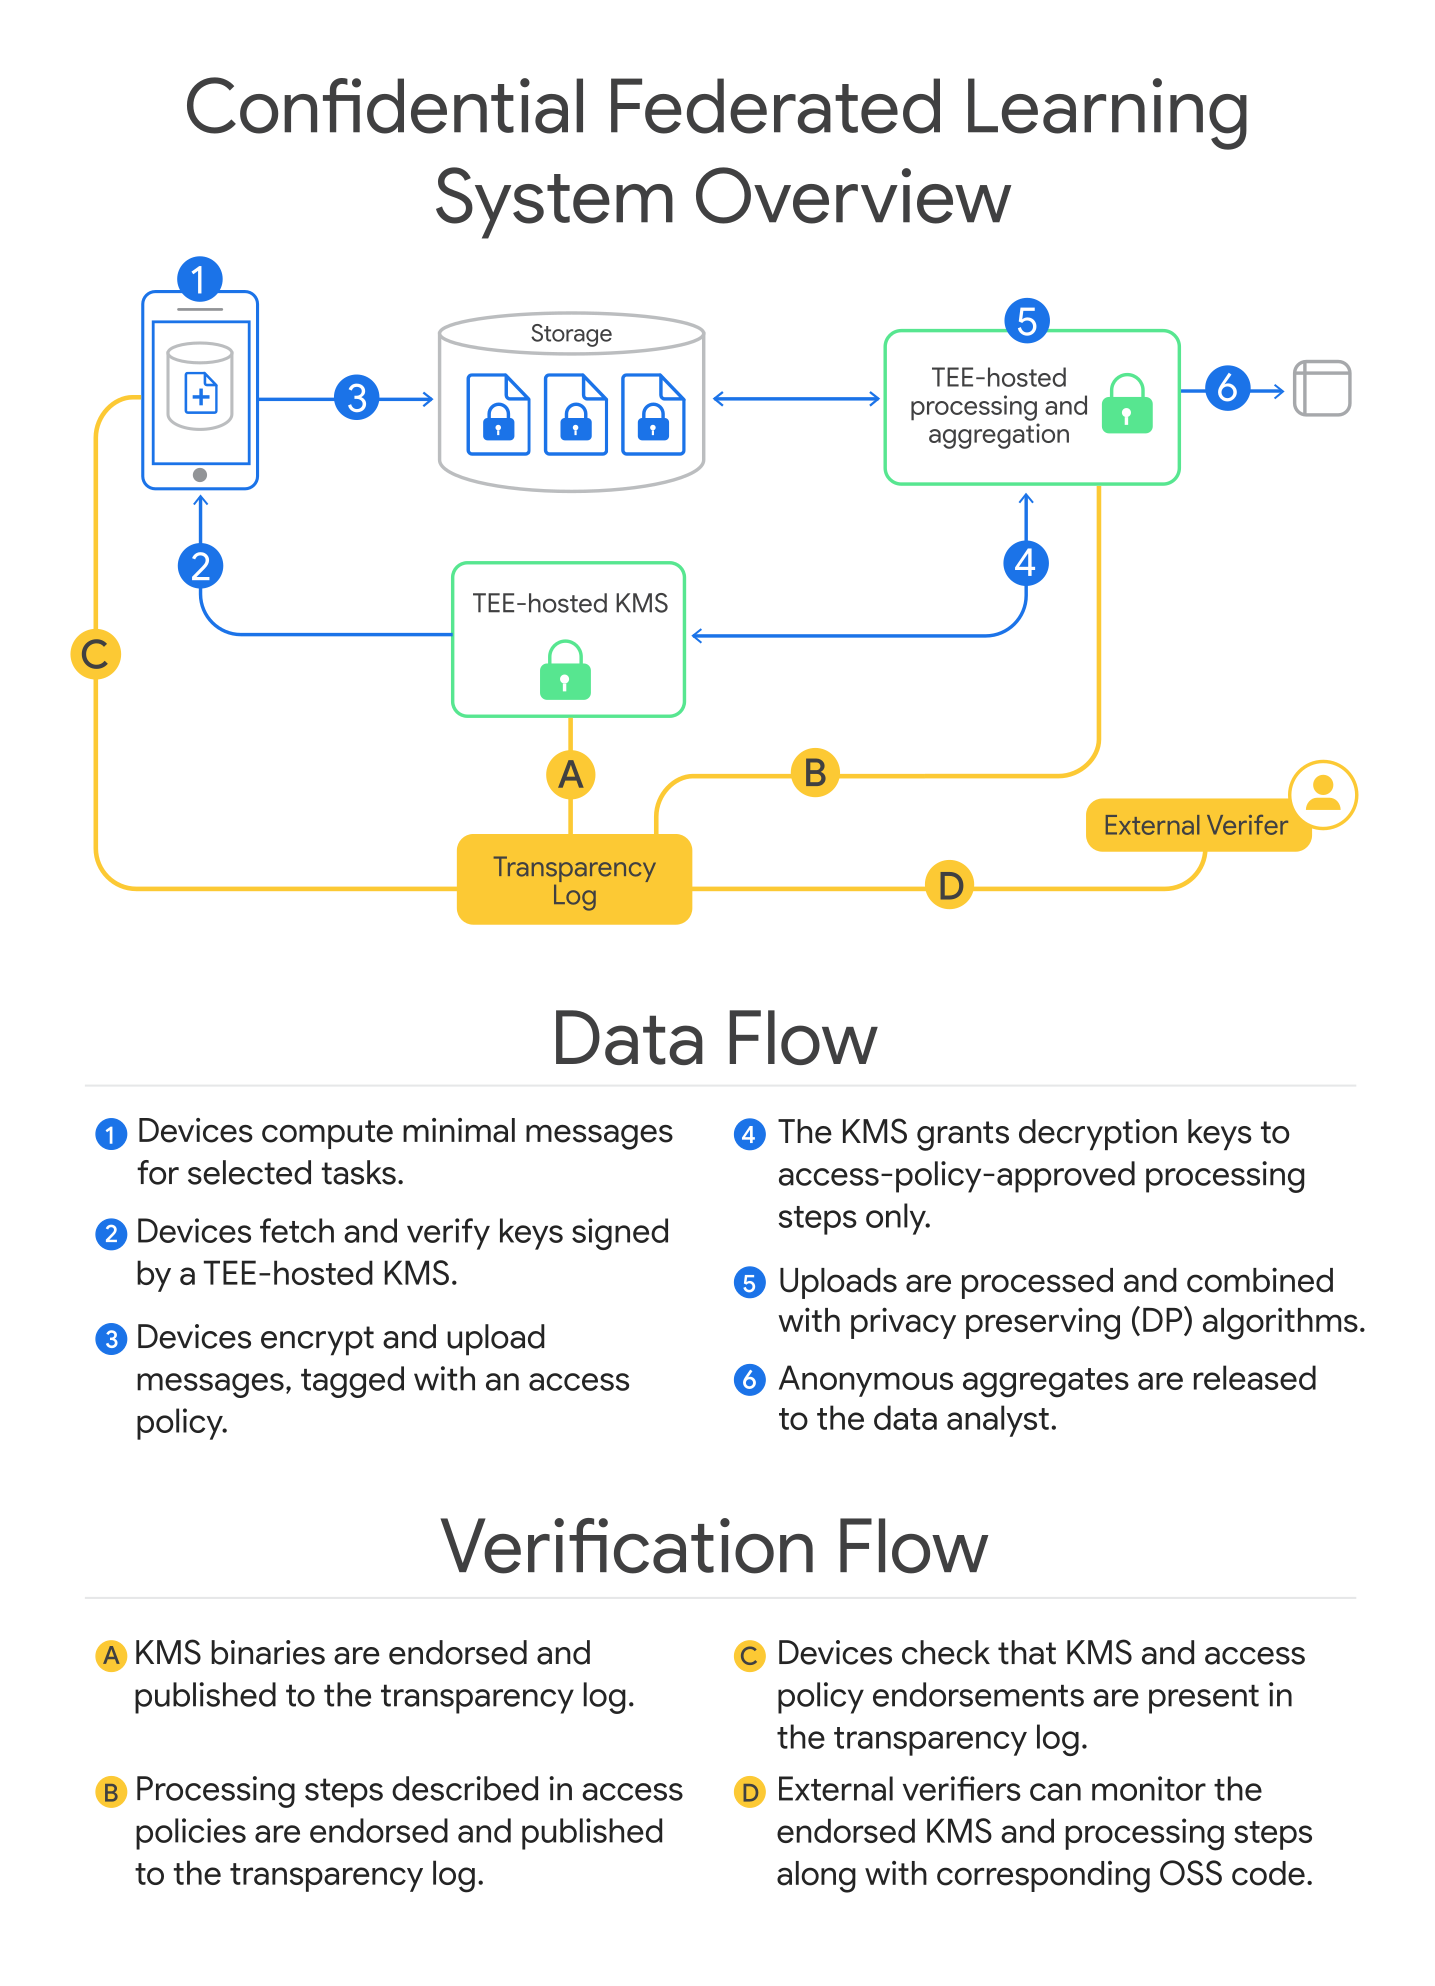
- 数据上传:客户端设备本地加密训练样本并进行上传。设备预先授权访问策略,即允许处理该数据的 TEE 计算集合,这些计算仅释放匿名化结果。客户端要求将访问策略发布到公共透明度日志中。
- KMS 与策略验证:密钥管理系统(KMS)由实施 RAFT 共识协议的 TEE 集群组成,仅向与服务端 TEE 负载匹配的解密密钥,这些负载需符合访问策略中的计算要求。
- 负载执行:数据处理 TEE 执行实现训练循环的 Python 程序。这个“根” TEE 将可并行化的子任务委派给一组工作 TEE 集群。分布式逻辑使用联邦语言(Federated Language)表达,这是一种开源、框架无关的编排语言,源自 TensorFlow Federated,后者曾驱动我们早期的联邦学习系统。训练循环定期向数据分析师发布匿名化的模型权重。
- 容错恢复:Python 程序在每个训练轮次结束时保存经 KMS 加密的恢复状态。这可用于从间歇性的根节点或工作节点故障中恢复,而不会泄露任何额外的隐私敏感信息。
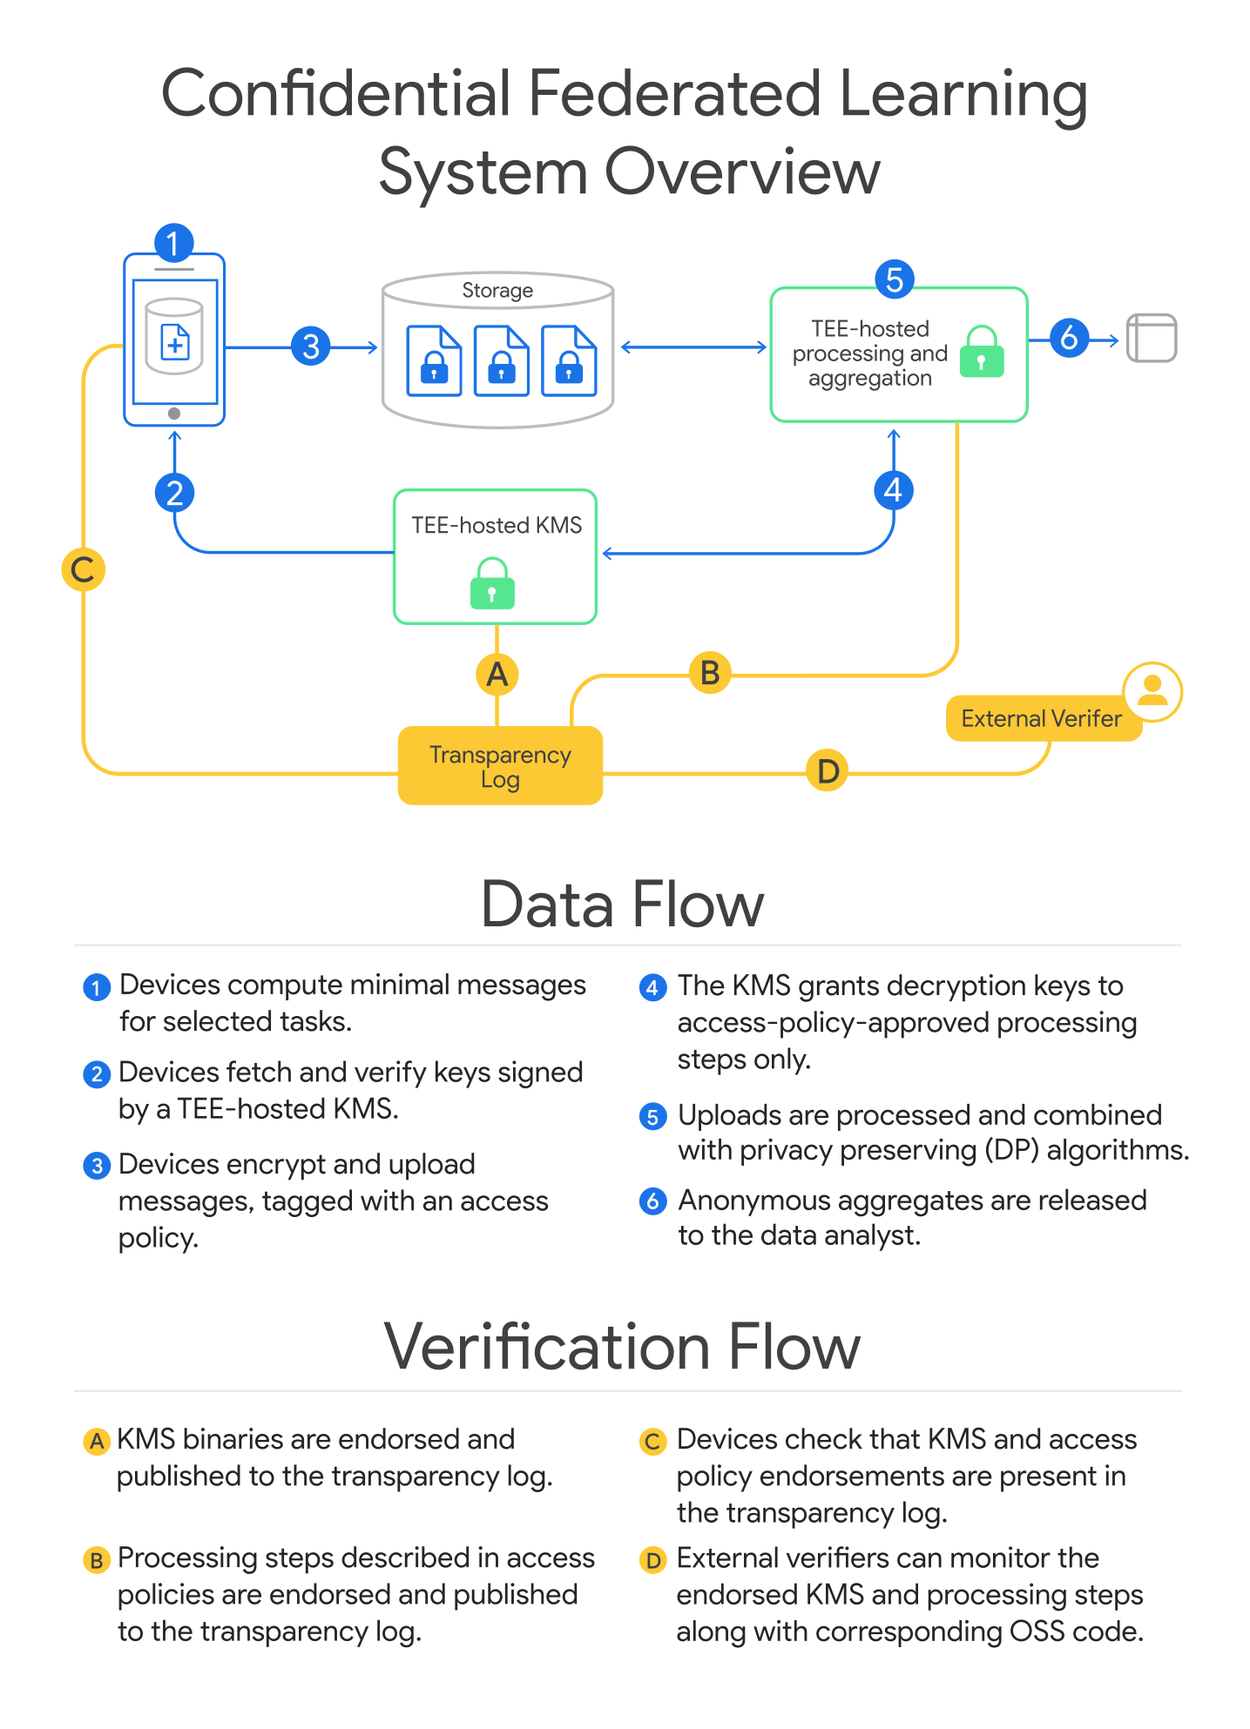
该图展示了数据在系统中的流动过程,以及验证系统上运行的工作负载隐私保证所需的步骤。
有关基于 TEE 的联邦学习(FL)系统设计更多细节,请参阅我们的白皮书《迈向可证明私密的联邦数据学习》。
基于 TEE 的 FL 如何加强隐私保护
在早期的 FL 系统中,设备数据被上传用于即时聚合,但外部观察者无法验证这些数据是否从未被记录或检查。后来,安全聚合(Secure Aggregation)允许通过密码学手段保护上传数据,但它与最先进的中心差分隐私(DP)保证不兼容。我们新的基于 TEE 的系统代表了我们在持续努力中完全消除对服务器运营商信任需求的下一个里程碑。
在我们新的基于 TEE 的 FL 系统中,工作负载操作员只能看到指标和差分隐私模型权重。从设备收集的加密训练数据只能在运行访问策略中表示的 Python 训练程序的 TEE 内解密和处理,且仅在上传后的一段有限时间内有效。
公共透明日志和可重现构建
参与我们新的基于 TEE 的 FL 系统的设备知道可能访问其上传数据的完整服务器工作负载集合。代表这些潜在未来服务器工作负载的访问策略发布到 Rekor(一个公共透明日志),外部审计员能够观察这些日志,以跟踪设备可能参与的完整服务器端工作负载集合。
我们 FL 系统中使用的密钥管理系统(KMS)和数据处理二进制文件可以通过在 Confidential Federated Compute GitHub 仓库中发布的开源代码进行可重现构建。
带有动态侧载的可验证执行
在早期的 FL 系统中,服务器上运行的逻辑既不能被设备也不能被审计员验证,因此我们需要被信任以正确地向梯度总和添加随机噪声,从而提供差分隐私。
在我们新的基于 TEE 的 FL 系统中,发布到 Rekor 的访问策略直接描述了表达 FL 训练逻辑的 Python 程序。为了保护专有模型架构和数据预处理逻辑同时保持可审计性,我们的数据处理 TEE 支持在运行时将序列化信息侧载到 Python 程序中。只要所有与隐私相关的逻辑都硬编码在 Python 程序中,这种侧载功能就允许必须保持专有的逻辑在 TEE 中运行,同时仍提供强大的外部可验证隐私保证(关于侧信道观测的讨论见下文)。
Gboard 如何使用基于 TEE 的 FL
Gboard 已部署此基于 TEE 的 FL 系统,推出了具有更强隐私保证和改进准确性的英语和日语下一个词预测模型。这些改进可归因于新系统设计的几个方面。
缓解昼夜可用性约束
通过在运行服务器端训练工作负载之前收集所有设备上传数据,我们不再需要担心设备可用性的昼夜变化影响训练进度。在服务器端执行时,我们可以在程序内动态计算最优的设备参与计划,并利用它来调整其他 DP 参数。
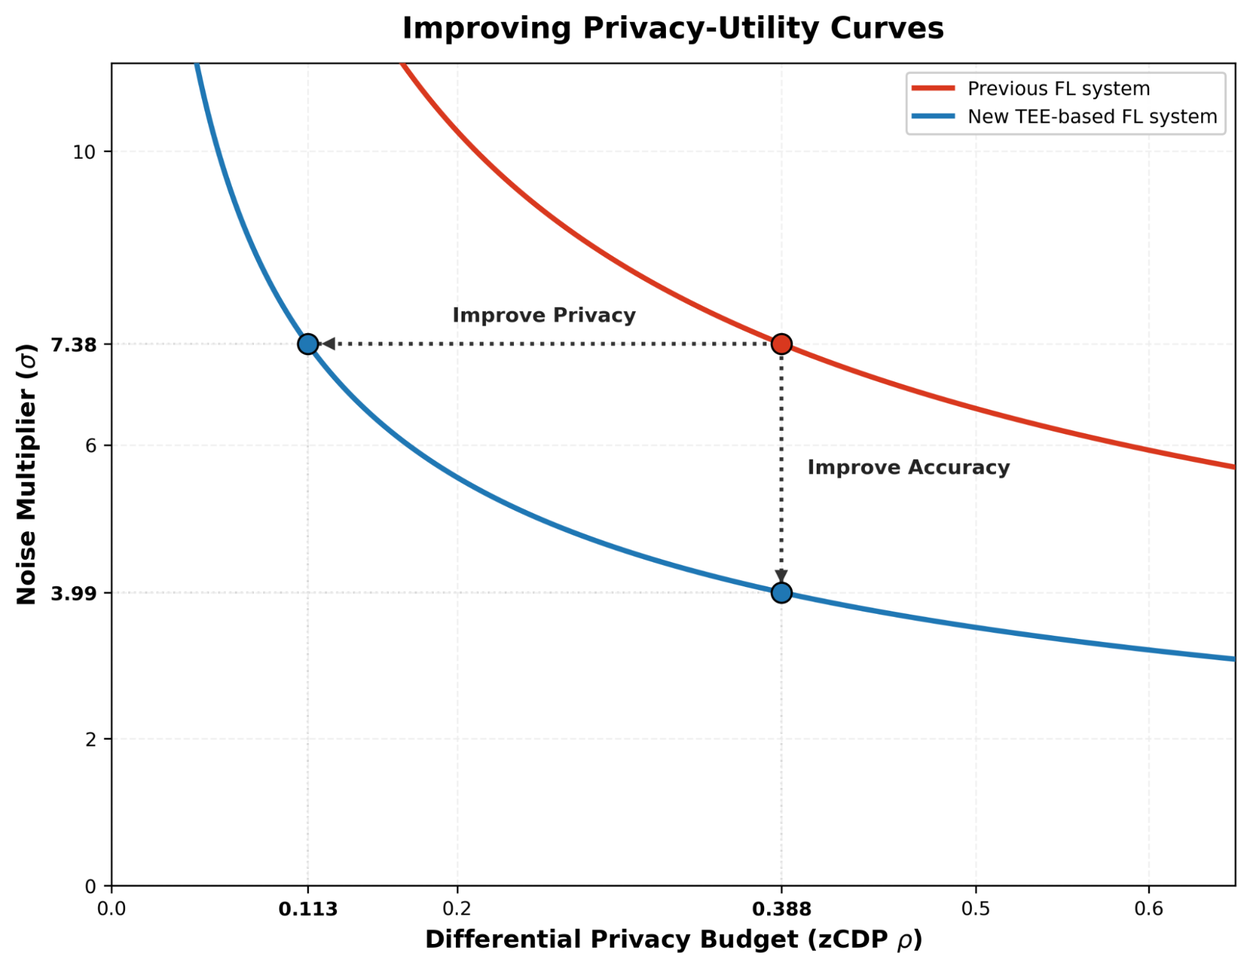
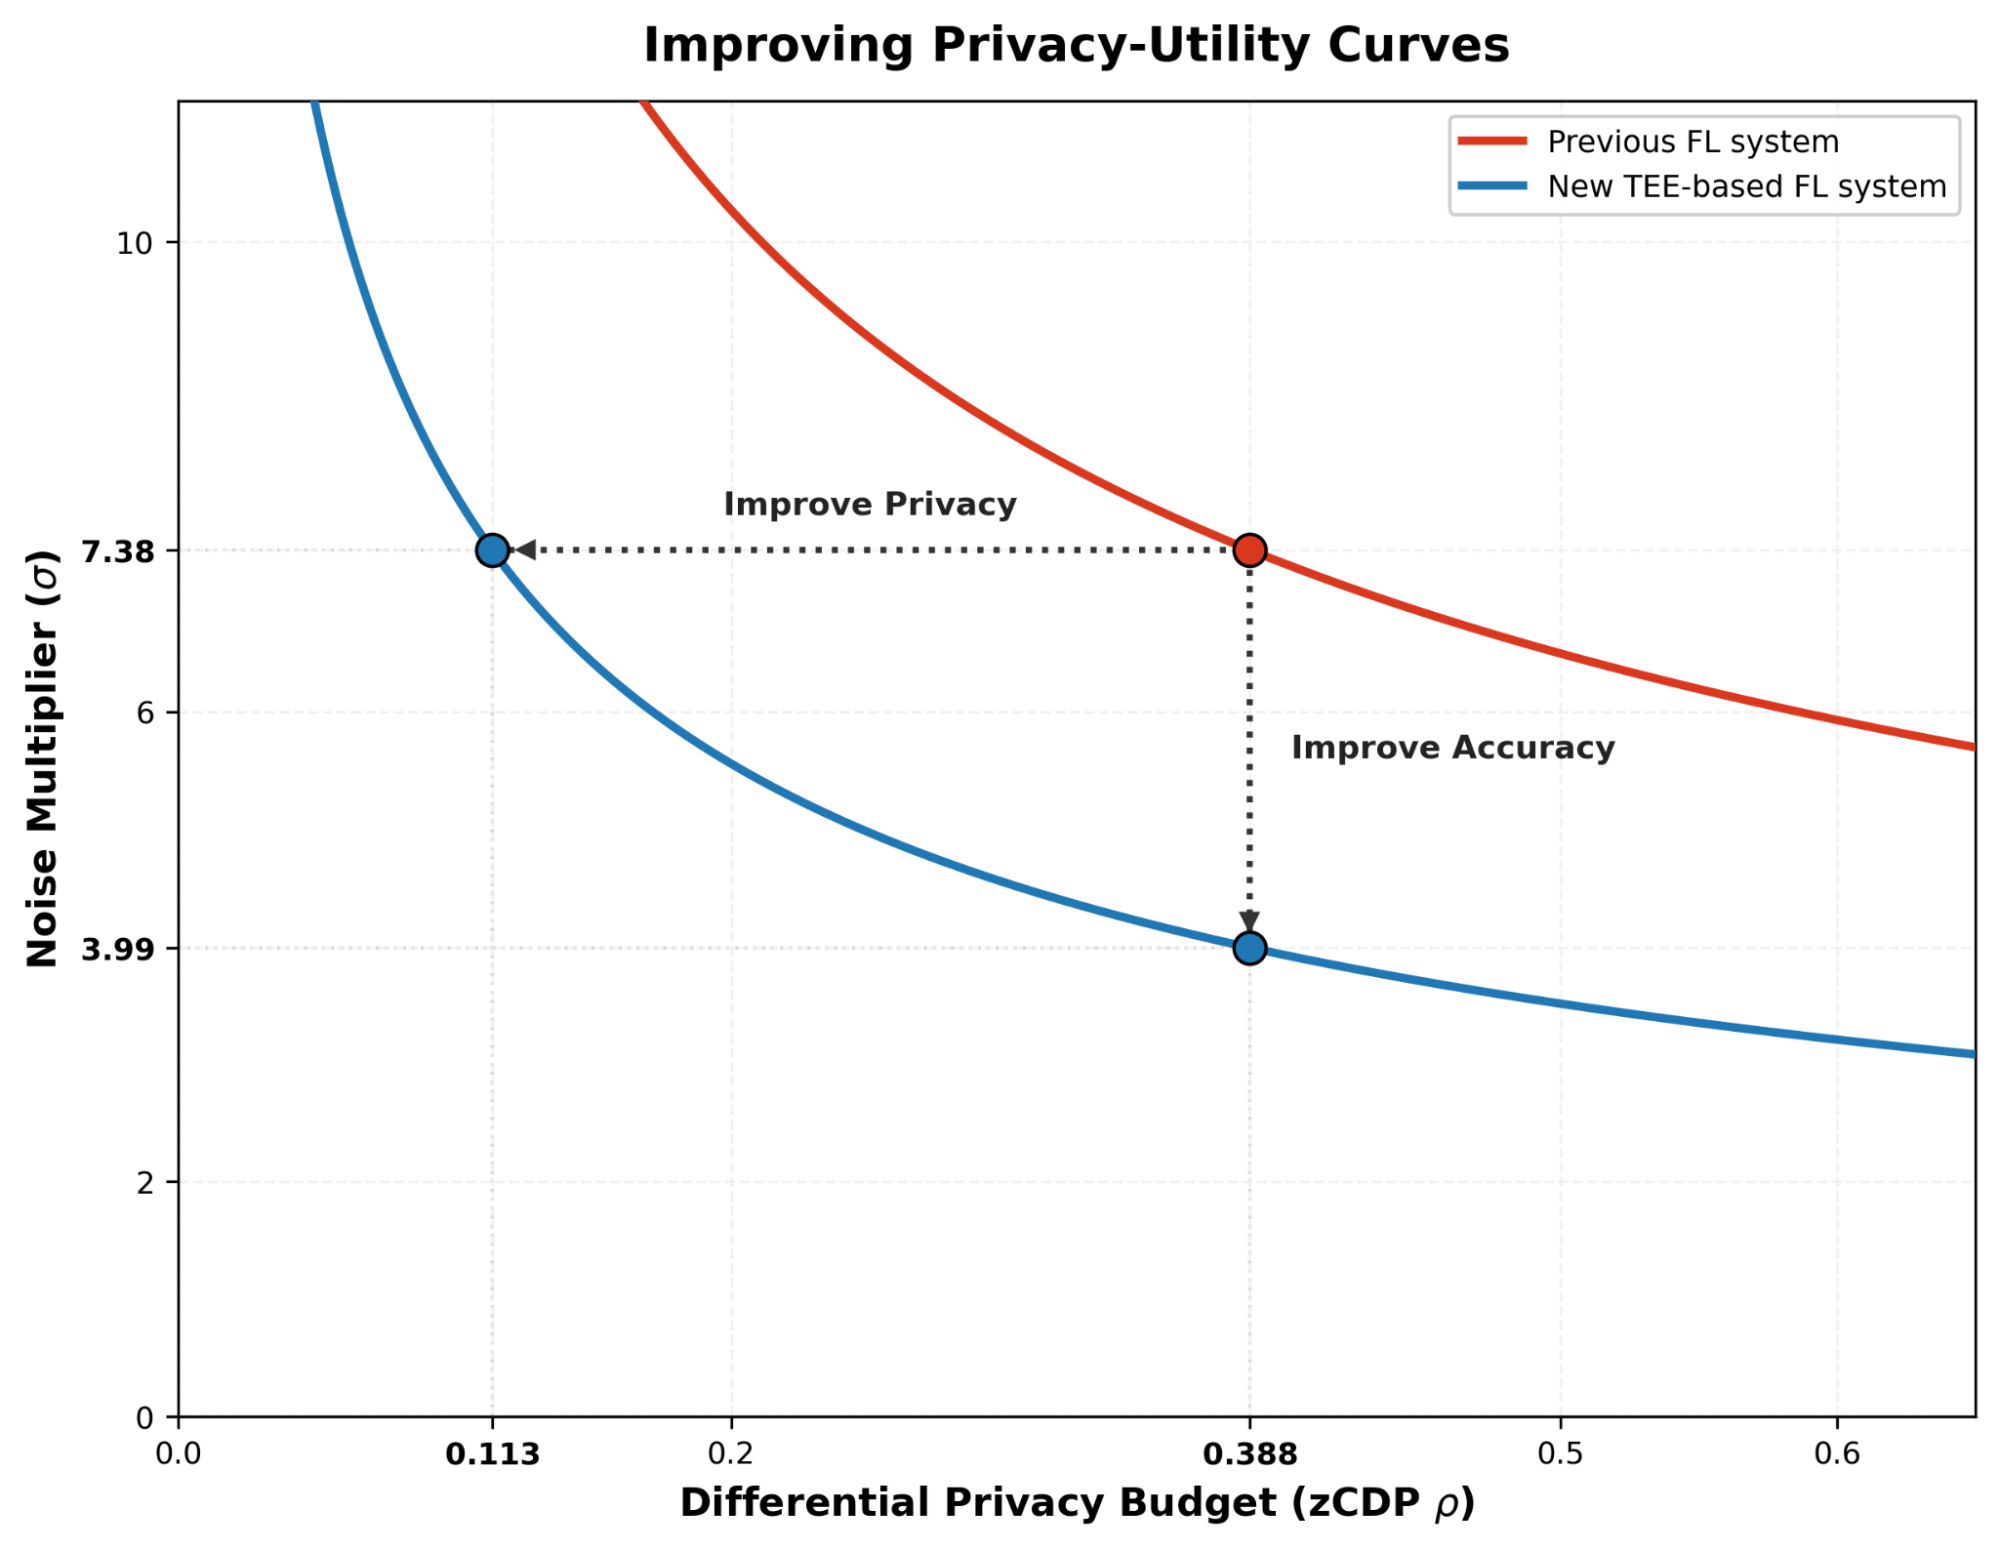
该图展示了通过优化设备参与计划,新的基于 TEE 的系统如何实现更强的隐私保证和/或更小的噪声乘数。这些曲线源自在两个系统上对英语下一个词预测模型进行 5000 轮训练,每轮使用 6500 个设备的群体得出。
训练加速
过去,训练这些联邦学习(FL)模型中的每一个可能需要 1-2 个月的时间,其进展受限于设备可用性、设备端计算能力以及同一组设备资源上多个训练工作负载之间的竞争。在新的基于可信执行环境(TEE)的系统中,瓶颈已转移至服务器端,跨多台机器的计算并行化使我们能够显著缩短训练时间,目前仅受限于 TEE 资源的可用性。
接下来是什么?
在我们新的基于 TEE 的 FL 系统中,客户端梯度的计算被移至服务器,从而消除了早期系统中与设备端计算资源相关的限制。这为使用 FL 技术训练越来越大的模型铺平了道路。将 TEE 与加速器集成将在此类用例中发挥重要作用。
上述描述的系统不仅能够以可验证的方式执行 FL 训练工作负载,还能执行任何可以用 Python 表达的工作负载。我们正在尝试在此基础设施上运行其他类型的工作负载,例如合成数据生成工作负载。另一个探索领域是:结合使用能够执行任意 Python 代码的数据处理 TEE 与我们专门用于大语言模型(LLM)推理等功能的其他数据处理 TEE。
这项工作朝着严格证明服务器端处理能够保护个人隐私迈出了重要一步。借助外部验证器能够检查我们在 Google 运行的确切代码,我们能够提供强有力的保证,即数据在服务器端的处理方式与描述完全一致。我们预计,未来的 TEE 硬件以及针对侧信道观测缓解措施的持续研究,将为动态加载的工作负载提供更深层的保护,以抵御恶意的服务器端攻击。我们 anticipate,像我们这样的系统未来可能会附带对差分隐私(DP)算法和系统组件的软件实现正确性的完整证明。
致谢
作者感谢为基础设施设计和实施做出贡献的合作者:Arun Ganesh、Brendan McMahan、Brett McLarnon、Chunxiang (Jake) Zheng、Emily Glanz、Maya Spivak、Michael Reneer、Nova Fallen、Stefan Dierauf、Suxin Guo、Timon Van Overveldt、Yu Xiao、Zachary Charles 和 Zachary Garrett。我们还感谢支持 Gboard 集成的紧密合作伙伴:Haicheng Sun、Heng Su、Jianpeng Hou、Liyang Jiang、Noriyuki Takahashi、Wenzhi Mao、Xiaojuan Fang、Yanxiang Zhang、Yingjie Liu、Yuanbo Zhang 和 Yun Wang。这项工作得到了 Corinna Cortes、Shumin Zhai 和 Yossi Matias 的支持。此外,我们还要感谢 Maysam Moussalem 对本帖写作的反馈。
- 标签:
- 移动系统
- 安全、隐私与滥用防范
- 软件系统与工程
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。