精选
在 Amazon EKS 上使用 NVRx 实现容错分布式训练
该教程介绍如何将 NVIDIA Resiliency Extension(NVRx)集成到 Amazon EKS 上的 PyTorch FSDP 训练中,通过异步检查点、进程内重启和 ft_launcher 作业内重启,让检查点 I/O 与训练重叠,并在数秒内从 GPU 故障中恢复。在 2 至 8 节点 H100 上的基准测试显示训练效率超过 99%,恢复时间达到秒级。
标题:在 Amazon EKS 上使用 NVRx 进行容错分布式训练
正文: 大规模分布式训练任务会在数十个节点上运行数小时甚至数天。在这种规模和持续时间下,中断在统计上几乎不可避免:网络分区、内存错误、软件异常或基础设施事件最终都会干扰至少一个 worker。单个 GPU 故障会触发连锁反应:NVIDIA Collective Communication Library(NCCL)超时传播到健康 worker,pod 崩溃并以不同步状态重启,而你的集群在消耗昂贵 GPU 小时的同时训练进展为零。同步 checkpointing 还会带来第二个空闲时间来源:每次保存都会让所有 rank 阻塞在 I/O 上,而在本文涉及的集群规模下,这最多消耗了总墙钟时间的 40%。
在这篇文章中,我们将展示如何将 NVIDIA Resiliency Extension(NVRx)集成到 Amazon Elastic Kubernetes Service(Amazon EKS)上的 PyTorch Fully Sharded Data Parallel(FSDP)训练中,以同时解决这两个问题。你将了解如何实现异步 checkpointing,使 I/O 与训练重叠;如何通过进程内重启在不触碰容器生命周期的情况下于数秒内从故障中恢复;以及如何使用 ft_launcher 进行作业内重启,在硬崩溃时自动重新拉起 worker。我们包含了在 H100 GPU 上从 2 节点到 8 节点规模的基准测试结果,并提供全部代码以便复现。
解决方案概述
该解决方案将 NVRx 容错原语与基于 EKS 的训练环境相结合,后者专为高性能多节点 GPU 工作负载而设计。NVRx 负责应用层韧性(异步 checkpointing、进程内重启和作业内重启),而 EKS 集群提供基础设施基础:GPU 调度、高带宽网络,以及用于 checkpoint 持久化的共享存储。
NVRx
NVIDIA Resiliency Extension(NVRx)是一个可通过 pip 安装的 Python 层(pip install nvidia-resiliency-ext),它为 PyTorch 增加了容错原语:无需自定义 kernel,无需 PyTorch fork,无需重新编译。这些原语可以作为普通 import 直接放入现有的 FSDP 脚本中。模型和训练代码保持不变。每一项都可以独立采用。我们实践了三个功能:异步 checkpointing、进程内重启和 ft_launcher(作业内重启)。
异步 checkpointing 通过 TorchAsyncCheckpoint 暴露,它用 async_save() 调用替代 torch.save,将 state dict 交给后台进程并立即返回。在下一次保存前调用匹配的 finalize_async_save() 来提交前一次写入。与 FSDP LOCAL_STATE_DICT 配合使用时,每个 rank 直接写入自己的 shard,无需 all-gather,也没有 rank-0 瓶颈。
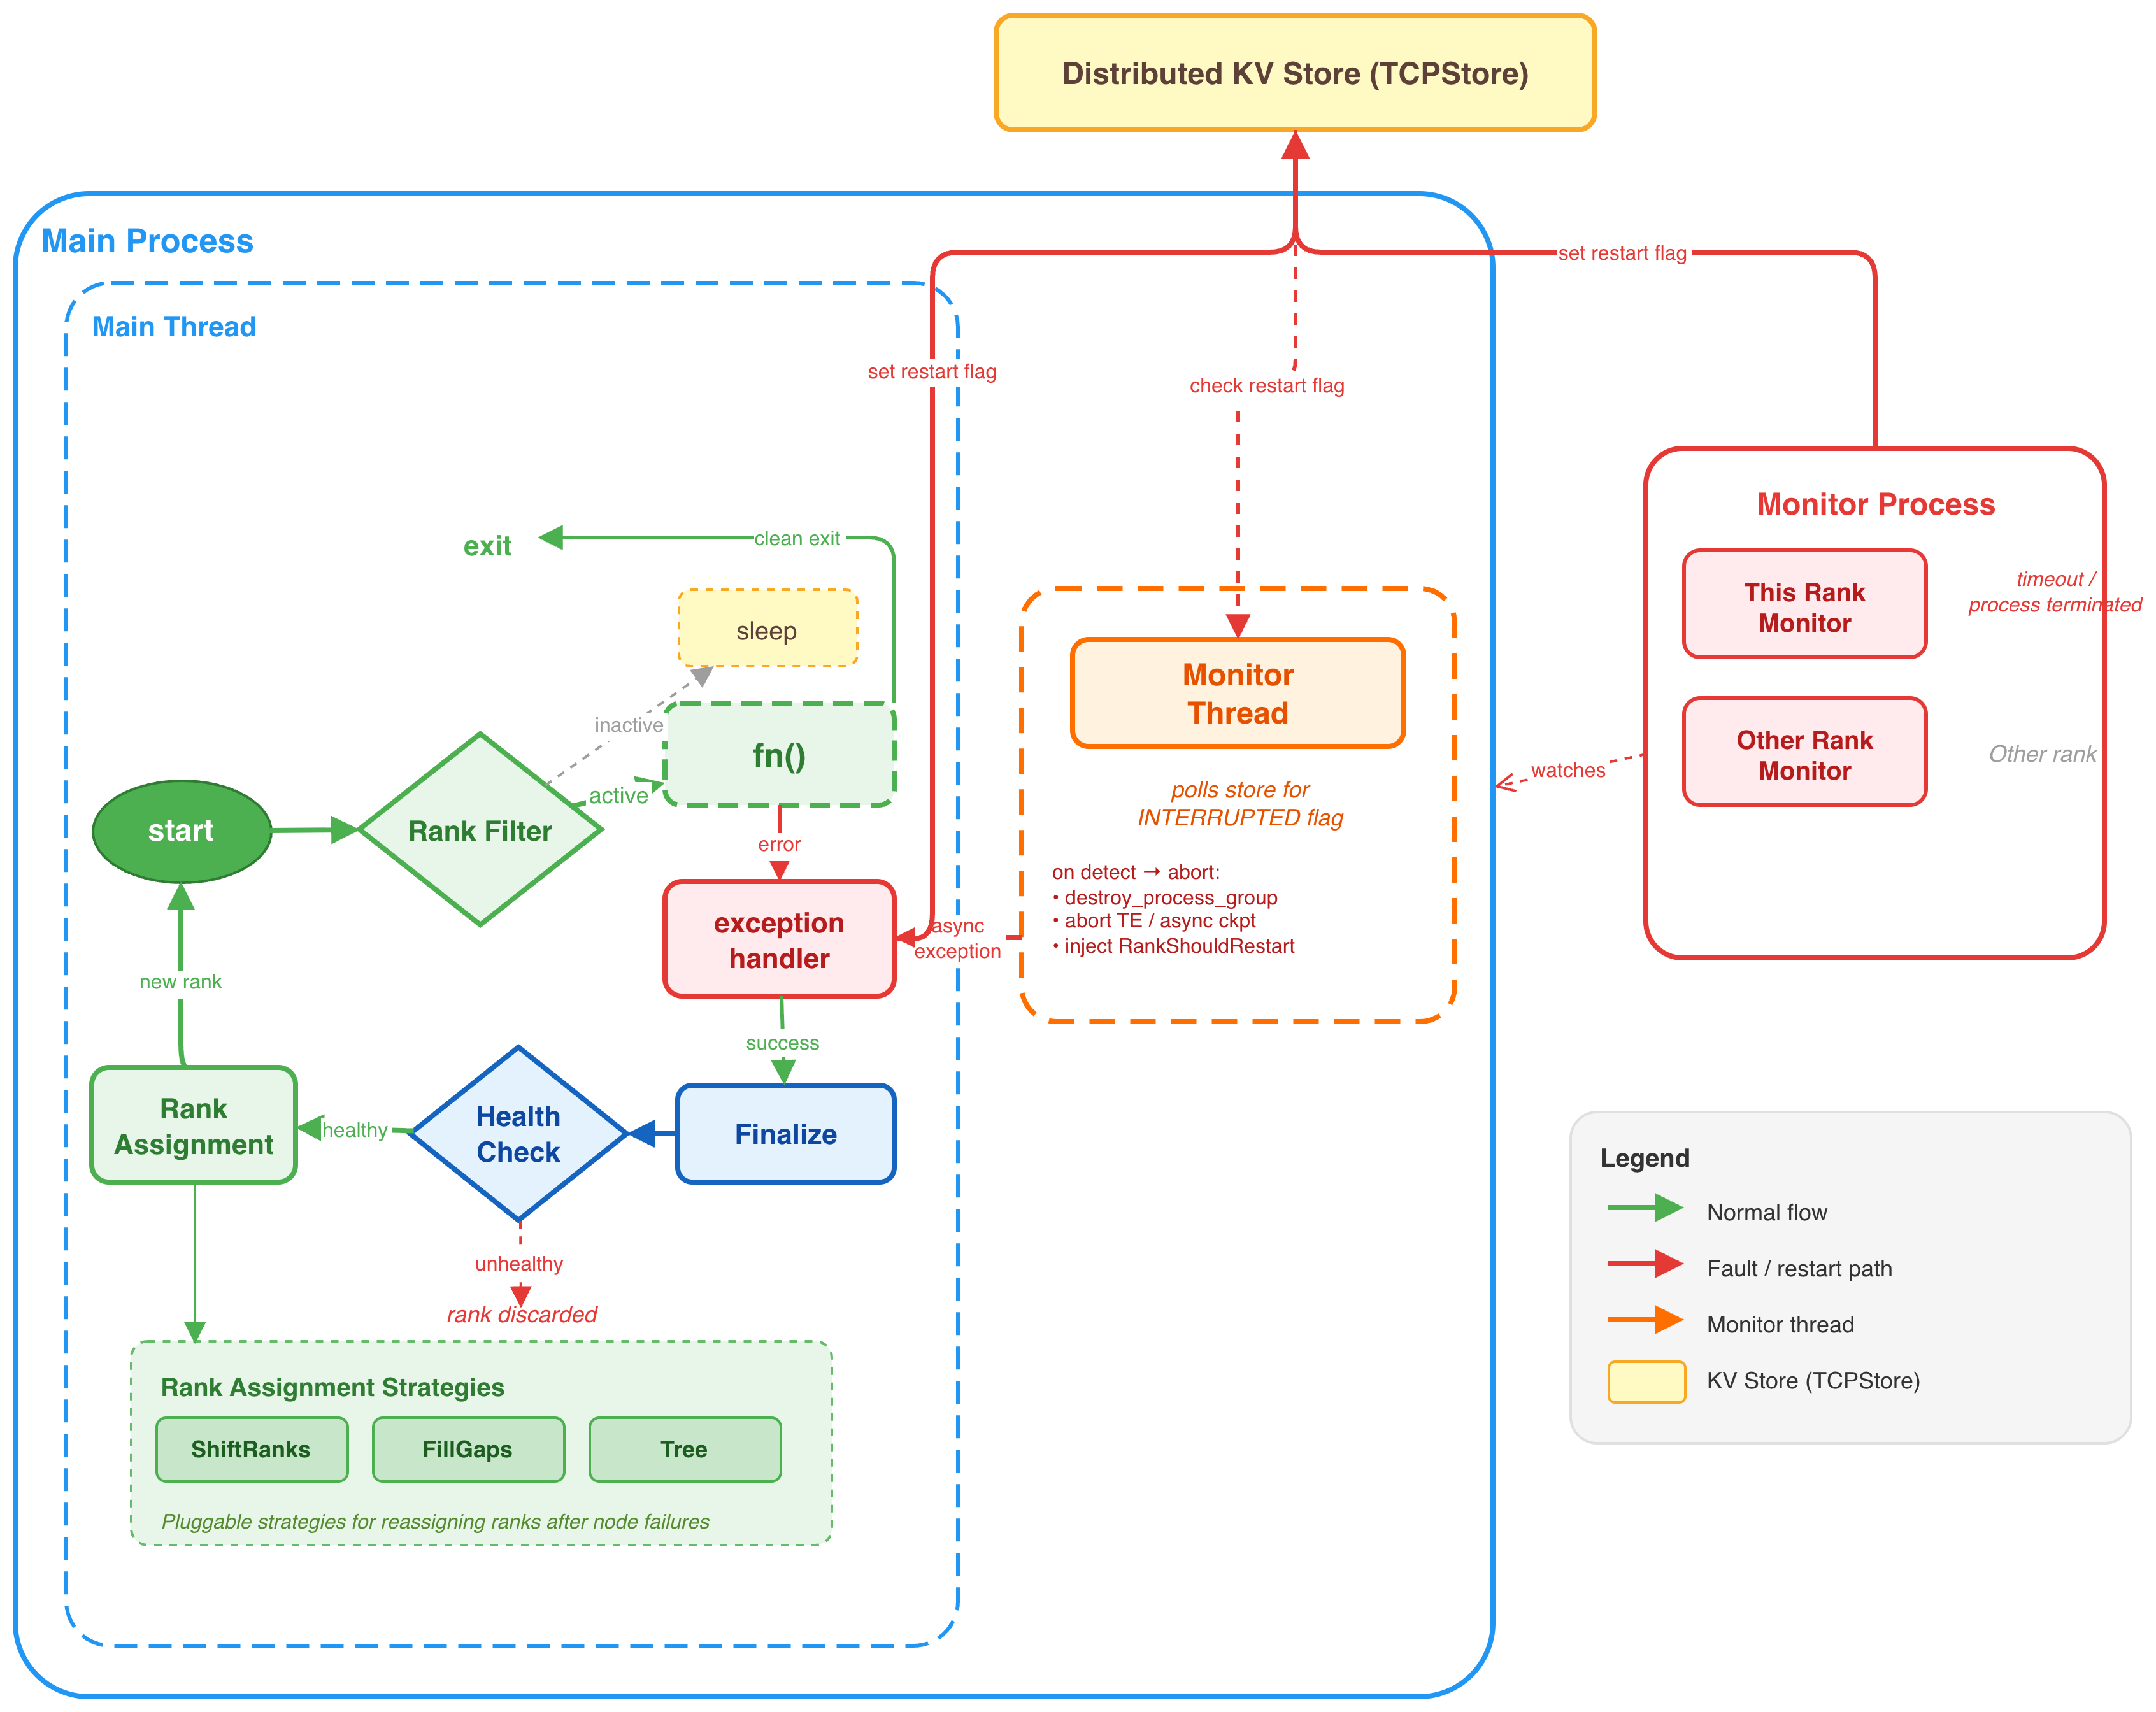
进程内重启通过 inprocess.Wrapper 暴露,它包装 train 函数,使瞬态故障(未处理异常或 NCCL 挂起)不会杀死 Python 进程。NVRx 会中止当前活动 process group,对每个 rank 执行健康检查(GPU、NVLink、NIC),让幸存者重新 rendezvous,并从最新 checkpoint 重新进入被包装的函数。解释器、CUDA allocator 和外层作用域对象都会保留下来。这可以捕获软故障这一类问题。
ft_launcher 二进制文件是 NVRx 的作业内重启启动器,用于处理进程内机制无法捕获的情况:SIGKILL、out-of-memory(OOM)kill 和 OS 级挂起。每个 rank 运行一个 RankMonitorClient。启动器会根据显式通过 CLI 设置的超时检查心跳,在停滞或死亡时杀死幸存进程、回收 GPU 内存,并在同一作业中重新拉起新的 worker。恢复后的 worker 会从最新 checkpoint 重新加载。每一层恢复机制覆盖不同的故障类别:进程内机制用于软故障,ft_launcher 用于硬故障,集群编排器用于节点丢失。这些层彼此独立。选择与你故障模式范围相匹配的那一层。
Amazon EKS 集群
Amazon EKS 是一项托管 Kubernetes 服务,负责处理控制平面、升级和 API 服务器可用性。我们运行自管理的 p5.48xlarge 实例节点组,每个实例配备 8 块 NVIDIA H100 80 GB GPU 和 32 个 Elastic Fabric Adapter(EFA)网络接口。训练 Pod 以 Kubernetes Job 形式运行,并通过无头 Service 进行对等节点发现,因此工作节点通过 DNS 相互发现,而非硬编码 IP,Pod 替换后无需重新配置 Job 即可重新加入。
每个节点通过 NVIDIA 设备插件和 EFA 设备插件将 GPU 和 EFA 适配器暴露为扩展资源。Kubernetes 调度器利用节点亲和性和容忍度将训练 Pod 放置到 GPU 节点上,从而实现每节点完整的 8-GPU 分配。

对于检查点存储,我们使用 Amazon FSx for Lustre(SCRATCH_2,1.2 TB),通过 FSx CSI 驱动挂载到每个训练 Pod 中。FSx 提供共享文件系统,异步和同步检查点写入均使用它,更重要的是,故障恢复后的工作节点从这里读取其检查点状态。将 FSx 放置在与 GPU 节点相同的可用区可最大限度减少恢复期间的读取延迟,这一点至关重要,因为在大规模场景下,检查点加载(而非重启机制)主导了恢复时间。
图 1:架构图,展示包含 2-8 个 p5 节点、EFA 互连、FSx for Lustre 以及训练 Pod 内 NVRx 组件的 EKS 集群
- Amazon EKS — Kubernetes 控制平面、Pod 调度、Job 生命周期管理。
- Amazon Elastic Compute Cloud(Amazon EC2)p5.48xlarge — 每节点 8 块 H100 80 GB GPU、32 个 EFA 适配器。
- Elastic Fabric Adapter(EFA)— 用于 NCCL all-reduce 操作的 3,200 Gbps 网络带宽。
- Amazon FSx for Lustre — 用于分布式检查点 I/O 的共享 POSIX 文件系统。
- Amazon Elastic Container Registry(Amazon ECR)— 训练镜像(PyTorch + NVRx + 模型代码)的容器注册表。
前提条件
- 具有 p5.48xlarge(或 p4de.24xlarge)实例服务配额的 AWS 账户。
- Amazon EKS 集群(v1.28+),配备启用 EFA 的自管理 GPU 节点组,并已安装 NVIDIA 设备插件。
- 与 GPU 节点位于同一可用区的 Amazon FSx for Lustre 文件系统(SCRATCH_2)。
- 包含 PyTorch 2.9+、NVRx 0.4.1 的容器镜像,用于复现本文所示的基准测试结果。对于当前部署和您的训练代码,请使用 v0.6.0 及更新后的启动器配置,并推送至 Amazon ECR。
- 已为您的集群配置 kubectl。
- 具有 meta-llama/Llama-3.1-8B(或您选择的模型)访问权限的 HuggingFace 账户。
- 预下载至共享存储的训练数据集(我们使用 C4 数据集中的 100K 样本。您可以使用任意数据集)。
有关创建带 GPU 节点和 EFA 网络的 EKS 集群,请参阅 awsome-distributed-ai/1.architectures 中的基础设施指南。有关完整的 NVRx 特定设置(包括 Terraform 模块、容器构建和数据集准备),请参阅 NVRx 测试用例 README。
解决方案演练
NVRx 对标准 PyTorch FSDP 脚本引入了两项正交变更:异步检查点(写入路径优化)和恢复,后者分为两个独立层次:针对软故障的进程内重启和针对硬故障的 ft_launcher 作业内重启。测试用例为每项能力提供了单独的脚本,因此您只需采用所需的部分。
我们从带有同步检查点的基线 FSDP 脚本开始,然后逐一独立引入每项 NVRx 能力(异步检查点、进程内重启和 ft_launcher 作业内重启),最后简要说明各恢复层次如何组合。
基线 FSDP 训练脚本
从由 torchrun 启动的最小 FSDP 循环开始,使用同步分布式检查点保存(底层为 PyTorch 的 torch.distributed.checkpoint.save)。保存操作会阻塞所有 rank,直到每个 rank 的分片写入共享存储,而工作节点崩溃会导致整个训练作业终止,需要从最后一个检查点完全重启。
异步检查点:将检查点 I/O 与训练解耦
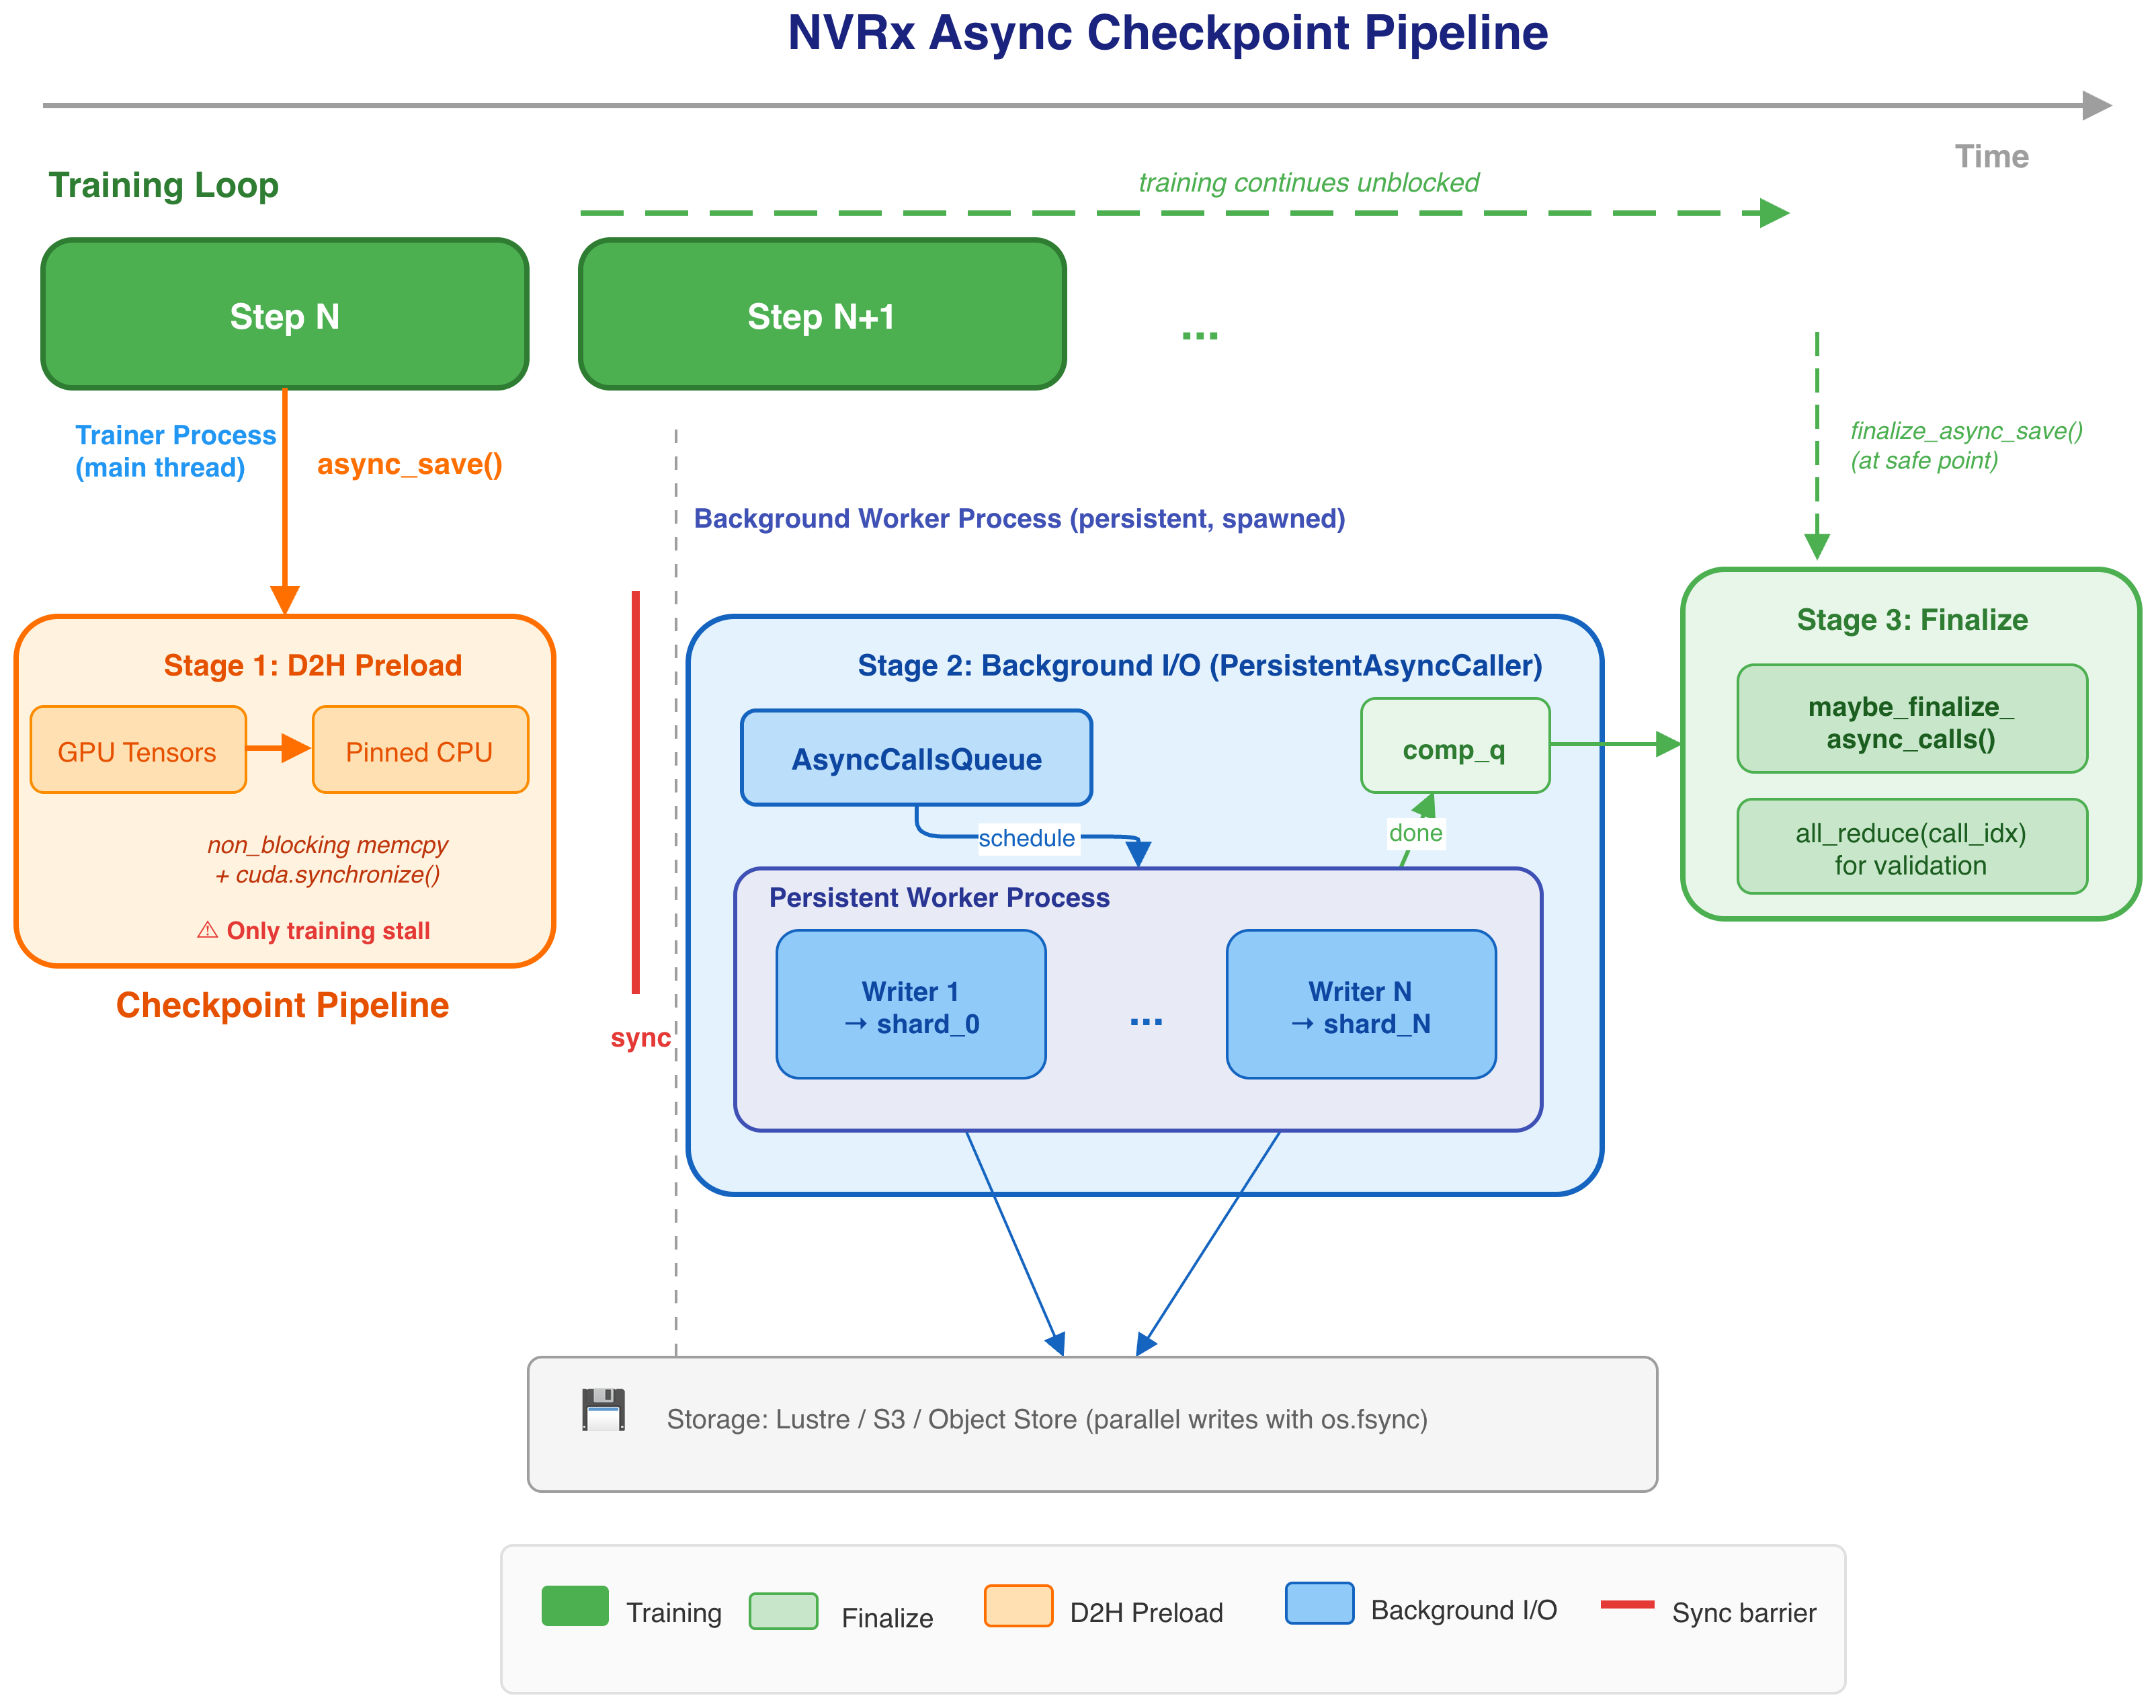
将同步保存替换为 NVRx TorchAsyncCheckpoint:使用 persistent_queue=True 实例化一次,用 async_save(state_dict, path) 替代 torch.save,并在作业退出时调用一次 finalize_async_save(blocking=True) 作为阻塞式收尾,如图 2 所示。后台进程负责实际的写入。主线程继续执行下一个前向/反向步骤。每个 rank 通过 FSDP LOCAL_STATE_DICT 写入自己的分片,无需 all-gather,也没有 rank-0 瓶颈。
import torch
import torch.distributed as dist
from nvidia_resiliency_ext.checkpointing.async_ckpt.torch_ckpt import TorchAsyncCheckpoint

# Initialize the async checkpoint manager once after model/optimizer setup.
async_ckpt = TorchAsyncCheckpoint(persistent_queue=True)

# Training loop
for step, batch in enumerate(dataloader):
    loss = model(batch)
    loss.backward()
    optimizer.step()

    # Checkpoint every N steps
    if step % checkpoint_interval == 0:
        state_dict = build_state_dict(model, optimizer, step)  # FSDP LOCAL_STATE_DICT, CPU-staged
        # torch.save(state_dict, path)  # was blocking
        async_ckpt.async_save(state_dict, path)  # returns immediately

# Drain any in-flight save at job exit.
async_ckpt.finalize_async_save(blocking=True)
进程内重启
用 inprocess.Wrapper 包装 train 函数。该包装器负责重启循环:被包装函数中的异常(或看门狗检测到的挂起)会触发重新进入,而不是使进程崩溃。构造函数连接了四个方面:超时(soft_timeout、hard_timeout、barrier_timeout、completion_timeout)、健康检查(CudaHealthCheck + FaultCounter)、一个限制总重启次数并设置最小存活 world size 的 RetryController,以及将存活者向左拉齐以保持 world 连续的 rank 分配(ActivateAllRanks + ShiftRanks)。
import nvidia_resiliency_ext.inprocess as inprocess
from nvidia_resiliency_ext.inprocess import CallWrapper

def train_with_inprocess_restart(args, restart_metrics, base_store=None,
                                 call_wrapper: CallWrapper = None):
    # 重新初始化 dist,重建 FSDP,加载最新检查点,训练。
    # 每一步调用 call_wrapper.ping();
    # call_wrapper.iteration 告诉你当前处于第几次重启。
    ...

wrapped_train = inprocess.Wrapper(
    store_kwargs = {"host_name": master_addr, "port": master_port + 1},
    soft_timeout = datetime.timedelta(seconds=args.soft_timeout_seconds),
    hard_timeout = datetime.timedelta(seconds=args.hard_timeout_seconds),
    barrier_timeout = datetime.timedelta(seconds=args.barrier_timeout_seconds),
    completion_timeout = datetime.timedelta(seconds=args.barrier_timeout_seconds),
    health_check = inprocess.Compose(
        inprocess.health_check.CudaHealthCheck(),
        inprocess.health_check.FaultCounter(max_rank_faults=20)),
    initialize = inprocess.initialize.RetryController(
        max_iterations=args.max_restarts, min_active_world_size=1),
    rank_assignment = inprocess.Compose(
        inprocess.rank_assignment.ActivateAllRanks(),
        inprocess.rank_assignment.ShiftRanks()),
)(train_with_inprocess_restart)

wrapped_train(args, restart_metrics, base_store)
在幕后(如图 3 所示):ProgressWatchdog(progress_watchdog.py:49)使用 Py_AddPendingCall 在字节码指令之间写入时间戳,因此即使卡在 NCCL(一个 C 扩展)内部也仍然可以被检测到。MonitorThread(monitor_thread.py:124)轮询 inprocess TCPStore 中的 interrupted 标志,并在检测到时向主线程抛出 RankShouldRestart。随后 AbortTorchDistributed(abort.py:62)收集 Flight Recorder 跟踪信息,中止 NCCL 后端,并销毁进程组。健康检查挑选幸存者。Python 进程保持存活,只重建分布式进程组。
作业内重启(ft_launcher)
将启动器从 torchrun 切换为 ft_launcher。它理解相同的 rendezvous 标志,并新增了一些自己的标志来控制重启行为:
# --- 之前 ---
torchrun --nnodes=$NNODES --nproc_per_node=$GPU_PER_NODE \
    --rdzv-backend=c10d --rdzv-endpoint=$MASTER_ADDR:29500 \
    train.py [args]

# --- 之后 ---
ft_launcher --nnodes=$NNODES --nproc_per_node=$GPU_PER_NODE \
    --rdzv_backend=c10d --rdzv_endpoint=$MASTER_ADDR:29500 \
    --max-restarts=20 --ft-restart-policy=any-failed \
    --ft-rank-heartbeat-timeout=900 \
    --ft-initial-rank-heartbeat-timeout=1200 \
    --monitor-interval=5 \
    train_ft_launcher.py [args]
import nvidia_resiliency_ext.fault_tolerance as fault_tolerance
ft_client = fault_tolerance.RankMonitorClient()
ft_client.init_workload_monitoring() # 一次,在 dist 初始化之后
for step in range(1, args.max_steps + 1):
loss = train_step(model, next(data_iter), optimizer)
ft_client.send_heartbeat() # 向 RankMonitorServer 发送存活信号将 --ft-rank-heartbeat-timeout 设置为大于应用心跳之间最长合法间隔的值。示例中使用 900 秒。设置 --ft-initial-rank-heartbeat-timeout=1200(20 分钟)是为了适应首次模型加载。参见 kubernetes/training-job-ft-launcher.yaml。
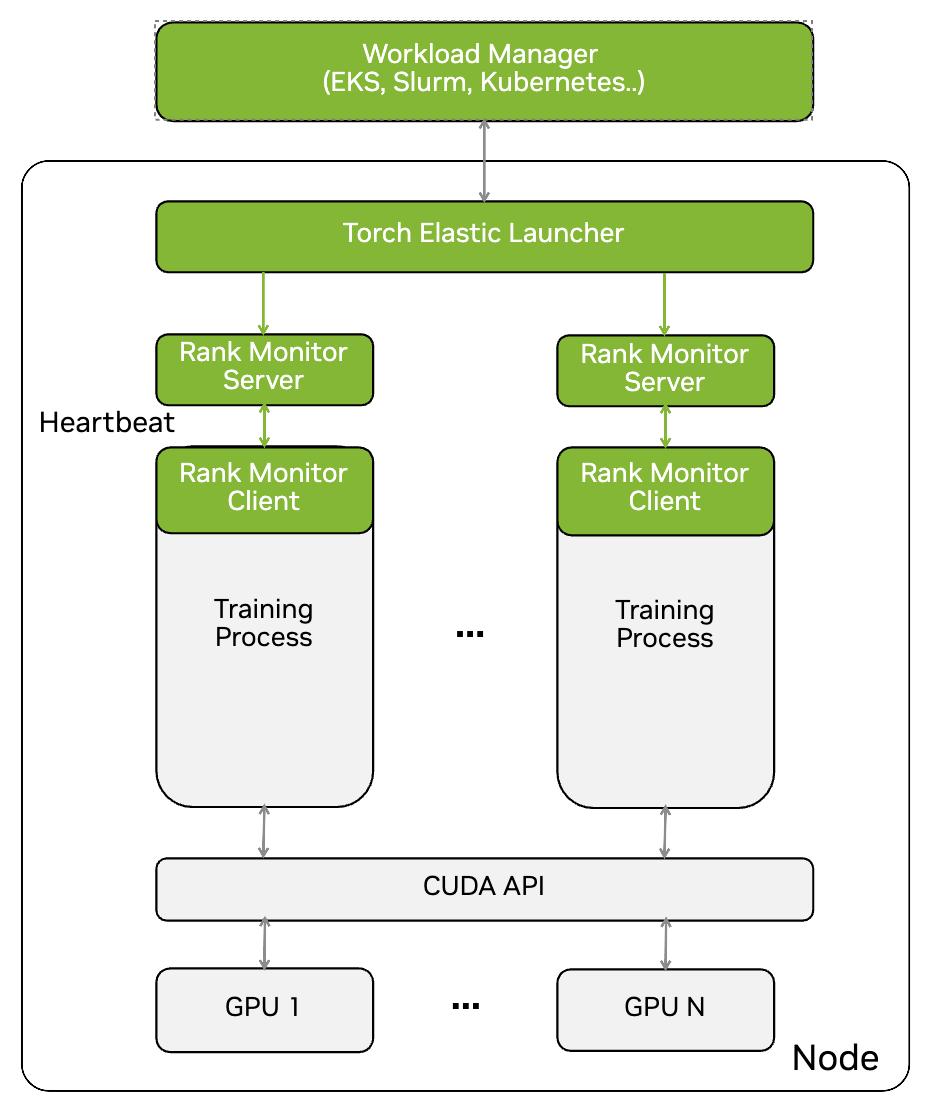
在幕后(如图 4 所示):每个 rank 的 RankMonitorServer 会根据上述超时来跟踪心跳间隔。超时后,启动器会向幸存者发送 SIGTERM(对落后进程发送 SIGKILL),回收 GPU 内存,重新 rendezvous,并启动新的 worker。Worker 在启动时从最新检查点重新加载。检查点频率决定了丢失工作的上限。
各层如何覆盖不同的故障类别
两个恢复层针对不同的故障模式:进程内恢复捕获单个 Python 进程内可处理的问题(瞬态异常、watchdog 可见的 NCCL 挂起),ft_launcher 捕获导致进程被杀或在操作系统层面挂起的问题(SIGKILL、OOM、Python 层以下的死锁),集群调度器则捕获节点丢失。选择影响范围与你的故障模式相匹配的那一层。异步检查点是正交的:它与某个恢复层(或不与任何恢复层)配合使用,并限制丢失工作的影响范围。
部署并运行实验
我们通过一个围绕 kubectl 的轻量封装脚本来部署训练任务,该脚本处理清单模板化、任务清理和环境变量替换。环境变量定义实例类型、GPU 数量、EFA 设备数量以及其他硬件相关参数,因此只需更改一个配置文件,相同的训练代码和清单就能在不同 GPU 类型(p5、p4de)上运行。为了在相同条件下比较恢复机制,我们使用确定性故障注入,通过带种子的 RNG 在固定训练步和 rank 上预生成恰好 N 个故障:
--fault_count=5 --fault_seed=42 --fault_types=exception,hang --fault_type_weights=0.6,0.4相同的种子在各次实验中产生相同的故障时间表,从而能够直接比较基线 K8s 重启、ft_launcher 和 NVRx 进程内重启。我们让每种机制面对相同的 5 故障模式,然后在不注入故障的情况下单独运行异步与同步检查点,以隔离检查点开销。
结果
本节展示两项关键能力的基准测试结果:异步检查点和故障恢复。
异步检查点
我们在 LLaMA-3.1-8B FSDP 训练上对异步(NVRx)与同步(torch.save)检查点进行了基准测试,涵盖两个维度:从 2 个节点扩展到 8 个节点(16-64 块 H100 GPU),固定每 1000 步检查点一次;以及在 8 节点规模下扫描检查点频率(每 100 到 1000 步)。
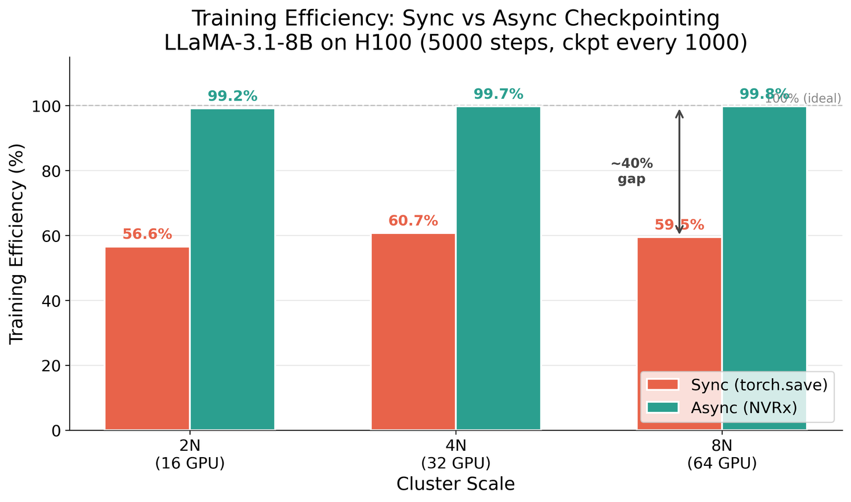
异步检查点在各个规模下都保持 99%+ 的训练效率(2 节点时 99.2%,8 节点时 99.8%),而同步检查点则持平在 57-61%,无论节点数量多少都因阻塞式 I/O 损失约 40% 的墙钟时间。这一差距持续存在,是因为检查点开销受存储限制:FSx Lustre 写入时间(约 275 秒)无论你有 16 块还是 64 块 GPU 都是恒定的。异步通过将 I/O 与下一段训练重叠,完全隐藏了这一延迟。
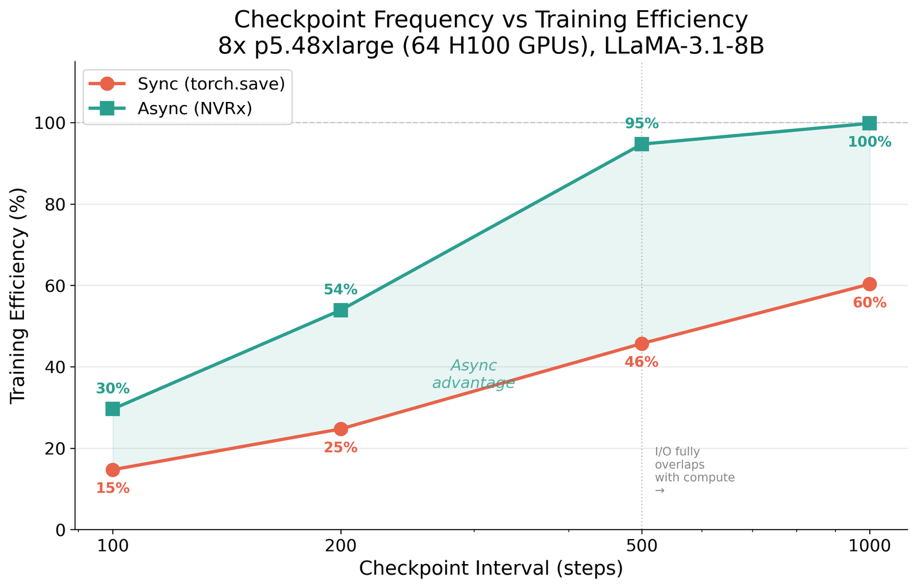
在每 1000 步检查点一次时,异步达到 99.8% 的效率,而同步为 60.3%。在每 100 步检查点一次时,同步骤降至 14.7%,而异步优雅地降至 29.6%,效率仍是前者的 2 倍。交叉点出现在检查点之间的训练间隔(100 步时约 280 秒)接近 FSx I/O 时间(约 275 秒)之处。高于该阈值时,异步完全重叠。低于该阈值时,部分重叠仍然优于阻塞式写入。
这意味着:大规模训练的团队通常为了规避阻塞惩罚而很少进行检查点,从而在发生故障时接受数小时的进度损失。异步检查点消除了这一权衡:你可以激进地进行检查点(每隔几分钟一次),开销接近于零,在不牺牲 GPU 利用率的情况下最小化回滚距离。
故障恢复
我们在 2 个 p5.48xlarge 节点(共 16 块 H100 GPU)上运行故障恢复实验,使用 FSDP 训练 LLaMA-3.1-8B,在 2000 步的运行中每 500 步检查点一次。我们向每次训练运行注入 5 个确定性故障(相同种子、相同故障时间表),并比较了三种恢复机制:
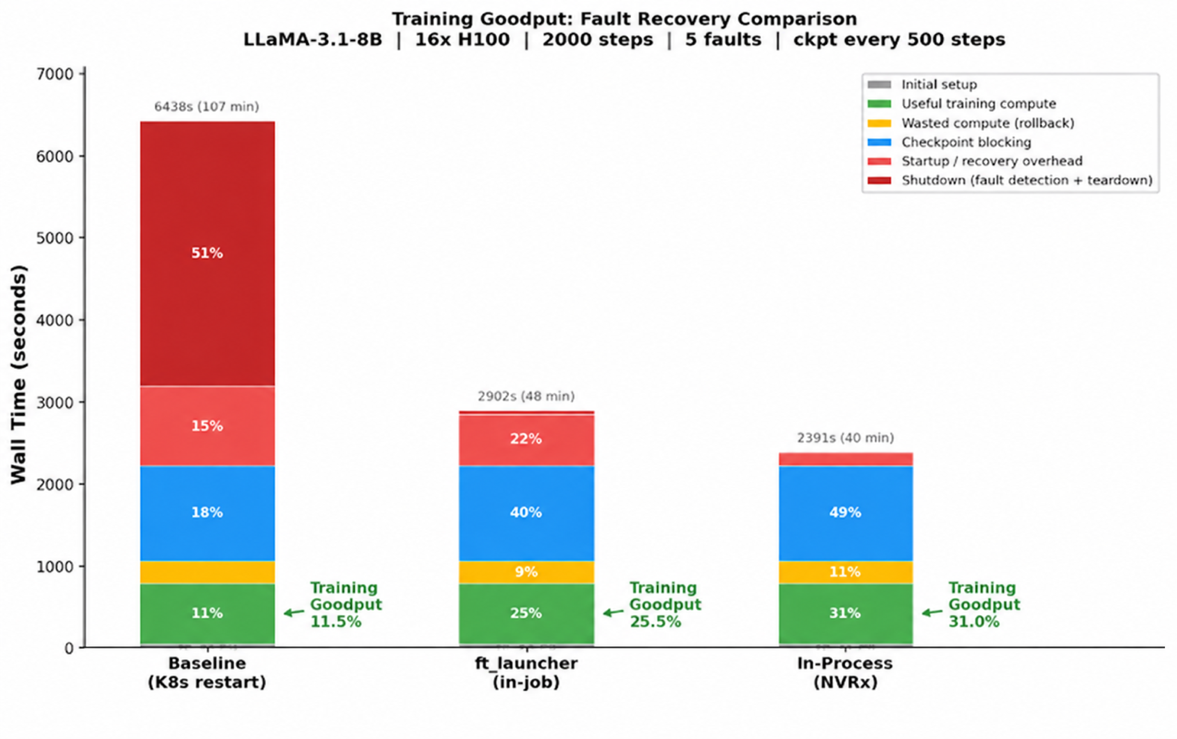
NVRx 进程内重启实现了 31% 的训练有效吞吐和 87% 的基础设施有效吞吐,约 10 秒内恢复,且零容器重启。ft_launcher 实现了 25.5% 的训练有效吞吐(85.9% 基础设施有效吞吐),每次故障恢复需 17 秒。基线 Kubernetes 重启则是灾难性的:11.5% 训练有效吞吐、35.8% 基础设施有效吞吐,每次故障恢复需 270 秒。基线的故障模式是一种级联:一个 rank 崩溃,存活的 rank 触发 NCCL 超时(60 秒),随后两个 pod 不同步地重启,引发 CrashLoopBackOff 以及额外的超时循环,之后训练才能恢复。
这意味着什么:在大规模训练中(数百到数千块 GPU),硬件故障每隔几小时就会发生。基线 Kubernetes 恢复每次故障要消耗 4 分钟以上,一个每小时经历 3-4 次故障的集群,花在恢复上的时间会比训练还多。NVRx 将这一恢复窗口缩短到数秒,即使故障频率随规模增长而上升,也能保持 GPU 利用率高企。
清理
为避免持续计费,请移除你创建的资源。顺序很重要:挂载 FSx 的 Kubernetes 对象必须先于文件系统本身删除,否则删除会因卷 finalizer 而阻塞。
- 删除训练作业。./deploy.sh --delete training-job-inprocess.yaml kubectl get jobs -n nvrx-training
- 释放卷声明。kubectl delete -f fsx-storage.yaml PersistentVolume 使用 persistentVolumeReclaimPolicy: Retain,因此这只会分离文件系统而不会删除它,FSx 会持续计费,直到你在第 4 步中将其移除。请先将你想保留的任何结果从 /checkpoints 复制出来。删除 SCRATCH_2 文件系统是永久性的,不会进行最终备份。
- 将 GPU 节点组缩容到零。aws autoscaling update-auto-scaling-group \ --auto-scaling-group-name \ --min-size 0 --max-size 0 --desired-capacity 0 按需实例一旦终止便停止计费。使用 EC2 Capacity Blocks 时,预留费用是预先收取的,因此提前释放不会收回任何费用,但至少要在此 block 结束前 30 分钟缩容,因为 EC2 会在此 Capacity Block 结束时间之前就开始终止实例。
- 删除文件系统、镜像仓库和集群。aws fsx delete-file-system --file-system-id aws ecr delete-repository --repository-name --force 然后使用最初配置它们的任一工具(terraform destroy、eksctl delete cluster 或 CloudFormation)移除 EKS 集群和 GPU 节点组,以保持基础设施状态一致。
关于上下文中的作业级拆除,请参阅测试用例 README 中的 Stop Training(https://github.com/awslabs/awsome-distributed-ai/tree/main/examples/training/nvrx/kubernetes#8-stop-training)。
结论
在这篇文章中,我们展示了将 NVIDIA Resiliency Extension(NVRx)与 Amazon EKS 结合,如何通过缓解两个常见瓶颈——检查点阻塞和故障恢复——来解锁更高效的分布式 PyTorch 训练。
在报告的运行中,异步检查点减少了阻塞式 I/O,在 16 到 64 块 H100 GPU 上测得 99%+ 的训练效率。在故障恢复方面,NVRx 进程内重启可在约 10 秒内恢复,且零容器重启,而 ft_launcher 则处理会导致进程完全崩溃的硬故障(SIGKILL、挂起)。两者相较基线 Kubernetes 恢复都是阶跃式改进,后者中 NCCL 超时级联和 CrashLoopBackOff 风暴每次故障要消耗 4 分钟以上。
这些特性的结合意味着团队可以激进地做检查点并快速恢复,从而同时最大化数据保护和 GPU 利用率。
后续步骤
- 在 awsome-distributed-ai 仓库中尝试完整的可复现示例。
- 探索将异步检查点与故障恢复结合,以实现最大训练效率,同时缩短回滚距离和恢复时间。
参考文献
- NVIDIA Resiliency Extension。
- Awsome-distributed-ai 展示 NVRx 与 EKS 的集成
- GTC 演讲:大规模构建容错分布式 AI 训练
- Amazon Elastic Kubernetes Service (Amazon EKS)
- Amazon FSx for Lustre
- Amazon Elastic Container Registry (Amazon ECR)
- Elastic Fabric Adapter (EFA)
- 使用 Amazon EKS 和 Torch Distributed Elastic 进行分布式训练
关于作者
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。