精选SemiAnalysis短讯
GLM5.3 稀疏注意力机制对 HBM 内存使用的影响
分析 GLM-5.3 模型中稀疏注意力机制(如 HiSparse、DeepSeek Sparse Attention)如何优化 KV Cache 卸载及索引共享,从而降低高带宽存储器(HBM)的内存占用。
GLM-5.3、KV Cache 卸载、HiSparse、AgentX TileRT、InferenceX、DeepSeek 稀疏注意力、IndexShare、单轮异步优化、网络安全
稀疏注意力如何影响包括 HBM 和 NAND 在内的内存总可寻址空间(TAM)?稀疏注意力选择最相关的 top-k 个 token 进行关注,从而减少了核心缩放点积注意力(SDPA)操作期间的内存消耗和带宽需求。然而,效率的提升并不能直接转化为实际中的整体内存节省。具体而言,top-k 选择操作通常要求完整上下文位于 HBM 中,因此稀疏注意力并未消除内存容量瓶颈。
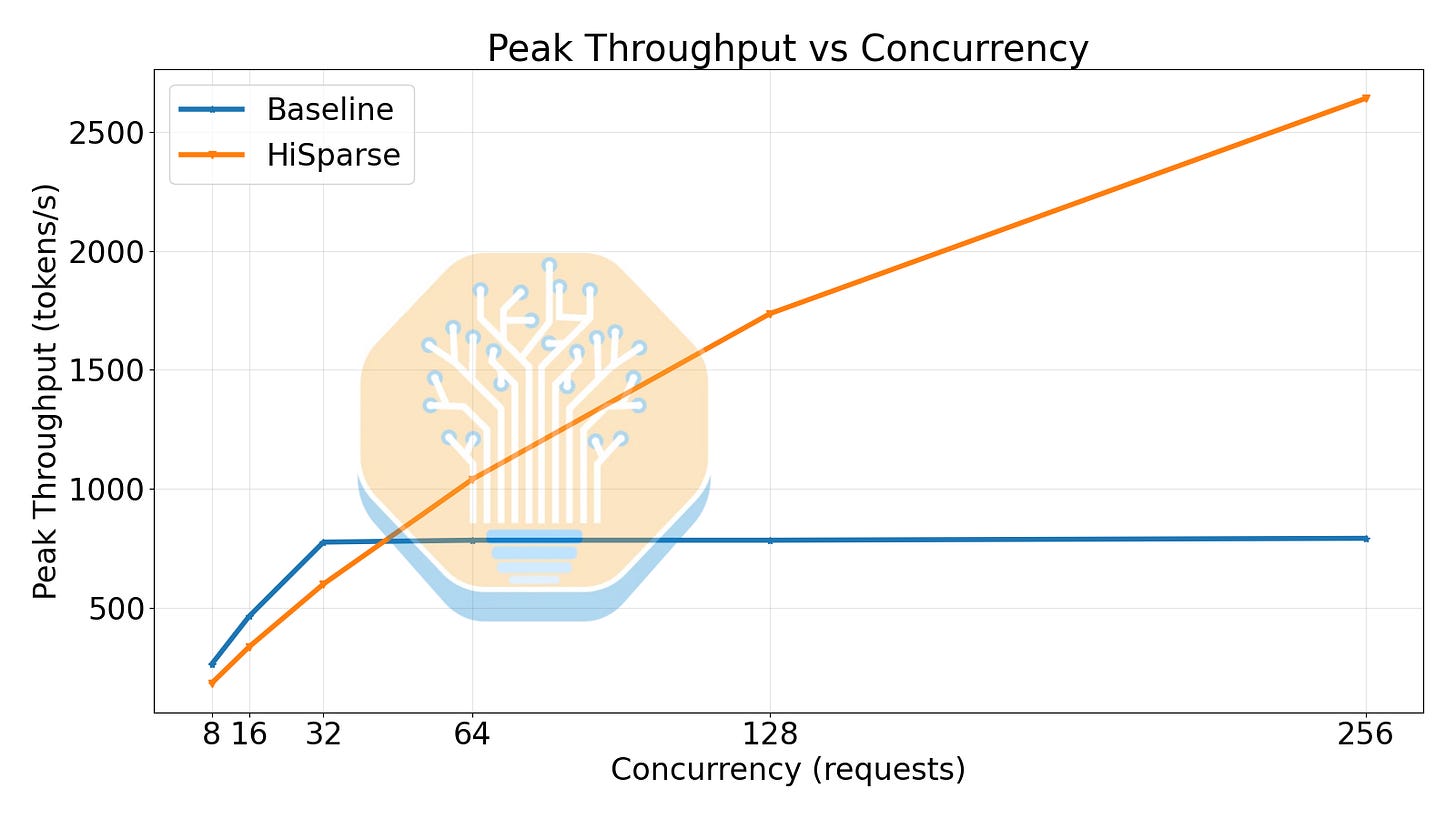
为了克服这一限制,SGLang 团队设计了 HiSparse,这是一种分层内存系统,能够主动将 KV cache 条目从设备 HBM 卸载到主机 DRAM。HiSparse 的行为类似于 LRU(最近最少使用)缓存:当在 top-k 选择时发生缓存未命中,它会将 token 从 DRAM 加载到 HBM;并根据 LRU 驱逐策略将 token 从 HBM 卸载到 DRAM。为了减少缓存未命中的延迟,HiSparse 将第 N 层的 KV cache 加载与第 N-1 层的执行重叠(层间重叠),这一特性在其先前工作 HiCache 中引入。
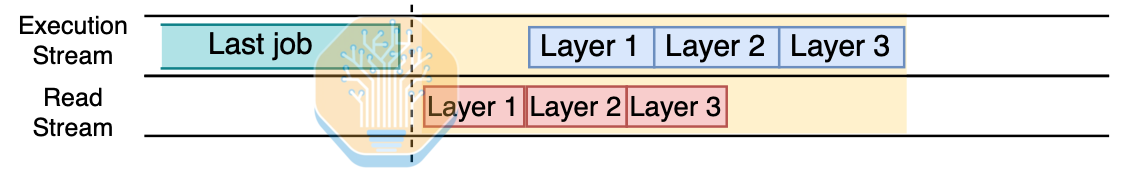
借助 HiSparse,SGLang 在高并发和长上下文场景下大幅提升了吞吐量,代价是 top-k 缓存未命中带来的 I/O 开销。
稀疏注意力降低了 SDPA 操作期间的 KV cache 内存和带宽需求,但并未降低整体内存容量的使用量。此外,HiSparse 表明系统优化可以克服稀疏注意力的内存容量限制,因此仅凭稀疏注意力的内存配置不足以充分描绘系统 KV cache 效率的全貌。为了更全面地展示服务稀疏注意力模型的情况,在此我们解释 Z.ai 的 GLM-5 模型系列的设计及其在实际中的服务方式。
在我们的实时基准测试平台 InferenceX 上,GB300 以每秒 150 个 token 的响应速度,在我们的对比中提供了最低的建模服务成本。GB300 每 GPU 处理的 token 更多,尽管其每小时成本更高,但在成本效益方面仍优于 GB200。GB300 的结果使用的是 Dynamo-TRT-LLM,而 GB200 的结果使用的是 Dynamo-SGLang。
我们使用 9 月 17 日的 AgentX 快照结果来说明 GLM-5.3 的服务影响。我们使用 InferenceX 对超大规模基础设施拥有和运营成本的模型来估算费用。总 token 数包括输入和生成的输出,包括跨多轮重复使用的缓存输入历史。流式传输速度使用 p90 交互性进行测量;首 token 生成时间单独评估。
在每秒 150 个 token 的情况下,GB200 的成本约为每百万总 token 0.044 美元,而运行 ATOM 的 MI355X 为 0.238 美元。这意味着在相同的流式传输速度目标下,成本降低了约 82%。这些数值是从测量的曲线中估算得出的,而非在恰好每秒 150 个 token 的单独测试中获得。
对于此比较,我们使用 InferenceX 估算的超大规模基础设施拥有和运营成本。总 token 数包括输入和生成的输出,包括从缓存中重用的输入历史。
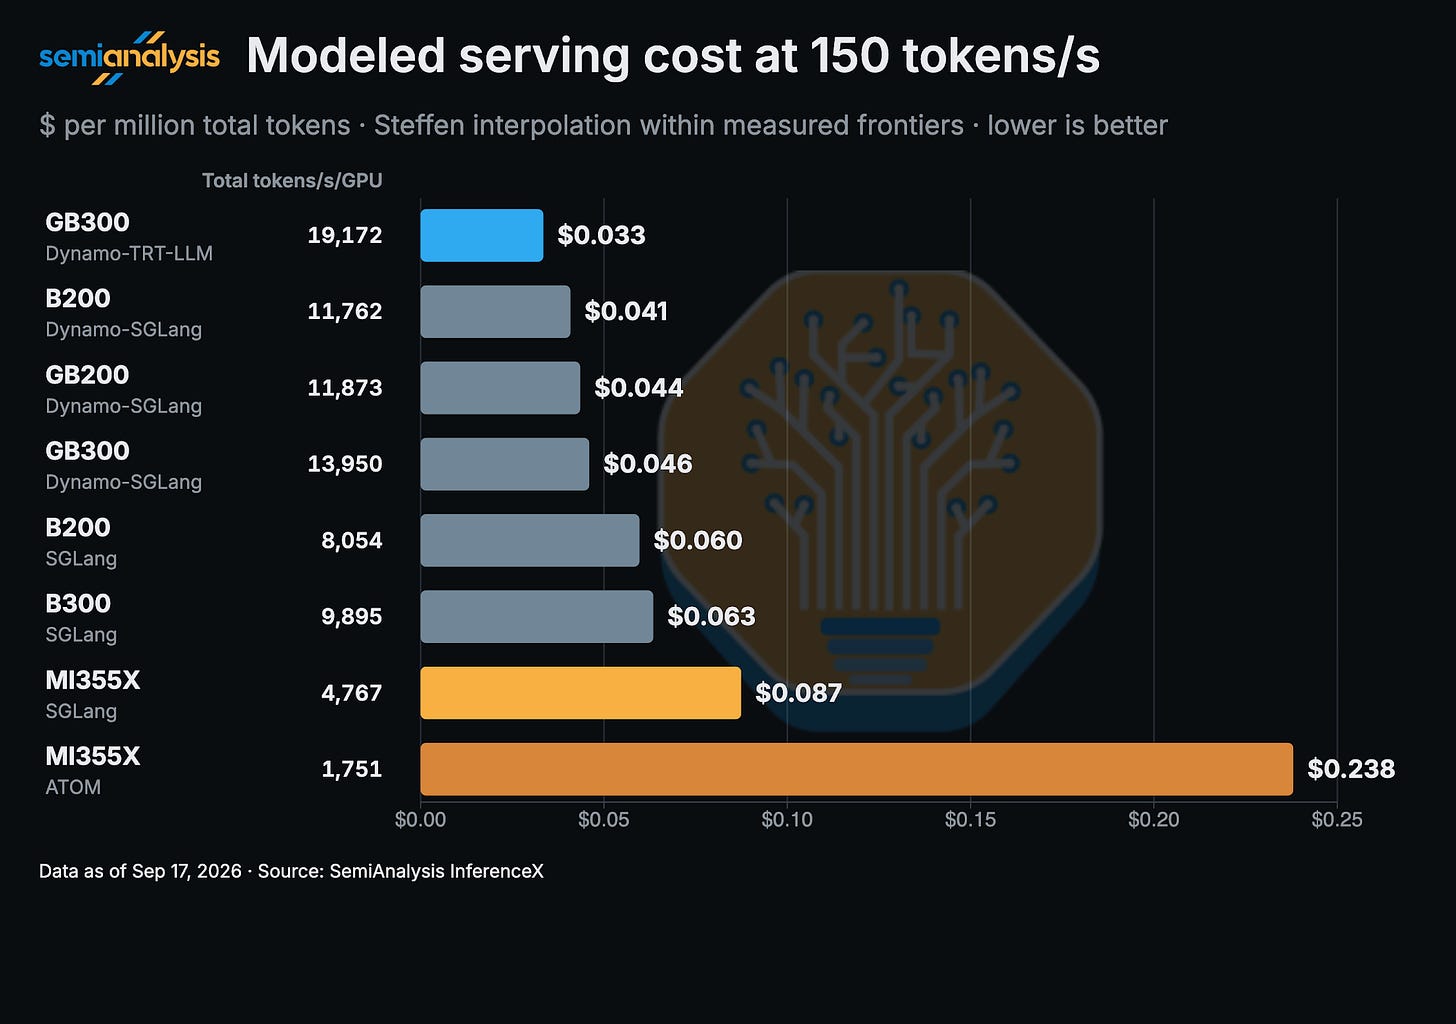
在 Dynamo-SGLang 的结果中,GB300 在此处每 GPU 每秒服务大约 13950 个总 token,相比 GB200 的 11873 个总 token,吞吐量优势为 17.5%。然而,我们假设 GB300 GPU 每小时成本为 2.31 美元,而 GB200 为 1.86 美元。较高的每小时成本抵消了 GB300 在此目标下的吞吐量领先优势。
在与 AMD 的比较中,在每秒 100 个 token 时,GB200 的成本比 ATOM 低约 52%;在 125 个 token 时低 62%;在 150 个 token 时低 82%。在这三个目标中,随着响应速度的增加,差距进一步扩大。
仅计算生成的输出,GB200 在每秒 150 个 token 的响应速度下,每百万输出 token 的成本为 5.92 美元,比 MI355X ATOM 的 28.52 美元低 79%。该指标对于分析代理工作负载下的成本非常有用,因为代理在生成相对较少的文本时,会反复重用长输入历史。
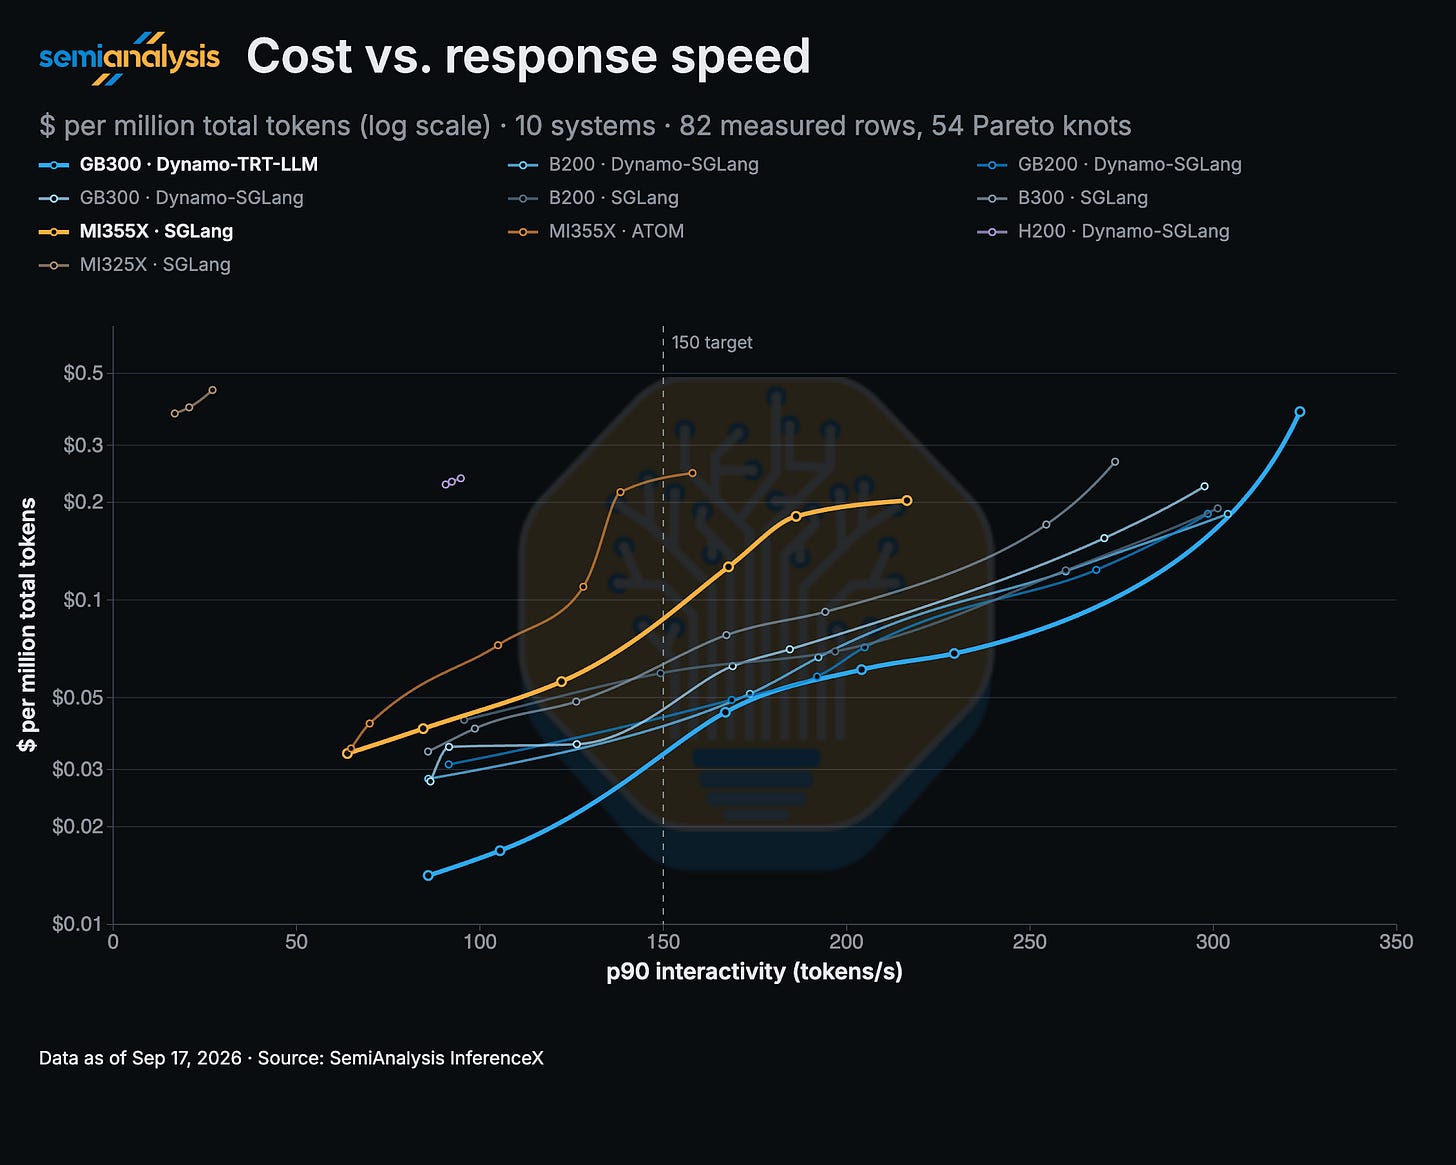
在目标速度每秒 150 个 token 两侧的 GB200 测量中,其 p90 TTFT(首个 token 时间)为 14-19 秒,而 MI355X ATOM 为 1.3-1.7 秒。部分 GB200 最低成本运行的首 token 等待时间要长得多。
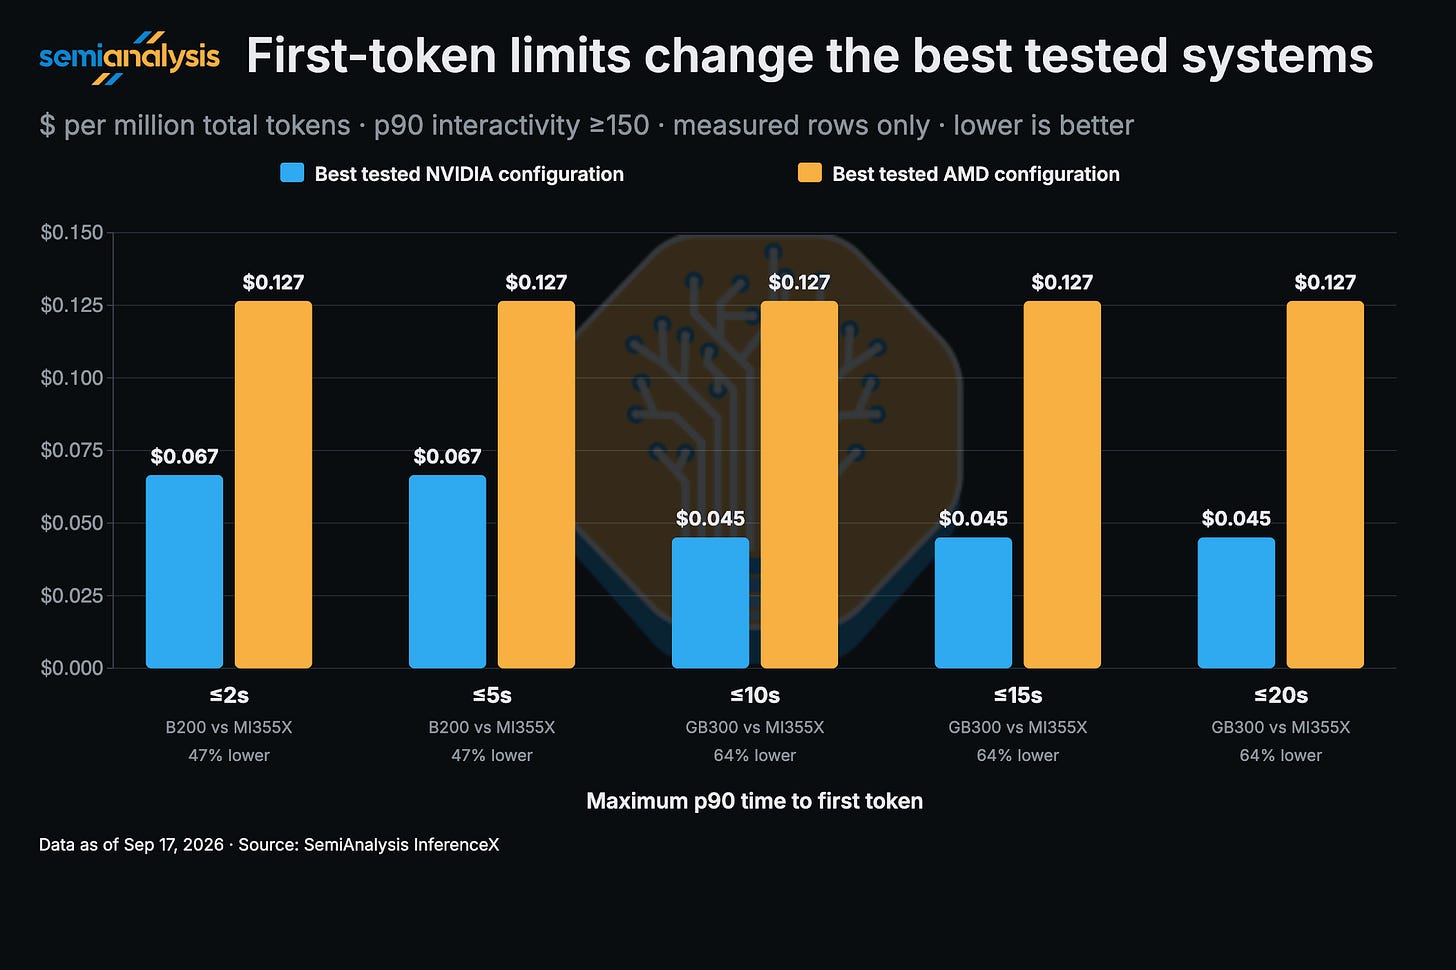
因此,我们使用另一项比较,仅包含实际测试并达到至少每秒 150 个 token 且 p90 TTFT 低于两秒的配置。下图显示,B200 配合 Dynamo-SGLang 每百万总 token 的成本为 0.0666 美元,而 MI355X 配合 SGLang 为 0.1265 美元。在限制首 token 时间的情况下,B200 的成本仍低约 47%。
优化措施
在 GLM 的 5.2 / 5.3 模型中,其注意力架构降低了内存需求,而长时间运行的代理仍需保留早期的对话历史。GLM 通过两种方式降低处理此历史的成本:KV 压缩减少了每个 token 存储的缓存状态量,稀疏注意力减少了每次注意力操作读取的状态量。随后,推理引擎将决定如何存储缓存以及如何高效地检索它。
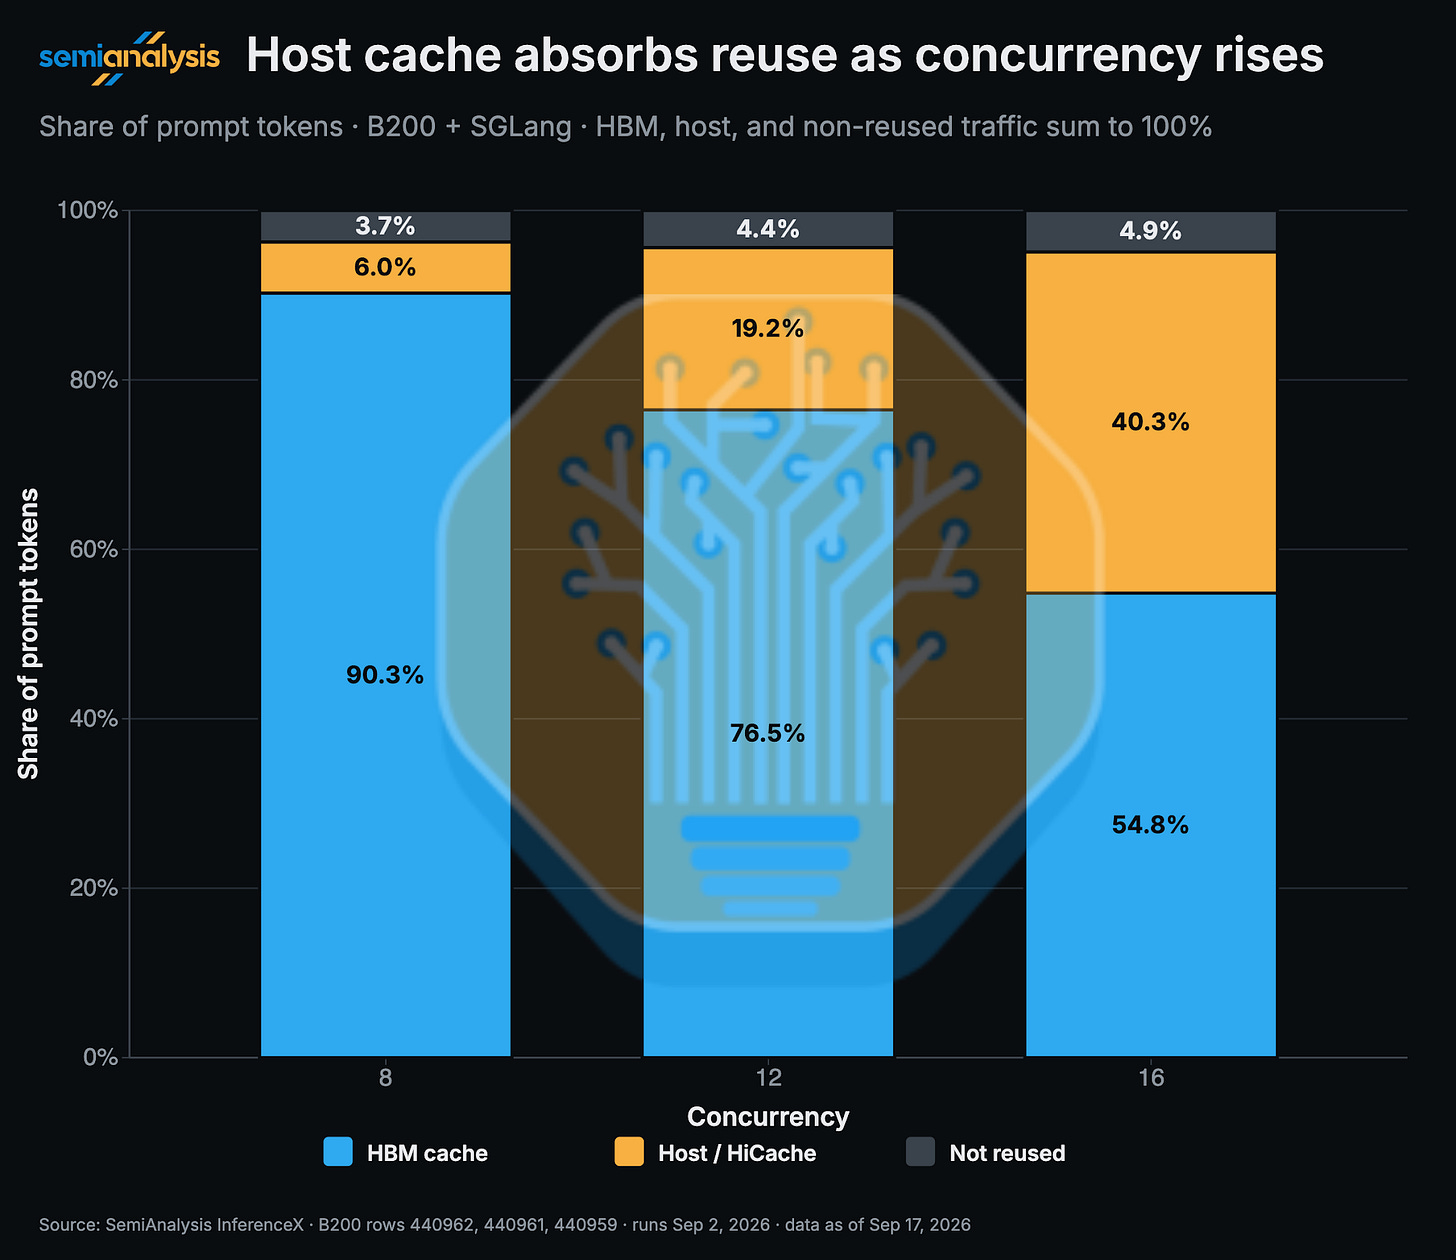
这些 B200 的结果展示了 GPU 内存之外可以发生多少复用。当并发量从 8 增加到 16 个请求时,从 GPU 内存重用的提示 token 比例从 90.3% 下降到 54.8%。大部分复用转移到了主机内存,主机内存的比例从 6.0% 上升到 40.3%。GPU 缓存的大量下降被主机内存的复用所抵消,使得在所有并发级别下整体缓存命中率保持在 95% 以上。
除了缓存管理外,推理引擎执行预填充和解码的方式变化也会改变性能。两项独立的 GLM-5.2 研究说明了这一点:
- 在 NVFP4 研究中,vLLM 将第一个解码步骤保持在一致的 CUDA 图执行路径上,使平均 TPOT(每个输出 token 的时间)从约 40 毫秒降低到 22 毫秒。
- 在另一个涉及 8 个 MI355X 的长上下文工作负载中,ATOM 引擎跨流水线阶段分块处理预填充,使总吞吐量提高了 98%,并将中位 TTFT 从 28.6 秒降低到 8.7 秒。
TileRT
对于 TileRT 上的 GLM5.3,AMD MI355X 率先得到支持。TileRT 是一个低延迟的大语言模型推理引擎,它将解码编译为单个持久内核,从而减少启动开销,并重叠计算、内存访问和通信。
它优先考虑每个用户更快的 token 生成,而不是最大批量吞吐量,同时由 vLLM 处理预填充。

NVIDIA GPU 上的超高交互性?- TileRT InferenceX
在 AgentX 上,FP8 TileRT MI355X 实现的 P90 交互性是最佳 FP4 MI335X 配置的两倍。与 GB300 NVL72 相比,其交互性提升了 40%。这些是曾经需要专用硬件才能实现的推理指标。
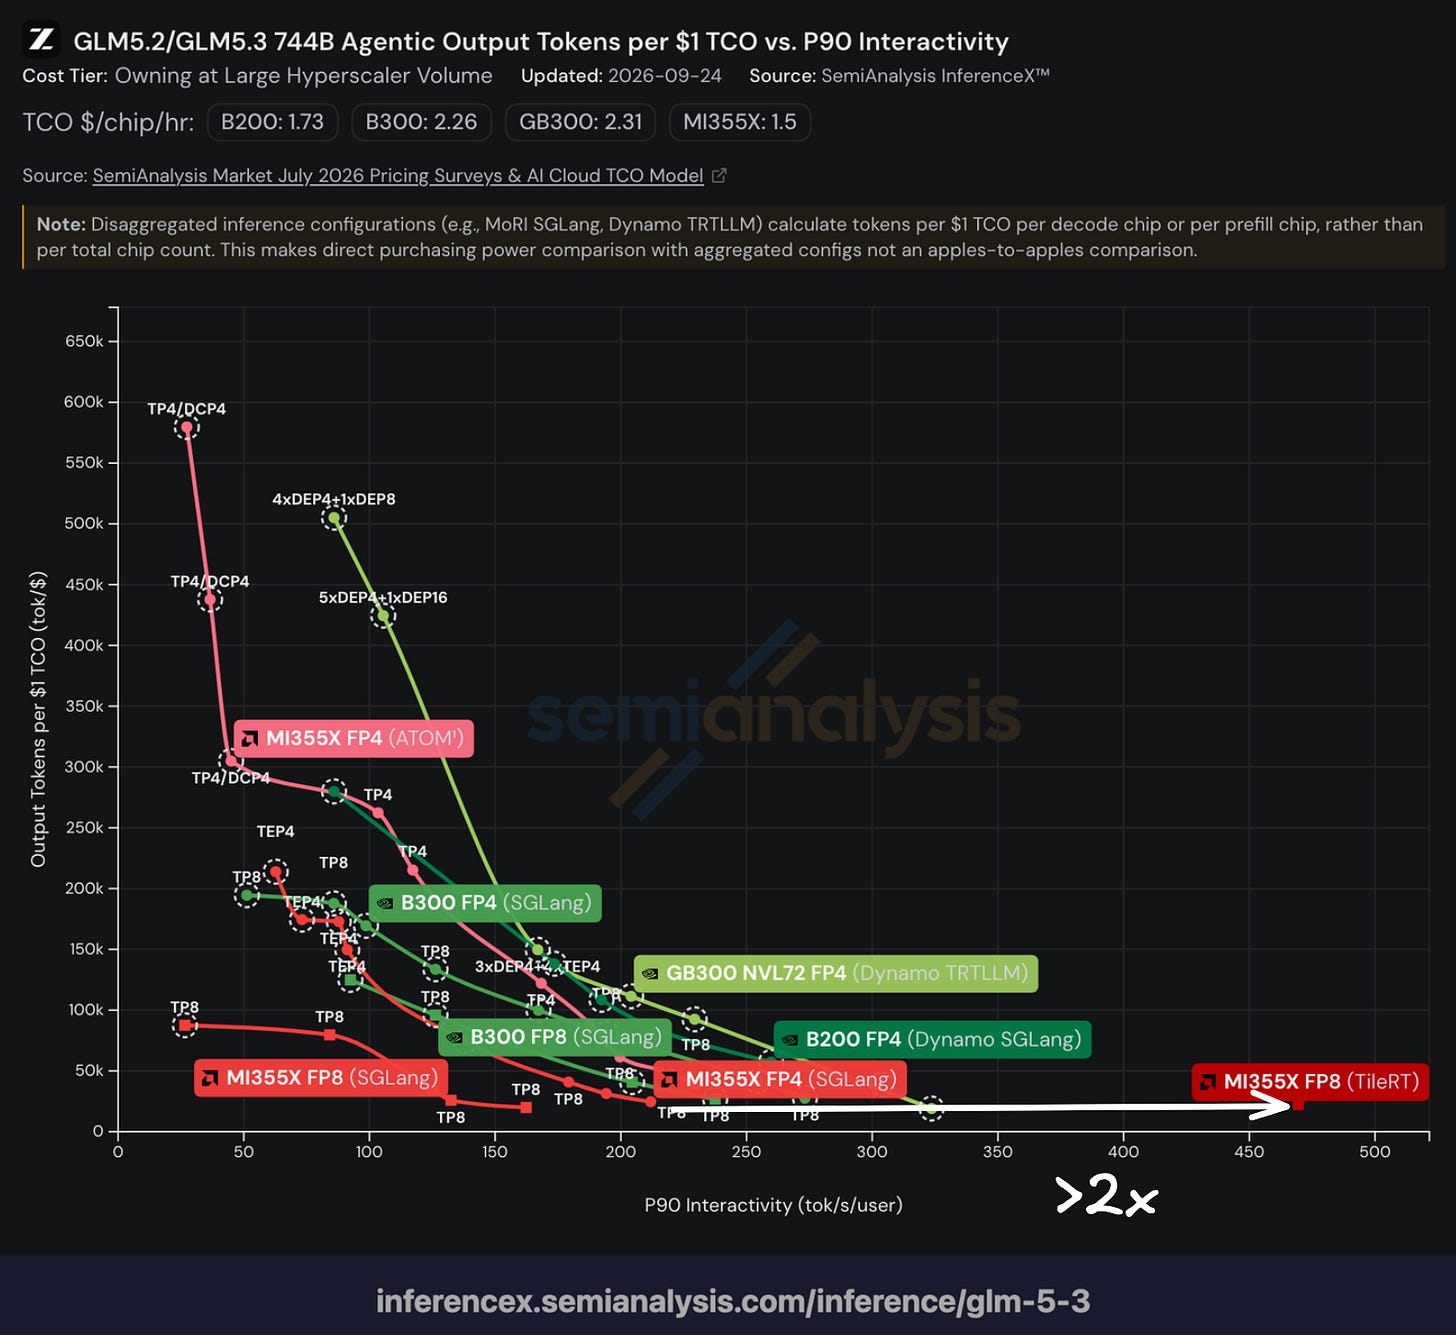
然而,TTFT 并非最优,仍有改进空间,例如优化 KV 传输、支持 FP4 以及更大的批次大小。
GLM-5(及 GLM-5.x 系列模型)是一个总参数量为 744B、激活参数为 40B 的混合专家模型。对于每个 token,它有一个共享专家,并从 256 个专家中的 8 个进行路由,稀疏度为 32。它具有 DeepSeek 稀疏注意力机制,我们将在本节中讨论。
DeepSeek 稀疏注意力(DSA),引入于 DeepSeek V3.2,由两个组件组成:一个选择前 K 个 token 的光速索引器,以及一个稀疏的多潜注意力(MLA)。
光速索引器
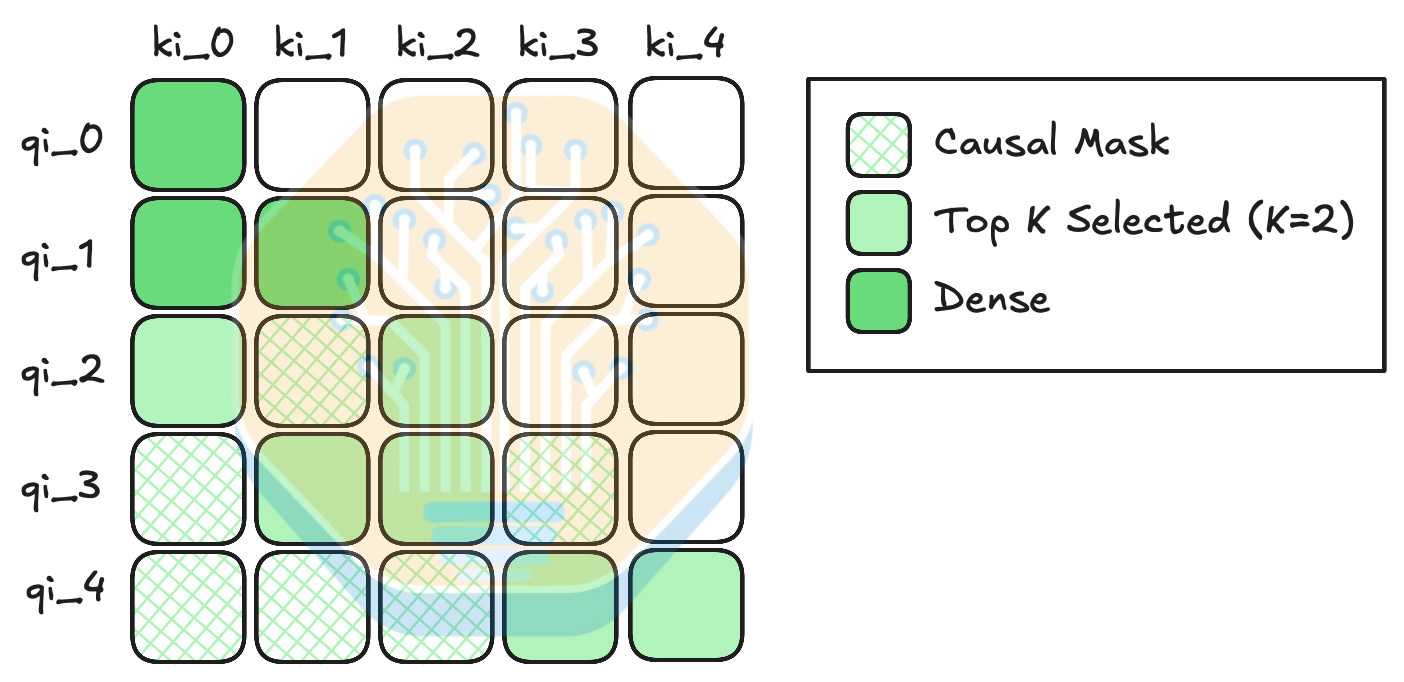
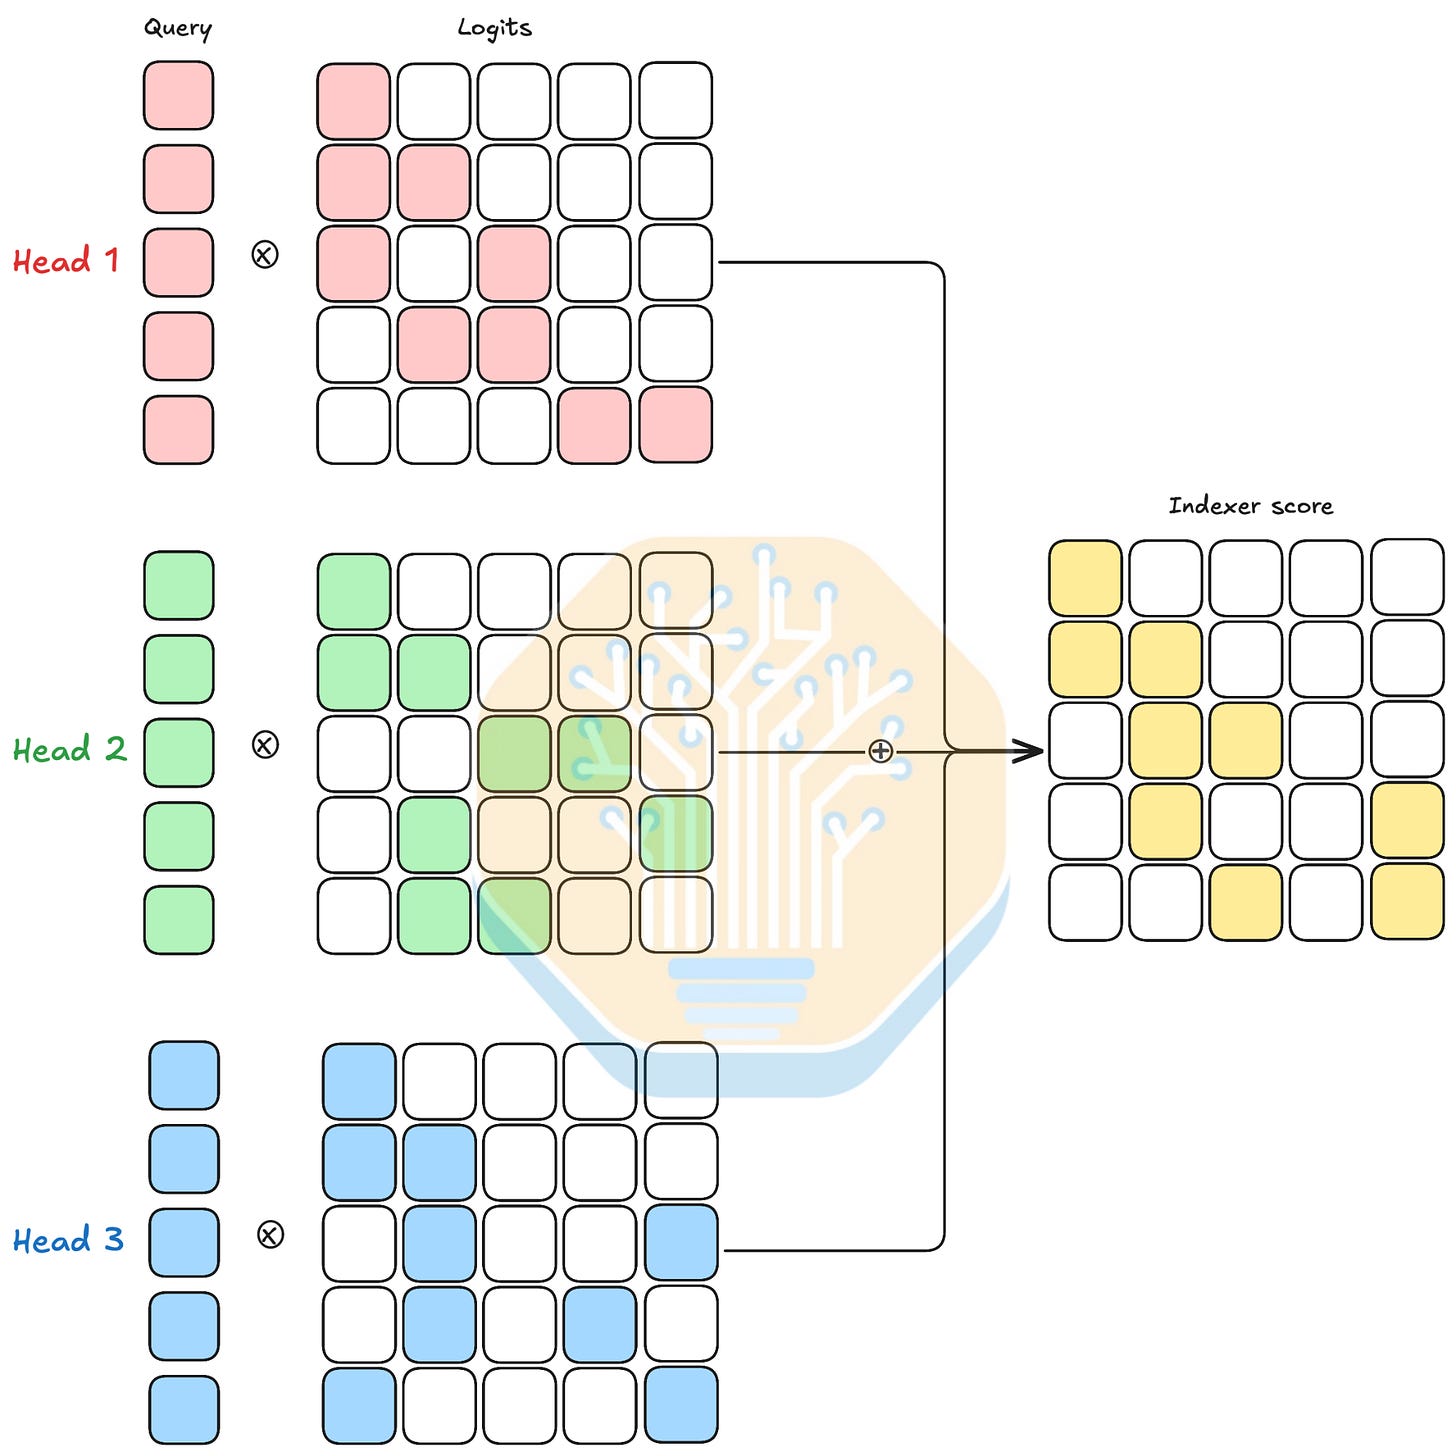
闪电索引器在功能上类似于轻量级注意力机制。查询和键被投影到低维空间,其中索引器的查询是多头的,而索引器的键是单头的。由于我们只需要一个查询-键关系得分(logits)来选择前 K 个 token,因此索引器不需要值嵌入或用于归一化 logits 的 softmax 操作。相反,它计算查询-键的点积,随后进行 ReLU 非线性变换。然后,索引器将每个 token 的索引器得分计算为所有查询头 across 的 logits 的加权和,我们利用该得分选择前 K 个 token。这意味着尽管索引器具有多个头,但 token 的选择是在多个注意力头之间共享的。在选择前 K 个 token 时,对于关注少于 K 个 token 的查询,我们保留为密集注意力;否则,我们选择前 K 个 token。
稀疏 MLA
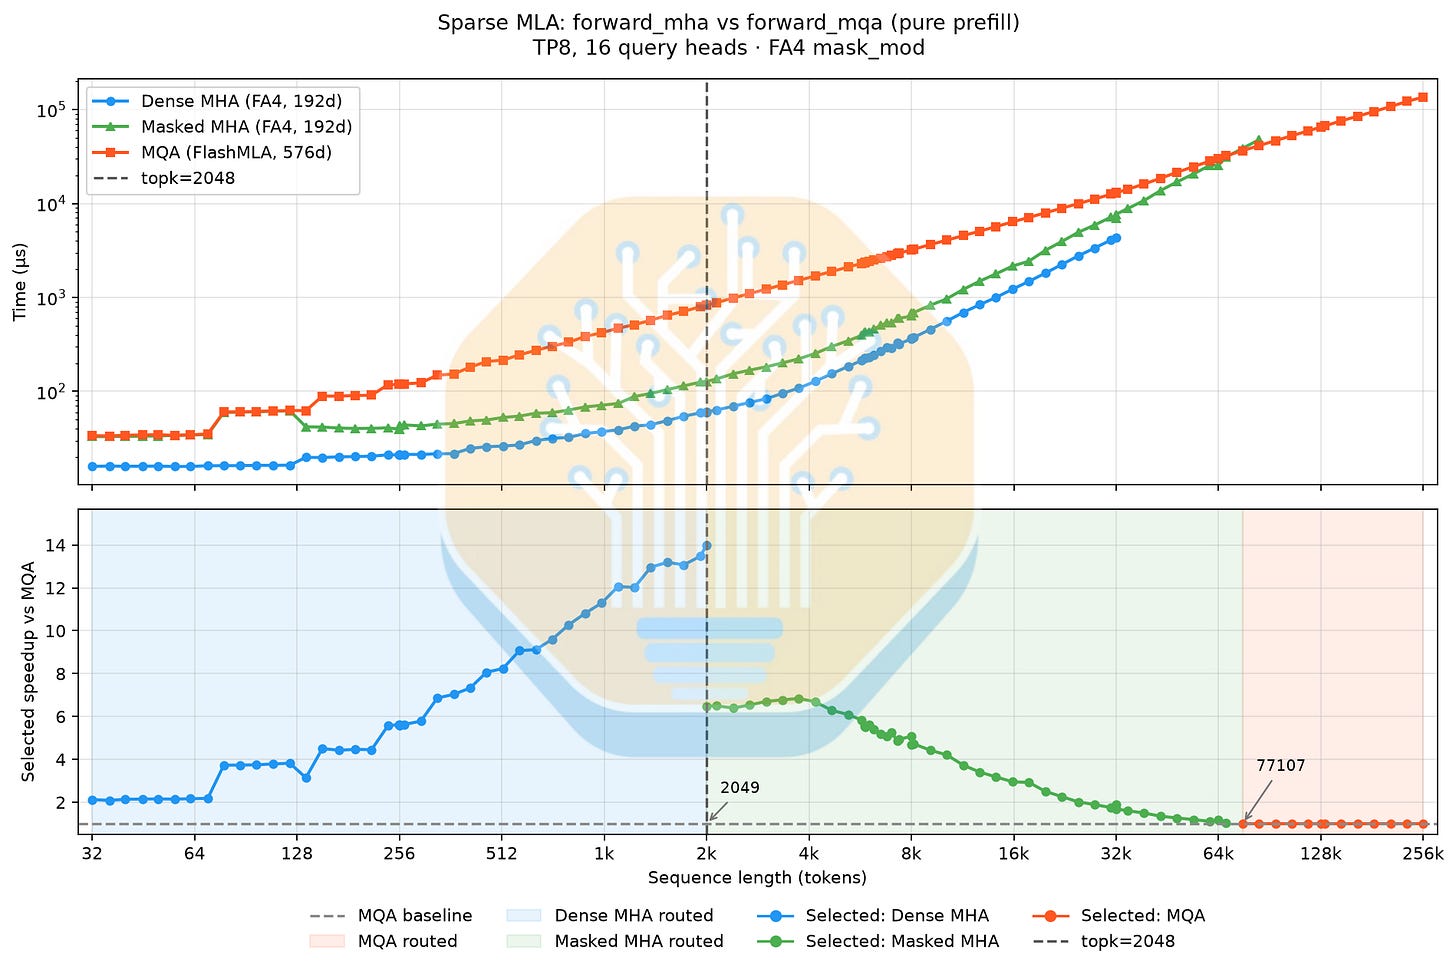
正如我们在 Kimi K3 文章中解释的那样,MLA 运行在两种模式下:多头注意力(MHA)模式和多查询注意力(MQA)模式。两者各有权衡:MHA 模式的 FLOPs 较低,但内存成本高出 42 倍;MQA 模式的内存成本较低,但 FLOPs 最高高出 3.4 倍。DSA 使用 MQA 模式,因为稀疏注意力关注的 token 较少,从而缓解了较高的 FLOP 使用量。然而,在实践中,存在一个序列长度阈值,低于该阈值时,MHA 模式实际上比 MQA 模式更高效。直观地说,在较短的序列长度下,内存加载时间不再占主导地位,而 MHA 模式可能因 FLOPs 较低而具有优势。vLLM 实现了此功能,并为数据并行配置了序列长度从 2K 到约 5K 的 MHA 模式,为张量并行配置了序列长度从 2K 到约 77K 的 MHA 模式。2K 的最小值是由于 top K 为 2048,并且如上所述,低于 2K 的注意力是密集的。
MLA 修改
比较 GLM-5 和 DeepSeek V3.2 的 MLA 维度配置,我们看到最显著的区别是查询头的数量和查询键头维度。
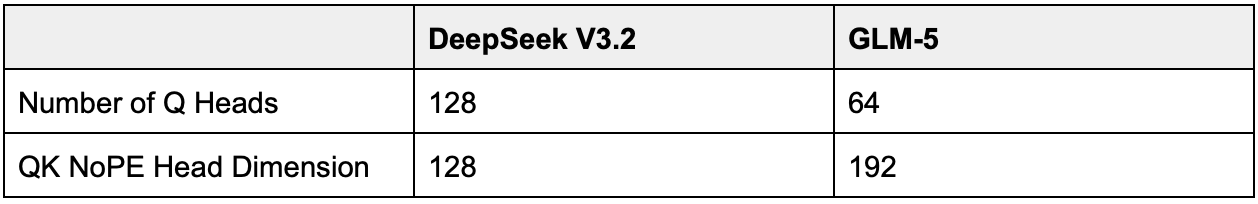
GLM-5 技术报告提到,DeepSeek 根据 H800 的屋顶线选择了查询头的数量。这可能指的是以下事实:MLA 在解码过程中的 SDPA 算术强度大致处于 H800 的脊点。推导如下。假设
- L: 序列长度
- d: 头维度
- r: RoPE 维度
- H: 头数量
- b: 每个参数的字节数
2 * H * L * (d+r)  # P = Q [H, d+r] @ K.T [d+r, L]
2 * H * L * d      # O = P [H, L] @ V [L * d]
以及加载的内存为
b * H * (d+r)  # Q
b * L * (d+r)  # K and V
(2 * H * L * (2 * d + r)) / (b * (d+r) * (L + H))
= (2 * H * L * (2 * d + r)) / (b * L * (d + r)) # L >> H
= (2 * H * (2 * d + r)) / (b * (d + r))如果代入 DeepSeek V3.2 的配置 d = 512, r = 64, b = 2),我们得到
(2 * H * (2 * 512 + 64) / (2 * (512 + 64)) ~= 2 * HH800 的实际算术强度为 258.2 FLOP/B(根据 DeepSeek 的数据,实际峰值为 865 TFLOP/s,带宽为 3.35 TB/s),代入公式得出 H ~= 128。
GLM-5 拥有 H = 64,即查询头数量的一半,这意味着 GLM-5 可能是为不同的硬件设计的。如果我们代入 GLM-5 的配置(d = 512, r = 64, b = 2, H = 64),我们得到的算术强度为 120.8 FLOP/B。因此,我们怀疑 GLM-5 针对 Moore Threads MTT S4000 进行了优化,其算术强度约为 128 FLOP/B。Moore Threads 与 Z.ai 的合作,例如 GLM-5.3-Flash 的 day 0 支持,证实了我们的理论。
另外,GLM-5 将 QK NoPE 维度从 128 增加到 192,因为消融实验表明,在等 FLOPs 和等参数约束下,该配置更优。这将 SDPA 头维度从 192 增加到 256,考虑到头数量的减少,这仍然减少了 33% 的 FLOPs。
IndexShare
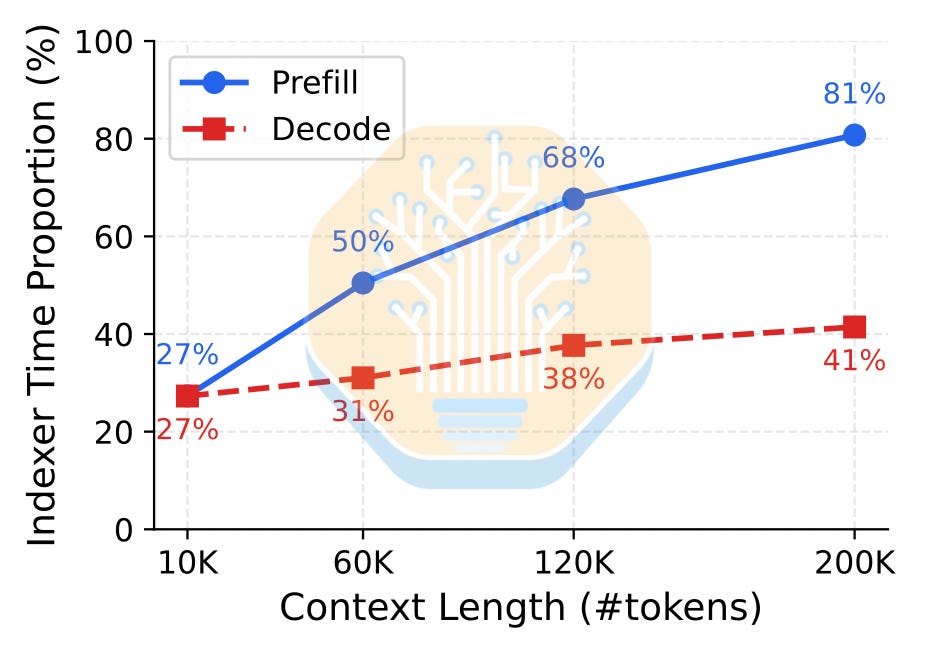
随着上下文的增长,索引器的延迟成本变得不可忽视。为了缓解这一成本,Z.ai 在 GLM-5.2 中提出了 IndexShare(也称为 IndexCache),其中每 4 个 DSA 层共享一个索引器。
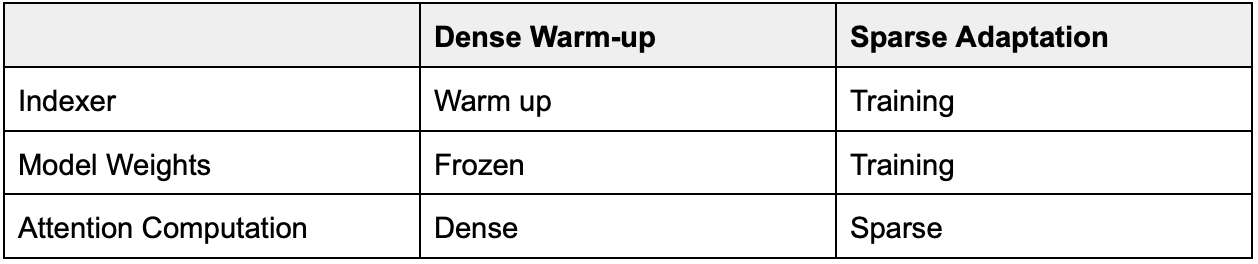
IndexShare 在训练和推理过程中引入了复杂性。标准的 DSA 训练包含两个阶段:首先是密集预热阶段,在此阶段除索引器外的所有模型权重均被冻结,且注意力计算为密集模式;随后是稀疏适应阶段,在此阶段使用稀疏注意力对完整模型进行训练。
在训练目标方面,索引器旨在与注意力头分数的总和对齐,采用 KL 散度作为优化目标。IndexShare 将训练目标调整为使索引器的 logit 分布与共享层中注意力分数的平均分布对齐。
在推理阶段,通常索引器会缓存键值(keys),类似于注意力缓存中的 KV。由于多个层共享同一个索引器,我们需要在全层额外缓存 Top K 索引,以便在共享层中复用 Top K 的选择信息。
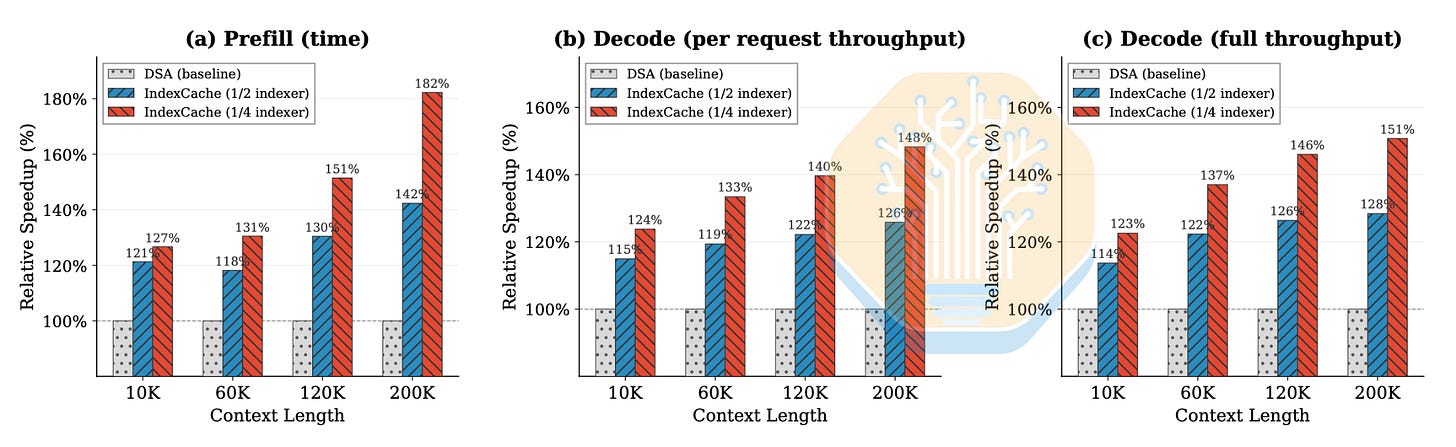
该设计将索引器缓存减少了 75%,将索引器的 FLOPs 减少了 75%,并在不同的上下文长度及预填充/解码阶段将吞吐量提升了 1.5 倍至 1.8 倍。
流水线
在完成预训练和中训练后,GLM-5 的后训练流水线从监督微调(SFT)开始,接着进行三个强化学习(RL)训练阶段(推理 RL、智能体 RL 和通用 RL),最后通过同策略跨阶段蒸馏,将推理 RL 和通用 RL 的知识蒸馏回 SFT 检查点。
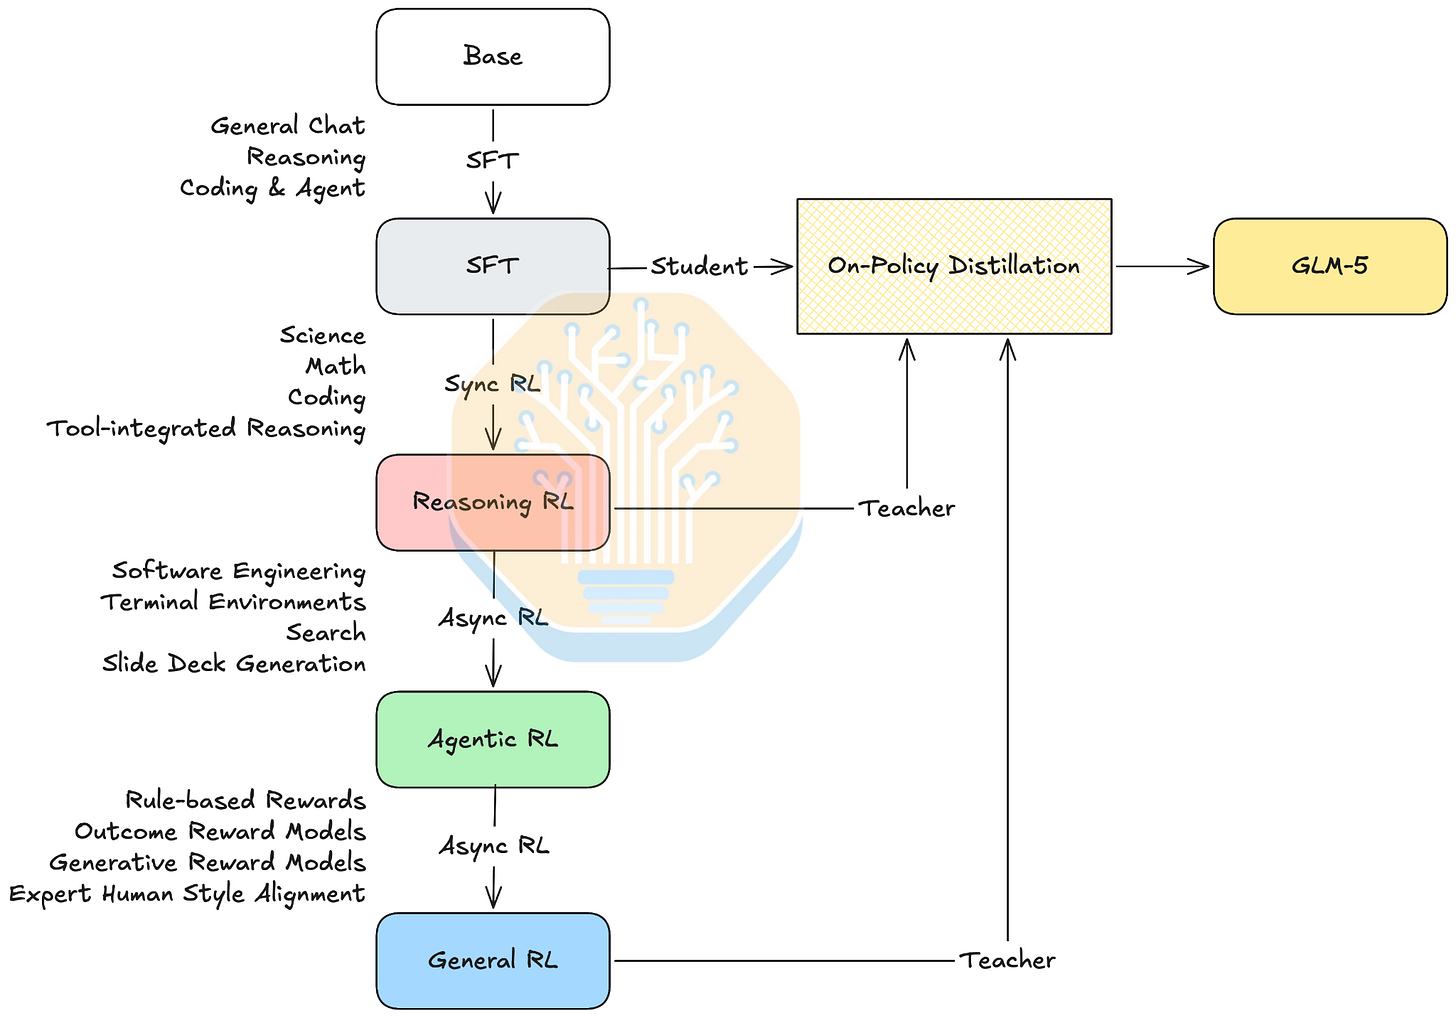
此处强调两个细节。首先,技术报告指出推理 RL 模型完全采用同策略训练,这意味着它是同步训练的。同步 RL 训练的系统效率较低,但具有更高的训练稳定性。其次,同策略跨阶段蒸馏类似于多教师同策略蒸馏(MOPD),其中学生模型通过基于多个教师模型的同策略蒸馏进行 RL 训练。然而,与旨在将专家教师模型合并为一个模型的 MOPD 不同,GLM-5 在此似乎更侧重于当模型学习新能力时恢复旧能力的损失。基于这一假设,我们不确定为何 Z.ai 仅使用推理和通用 RL 检查点作为教师,而不是使用全部三个 RL 检查点。
根据公告博客文章,GLM-5.2 可能已用标准的 MOPD 流水线替换了同策略跨阶段蒸馏,Z.ai 将其命名为并行 OPD 训练。Z.ai 强调了其规模和训练效率:他们通过约两天的训练,将十多个专家模型合并为一个最终模型。
RL 训练算法
Z.ai 针对同步和异步 RL 阶段采用了不同的 RL 算法。此处我们比较 RL 目标的主要差异。
在同步 RL 阶段,Z.ai 采用了基于组相对策略优化(GRPO)的 RL 算法,并进行了现代化改进,包括:
- 移除 KL 正则化项以提高系统效率并允许更激进的梯度更新
- IcePop:基于训练-推理不匹配比率应用令牌级掩码
- Clip-Higher:使用更高的重要性采样比率最大阈值以鼓励探索
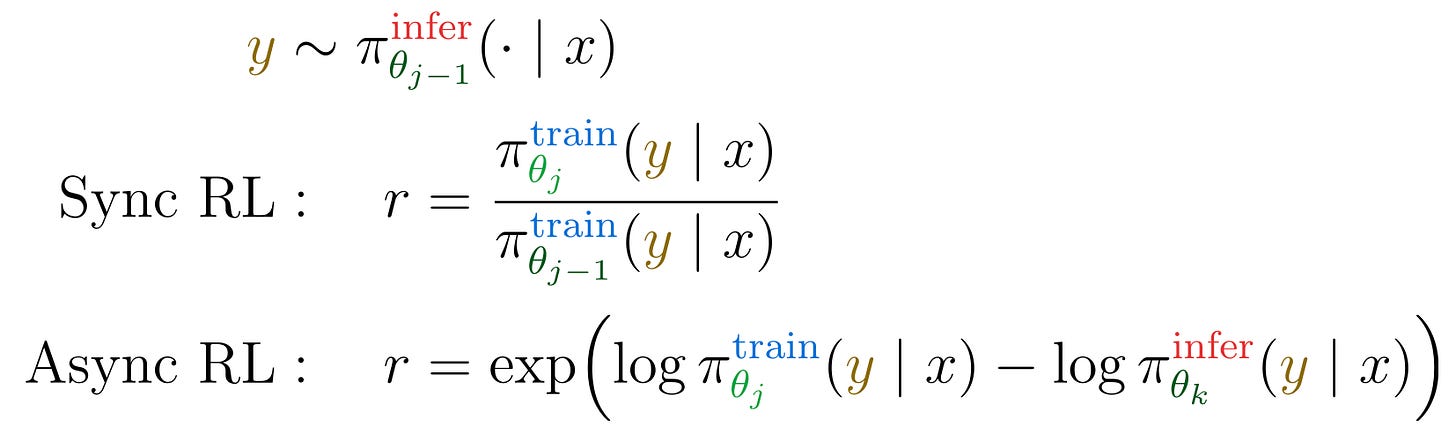
相比之下,Z.ai 在异步 RL 阶段采用了一种类似 REINFORCE 的 RL 算法,并添加了直接双面重要性采样(DIS)以及一种类似 IcePop 的裁剪机制。以下比较了两个 RL 阶段的令牌级目标:
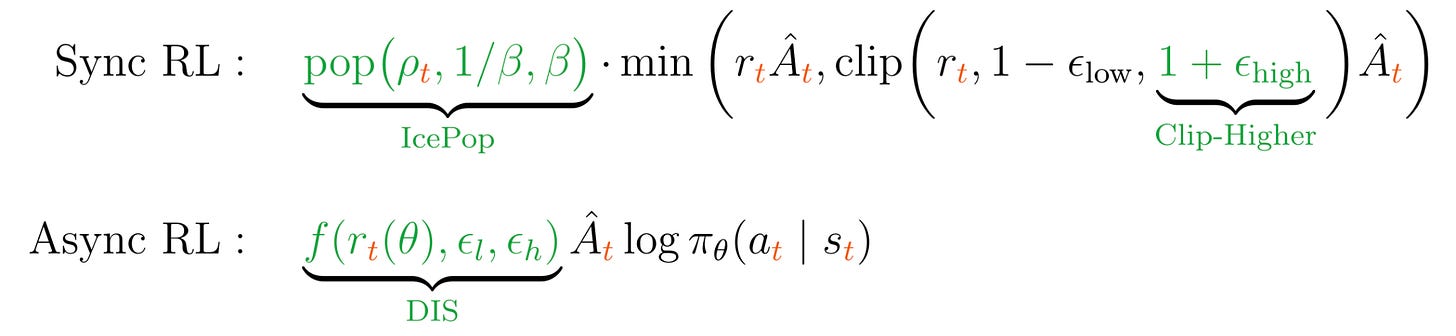
重要性采样(IS)比率比较了当前策略与行为策略下每个采样动作的概率,并对每个动作对训练目标的贡献进行缩放。对于 IS 比率,同步强化学习阶段使用上一轮迭代的训练器策略作为行为策略,而异步强化学习阶段则使用该阶段的推理策略。在异步训练设置中,策略更新在 rollout 期间发生多次,因此我们需要计算中间所有检查点版本的 IS 比率。然而,由于高昂的内存和延迟开销,这是不可行的。因此,Z.ai 为了效率和简洁性选择使用推理策略,但这以数值稳定性挑战为代价。
最后,我们强调强化学习训练、交叉蒸馏和长视界强化学习训练中优势计算的主要差异。RL 训练采用 GRPO 标准的组归一化优势,而交叉蒸馏使用反向 KL 散度。
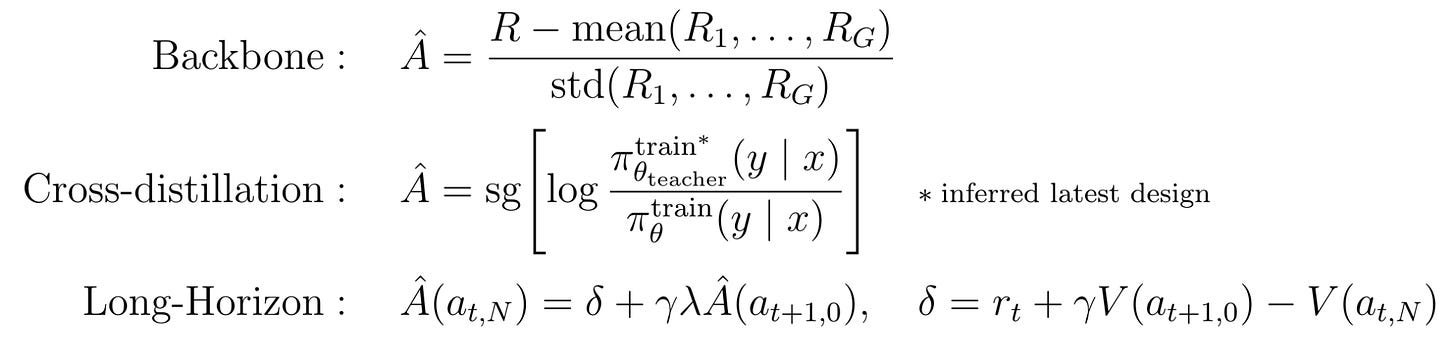
单次 Rollout 异步优化
长视界任务会产生极长的轨迹,而在 GRPO 的背景下,轨迹长度的高方差会产生不稳定的训练信号,这些信号可能会向较长的轨迹倾斜。更糟糕的是,由于 RL rollout 工作负载对端到端延迟敏感,长视界任务中拖后腿的 rollout 的尾部延迟会恶化。为了缓解这个问题,Z.ai 在 GLM-5.2 中引入了用于长视界 RL 训练的单次 rollout 异步优化(SAO)。SAO 用修改后的广义优势估计(GAE)取代了组归一化优势,其灵感来源于近端策略优化(PPO)。GAE 只需要一次 rollout 即可计算优势。这消除了每提示词进行多次 rollout 的需要,从而缓解了 GRPO 的短处。
GAE 通过值模型估计的值(在 RL 术语中,即当前状态的期望回报)来计算。具体来说,值模型将 rollout 作为输入,并为每个 token 产生一个值估计。SAO 通过从优化中移除观察 token(即工具调用结果),将 GAE 适应于代理式 RL 训练。之前在 GLM-5 中,跳过这些 token 就足够了;在 SAO 中,我们修改了优势估计公式以绕过观察 token。更多关于贝尔曼目标和消融实验的直觉,请参阅 SAO 论文及其附录 A.1。
在 SAO 中,值模型是一个与策略模型并发训练的独立大语言模型。这意味着在训练的早期阶段,由于值模型较弱,优势计算的方差很高。为了应对这一问题,SAO 提出了多种训练值模型的技术:
- 双时间尺度更新规则:以比策略模型高两倍的频率更新值模型。这意味着在每个策略训练步骤中,对每个数据批次进行两次训练
- 注意力参数冻结:冻结值模型的完整注意力层以提高训练稳定性
- 扩展预训练:扩展值模型的预训练语料库以初始化值模型,从而使值模型能够在训练早期稳健地估计值。不幸的是,Z.ai 没有披露预训练语料库的扩展信息
以计算开销和内存占用翻倍为代价,SAO 用值模型取代了组采样,从而缓解了 GRPO 的延迟问题。
后训练基础设施
Z.ai 在整个 GLM-5 系列模型的后训练基础设施中使用了 slime,这是一个优秀的开源 RL 训练框架之一。我们建议读者访问 slime GitHub 仓库以了解其设计和功能,在此我们突出两个特性。
强化学习(RL) rollout 的性能特征高度依赖于具体任务,每个任务都配备不同的工具和奖励函数。为确保系统效率,Z.ai 设计了一种基于服务器的多任务 rollout 编排器。每个任务作为一个独立的微服务服务器运行,控制 rollout 和奖励逻辑。该编排器平衡整体性能,控制各任务的 rollout 比例和生成速度。集中化管理还允许跨任务动态调整比例、进行细粒度的进度监控等。Z.ai 声称,在训练 GLM-5 时,该编排器支持 1000 个并发 rollout。
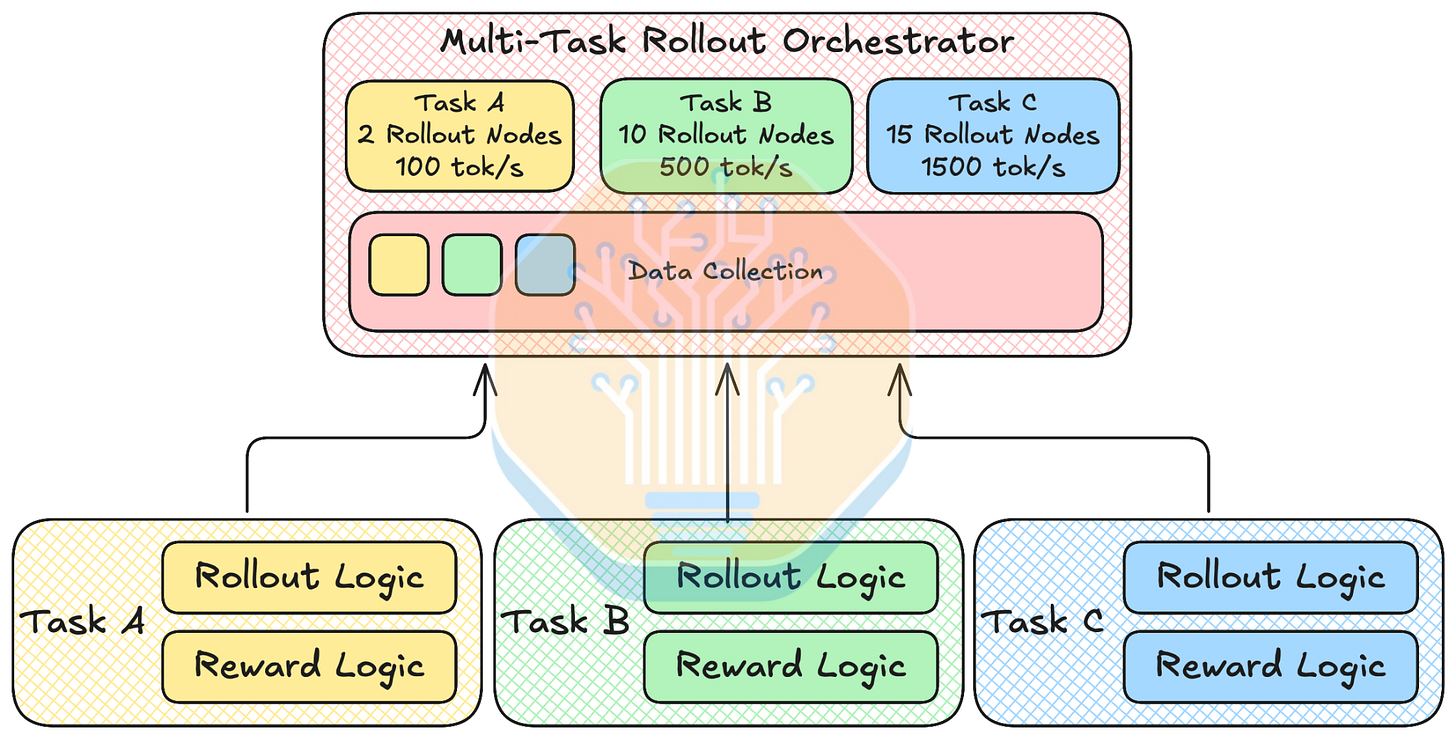
在 GLM-5.3 的公告中,Z.ai 声称除了主机内存外,还使用本地存储作为缓存层,从而实现 MOPD 的动态教师模型切换和预取。slime PR#1538 通过引入 TensorBackuper 类实现了教师模型切换,该类将教师权重存储为固定到 CPU 内存的 PyTorch 张量。当 rollout 被路由到某个教师模型时,TensorBackuper 对象会将教师模型复制回 GPU 内存以执行前向传播(实现细节见此处)。然而,这是基于 CPU 的权重交换机制,我们尚未见到基于存储的实现方案。
在我们的付费章节中,展示了我们对 GLM-5.3 网络安全能力的分析。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。