精选
OpenAI 发布由前沿模型生成的全新数学成果
OpenAI 在 GitHub 上公开了由其内部前沿 AI 模型生成的大量数学研究成果,其中包括对前 500 个开放数学问题中 90 个的解答。此举标志着 AI 在基础科学探索领域的重大进展。
这确实是一件大事。OpenAI 发布了一系列由内部前沿模型产生的庞大新数学成果,并全部上传至 GitHub。
根据 Proof of Atlas 的数据,其中包含了数学界前 500 个未解问题中的 90 个。总计有 722 份手稿(由于集群中有三份撤回且缺乏 Lean 证明,现余 719 份),被整理为 372 个家族。
这是单一模型的结果,很可能是那个产生纳维-斯托克斯方程证明的同一模型(如其链接回该帖所示)。该模型主要基于单个提示词(准黎曼猜想是少数例外之一),在尝试解决约 4,000 个问题后,平均每个找到的解决方案耗费了约三小时的计算资源。提示词中包含类似这样的内容:“即使问题是‘开放’的,你的意图也应该是解决它并呈现完整的解决方案。”OpenAI 所付出的努力远未达到极限。
Levant 等人将 2026 年 10 月 6 日称为“显然是数学历史上最重要的时刻”。
目录
- 我们证明了什么?
- 数学末日。
- 世界并不理解。
- 目前你仍可做数学。
- 你需要寻找一个新问题。
- 验证或评估并不总是比生成更容易。
- 破解代码。
- 永不改变。
- 数学家们状况不佳。
- 局势变得严峻。
- 咨询小组回应。
- 另一个数学小组回应。
- 不同的方法。
- 三次撤回。
- 拥抱 Lean。
我们证明了什么?
这里有一组关于顶级问题的常识性图形解释线程(当然由 AI 制作)。它们看起来像这样:
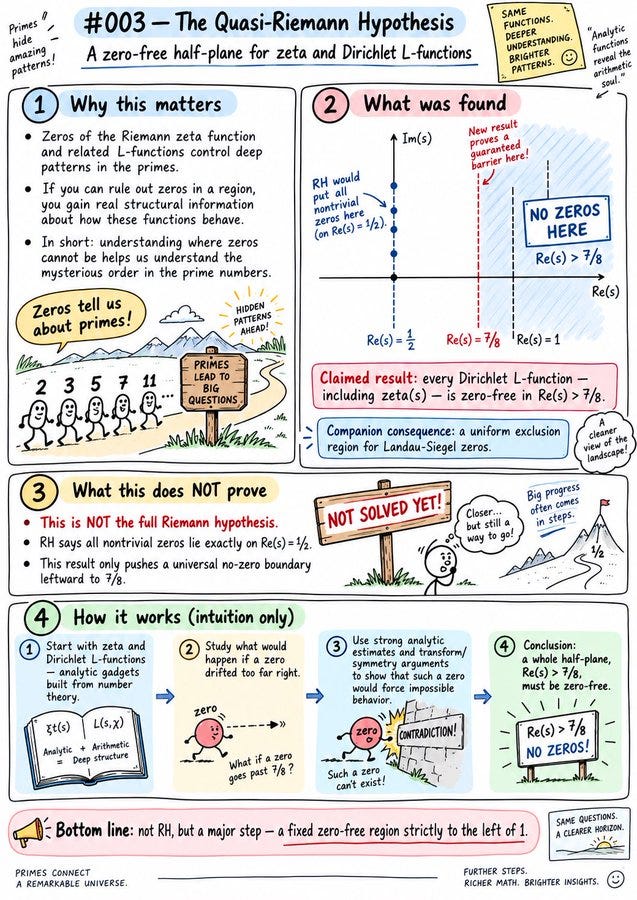
以下是文本摘要:
首先,头条新闻是关于黎曼猜想的重大突破。它并非对猜想的完整解答,但极大地收紧了界限。矩阵乘法效率达到 2.25 可能会产生最实际的影响。
也许吧,但我们尚未找到在实际中更快的场景。
这还不是一个完全实用的结果,但矩阵乘法占据了全球计算量的大部分。这可能开启一种全新的方法。整数乘法可能是最令人震惊的结果。与矩阵乘法类似,它是一种“渐近简化”。同样如矩阵结果那样,它也不具备实用性。但很少有人能预测之前的壁垒会被打破,哪怕只是轻微地。关于 Pi 的结果未必是最重要的,但可能最有趣。而且很可能足够通俗易懂,连你的孩子都能理解。基本上就是在探讨 Pi 的无理性程度如何。唯一游戏也是一个相当重大的成果,因为和黎曼猜想一样,它与数学中最重要问题之一的 P vs NP 相邻。明确地说,这并非直接关于 P = NP 本身,但它揭示了关于 NP 困难问题根本限制的新见解。从技术上讲是两个问题,但由于它们在证明和含义上的相似性,我将它们归为一类。霍奇猜想和 Birch-Swinnerton-Dyer 猜想都非常抽象。但它们对代数几何都至关重要,因此在黎曼猜想之后,它们可能是这套成果中最重要的结果。希尔伯特第十问题则是另一个计算机科学问题。但与 P vs NP 不同,它甚至不涉及计算上难以解决的问题,而是关于某类问题是否存在可计算的解。最后但同样重要的是哈德维格关于图着色的研究。它在整套成果中也以最具震撼力的结果排名。它基本上推翻了我们认为在图中是最基本关系之一的某种东西。
以下是关于代数数论中一些成果的分析。
这一切有什么用呢?Ole Lehmann 的 AI 提到了其在聚变研究、便携式人体扫描仪、匹配系统、组织扫描、量子传感器以及自动驾驶汽车和机器人的安全检查等方面的应用,以及其他用途。
数学末日
Alex Kontorovich:准黎曼猜想(Quasi-RH)?!难道你在开玩笑吗?如果是人类做到的,这毫无疑问会立即获得菲尔兹奖。黎曼猜想指出 zeta 函数在 Re(s)>1/2 区域没有零点。直到一秒钟前,我们最好的结果是一个随着虚轴向上延伸而越来越窄的区域。我原以为他们能把这个区域稍微拓宽一点,那将是一项巨大的突破。但并没有。他们得到了一个无零点区域!!太疯狂了。是的,也没有西格尔零点(Siegel zeros)。所以我猜这是两座菲尔兹奖……
准黎曼猜想并非完整的黎曼猜想,但它足以用于许多目的,例如在不使用随机抛硬币的情况下快速计算模素数的平方根,或者对给定数值以下素数的数量获得更精确的估计,而一篇姊妹论文则触及了阿廷(Artin)1927 年原始根猜想的核心理论。
Steven Strogatz:这里有许多令人震惊的结果。但这一条尤其惊人:矩阵乘法的指数不超过 2.25。之前的世界纪录大约是 2.37。这一进步飞跃堪比鲍勃·比蒙(Bob Beamon)的跳远纪录。Isaac Kim:这份清单包含了量子信息、多体物理和量子计算领域(这些是我珍视的领域)中令人震惊的一系列问题,数量之多不胜枚举,但我挑选以下几项:1. 二维面积律的证明;2. 自旋-1 霍尔丹能隙(Spin-one Haldane gap);3. 奇偶性不在 QAC^0 中;4. 常数误差 Aaronson-Kuperberg 猜想;5. 酉顶点算子代数生成共形网。事态变化迅速。我甚至无法想象未来几个月会发生什么,更不用说一年了。will depue:我问过 GPT 6 Pro 和 Fable 5.1 对过去三年的所有发现进行排名 🔵 代表人类发现 🔴 代表 AI 发现(10 月 6 日之前) 🟢 代表来自 OpenAI/math 仓库的 AI 发现 其中 81% 在今天发布。真是见鬼了
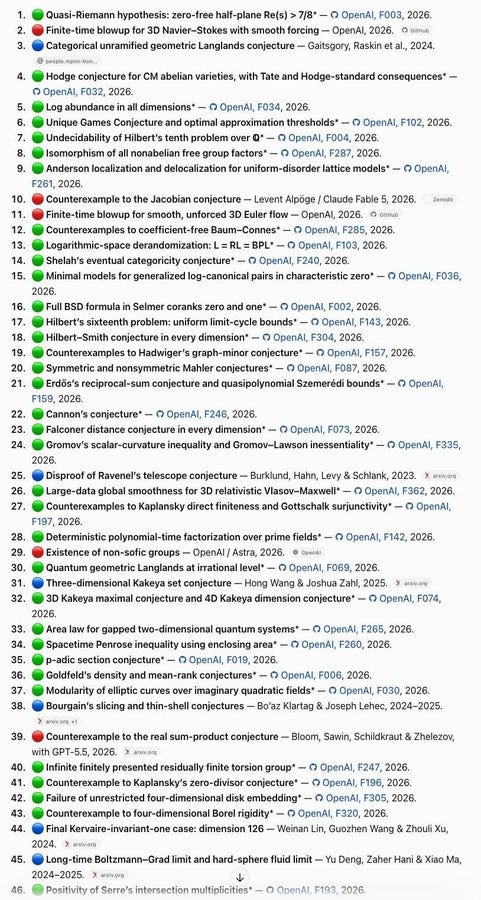
Fable 5.1 的前 100 项中有 59% 出现在今天的列表中,其中 87% 为 AI 发现,完整列表请见链接。
Sauers:我的代理(Opus 5.5、Astra 和 5.6 Sol)已经提前解决了一些这些问题(在 GitHub 上)。我想知道其中有多少百分比真正需要它们的内部模型?
世人并不理解
当被问及这些数学证明作为假设情景时,所有 AI 都表示这将是一件大事,应该成为头版新闻,其历史意义远超任何合理的比较,是数学史上最大的一天。有些人认为这不可能发生。
事实证明,这并未成为头版新闻。大多数人没有听说过。它本应如此,但新闻界无人知晓这意味着什么,或者认为人们会关心。
Kevin A. Bryan:好吧,我已经浏览完 OAI 的数学清单。这简直疯了,如果人们理解这意味着什么,它理应成为全球头版新闻。但如果我是某实验室的策略负责人,首要任务将是“尽可能快地将其应用于医学、肿瘤学、电池效率等领域”。
Joshua Gans 在他的报道开头展示了真正的头版,以向我们展示《纽约时报》认为比一次性解决 500 个顶级开放数学问题中的 90 个更重要的事情是什么。
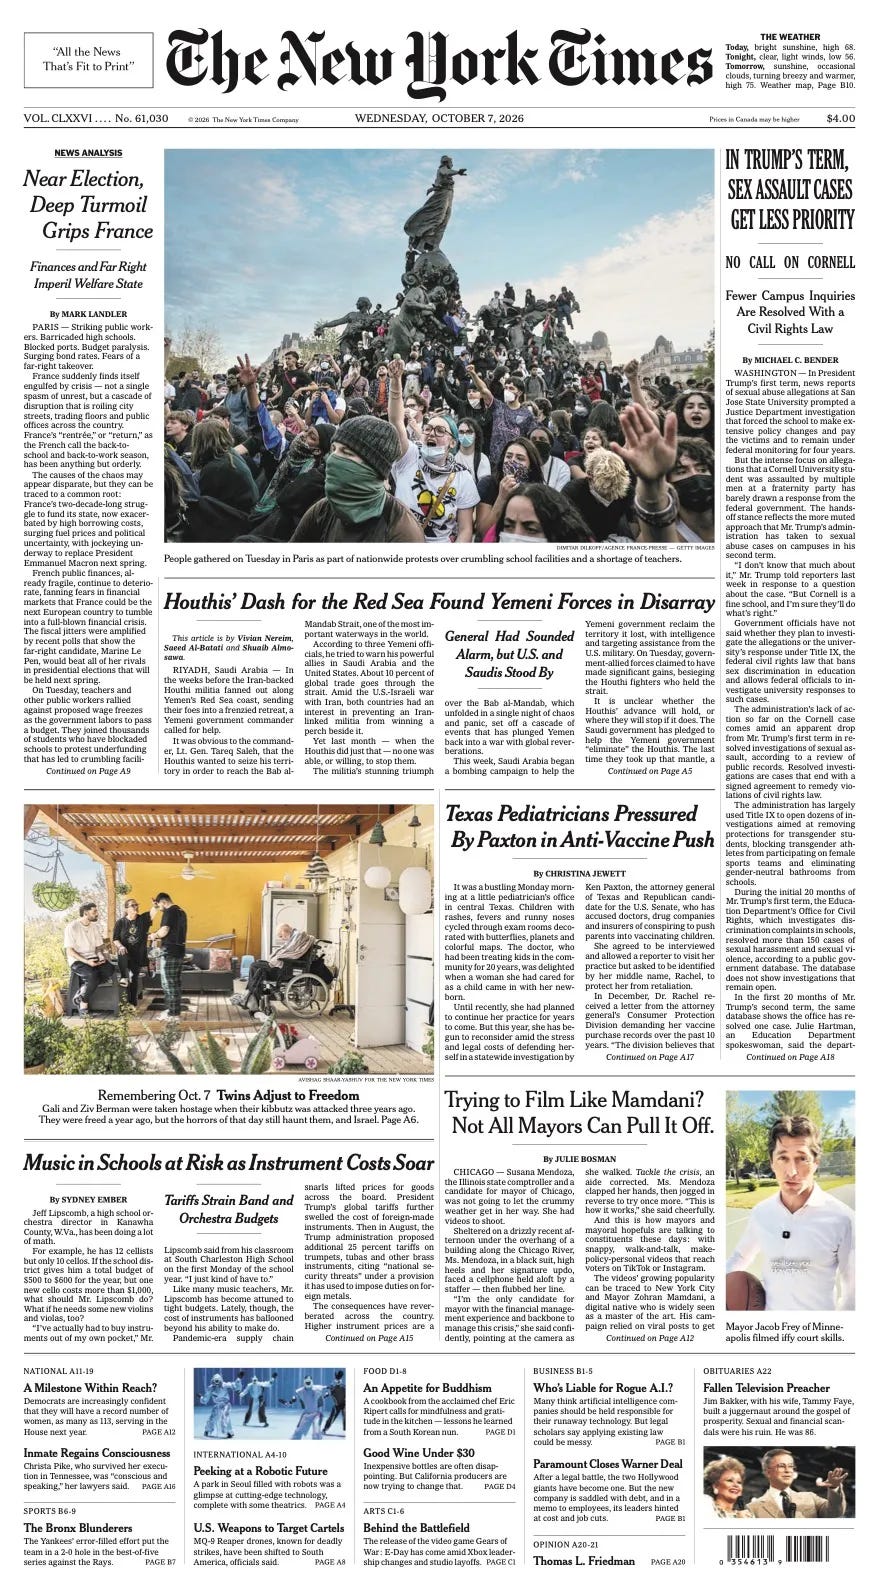
Seth Burn:有时头版新闻最初并不会登上头版。最好的例子是斯普特尼克号(Sputnik)。它于 1957 年 10 月 4 日发射,但苏联人并不认为这是一件大事[因此只占据了右侧栏的几段文字]。直到美国陷入恐慌之后,它才在 1957 年 10 月 6 日成为俄罗斯的头版头条。
否则,这是一个异常缓慢的新闻日。其中大部分内容并不完全是突发新闻。然而,连底部的摘要中也看不到任何数学相关内容,尽管那些摘要甚至包含了一篇通用的 AI 评论文章。
Joshua Gans:缺失的是这一点:由 OpenAI 撰写的 722 篇数学论文。说这可能是科学史上最大的一天也不为过。这很难评估,但我看到的讨论表明,其中许多成果是数学中最困难且最重要的结果之一。我怀疑 2026 年 10 月 6 日将成为 AI 在数学领域的某种“审判日”,但它预示着的远不止于此。
反驳意见是,这样的日子可能还有很多:
roon(OpenAI):昨天会被铭记为一个重要的日子吗?很难说。在间断指数增长中,每一个局部最大值从稍远一点的地方看都是看不见的。
目前你仍然可以做数学
我喜欢这种关于数学尚未完成的解释模型:
Joshua Gans:数学家们现在正在经历这个过程。对此我再次提供上述的“书挡”幻灯片作为帮助:
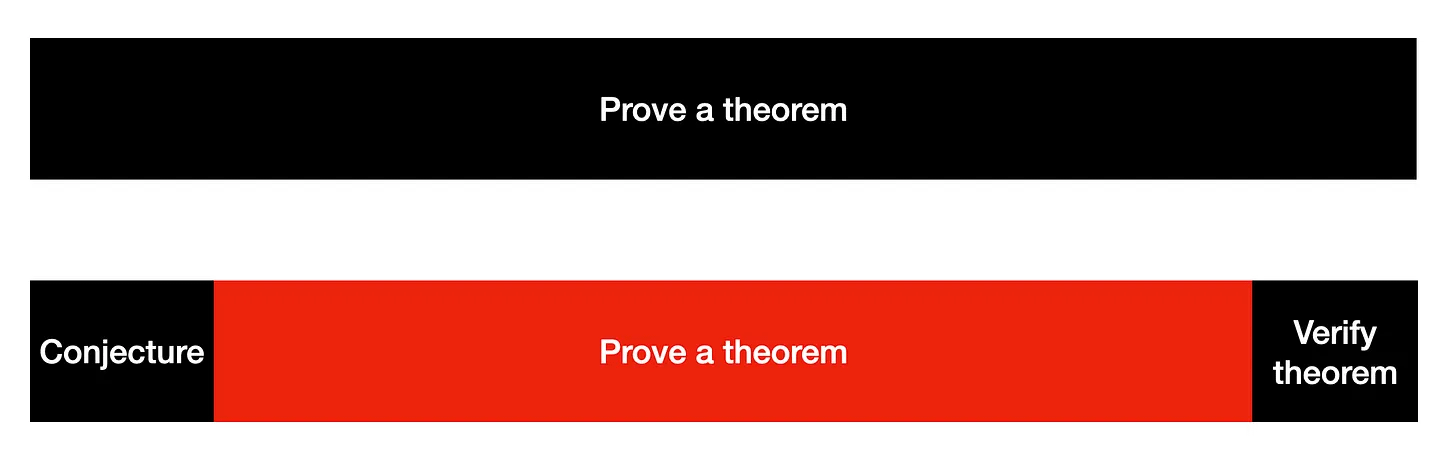
我们还无法证明 AI 在猜想或最终验证方面更胜一筹。这需要一些额外的时间,尽管可能不会太久。
验证必须相当可靠,否则我们到现在会发现更多错误。有很多数学家非常希望找到一个错误。我们通过推理轨迹知道,很大一部分精力投入到了验证中。
你需要寻找一个新问题
Scott Aaronson 报道了“数学末日”。
Scott Aaronson(Shtetl-Optimized):昨晚,我9岁的儿子取笑我的妻子、复杂性理论家 Dana Moshkovitz,说道:“妈妈,我听说你被击败了!我听说一个机器人解决了你整个职业生涯都在研究的数学问题!哇哦!”虽然我儿子像个混蛋一样说话,但他也没说错。无论你是为此感到兴奋、沮丧、愤怒还是其他什么情绪,昨天无疑是数学史上最大的一天之一。是的,在 OpenAI 昨天发布的372项重大成果中,在其顾问团 Timothy Gowers、Edward Witten 和其他杰出数学家的推荐下,包括了对 Subhash Khot 唯一游戏猜想(UGC)的证明,这是我妻子在我认识她的整个时间里一直致力于证明的一个命题。
还有另一种“新问题”,那些否认现实的人,三年前还以谈论大语言模型无法做数学为安慰,现在不得不找到新的方式来解释为什么 AI 所做的任何事情都不是真实的或不重要的。
Shtetl-Optimized:经验表明,即使到现在,仍会有人以居高临下的语气解释为什么这一切都不是真实的,也不值得重视。如果这样的人能够对实证世界中发生的事件感到印象深刻,能够更新自己的认知,他们早在几年前就会感到印象深刻并更新认知,远在事情发展到真正的“数学末日”之前。所以,他们会说,也许所谓的解决方案根本不是解决方案,而只是“AI 垃圾”。或者也许昨天解决的372个著名开放问题都不是真正的数学问题,它们都只是经过包装的比赛谜题和琐事。(毕竟,黎曼猜想还没有解决!)或者也许整个4000年的数学学科都需要被抛弃:原来它只是一堆解谜和琐事;不同的是,现在这些琐事暴露无遗。无论如何,真正重要的是人类创造力的真正核心圣殿未被突破,而且可能永远不会被突破,同时 Sam Altman 和 Dario Amodei 是可鄙的小书呆子。如果你仍然是这种注定失败的世界观的支持者,仍然在这艘沉船上,我强烈建议你阅读昨天除了 OpenAI 数学末日发布之外对 AI 话语的另一大贡献:即 Scott Alexander 写给 Steven Pinker 的公开信。
我必须向针对所有可能的 AI 炒作的全能反驳意见致敬:
Cas:我认为 AI 在数学领域超越人类成就可能被高估了,这更像是莫拉维克悖论的例子,而不是即将到来的奇点的有力迹象。回想一下,大约10年前 AI 在围棋上超越了人类,但在改变世界的任务上进步缓慢得多。
无论AI擅长什么,都是莫拉维克悖论。无论AI不擅长什么,就是它糟糕的原因。为什么你会对AI突然在越来越多领域(包括我们之前说它因为不擅长而显得愚蠢的那些具体领域)展现出超人能力感到如此兴奋?这种优势显然不会很快扩展到其他领域。
验证或评估并不总是比生成更容易
这一批评的最强论证在于区分可验证与不可验证的领域。
该论点认为,只要存在具有已知真实答案的可验证领域,AI就会迅速变得超越人类。
然而,如果验证困难,或者你只能以非正式方式进行评估,需要人工介入以避免偏见错误和扭曲行为,那么AI的能力就会落后。
在预训练主导的那几年里,我们处于一个奇怪的位置,当时LLM主要是在人类文本上进行训练的。这在关键方面导致了一个看似不符合尤德科夫斯基预期的世界:LLM在各种有用但未经验证的领域表现相对出色,而在数学方面却毫无希望。
现在,随着后训练占据主导地位,LLM在数学和编程方面再次变得更强,情况又回到了人们预期的样子。AI正在迅速在所有领域取得进步,尽管与其他任何技术相比,其他领域的进展速度已经超快,但目前仍相对缓慢。因此,我们首先推进数学、编程和类似领域的发展,这些领域随后实现了AI研发的自动化,从而加速了其他所有领域。
破解密码
贾斯汀·德雷克注意到,在成果中密码学突破的出现率显著偏低。也就是说,719篇摘要中没有一篇提到密码学、LWE(带误差学习问题)或离散对数。
一种可能性是AI在密码学方面相对较弱;另一种可能是运气使然,或者OpenAI在其初始问题集中没有包含密码学(也许是为了避免恰好出现这个问题?);又或者政府或OpenAI正在审查这些结果。
贾斯汀呼吁区块链行业进入“掩体模式”,以防范突然的大规模突破。
维塔利克表示不必恐慌,但潜在的新数学发现确实给密码学带来了严重风险,包括对格密码的影响,但尚未波及哈希函数。
Vitalik Buterin:但对于任何具有结构的事物,你都应该假设 AI 至少会在打破该结构方面取得一些进展。在此,一个合理的推论是,如果你希望使某物在长期内保持合理的安全性,请将密钥大小乘以 10。……当然,理论上哈希也可能被破解(例如 P = NP 就意味着这一点)。但我认为 P = NP 极不可能发生。直观地说,一个数学对象恰好没有任何可利用的结构(正如哈希所期望的那样),比一个数学对象恰好具有大约三种可利用的结构形式(对于椭圆曲线:结合律、Schoof 算法、配对)且没有某种我们尚未发现的会严重削弱其安全性的秘密第四种结构形式的可能性要大得多(对于椭圆曲线,即 ECDLP 和配对安全性)。LWE、SVP、RLWE 以及格问题家族的情况也类似。因此,目前我们没有理由担心并开始增加哈希的字节大小(如果我们开始更加担忧,我们会先增加轮数,而不是对字节大小做任何操作)。具体的简要总结,我个人的观点如下:* 在哈希方法可行的情况下,基于哈希的方法优于基于格的方法 * 对于所有基于格的方法,对参数规模要更加偏执谨慎。请记住,区块链只是密码学故事的一小部分;这一点远远超出了区块链的范围,适用于访问网站、安全消息传递、Tor/VPN 等场景…… * 对于隐私协议,强烈建议不要将加密笔记上链。相反,通过某些第三方机制将它们发送到链下。* 如果对你来说不难,将资金保留在尚未用于交易的地址中是个好主意。如果对你来说很容易,那就这么做。但要小心迁移;我个人因迁移失败而损失的资金比在所有黑客攻击中损失的总和还要多。 * 对于多重签名钱包,在链下进行确认比在链上进行更好,因为这样签名者的钱包签名就不会暴露给公众,因此如果 ECDSA 比预期更快地被 AI 攻破,多重签名至少可以“优雅地降级”为 1-of-1,其中那个 1 是负责收集签名的人——这比“任何人都可以取走资金”要好得多。
我猜测 Vitalik 关于迁移失败的要点被严重低估了。在加密货币领域,由于愚蠢的错误而损失巨额资金是非常容易的,这与因黑客攻击或技术故障而损失资金的方式相同。
是的,你应该感到担忧,尤其是考虑到 OpenAI 在此处的突破并没有涉及尽最大努力。
Kevin Madura:鉴于这些数学方面的公告,我们认为现在存在但尚未发布的针对密码学的新型攻击有多少?一年后会是什么样子?五年后呢?我现在会密切关注国防部/国家安全局/NIST 的指导方针 Matthew Green:我认为我们可能会失去公钥密码学。好吧,具体来说是加密。
永不改变
Gary Marcus 正在捍卫他的立场,称涉及的神经网络有一个独立的符号系统,因此这一切都不算数,他一直都是对的,如果“这超出了你的理解范围”,你可能不应该评论 AI。礼貌的回应是,这种区别在实践中并不重要。
数学家们并不安好
以下是来自数学界不同人士的 100 多条反应。他们中的许多人对于 OpenAI 处理此事的方式非常不满,特别是许多论文都是“不可读的垃圾”,而不是事先整理得井井有条,或者 OpenAI 竟然解决了这些问题。如果你想了解“数学家们在想什么”,这是一个很好的资源。
这是 Terence Tao 的严肃回应,重点在于此事如何扰乱工作:
特伦斯·陶(Terence Tao):我对最近的发展感到矛盾而复杂。一方面,许多由人工智能生成的证明似乎引入了巧妙的新思想,一旦经过消化吸收,这些思想将富有成效,并且它们也建立在无数过去和现在的人类数学家的现有贡献之上。但与此同时,我深感沮丧的是,与传统突破形成鲜明对比的是,参与这些证明的人类都无法提出问题、发表演讲、参加会议、向期刊提交论文、指导学生或以其他方式参与这些结果的后续发展。同样,我也对社区能够利用这些工具来解决雄心勃勃且规模庞大的项目而感到兴奋,这类项目在以往是我们连想都不敢想的。但我对许多原本需要耐心且刻意缓慢推进的研究工作——尤其是研究生和博士后们的工作——因此类发布而被随意干扰或摧毁感到震惊。正如我们无法在听到电影剧透或字谜线索后假装没听见一样,一旦意识到已有现成解法,我们就无法再像以前那样富有成效且丰富地探索一个问题。是的,我们仍然可以分析和消化这样的答案;但最好的机会是在发现它的时刻,而当这一切完全委托给人工智能工具时,这样的时刻正日益被浪费。我为那条未曾走过的路哀悼,为在这场疯狂的技术竞赛中失去的机会哀悼。那些本可以将前沿模型提交给独立研究人员以进行适当科学评估的实验室。那些本可以与研究社区协调以确保这些工具被用于补充和增强人类研究人员的能力与活动,而非与他们竞争的做法。那些本可用于促进合作与分享,而非竞争与保密的工具使用方式。那些本可以打开新大门而不关闭旧大门的可能。但我们如今所处的道路并非如此。相反,社区比以往任何时候都更需要团结起来。明确宣告我们的标准和价值观,构建我们自己的工具和实践,支持我们最脆弱的成员,并规划我们自己的前进道路。让我们开始工作吧。
以下是更不客气的一版:
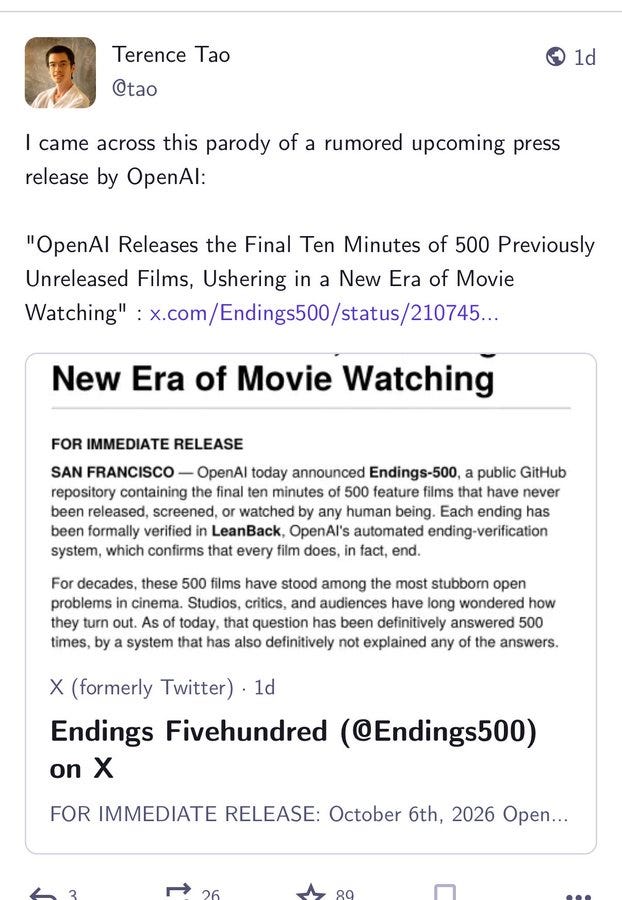
这是来自数学界的另一份报告。人们似乎并不兴奋。
β/σi:> 担心他们的未来 > 担心那些尚未发表的解决方案(你好,密码学) > 对这些模型的能力表示难以置信 > 为他们曾经爱上的部分消失而悲伤(就像我们在 swe 中看到的那样) > 去解决生物领域的“真正”问题(来自数学家真是好笑,顺便说一句)ps 这只是我的小样本,我的数学家朋友有限
数学家似乎把数学当作他们的游乐场,他们并没有因为问题被解决而感到高兴,反而觉得他们的玩具被拿走了。这里存在一种挣扎:想要知道,想要尝试解决,想要获得荣誉,以及想要找到解决方案。你实际上最关心的是什么?
要足够聪明成为数学家,并且选择成为数学家而不是去做其他许多收入更高的事情,至少在一定程度上需要那种会导致漫画情节的态度:有人告诉数学家他们的工作有了应用,而数学家则惊慌失措。当然,绝对不是所有数学家都这样。
我非常同情。我真的非常同情。我曾可能走上那样的道路。这种态度具有巨大的价值,不仅因为其内在价值,还因为正是遵循这种好奇心引领我们发现了那些否则会被错过的最有价值的成果。
Will Kinney:我开始注意到的一件事是,理论物理学界对人工智能造成的颠覆性影响的反应,与数学界的反应截然不同。Steve Hsu:如果你的毕生心血都投入在一个真正重要的问题上——比如治愈癌症、核聚变能源或揭示量子现实的本质——那么突然从人工智能那里获得解决方案,本该是值得大肆庆祝的事。你或许会短暂地思考一下这对你的职业产生的次级影响,但这种思考会被你和全人类所获得的这份礼物所带来的喜悦所淹没。
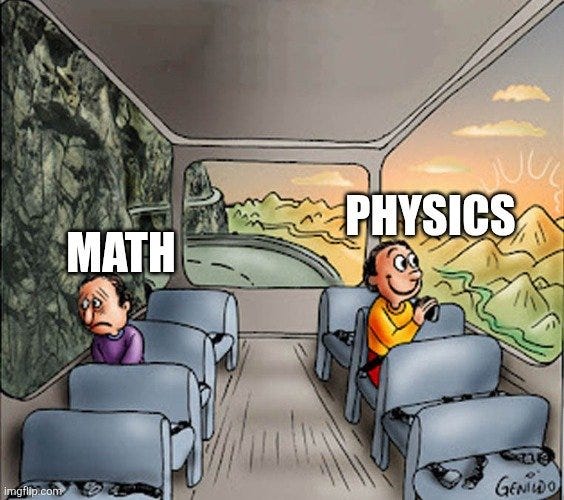
关注这些变化对你和你身边的人有何影响,也是完全合理的。这才是直击人心的部分,也是你最能够掌控且不得不面对的部分。
Josh Frisch:像许多其他数学家一样,我在 2026 年迄今为止的主要情绪是失落:意义的丧失、目标的丧失、人类证明时代的终结,以及对未来图景描绘能力的丧失。随着昨天(2026 年 10 月 6 日)数百个优美结果的发布——其中许多,也许大多数,回答了某人的“一个问题”——我正努力超越这种失落感。这里有太多优美的结果:那些此前无人有任何思路的问题、那些人们认为绝不可能存在的算法、意想不到的同构关系,以及构造和证明。Andrew Curran:请克制住嘲笑那些正艰难度过这一时刻的数学家的冲动。无论你的领域、专长还是热情所在是什么,终有一天你也会经历他们正在经历的一切。当你回想起自己的言语时,你会感到悔恨。
如果你的回应是“好吧,所有人的热情都在消退,人工智能将席卷我们所有人”,那情况就更糟了。你知道为什么这更糟,对吧?这并没有让事情变得更容易。有些人以极其恶劣的方式对这些可以理解的情绪做出反应。我敦促他们停止这种行为。
数学在此刻面临着真正的问题。如果人工智能证明了所有定理,那么我们目前提升数学理解能力的方法就不再有效。传统上,我们通过努力解决问题来理解问题,而如果没人能理解解决方案,其价值往往大打折扣:
Jordana Cepelewicz(《量子》杂志):这就像是你被瞬间传送到了高山的顶峰。四周云雾缭绕,你不知道自己身在何处,也不知道周围有什么。你不知道你的山与其他山如何相连,也没有任何装备帮助你探索,更没有方法帮助他人加入你。如果你是自己攀登这座山的,你就会体验到人体如何适应海拔和氧气水平的变化。你可能不得不发明工具来导航、攀爬陡峭的悬崖,或者搭建庇护所。你可能会遇到另一位探险者,一起在隐藏的峡谷中迷路,并发现一种可以制成救命药物的植物。相反,你现在却坐在山顶的黑暗中,而那个制造传送机器的人告诉你,它能比任何人类更好地探索荒野。
还有其他训练理解能力的方法,但开发它们可能需要一段时间,并且需要更多的动力,尤其是内在动力。
这也摧毁了博士和博士后体系,因为你试图解决的问题或你想申请的资助随时可能被抽走。
这也是一种令人不适的处境:
许多数学家已经停止在论文末尾发布未解决的猜想和潜在的想法,因为他们担心这些内容会被机器人抓取并喂给人工智能模型。另一些人则在论文尚未准备好时就提前发布,以避免被别人抢先发表。
局势变得严峻
有些解法既优雅又酷炫。例如,关于 9/4 矩阵乘法的论文只有 13 页,直接限制了斯特拉森谱特征。我们看到许多人,在看到自己最喜爱的问题得到解决后,分享了他们在阅读证明时的“顿悟”时刻。
其他解决方案则不够优雅。
我和 Wendigo 的看法一致:我们目睹了这些针对先前优雅计算界限的微小改进,它们几乎没有任何实际益处,这既怪异又可怕。
Acer:哦对了,顺便说一句伙计们,我们可以比 n log n 更快地进行整数乘法,哈哈。当这个结果出现时我确实非常惊讶,哈哈。
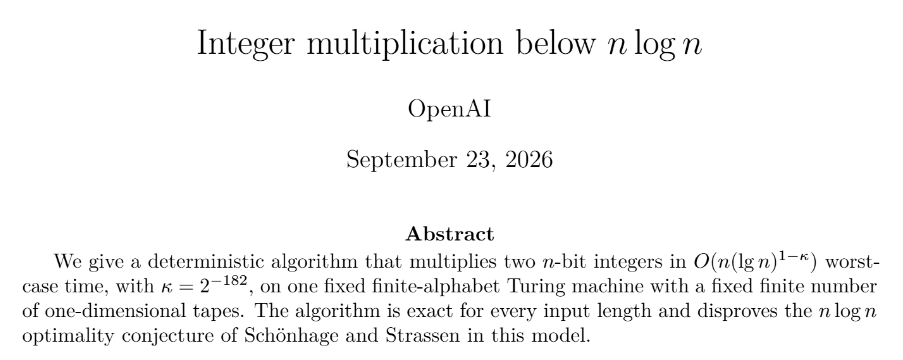
Wendigo:难道只有我觉得有点毛骨悚然吗?我们那些整洁的下界(在这种情况下是 nlog(n))竟然只是稍微有点错误。数学那种崇高的美感,看起来像是由于我们有限的人类能力所导致的粗略近似。Uubzu v4:我认为 AI 只是在耍我们,它把一个像 n(lg n) 这样优雅的界限改进了 1/2^182。就像谢谢你了,兄弟,但这毫无用处。
那如果我们把它进一步降低到 (1/2)^59 呢?然后是 (1/2)^34?接着是 (1/2)^14?
任何人都可以一直做这种事。你只需要一个 Codex 订阅即可。
Doug Colkitt:我们正在发布关于 OpenAI 问题 #109(整数乘法)的更新,进一步收紧参数。κ = 2⁻³⁴(从 κ = 2⁻¹⁸² 收紧)。精确见证值为 8.3 × 10⁻¹¹,相比之前的结果提高了约 4800 万倍,相比最初的 OAI 结果提高了 2¹⁴⁸ 倍。这一改进来自于消除二次瓶颈背后的间距惩罚。这是通过移动紧凑的控制位而不是整个窗口来实现的。Beni:Doug,你到底什么时候睡觉?Doug Colkitt:当然是在我的 Codex 使用率降至 0% 的时候。Konsti Wohlwend:在我预测的一天内,指数从:0.𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟿𝟾𝟺 变成了 0.𝟿𝟿𝟿𝟿𝟺。“几周至几个月”太保守了!
咨询小组回应
以下是主要咨询小组的完整声明:
agmai.org:正如几周前宣布的那样,OpenAI 发布了一个由内部模型生成的庞大数学结果集合,报告了对数百个未解问题的解答。这对数学界来说是一个重要事件,其影响不仅涉及数学本身,还波及数学界,远远超出了单个结果的范畴。AGMAI 的咨询角色不应被解读为对这些结果影响的评判,也不应被视为对 OpenAI 获取这些结果的过程的认可。我们不代表整个数学界发言,只有数学界才能开展所需的评估。将这项工作公开只是一个第一步。这次发布是开始,而非人类理解过程及将这些工作纳入数学知识的完成。同时,未来的数学研究不能仅仅依赖于理解由 AI 实验室产生的结果。数学家必须能够提出自己的问题,发展自己的方法,并探索未被选作展示 AI 系统能力的方向。公平地获得强大的研究工具和充足的计算资源对于这种自由至关重要。我们重申已发布的负责任发布建议。我们已经与 OpenAI 讨论了这些建议,并感谢该公司愿意参与对话。虽然我们认为这些讨论具有建设性,但最终由数学界来评估我们的建议在多大程度上得到了成功遵循,以及是否还有其他建议需要提出。我们仍致力于就这些问题与任何前沿 AI 实验室进行接触,并且已经与其中几家取得了联系。
另一个数学团体的回应
有些人看着正在发生的事情,大喊“不!”
他们需要比这份声明更好的计划。
不要被骗以为这个名为“人类数学协会”的组织有多了不起。这里有数十万名数学博士,而这个组织只有 809 名成员。我将其列入是因为它完美地体现了一种态度,仅此而已。
阿里尔:“数学家们并未要求开展这项工作”可能会成为这个时代的历史名言之一,完美地描绘了学术界的衰落。伊森·莫利克:这份文件将成为大学课堂上的指定阅读材料,这些课程将涵盖这一历史时刻,短短几段文字中蕴含着大量信息……人类数学家协会:关于 OpenAI 于 10 月 6 日发布数学文件的声明 昨天,即 2026 年 10 月 6 日,OpenAI——目前正面临非法抄袭、侵犯版权和商标淡化等诉讼的辩护——发布了一个手稿库,声称其中包含了对多个高知名度数学问题的解答。数学家们并未要求开展这项工作。OpenAI 声称其合法性源于“数学与人工智能咨询小组”(Advisory Group on Mathematics and Artificial Intelligence),该小组在其初始咨询声明中指出,前沿人工智能公司不应在内部模型上测试高级数学问题。OpenAI 无视了咨询小组立场的核心前提,表明其对科学研究规范——即确保数学具有可信度、符合伦理研究并服务于公共利益的规范——完全漠视。数学家对进步有着独特的愿景,这种愿景受到历史和领域特定因素的启发。我们拒绝 OpenAI 关于此次发布推动了我们的学科发展的说法,并敦促数学家和公众以应有的怀疑态度看待这种出版模式的价值。一次性发布超过 700 个文件并非学术能力的展示,而是权力的展示。我们敦促数学家停止与 OpenAI 的合作,回归以人类理解为中心的科学发展愿景。人类数学传播协会工作组
无论你对声明的其他部分作何评价,他们说得没错,这里的所有举动都直接违背了数学咨询小组(AGMAI)的意愿。AGMAI 的核心诉求是要求 OpenAI 不要在私有内部模型上测试难题。这项请求,无论你怎么看,都被完全无视了。
不同的方法
OpenAI 承认,“全部转储到 GitHub 上”并不完全符合咨询委员会的指导方针。他们正在探索更好的方案,并希望未来能产出撰写更完善的论文。
除了这次大规模的文件发布外,还有一件事发生在一天前,Anthropic 在此时将其解决方案提供给数学家进行整理后再行发布,试图遵循咨询小组的建议:
Anthropic 的一项新数学成果,随后由 Josh Alman 和 Virginia Vassilevska Williams 撰写成文,这确实是一件大事。Anthropic 让 Claude 研究开放性问题,找到了这一结果,然后聘请 Alman 和 Vassilevska Williams 按照数学家委员会要求 AI 公司所做的那样撰写论文。摘要:我们为 3SUM 问题和全对最短路径(APSP)问题提供了优于教科书算法的首个多项式级改进:我们展示了如何以 O(n^1.9992) 的时间确定性解决规模为 n 的多项式大小整数的 3SUM 问题,以及如何以 O(n^2.9995) 的时间解决具有多项式有界整数权重的 n 顶点有向图的 APSP 问题。这推翻了 3SUM 假设和 APSP 假设。利用已知的归约方法,我们还推翻了 3SUM 和 APSP 假设的实数值版本、精确三角形假设、零权重 k-团假设,以及 van den Brand、Nanongkai 和 Saranurak 提出的三个矩形提示在线矩阵-向量猜想,并为多种其他问题提供了多项式级的加速。𝖬𝖺𝗁𝖽𝗂 𝖢𝗁:什么?!Atoosa Kasirzadeh:你能写一条推文,从你的角度详细阐述这可能意味着什么吗?𝖬𝖺𝗁𝖽𝗂 𝖢𝗁:简而言之,假设对于一大群动物,我们知道如果它们能吹口哨,那么猪就能飞。但现在有人看到了一只飞翔的猪。这意味着我们现在无法推断出关于这些动物的任何信息(在某种意义上,“动态规划并非最优”)。Scott Kominers:首先:🤯。完全不可思议的结果。其次:我看到很多人抱怨 Anthropic 聘请人类专家来撰写论文这一事实——但从一阶角度来看,这不正是上周流传的“负责任发布”指南所建议的做法吗?如果数学界认为“AI 实验室有责任提供支持,包括资金,以帮助发展对人类理解其发布的 AI 数学输出的能力”,那么它们就必须习惯这些公司资助数学家去做这件事。
还有一项通过 GPT 产生的零星新数学成果,出现在其他数学成果大幅下跌之前。
Ethan Epperly:John Urschel 刚刚证明了,带有部分选主元的 Gaussian 消元法的增长因子在高概率下约为 ~n^{1/2},解决了 Nick Trefethen 的一个长期猜想!
三次撤回
这三次撤回都是同一个符号错误的后果。
我喜欢“撤稿观察”(Retraction Watch)这个网站的想法。这是 OpenAI 执行得很好的一个方面。错误会发生,即使发现更多错误——而且几乎肯定会发现更多错误,因为未验证的 58% 仍然 largely unvetted ——错误率也令人印象深刻。重要的是在发现错误后勇于承担责任。撤稿往往是你做对了某事的标志,而不是做错了的标志。
Alicia Gallegos(Retraction Watch):“我认为数学界会对这些撤回和更正持积极态度,但要重新赢得他们失去的信任,仅靠这一点是远远不够的,”Sutherland 告诉我们。
此外还有十四次修订。
拥抱 Lean
我喜欢 Jon Stokes 的这个解释:数学非常适合高级 AI,尤其是 GPT,因为没有“奖励黑客”行为。答案就是答案,如果你做了一些疯狂且超出分布范围的事情但有效,那就是有效的。
不过,你确定吗?一种观点是,你要么找到证明,要么找到 Lean 中的 bug,当你面对世界上最难的开放问题时,你确定数学总是更容易的选择吗?
Jai:它只是一个下一个突破点的预测器。一个随机的天才。诺贝尔奖自动补全。Michael Roe:我的猜测是在 Lean 中发现可利用的健全性漏洞比证明拟黎曼假设要容易得多。鉴于此,我们预计其中一些证明会成为对 Lean 的攻击利用。尽管如此,我也准备好相信它们是真实的。(作为一名计算机安全人员,“AI 能在 Lean 中找到可利用的漏洞”这一消息实际上比“AI 证明了拟黎曼假设”更令人担忧。安全漏洞末日即将来临。)
更大的风险在于,Lean 未能确认所陈述的定理与著名的开放问题相符。你的术语可能在第一眼看上去并不明显的方面有所不同。
到目前为止,Lean 表现良好,所有带有 Lean 证明的论文(除了一项需要修正的附带声明外)也都表现良好,这相当令人印象深刻。系统运行正常。迄今为止有 3 个证明失败了,而且它们都位于未形式化的 58% 部分中。
在顶部讨论的九个结果中,有五个在 Lean 中经过检查(拟黎曼假设、矩阵乘法、π、唯一游戏和 Hadwiger),正如 Lean 检查过的 42% 所示。
在某个时刻,你将给模型分配一个任务,该任务比通过你分配任务的其他方式来解决“问题”要难得多,无论替代路径是否涉及接管世界。然后,你就会成为那个遇到问题的人。
分享这个:
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。