精选UK AI Security Institute新闻
最优停止:在评估计算上花在刀刃上
英国AI安全研究所(AISI)开发并开源了Python包optstop,用于在模型评估中动态停止计算,当性能估计足够精确时提前终止,从而节省57%至97%的计算资源。该方法解决了固定预算评估低估智能体能力的问题,提高了评估效率。
随着前沿AI模型能力的持续进步,我们用于测试和衡量这些能力的评估手段也必须同步跟上。能够充分激发模型真实能力的评估,如今往往变得篇幅更长、运行成本更高,而模型快速开发和发布的周期又使得可用于运行评估的时间愈发紧张。
AISI(英国人工智能安全研究所)此前已发现,固定预算的评估可能会系统性地低估前沿智能体(agentic)的能力,尤其是对较新的模型而言。受限预算下的基准测试分数可能导致模型之间的比较不公平,使决策者低估智能体的能力,并掩盖风险的真实规模。然而,在评估中充分激发能力所需的计算预算规模,如今对许多评估者而言日益构成实际难题——一些前沿评估现在需要消耗数亿个token。
在这样的规模下,评估中每一步不必要或浪费的操作都会带来可观的机会成本。因此,评估者需要高效的方法,有选择性地使用资源,同时既不削弱评估结果的统计基础,也不损害评估激发模型真实能力的效果。
AISI的使命不仅在于评估前沿模型的能力,还在于创新更优的工具、方法和框架,以确保评估始终切合目的——并在可能之处分享解决方案,惠及更广泛的评估者社区。
我们为应对评估效率这一挑战而开发的一个解决方案是 optstop,这是一个开源Python包,与我们的Inspect评估框架集成。总体而言,optstop的目标是在评估过程中,当模型性能的估计值已达到足够精度时停止运行,从而减少不必要的计算消耗。在测试中,我们发现,在我们设定的每一种条件下,optstop在评估中节省了计划运行量的57%至97%。
本篇博客将讨论optstop所针对的具体测量问题——并解释其工作原理、评估者如何使用它,以及我们在初步测试中运行它时发现了什么。
为什么需要optstop?
在一次评估运行中,模型会与一个或多个基准(benchmark)配对——基准是一组结构化的任务,用于估计模型的潜在能力。基准中的单个任务集合会被重复运行,以平均掉模型在任务上表现的运行间随机性。
任务数量乘以重复次数,即得出总试验次数(模型的单次运行),也就是评估的样本量。
评估产生的数据是嵌套结构的:任务内部是模型的响应,任务之上是模型与性能相关评估设置(例如选定的token预算)的分组。它们之间的不确定性往往是不均匀的——某些模型-任务组合在少量运行后就能达到较高精度,而另一些则需要更多运行次数。
由于样本量由评估者在运行开始前预先确定,因此它无法根据评估中剩余的不确定性位置进行动态调整。评估可能会持续对已经足够精确的估计值进行采样,而在更困难的情况得到解决之前就耗尽了预算。
随着单次试验的成本不断上升,评估团队能够负担的运行次数随之下降,而浪费一次试验的代价也随之增加。
针对这一问题的自适应方法则将评估视为序贯测量:在不确定性仍然较高的地方继续采样,当达到预先设定的精度水平时停止。
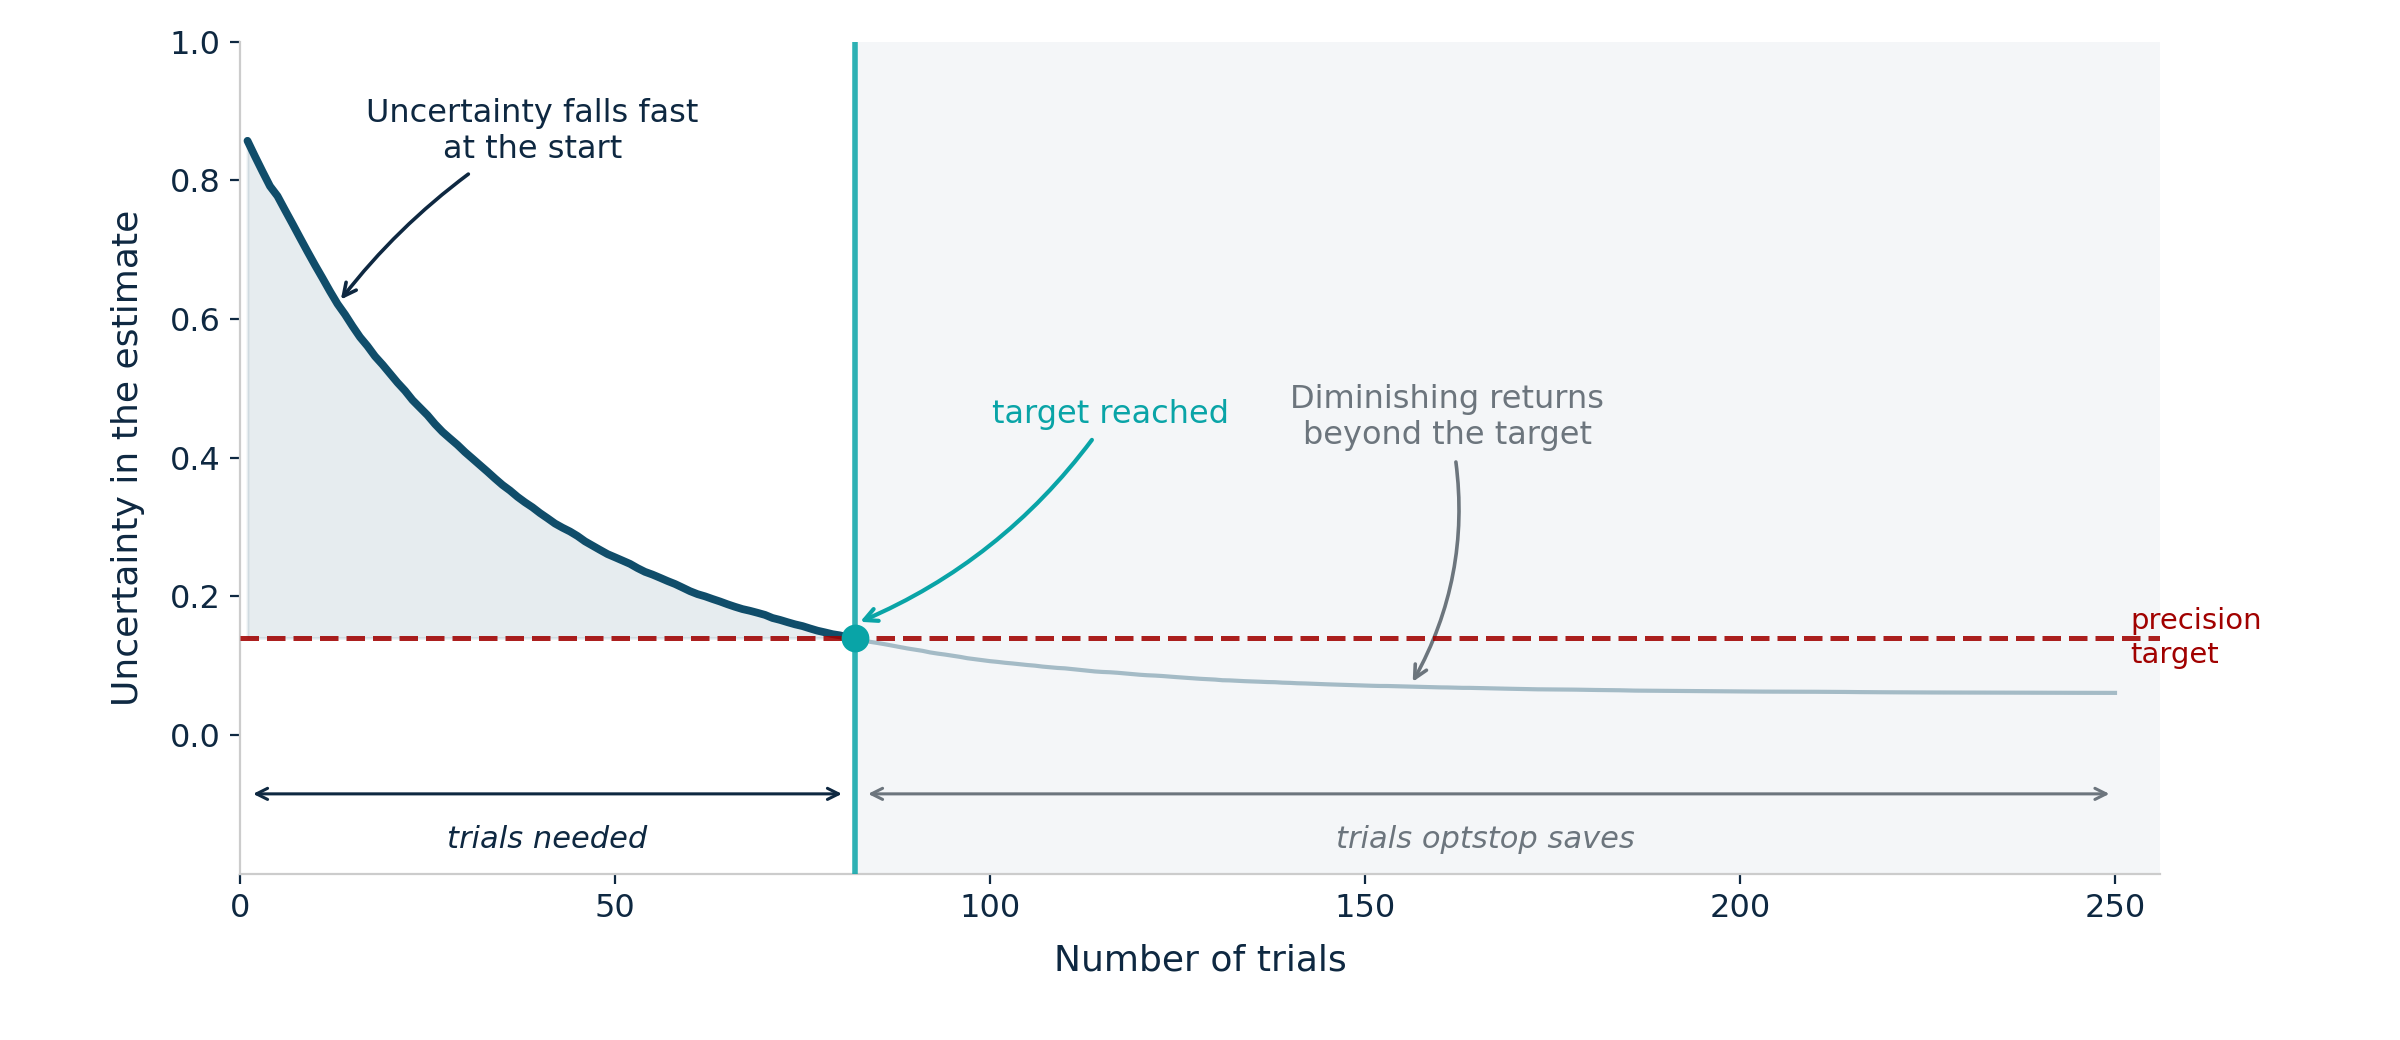
针对这一测量问题,一种已有的应对方式是缩小基准中单个任务集合的规模。自适应题目选择方法会为每个模型挑选最具信息量的任务,并跳过其余任务。然而,这些方法通常需要一个预先校准好的、具有已知难度的题库,而对于新开发的或安全关键的基准而言,这样的题库可能并不存在。
optstop 无需此类储备,评估中的每项任务都始终保持入选资格:一旦评估的某一部分(无论是单个条目还是整个分组)达到足够精确度,采样即告停止。
optstop 的工作原理
在评估过程中,optstop 会追踪当前模型性能估计所处的统计范围(即可信区间)。它在两个层面进行追踪:任务内部的重复采样,以及分组内部的任务,每个层面都设有各自的精确度或稳定性目标。
在分组层面,分层贝叶斯模型整合了各任务的信息,同时允许各任务的个体表现存在差异。这解决了某些任务提前停止所造成的样本量不均衡问题。
- 精确度:可信区间已足够狭窄。
- 稳定性:区间已不再变化,说明数据已无更多信息可供提取。
若两项规则均未满足,分组将按原定完整预算运行到底,因此真正“嘈杂”的估计不会被提前终止,而是会采样至结束。
当模型仅在极少数情况下通过评估时,停止最为危险,因为一次罕见的成功可能正是测试的全部意义所在。optstop 中的保守机制可防范此风险,当估计成功率低于 1% 时,会要求更多数据。
每次停止决策也都是可核查的:optstop 会记录并报告所有停止决策及其依据。这份记录让您可以核实所报告的节省量,而非仅凭信任接受。(每项规则和保障措施均在随附论文中单独验证。)
最优停止的实际应用
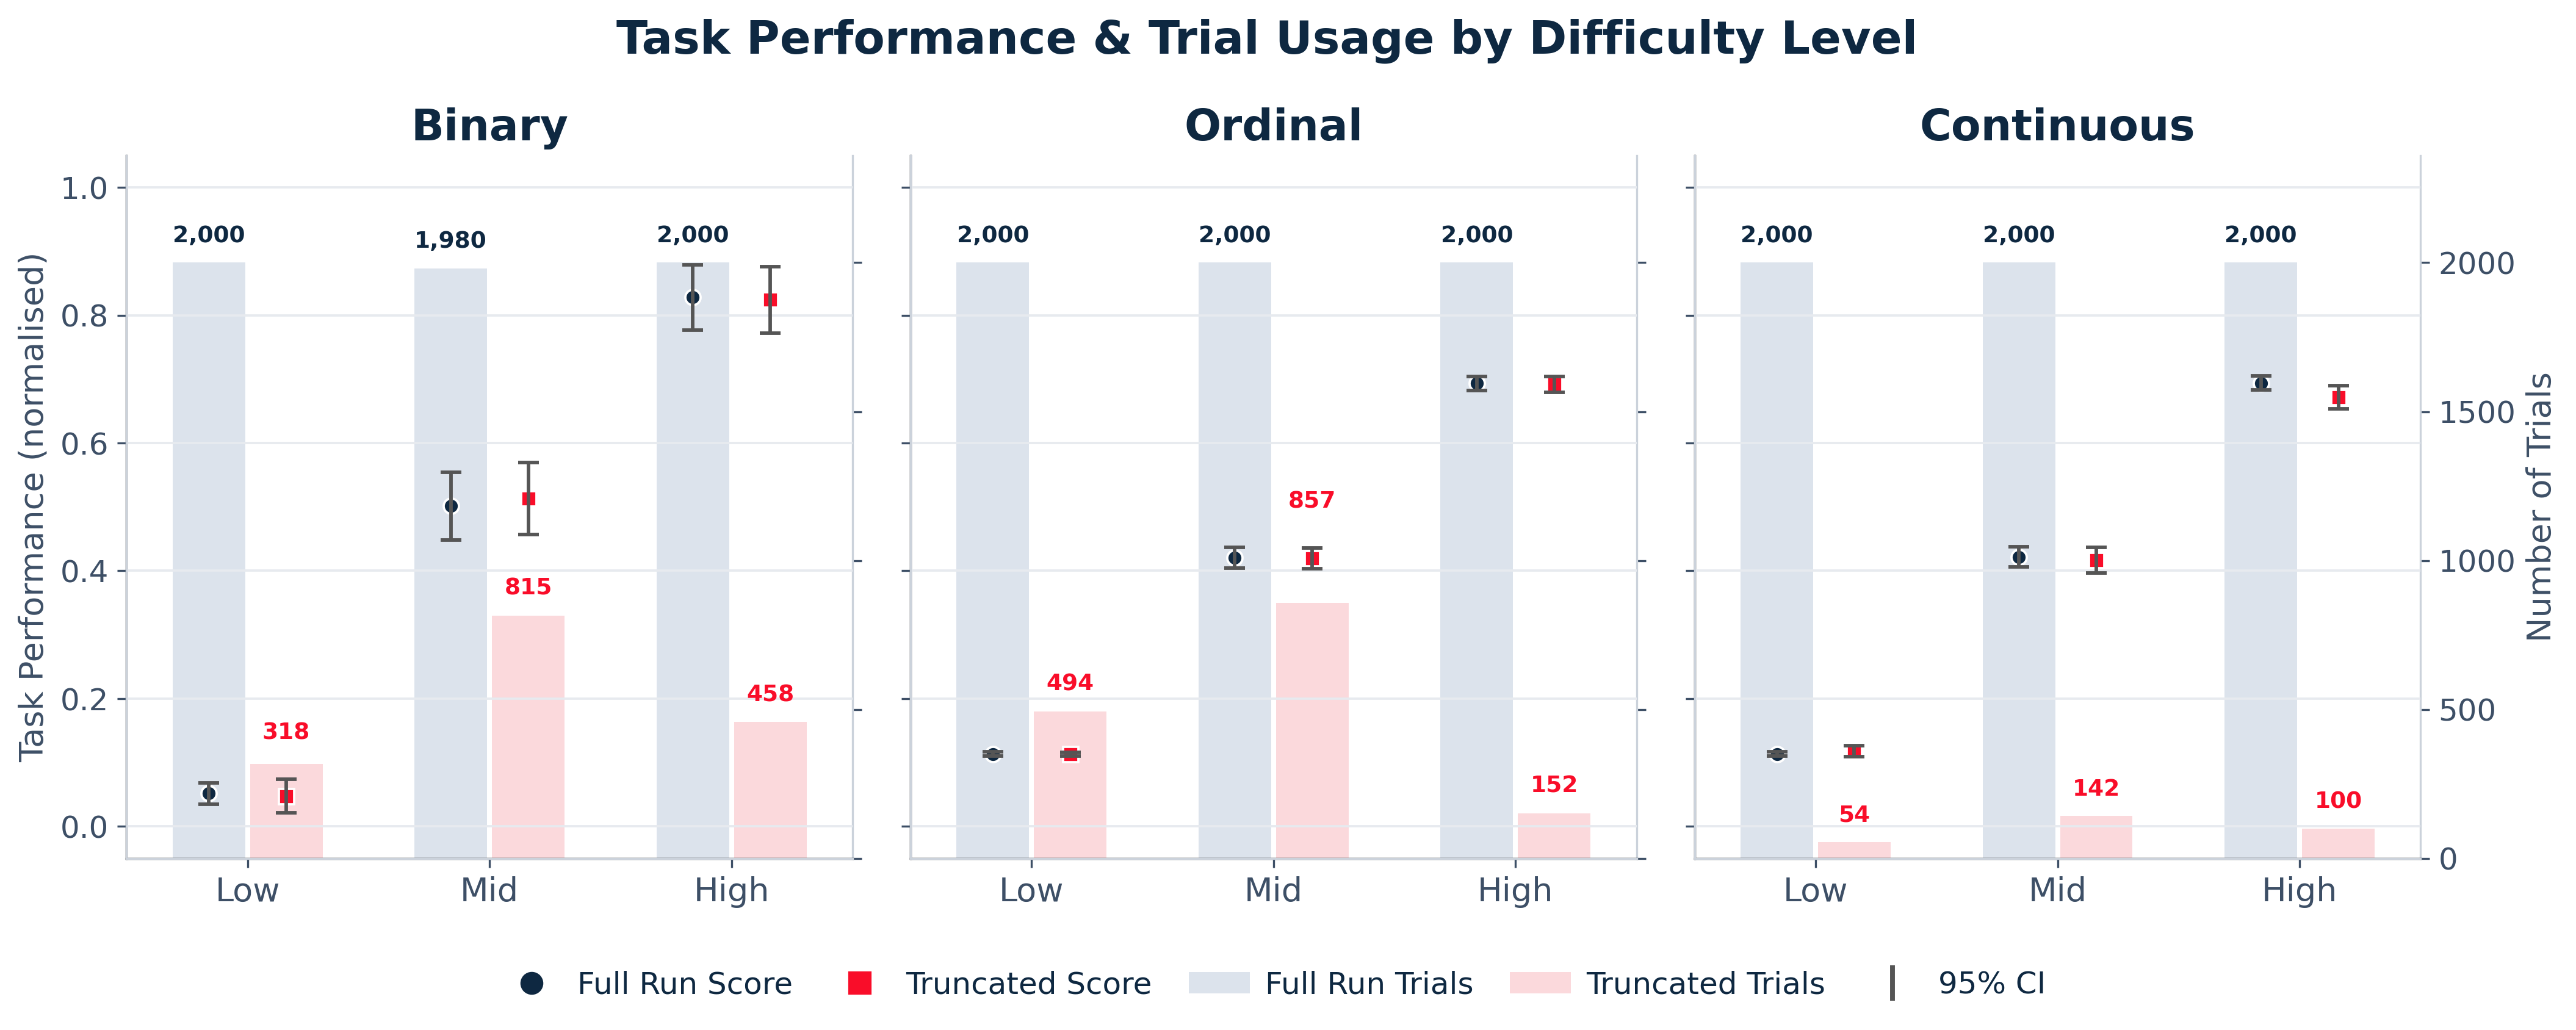
我们在三类基准测试中常见的评分类型上对 optstop 进行了测试——二元评分(如通过/失败)、序数评分(如 0-10 分的评分标准)和连续评分(如 0-100%)——并覆盖了三种预期模型性能水平(低、中、高)。这些测试在公开基准上运行,包括 MATH、GPQA Diamond 和 WritingBench。
我们发现,在所有条件下,optstop 的提前停止节省了计划试验次数的 57% 至 97%,且不影响分数估计(见图 2)。
当然,如果采用试验次数更少的精简设计,节省的试验次数可能较少,但当每次试验耗时漫长且成本高昂时,即便仅减少几次,也能带来可观的资源节省。
无风险试用
- 事后模式:评估者在已完成的评估上运行 optstop,确认停止时的估计与完整运行的估计一致。
- 影子模式:评估照常运行,同时 optstop 报告其本可实现的节省量,评估者的完整数据集得以保留。
- 实时模式:评估者在影子模式的数据令人满意后,开启实时停止功能。
部署十分轻量。若使用 Inspect,optstop 只需在评估配置中添加几行代码。主要的实际要求是任务需以随机顺序呈现,以确保早期估计不会因队列中试验的顺序而产生偏差——Inspect 支持此功能。
超越固定样本
随着评估者面临越来越大的压力,需要跟上模型发布的速度并确保前沿性能被评估有效捕捉,我们将 optstop 定位为一种工具,不仅提升评估吞吐量的效率,还将其直接且严谨地与我们对结论的信心挂钩。
optstop 的设计宗旨是轻量、低风险,并灵活适配各种评估设置。通过将其作为我们现有开源框架的一部分发布,我们希望帮助其他评估者自动化地将评估资源重新分配到仍存在不确定性的地方。
我们一直在 AISI 探索 optstop 的应用场景,将其作为应对评估瓶颈的潜在方法之一,并计划在未来开发和发布更多类似工具。
您可以在此处访问 optstop 软件包。
在此处阅读完整论文。

译文已达到本站中文翻译的字数上限,剩余内容请查看原文。