精选
面向多轮对话的智能体评估指标 AEM
作者提出 Agent Evaluation Metric(AEM),一种可分解的逐轮评估方法,用于衡量多轮智能体的质量。多轮智能体的失败模式是单轮评估无法捕捉的:早期某一轮的错误会污染后续所有轮次。AEM 首个维度为正确性,可定位导致失败的具体轮次,并将其与被动继承错误的后续轮次区分开。
标题:面向多轮对话的Agent评估指标
正文: 多轮Agent的失败方式,是单轮评估所无法捕捉的:早期的一个错误会悄然污染之后的每一轮。本文介绍Agent评估指标(AEM),一种可分解、轮次级别的Agent质量衡量方式。我们将其应用于第一个维度:正确性。我们展示AEM如何精确定位导致失败的那一轮,并将其与仅仅继承了该问题的后续轮次区分开来。
多轮Agent对话中的正确性挑战
在多轮对话中评估Agent正确性之所以困难,是因为这一属性本身很脆弱,而整体性评分会掩盖它在哪里出了问题。本节说明为什么级联错误会击败结果级评估,并引出一种可分解、轮次级别的指标。
为什么正确性很重要
一次错误的工具调用会级联引发跨轮次的下游失败。设想一个与企业助手进行的五轮对话。用户要求创建一份销售报告,然后对其进行细化。在第2轮中,Agent选择了正确的动作,但传入的是“profit”而不是“revenue”。这个单一错误随后会悄然传播到之后的每一轮。
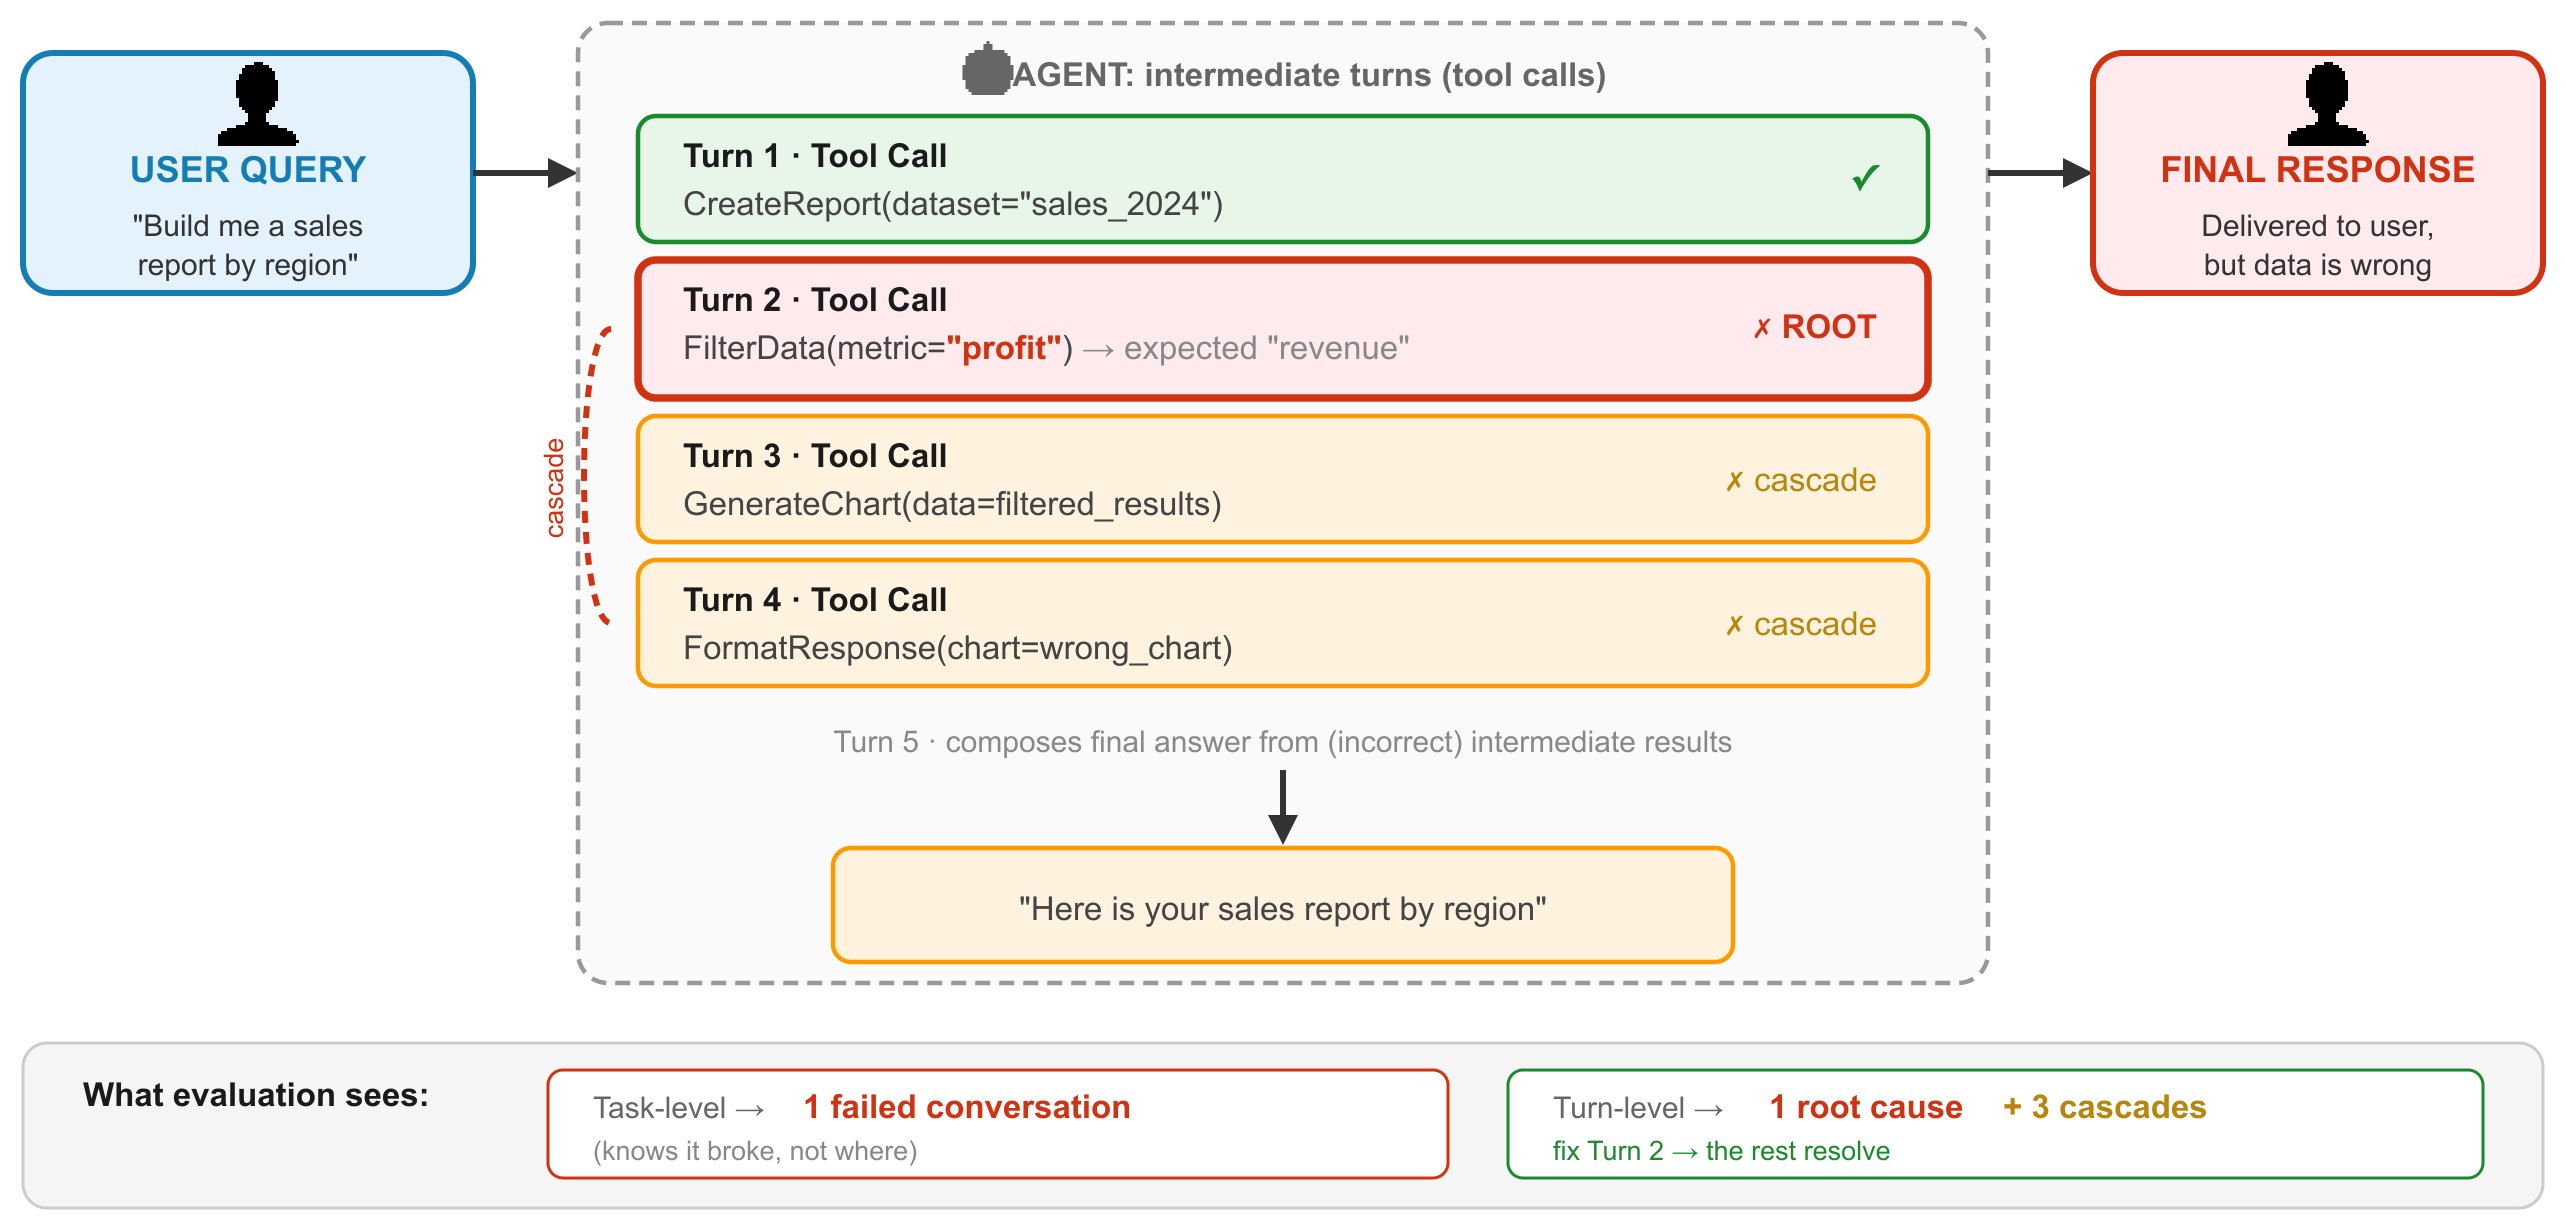
下图追踪了这一失败过程。它展示了第2轮中的一个早期错误如何级联影响第3至第5轮,以及轮次级评估如何将单一根因与其下游影响隔离开来。
任务级评估只检查最终结果。它会把整个交互标记为失败,却不揭示实际上只有一轮需要修复。这就是核心问题:在多轮Agent对话中,错误会级联,而结果级评估无法区分根因与其下游影响。
现有指标的局限
大多数Agent评估工具都是在任务级或响应级对质量进行整体评分。当前一代工具提供了目标完成度评分,以及以LLM作为评判者的质量评估。有些还加入了轨迹级根因分析。这些都很有价值,但它们共享同一种框架:Agent质量被视为单一信号,而不是被拆解为可独立追踪的各个部分。
它们没有提供的,是一种将质量分解为具名、可分别度量的子指标,并逐轮追踪的方法。知道一个Agent“在目标完成度上得分70%”并不能告诉你,这些失败是事实错误、信息缺失,还是工具选择错误。随着需求增长,单一分数也无法干净地扩展到新的维度。由此产生三个缺口:
- 任务级指标(目标成功率)告诉你Agent是否完成了任务,但没有告诉你哪个质量维度出了问题。
- 单轮指标(有用性、忠实性)孤立地评估响应,没有考虑错误如何跨轮次传播。
- 整体性分数无法区分事实错误与缺失必填字段,也没有提供明确路径来在不重构评估体系的情况下添加新维度(安全性、指令保持)。
一种可分解、轮次级别的评估模式可以弥补这些缺口。它将质量拆分为具名子指标,在完整轨迹中评估每一轮,并将它们组合为一个单一指标。同样的方法可以扩展到新维度,而无需改变机制。
作为复合指标的正确性
我们将Agent质量定义为一个单一复合指标,由AEM计算,并由具名、可分别度量的子指标构成。在本系列第一篇文章中,AEM通过两个子指标来衡量正确性:
- 真实性:Agent产生的值是否在事实层面与预期一致?这适用于工具调用中的参数值以及自然语言响应中的陈述。
- 完整性:所有必需元素是否都存在?没有缺失参数,也没有遗漏所请求信息的部分响应。
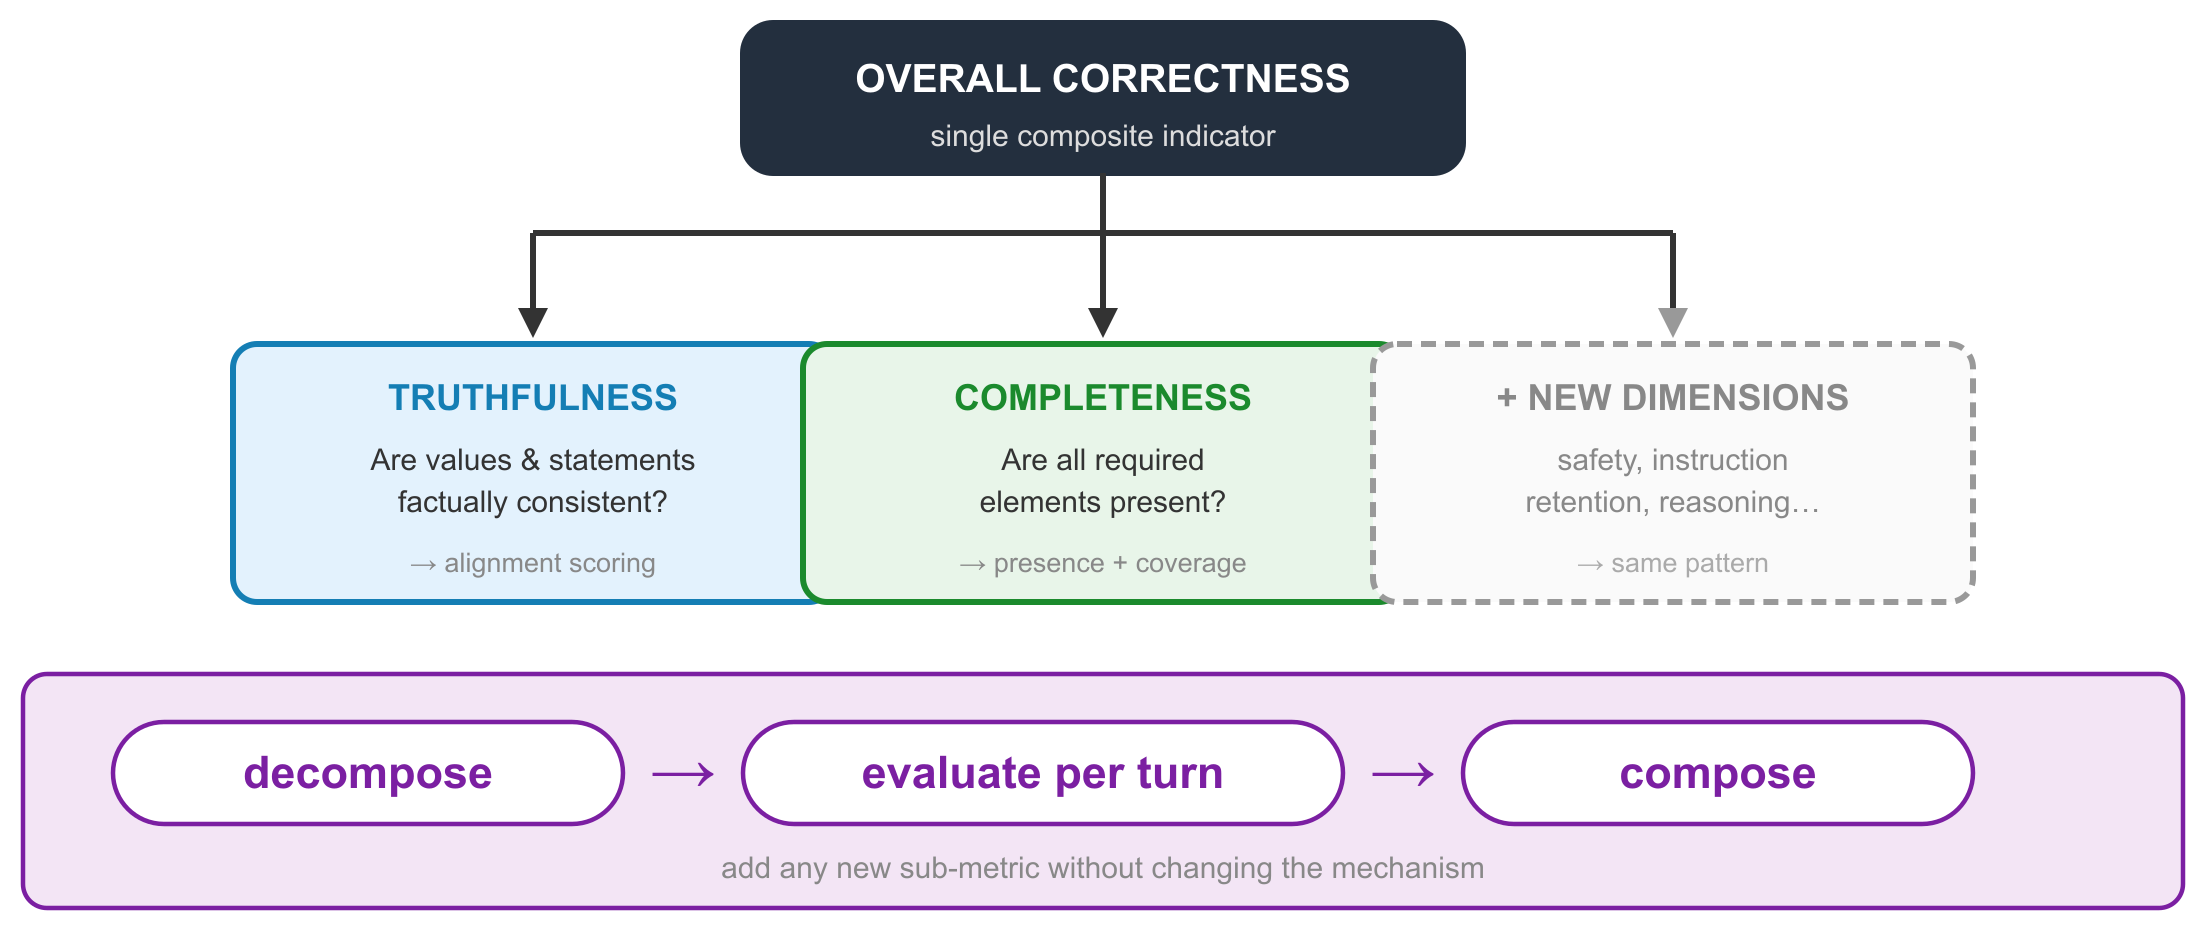
下图展示了这种分解方式。它说明了顶层分数如何拆分为具名的子指标,这些子指标被独立测量后再重新组合,以及同样的模式如何扩展到未来的维度。
核心贡献就是这种分解本身。AEM 不是一个单一的不透明分数,而是由多个子指标组成的复合体,每个子指标都可以按轮次测量,并可在整个轨迹中组合。工具和动作选择构成了它们之下的结构基础。同样的“分解—评估—组合”模式可以扩展到新的维度,例如安全性、指令保持和推理深度。正确性是我们要实例化的第一个维度。
Agent Evaluation Metric 框架
AEM 将分解思路转化为一个具体的、按轮次的指标。本节定义了轮次级别的层级结构、两个子指标及其组合方式,以及使分数可付诸行动的失败分类法。
轮次级别的层级结构
正确性按轮次计算。一个轮次要么是响应轮次,即智能体回复用户;要么是动作轮次,即智能体调用工具。我们先从响应轮次讲起,因为这是用户最终看到的内容,而同样的指标也适用于动作轮次。两者都属于同一个层级结构。

下图展示了这个共享的层级结构。它显示了同样的两个子指标,一侧评估工具调用(参数键和值),另一侧评估自然语言响应(覆盖度和事实性)。
对于响应轮次,这两个子指标适用于自由文本。完整性追问回复是否覆盖了完整查询,真实性追问其是否在事实上一致。同样的复合指标也适用于动作轮次。在那里,完整性检查参数键,确认所有必需参数都已存在。真实性检查参数值,确认它们在语义上正确。两者都建立在一次结构检查之上,即是否选择了正确的工具和动作。
在本文中,一个轮次的正确性被视为二元的:通过或失败,并给出一个具体的失败原因,指明子指标和字段。同样的分解也支持更细粒度的评分,即以连续尺度对单个断言或字段打分。
在对话中组合后,AEM 分数就是通过轮次的比例。由于它按子指标分解,分数下降能显示出是哪个维度——真实性还是完整性——导致了变化,而不只是正确性下降了。
分解并形式化 AEM
这两个子指标都依赖语义比较,而不是精确匹配。对于响应和参数值来说,精确字符串匹配过于脆弱。“New York City”和“NYC”在语义上等价,而“Q3 2024 revenue”和“third quarter revenue figures for 2024”传达的是相同信息。
语义相似度评分用于判断两个值是否在语义上等价。从概念上讲,这种检查如下所示:
def evaluate_truthfulness(gold_value, predicted_value, scorer, threshold=0.5):
    """Score semantic equivalence of a predicted value against gold."""
    if gold_value == predicted_value:
        return True, 1.0  # Exact match (fast path)

    score = scorer.score(gold_value, predicted_value)
    return score >= threshold, score
评分器可以是基于嵌入的相似度检查(快速、低成本),也可以是 LLM-as-judge 调用(更细致)。嵌入检查是一个透明的编码器加相似度函数,而评判器则是一个更不透明的基于解码器的模型,其评分无法被直接检查。阈值控制严格程度:更高的阈值能捕捉真实错误,但有把语义等价项标记出来的风险;更低的阈值则更宽松。这里的 0.5 是一个中性的起始默认值,而不是经过调优的值。正确的取值取决于你的领域对假阳性与假阴性的容忍度(见经验教训)。
相似度分数是连续的。阈值的作用是将其压缩为本文中的二元轮次判定,而更细粒度的设置可以保留每个声明的分数。
完整性对响应轮次进行语义检查(响应是否回答了完整的问题?),对动作轮次进行结构检查(所有必需的参数键是否都存在?):
def evaluate_completeness(gold_args, predicted_args):
    """Check all required parameters are present, with no unexpected extras."""
    missing = set(gold_args.keys()) - set(predicted_args.keys())
    extra = set(predicted_args.keys()) - set(gold_args.keys())
    return len(missing) == 0 and len(extra) == 0, missing, extra
返回的缺失和多余集合直接输入失败分类体系。非空的缺失集合产生 missing_parameters 失败,非空的多余集合产生 extra_parameters 失败,精确指出哪些参数出了问题。
组合分数。分解产生每个子指标、每个轮次的判定。组合将它们变成一个数字。组合规则本身是一种选择,与该框架的可组合原则一致。本文中的默认设置是通过轮次的未加权平均值。
其他规则同样有效。加权平均给出错代价更高的轮次更多权重。门控规则允许单个关键轮次的失败将分数封顶。按子指标阈值则为每个维度设定单独的标准。该框架将这种组合函数视为可插拔的。
失败分类体系与动作链
当一个轮次失败时,一个具体的失败原因精确捕获了出错的地方。该分类体系涵盖两种轮次类型:响应轮次失败与动作轮次失败处于同一层级,而结构检查(工具和动作选择)仅适用于轮次调用工具的情况。
| 失败原因 | 适用于 | 子指标 | 含义 |
|---|---|---|---|
| inconsistent_response | 响应轮次 | 真实性 | 响应与参考事实不一致 |
| incomplete_response | 响应轮次 | 完整性 | 响应遗漏了部分请求信息 |
| tool_mismatch | 动作轮次 | 结构性 | 选择了错误的工具 |
| action_mismatch | 动作轮次 | 结构性 | 工具正确,操作错误 |
| missing_parameters | 动作轮次 | 完整性 | 未提供必需参数 |
| extra_parameters | 动作轮次 | 完整性 | 添加了意外参数 |
| inconsistent_parameter_values | 动作轮次 | 真实性 | 值存在但语义错误 |
| prior_action_failed | 任一类型轮次 | 级联 | 非根本原因。由先前轮次导致 |
真实性和完整性这两个子指标是两种轮次类型中恒定不变的。只有结构检查是工具特定的。prior_action_failed 标签是使该指标在多轮设置中具有可操作性的关键。它将根本原因与级联效应区分开来,并且它可以同样附着于响应轮次和动作轮次。评估器通过依赖关系分配该标签。当一个轮次的失败源于该轮次本身时,它是根本原因。当它失败仅仅是因为消费了一个已经失败的轮次的输出时,它获得 prior_action_failed 标签。在开头的示例中,只有轮次 2 是根本原因,轮次 3–5 继承该标签。该指标还跟踪动作链长度(单次调用、两步以及复杂的三步以上序列),因为较长的链集中了大部分退化。
智能体工作流的评估流水线
前面描述的指标在一个可重复的流水线中运行。标注对话输入,输出一个分解后的单一 AEM 分数,按轮次归因并在智能体生命周期中被消费。
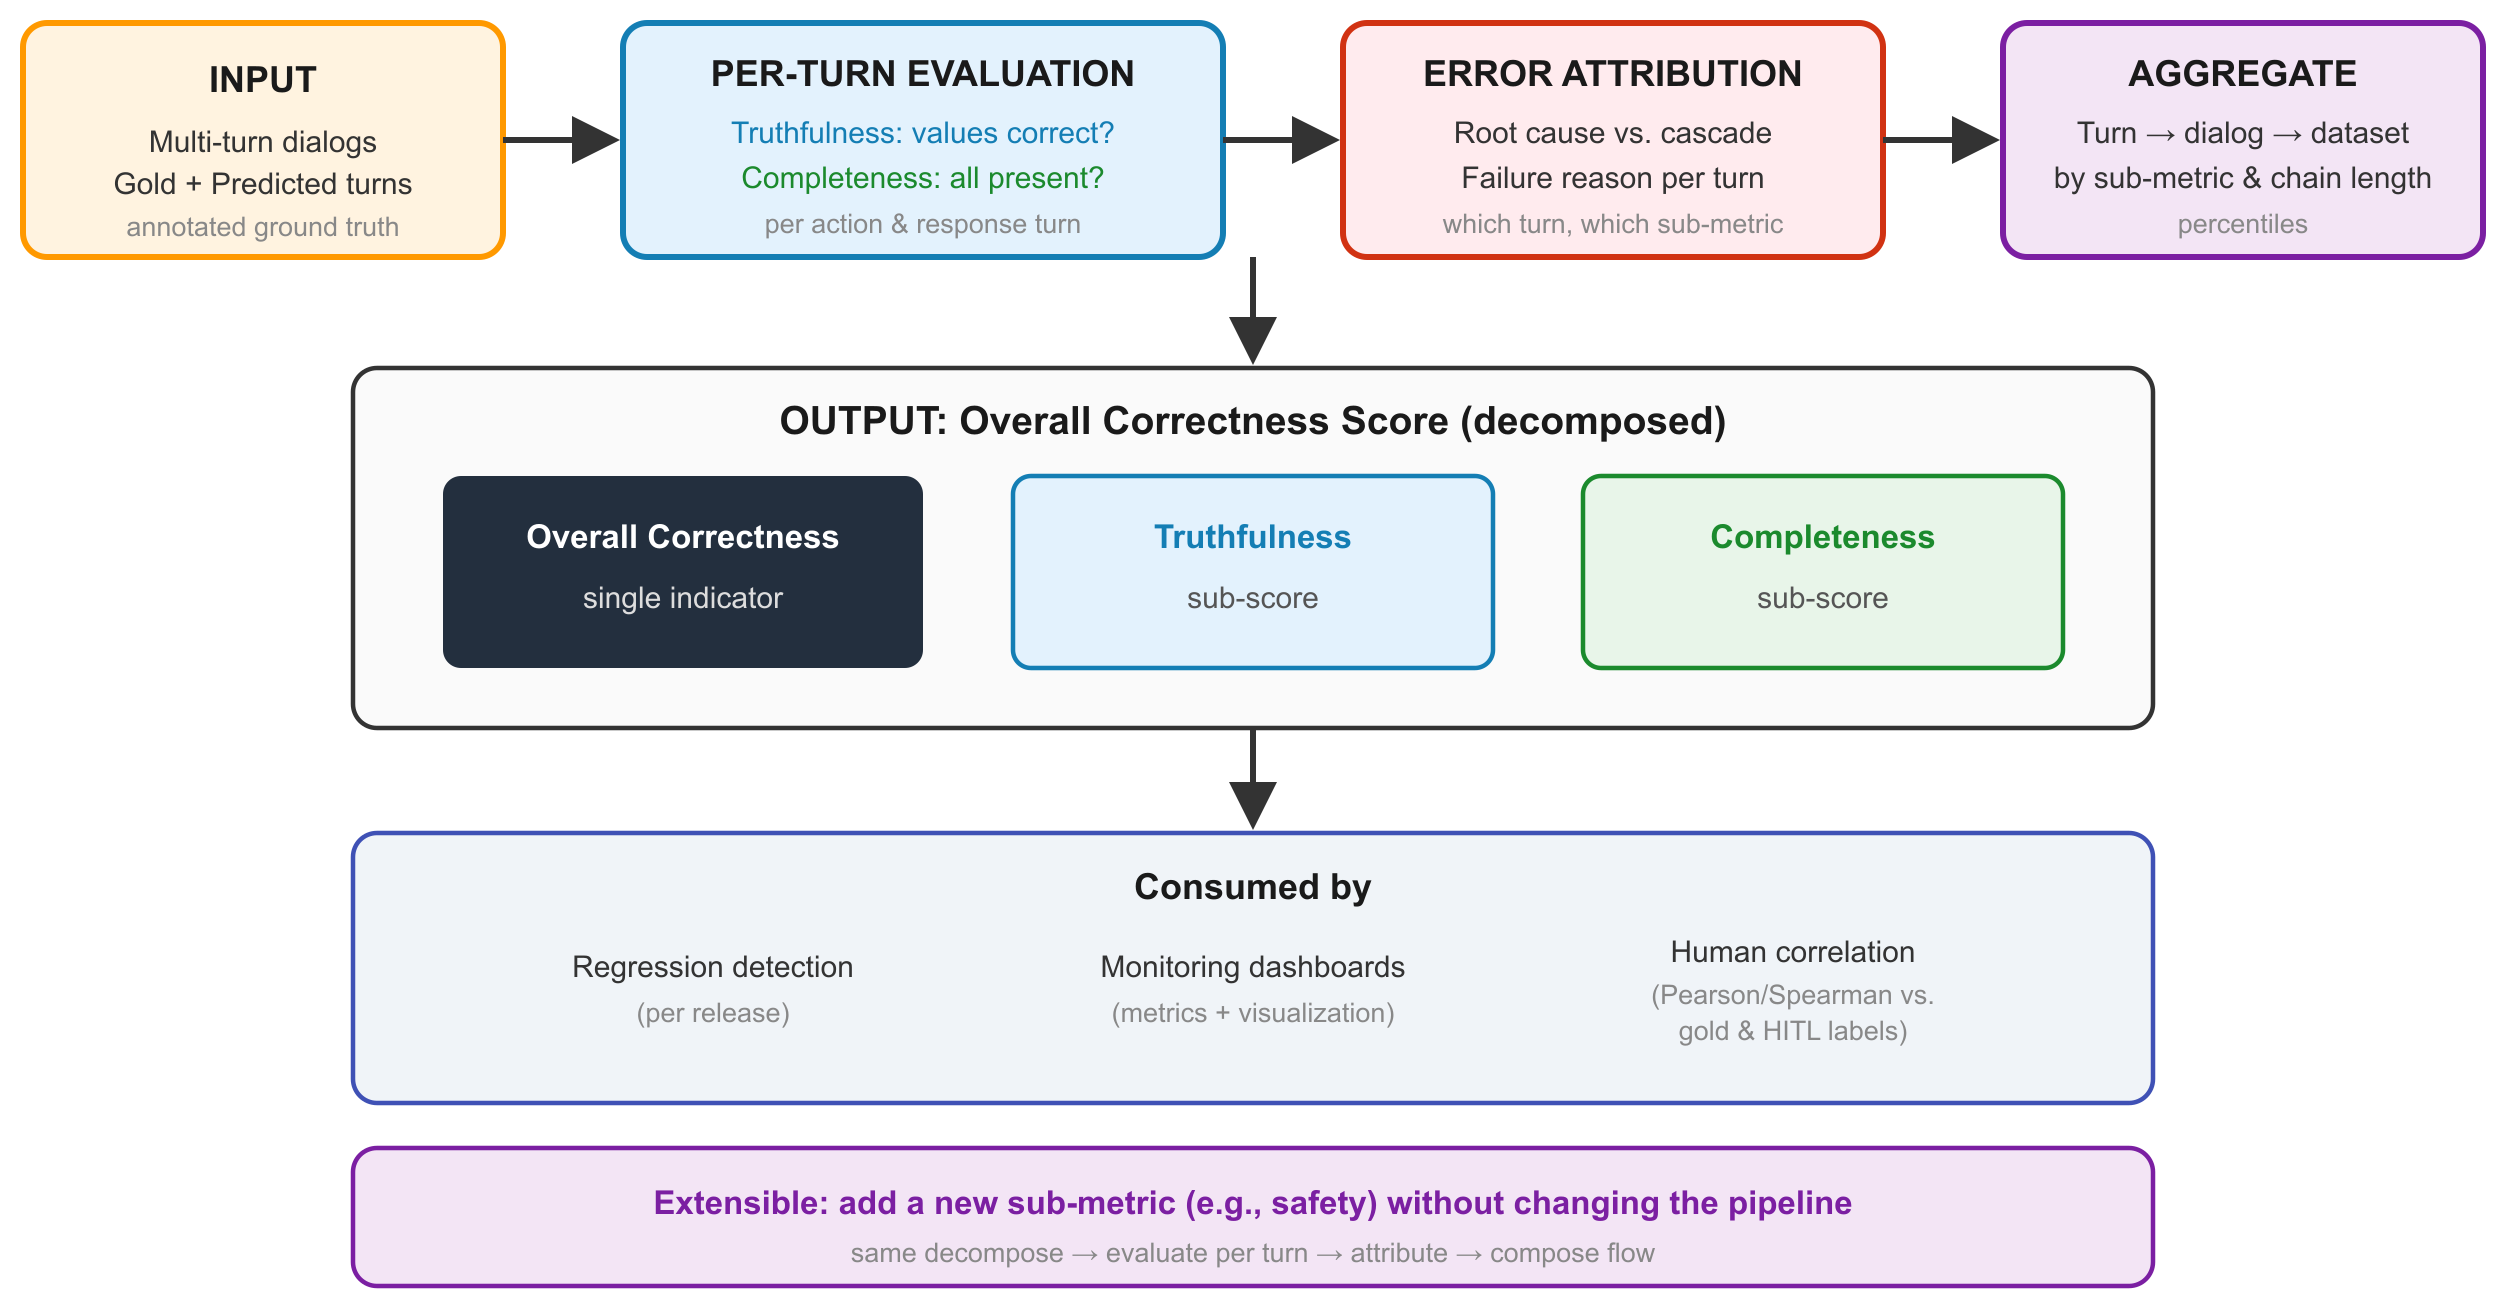
下图展示了该端到端流程,从标注对话经过逐轮评分和归因,到在开发和生产中消费的单一分数。
{"success_rate": 0.2, "test_pass": false,
 "first_failure_turn": 2, "root_cause": "inconsistent_parameter_values",
 "root_cause_count": 1, "cascading_count": 3}
黄金数据集设计
评估始于真值标注:即正确回复和正确工具调用均已标注的对话。这一黄金参考通常由人工标注(或在从更强模型引导时经人工审核),因为它定义了每一轮中“正确”的含义。每个对话是一系列轮次,每一轮将黄金(预期)输出与预测(实际)输出配对。每一轮带有一个轮次角色,标识其由谁产生。回复轮和动作轮如下所示:
[
  {
    "turn_no": 1,
    "turn": "Agent",
    "gold_turn":    {"response": "Which region should the report cover?"},
    "predict_turn": {"response": "Sure, which region would you like the report for?"}
  },
  {
    "turn_no": 2,
    "turn": "Tool",
    "gold_turn":    {"tool_id": "reports", "action": "FilterData",
                     "args": {"metric": "revenue", "region": "EU"}},
    "predict_turn": {"tool_id": "reports", "action": "FilterData",
                     "args": {"metric": "profit",  "region": "EU"}},
    "tags": ["OrderInvariant_filter"]
  }
]
比较黄金输出与预测输出,即可得出每一轮的正确性判定。回复轮通过:措辞与黄金输出不同,但语义等价,这正是语义相似度评分所要衡量的。动作轮失败:在指标值上暴露出真实性错误(预期为 revenue,实际为 profit)。tags 字段支持顺序无关的评估。当多个工具调用以任意顺序执行均有效时,例如查看日历和搜索航班,评估器会对照所有有效顺序进行检查。它不会惩罚正确但顺序不同的行为。
错误归因
在每一轮都被评估之后,错误归因将根因与级联效应区分开来。它基于轮次判定运行,无论该轮是回复还是动作:
def attribute_errors(turn_results):
    """Separate root cause failures from cascading failures."""
    root_causes = []
    cascading = []

    for result in turn_results:
        if not result.success:
            if result.failure_reason == "prior_action_failed":
                cascading.append(result)
            else:
                root_causes.append(result)

    return {
        "first_failure_turn": root_causes[0].turn_no if root_causes else None,
        "root_cause": root_causes[0].failure_reason if root_causes else None,
        "total_failures": len(root_causes) + len(cascading),
        "root_cause_count": len(root_causes),
        "cascading_count": len(cascading),
    }

# Example output:
# first_failure_turn: 2, root_cause: "inconsistent_parameter_values"
# root_cause_count: 1, cascading_count: 3
# Fix the parameter in turn 2; turns 3-5 likely resolve automatically.
这改变了团队确定修复优先级的方式。他们不再逐一调查每个失败,而是聚焦于根因,因为级联失败往往在根因修复后自行消解。否则,多步链条中的单个根因可能表现为多个不同的失败。
生产监控
- 按发布版本统计的整体正确性(回归检测):最新的模型更新是否降低了轮级成功率?
- 按链条长度统计的正确性:复杂的多步链条是否会随时间退化?
- 失败原因分布(根因趋势):模型更换后 tool_mismatch 是否在增加?
- 延迟相关性:累计延迟更高的对话是否表现出更低的正确性?
该框架输出结构化 JSON,供监控仪表盘使用。有些错误代价高昂,例如财务计算或合规相关回复。对于这些情况,分解后的子指标分数还可以与人工或黄金标签进行相关性分析。按子指标计算相关性(例如 Pearson 或 Spearman)可以显示自动评分是否与人工判断一致,以及应在何处引入审核人员。
与 Strands Agents 评估 SDK 集成
该方法论与框架无关,但许多团队通过现有测试框架运行评估。轮次级正确性信号作为自定义评估器与 Strands Agents 评估 SDK 集成。在此基础上,它接入团队已用于目标完成度和 LLM-as-judge 评分的同一流水线。这些内置评估器将质量报告为整体、按轨迹的信号。AEM 是互补的,它提供分解的、按轮次的正确性分数,将失败归因到特定子指标和轮次。该封装器复用了本文前面构建的按轮次检查(evaluate_truthfulness、evaluate_completeness 以及归因逻辑):
from strands_evals.evaluators import Evaluator
from strands_evals.types import EvaluationData, EvaluationOutput


class CorrectnessCustomEvaluator(Evaluator):
    """Wraps the turn-level correctness checks as a Strands Agents custom evaluator."""

    def __init__(self, threshold: float = 0.5, name: str = "correctness"):
        super().__init__(name=name)
        self._threshold = threshold

    def evaluate(self, evaluation_case: EvaluationData) -> list[EvaluationOutput]:
        # Run the per-turn truthfulness + completeness checks over the dialog
        turn_results = evaluate_dialog(evaluation_case, threshold=self._threshold)

        success_rate = sum(r.success for r in turn_results) / len(turn_results)
        failures = [r.failure_reason for r in turn_results if not r.success]
        return [
            EvaluationOutput(
                score=success_rate,
                test_pass=all(r.success for r in turn_results),
                reason=f"failing turns: {failures}" if failures else "all turns pass",
                label="correctness",
            )
        ]
这里 evaluate_dialog 应用前面展示的相同按轮次真实性和完整性检查,并为每一轮返回一个结果。这种模式将评估逻辑(分解、失败分类法、轮次级组合)保持为可移植的自定义代码,而 Strands Agents 提供运行器、追踪收集和报告。具体而言,每次运行都会产生按轮次追踪(工具调用和模型调用的 span)以及结构化报告。你可以将该报告显示或导出为 JSON 到自己的仪表盘和告警系统。AEM 增加了按轮次正确性分数。该封装器在一次运行中将正确性信号与其他评估器一起运行,包括我们将在下一篇文章中介绍的安全评估器。
将该框架应用于 Amazon Quick Suite
Amazon Quick Suite 是一个企业助手,运行的正是该指标所针对的那种多轮、多工具对话。本节不报告内部生产数据,而是通过开头示例中的销售报告对话,说明团队如何解读 AEM 输出。
解读 AEM 分数
用户最终评判的是他们在每一轮收到的回复,因此该回复就是我们在整个对话中逐轮评估的单元。在单个回复背后,智能体通常会在交互延迟约束下串联多个工具调用,而 AEM 对由此产生的正确性进行评分。
在整个对话上运行评估流水线,会生成该对话的单一 AEM 分数及其分解。success_rate 是领先指标,同时还有按子指标的细分以及 test_pass 标志;只有当每一轮都通过时,该标志才为 true。同一次调用还会返回驱动错误归因的按轮次失败原因。
一个归因示例
回到那个五轮销售报告对话。第 2 轮在预期为 revenue 的位置传入了 profit,因此它在真实性上失败,错误为 inconsistent_parameter_values。第 3–5 轮建立在该结果之上,也失败了,但属于级联失败:每一轮都带有 prior_action_failed。原始失败计数会报告四个出错的轮次。归因则报告第 2 轮有一个根因,以及三个下游影响,而后者才是真正重要的数字。
实用规则是先归因,再调查。以下反复出现的模式将这一点具体化,表格总结了每种情况下应首先检查的位置。
| 你观察到的现象 | 应首先检查的内容 | 典型根因 |
|---|---|---|
| 许多失败聚集在一条长链中 | 第一个失败的轮次,而不是失败数量 | 一个早期 inconsistent_parameter_values 向下游级联 |
| 失败出现在对话中段 | 通过 prior_action_failed 标签找到出错的轮次 | 上游的 missing_parameters 或 action_mismatch |
| 响应看起来不对,但每次工具调用都成功 | 响应轮次的真实性和完整性 | inconsistent_response 或 incomplete_response |
结论是,更长的链条会把更大比例的失败推回到更早的轮次,而不是独立错误。修复少量根因即可解决许多观察到的失败,因此归因把一份嘈杂的失败列表变成一份简短、有序的修复列表。
经验教训
在实践中应用 AEM 后,总结出了一些经验教训。首先,先归因再调查:prior_action_failed 标签将根因与级联失败区分开来,因此链条中的一个早期错误不会被解读为许多独立失败。
其次,根据你的领域调整相似度阈值。依据你对假阳性与假阴性的容忍度来设定它。阈值过严会把“NYC”与“New York City”这类语义等价项标记出来,而阈值过宽则会漏掉真实错误。
第三,标记顺序无关步骤。当多个工具调用以任意顺序执行都有效时,标记它们可以让评估器认可有效的替代顺序,而不是将正确行为判为失败。
另外两条更广泛的经验教训关乎信任与扩展。对于代价高昂的错误,通过将分解后的子指标与人工或金标准判断相关联,来对照人工标签进行验证。在未检测到的错误会带来真实后果的地方,引入审查者参与流程。并且通过新增子指标而不是新增流水线来扩展:定义每轮标准和一个失败分类体系,然后用同一评分进行组合。规划质量、指令保持和安全性都遵循这种方法。
结论与下一步
本文介绍了 Agent Evaluation Metric (AEM),将其作为多轮智能体对话的单一复合指标,并应用于其第一个维度:正确性。AEM 将正确性分解为具名子指标(真实性和完整性),并在轮次级别评估它们,同时提供精确的错误归因。它不止于检测失败:它识别出哪个维度出了问题、是哪一轮导致的,以及后续失败是根因还是级联影响。
该方法适用于团队已经在运行的评估工作流。金标准优先,然后 AEM 通过真实性和完整性对每一轮评分。错误归因随后将根因与级联失败区分开来,因此计数反映的是独立问题,而不是下游噪声。跨模型版本跟踪该分数,可将该指标转化为回归信号,并通过 custom-evaluator wrapper 在现有的 Strands Agents 流水线中运行。分数下降会指向应负责的子指标,而失败分类体系会识别出需要调查的具体轮次。
正确性是 AEM 通过一种刻意可扩展的方法实例化的第一个维度:将质量概念分解为命名的子指标,在完整轨迹中评估每一轮,归因失败,并将结果组合成单一指标。本系列的下一篇文章将把同样的方法应用于安全性,后续文章会将其扩展到多语言和多模态评估。
要开始使用,请探索 Strands Agents 示例仓库中的可运行示例以及 Strands Agents 评估文档,然后根据你自己的对话调整前面展示的自定义评估器。要了解此处使用的企业助手,请参阅 Amazon Quick Suite。今天采用正确性的团队可以随着需求增长添加安全性及其他维度。
关于作者
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。