精选Cohere Blog发布
发布 Embed 5:前沿企业级嵌入模型家族
Cohere 发布 Embed 5 系列嵌入模型,包含 Pro 和 Fast 两个版本。Pro 版在金融、PDF 及多模态检索上表现最强,Fast 版侧重低延迟与低成本。两者共享嵌入空间,支持 128K 上下文及 Matryoshka 表示,已上线 Cohere API 及主流云平台。
- 最先进的企业检索:Embed 5 Pro 在我们测试的所有模型中取得了最高的平均得分,尤其在金融数据集、解析后的 PDF 以及视觉丰富的文档方面表现突出。
- 新增 Fast 层级:Embed 5 Fast 将强大的检索质量引入对延迟和成本敏感的工作负载,价格为每百万令牌 0.08 美元。
- 一个索引,两种模型:Pro 和 Fast 共享嵌入空间,因此团队可以使用 Pro 进行索引,并使用任一模型进行查询,而无需重新索引。
- 专为复杂企业数据构建:Embed 5 支持多模态输入与检索、100 多种语言,并提供 128K 令牌的上下文窗口以处理更长文档。
- 规模化下更高效:Matryoshka 表示法和低精度输出降低了向量存储和搜索成本,而量化权重则降低了私有部署的服务要求。
今天,我们发布 Embed 5,这是一个全新的嵌入模型系列,代表了高质量企业检索的前沿水平。
Embed 5 在复杂的企业数据上提供更强的检索能力,同时赋予团队对延迟、成本和部署的更多控制权。Embed 5 Pro 针对多模态、多语言、金融、代码和解析文档检索的最大化质量进行了优化。Embed 5 Fast 则为对延迟和成本敏感的工作负载带来了极具竞争力的性能。这两个层级共享单一嵌入空间,因此团队可以使用 Pro 进行索引,并使用任一模型进行查询,而无需重建索引。
Embed 5 为搜索、RAG(检索增强生成)和智能体工作流建立了检索基础,在将噪声过滤到昂贵的生成式模型之前,揭示更相关的上下文。使用 Embed 可以提高答案质量和用户体验,同时帮助控制下游推理成本。
Embed 5 今天已在 Cohere API 和 Model Vault、Microsoft Foundry 以及 Amazon SageMaker 上全面可用。Pro 的价格为每百万令牌 0.12 美元,Fast 的价格为每百万令牌 0.08 美元。
概览
| 功能 | Embed 5 Pro | Embed 5 Fast |
|---|---|---|
| 最佳用途 | 最大检索质量;离线索引;复杂企业语料库 | 交互式搜索;高容量 RAG;智能体检索 |
| 上下文长度 | 128K 令牌 | 128K 令牌 |
| 输入 | 文本、图像、融合文本+图像 | 文本、图像、融合文本+图像 |
| 语言 | 100+ | 100+ |
| 输出维度 | 2048, 1536, 1024, 768, 512, 256 | 2048, 1536, 1024, 768, 512, 256 |
| 嵌入格式 | float, int8, binary | float, int8, binary |
| Matryoshka 嵌入 | 是 | 是 |
| 共享嵌入空间 | 是 | 是 |
| 支持自托管 | 是 | 是 |
| 定价 | $0.12 / 1M 令牌 | $0.08 / 1M 令牌 |
性能
Embed 5 Pro 提供了迄今为止最强的检索性能。它在 ViDoRe V3、金融文档、解析后的 PDF、图像检索以及关键业务语言方面,在所有我们测试的模型中取得了最高的平均得分。
Embed 5 也是首个通过 RCP-nDCG@10 进行评估的模型系列,这是我们要最新的检索方法。它不仅仅针对有限的一组固定标签进行评分,而是根据特定于查询的相关性标准评估检索到的文档,捕捉相关结果并提供对您自身语料库性能的更全面视图¹。了解更多关于 RCP-nDCG@10 的信息。
企业文档
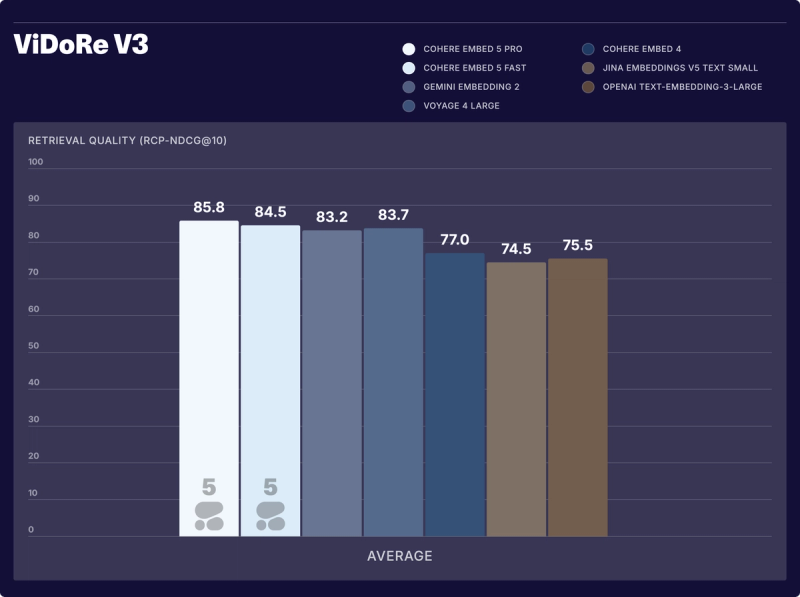
Embed 5 在处理视觉丰富的文档时表现出色,这些文档的意义存在于表格、图表、 diagrams 和布局中,而不仅仅是文本。在 ViDoRe V3 上,该数据集包含来自关键企业领域的文档样本,包括财务报告、技术手册、监管材料、政府报告、教科书和讲座,Embed 5 Pro 的平均得分为 86.1,相比 Embed 4² 提升了惊人的 8.8 分。
这使其领先于 Voyage 4 Large(83.7)、Gemini Embedding 2(83.2)和 OpenAI text-embedding-3-large(75.3)。Pro 在八个领域中的五个领域独占鳌头,在能源领域与 Voyage 4 Large 持平,相较于 Embed 4,其在人力资源(+11.4)和工业(+10.3)领域的提升最大。Embed 5 Fast 平均分为 84.7,领先于 Gemini Embedding 2 和 Voyage 4 Large。完整结果请见此处。
金融
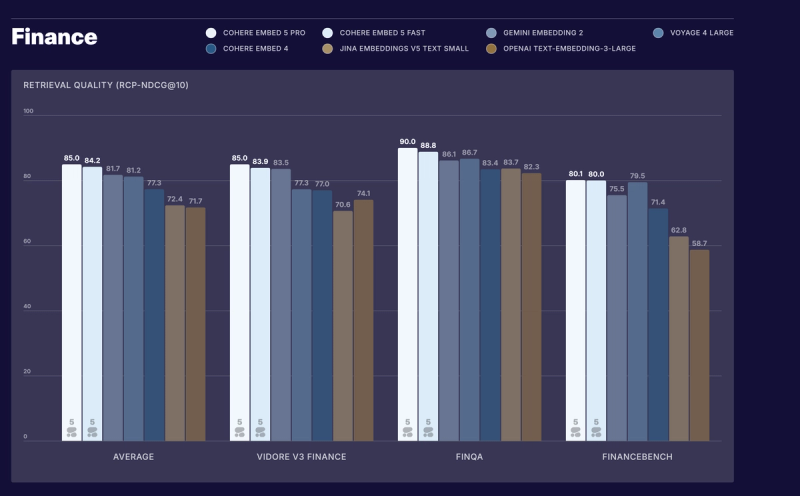
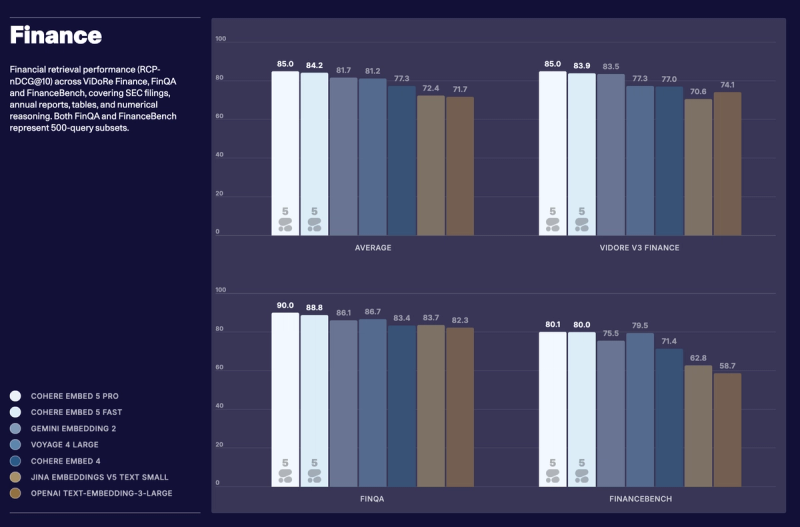
Embed 5 Pro 确立了其作为金融文档检索领先嵌入模型的地位。
Pro 在三个主要的公开金融基准测试中排名第一,尽管 Fast 模型的规模远小于其同类竞品,但在每项测试中均排名第二:FinanceBench(Pro 为 80.1,Fast 为 80.0)、FinQA(90.0,88.8)和 ViDoRe V3 Finance(85.0,83.9)。
在这些测试中,Pro 的平均分比下一个非 Cohere 竞争对手 Gemini Embedding 2 高出 3.3 分。与 OpenAI text-embedding-3-large 相比,其在 FinanceBench 上的领先优势扩大至 21.4 分。
多模态
解析后的 PDF
大多数企业搜索管道仍会在嵌入之前将 PDF 转换为文本,但这一过程可能会破坏结构。表格会丢失行和列的关系,多栏布局可能会打乱阅读顺序,重复的页眉会增加噪声,而图表往往会完全消失。这使得解析文档检索成为一项比干净文本基准测试所暗示的更具挑战性的任务。
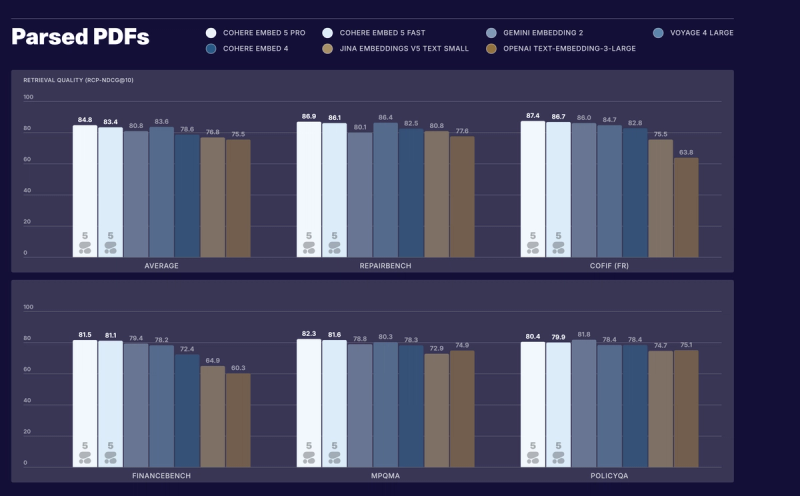
我们的解析文档套件涵盖服务文档、企业报告、SEC 备案文件、产品手册和隐私政策。Embed 5 Pro 在该套件中实现了最高的平均分 84.8,领先于 Voyage 4 Large(83.6)、Embed 5 Fast(83.4)、Gemini Embedding 2(80.8)和 Embed 4(78.6)。下图突出显示了一部分熟悉的公共基准测试,其中 Embed 5 Pro 在由 FinanceBench 和 CoFiF 代表的金融文档方面表现尤为强劲。
某些文档以视觉形式呈现效果更好。扫描页面、幻灯片演示文稿、示意图和图表包含文本提取可能遗漏的信息。Embed 5 可以直接嵌入页面图像(page-image),或者将图像与其元数据结合成单个向量(fused text-image)。
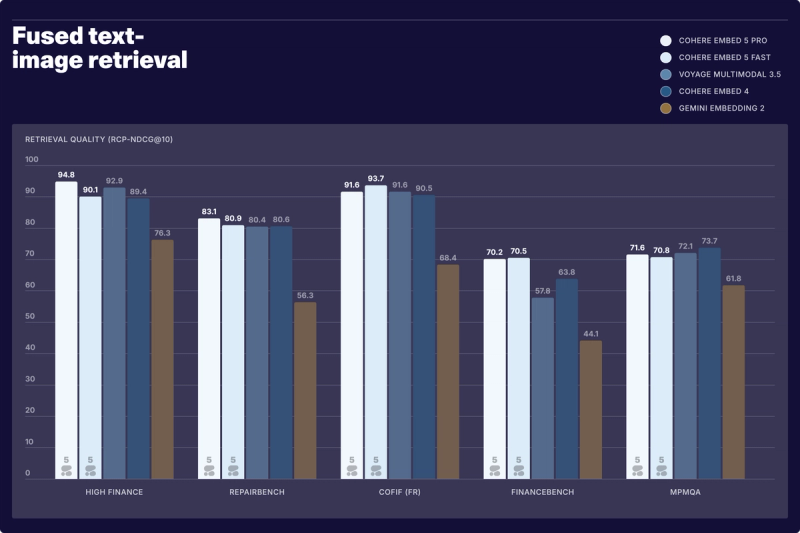
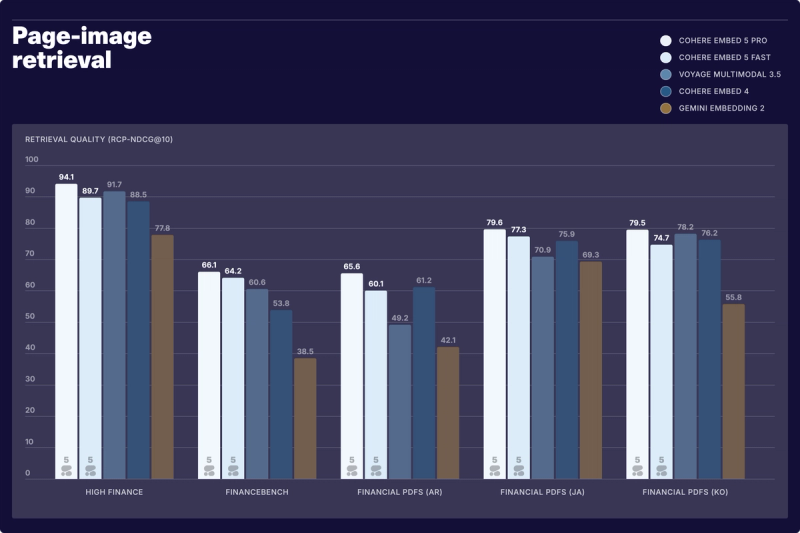
在融合文本-图像语料库上,Embed 5 Pro 在五组数据集上的平均分为 82.3,领先于 Embed 5 Fast(81.2)和 Gemini Embedding 2(61.3)。Pro 在该套件的所有数据集中均优于 Gemini Embedding 2。页面图像检索同样稳健:Embed 5 Pro 继续在金融数据集中保持领先地位,五组数据集的平均分为 77.0,领先于 Embed 5 Fast(73.2)、Embed 4(71.1)、Voyage Multimodal 3.5(70.1)和 Gemini Embedding 2(56.7)。
多语言
Embed 5 使用超过 100 种语言进行训练,特别关注全球客户群体最常用的语言。
在德语、法语、西班牙语、意大利语和俄语方面,Embed 5 Pro 在我们测试的模型中取得了最高的平均分 77,高于 Voyage 4 Large 的 76 和 Gemini Embedding 2 的 73。相较于 Embed 4,其平均分提升了约 7 分,其中在俄语(+9)和意大利语(+7)方面的提升最大。
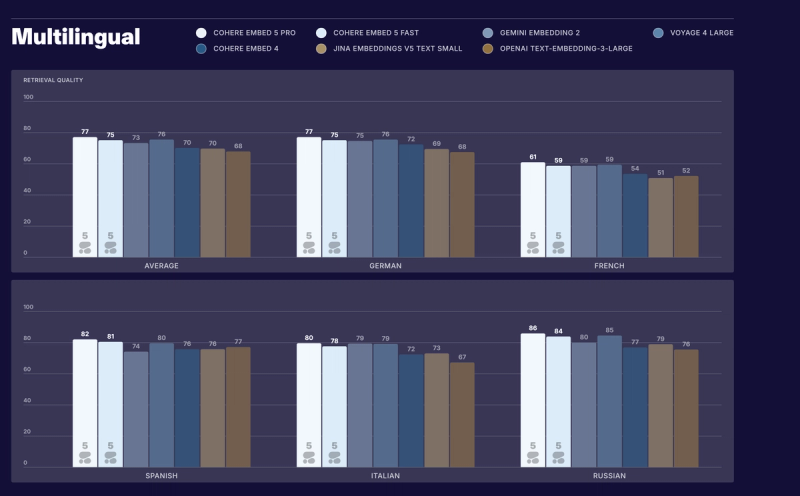
下表涵盖了十个 Embed 5 相较于 Embed 4 取得重要进展的其他语言。Pro 的提升幅度最大的语言是中东和南亚次大陆语言, notably 波斯语(+12.8)、泰卢固语(+12.3)和印地语(+11.5)。如需查看完整的多语言评估结果列表,请点击此处。
| 语言 | Cohere Embed 5 Pro | Cohere Embed 5 Fast | Gemini Embedding 2 | Voyage 4 Large | Zembed-1 (4B) | Cohere Embed 4 | Jina Embeddings v5 Text Small | OpenAI text-embedding-3-large |
|---|---|---|---|---|---|---|---|---|
| 日语 | 86.6 | 84.8 | 90 | 87.1 | 84.7 | 83.1 | 82.7 | 79.9 |
| 中文 | 82.4 | 80.3 | 80.7 | 82 | 84.6 | 78.9 | 78 | 72.9 |
| 韩语 | 85 | 83.2 | 87.3 | 85.6 | 81.8 | 78.9 | 79.2 | 69.7 |
| 阿拉伯语 | 82.8 | 79.3 | 86.5 | 85.9 | 79.5 | 72.2 | 70.9 | 67 |
| 波斯语 | 80.6 | 78 | 82.7 | 78.7 | 73.8 | 67.8 | 70.2 | 59.9 |
| 印地语 | 79.6 | 77.4 | 84.3 | 82.9 | 79.7 | 68.1 | 72.8 | 59.3 |
| 孟加拉语 | 83.1 | 80.7 | 89.1 | 85.1 | 80.2 | 72.9 | 79.1 | 61.1 |
| 泰卢固语 | 80.3 | 75.5 | 91.1 | 88.6 | 67.3 | 68 | 82 | 63.1 |
| 印尼语 | 85.2 | 82.7 | 87.8 | 84.5 | 83.9 | 78.6 | 79.1 | 81.2 |
| 泰语 | 82 | 74.6 | 87.7 | 84 | 78.7 | 74.5 | 77.8 | 66.9 |
了解 Embed 5 Fast
Embed 5 Fast 是一款轻量级模型,专为对延迟敏感且需处理高并发量的检索场景而构建。其成本仅为 Pro 版本的三分之一,同时保留了相同的 128K token 上下文窗口、多模态输入支持、多语言覆盖能力以及多种压缩输出格式。
这在查询路径上尤为重要,因为每次搜索都会产生嵌入延迟——而在智能体工作流中,每个任务可能发起数十次搜索,延迟会被进一步放大。Fast 更小的模型体积还降低了私有部署中的服务成本,并加速了大规模数据摄入和重新索引的任务。
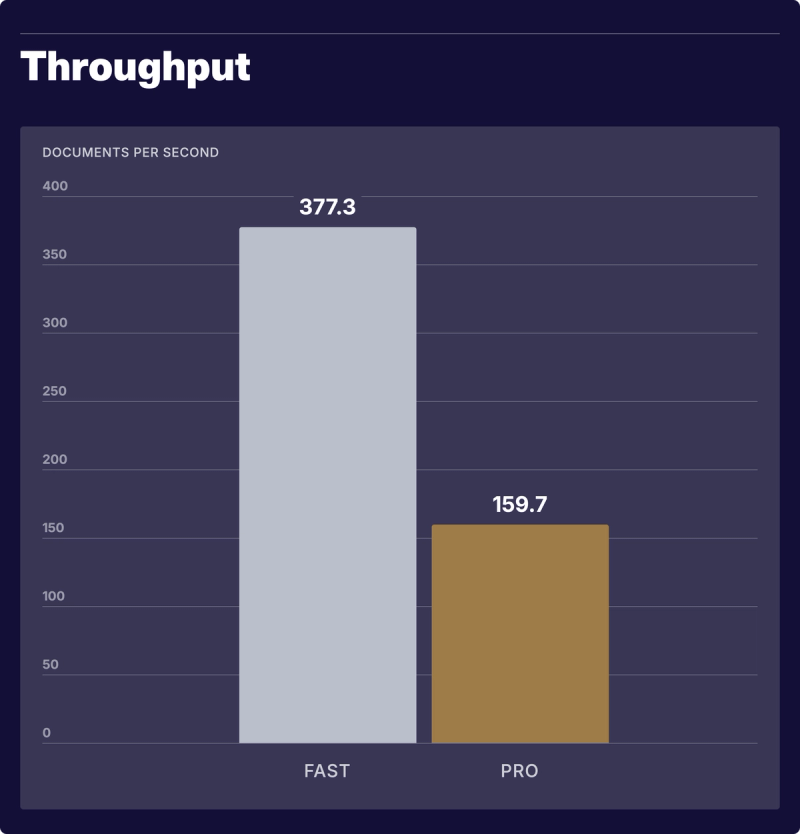
在文档吞吐量方面——这是衡量索引效率的一个更贴近实际的指标——Fast 始终表现出更高的效率,在不同上下文大小下,其平均吞吐量比 Pro 高出 2.4 倍。
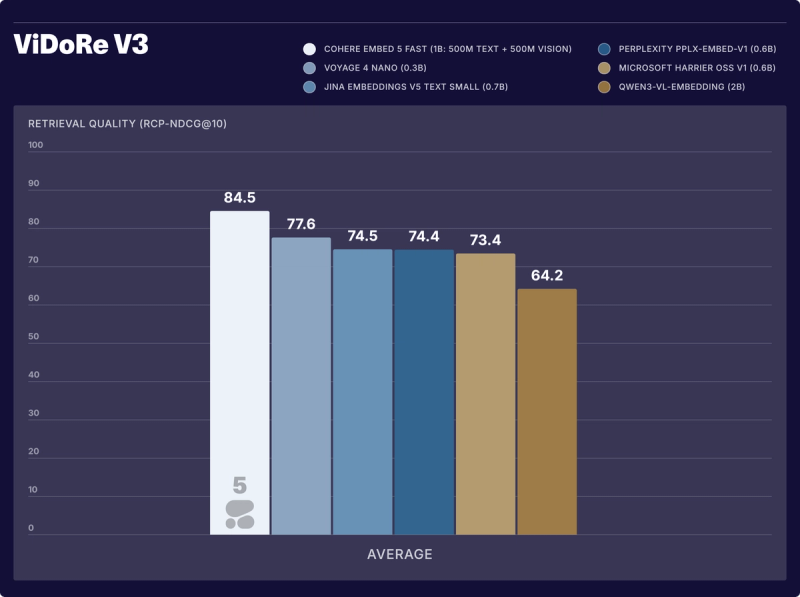
Fast 提升了紧凑型嵌入模型的性能标杆。在 ViDoRe V3 基准测试中,它领先 Voyage 4 Nano 七分以上,领先 Jina Embeddings v5 Text Small、Perplexity 以及微软的 Harrier 0.6B 十分以上。尽管模型规模约为 Qwen3-VL-Embedding-2B 的一半,但其性能仍高出约 20 分。如上所示,在 ViDoRe V3 和金融检索任务中,其平均分也超过了 Gemini Embedding 2 和 Voyage 4 Large。在处理解析后的 PDF 文档时,它优于 Gemini Embedding 2(83.4 对比 80.8),但略逊于 Voyage 4 Large(83.6)。
| Pro | Fast | |
|---|---|---|
| 适用场景… | 适用于离线索引和对质量要求极高的检索——尤其是在处理复杂文档、多模态内容或细微差别的查询时。 | 适用于实时请求路径,特别是交互式搜索、智能体循环以及其他高并发查询负载。 |
| 金融服务 | 对 10-K 表格、财报、表格和脚注进行批量索引,用于股票研究;或对密集金融记录进行合规性或风险搜索。 | 客户服务搜索、顾问辅助工具、交易支持工作流,以及发出重复检索调用的智能体。 |
| 零售与电商 | 跨大型多模态目录的产品发现,包括细微的属性匹配以及“图像+文本”检索。 | 站内搜索、购物助手、推荐系统以及为大量实时查询提供服务的对话式产品查找。 |
| 法律 | 数字化大型法律档案,包括合同历史、案件文件、监管材料和内部判例库。 | 内部法律知识搜索、条款查找、案件搜索,以及在法律助手或工作流中进行的重复检索。 |
两个模型,一个嵌入空间
Pro 和 Fast 共享同一个嵌入空间,因此来自任一模型的向量可以直接进行比较。我们在涵盖文本、图像、融合及解析文档检索的 40 个开发数据集上,测试了所有语料库/查询配对。
这种共享空间允许团队独立选择每个层级:文档可以使用 Pro 进行索引以获得最高质量,而查询则使用 Fast 以降低延迟和成本——无需重建索引。跨模型组合的表现与同模型基线非常接近(Fast 和 Pro 查询的平均损失分别为 1.6% 和 2.7%),没有任何数据集出现重大失败。
对于许多客户,我们推荐以下部署模式:使用 Pro 进行索引,使用 Fast 进行查询。这种模式在保持请求延迟和成本较低的同时,捕获了全 Pro 系统的大部分质量提升。
| 平均检索质量 | 语料库: Fast | 语料库: Pro |
|---|---|---|
| 查询: Fast | 96.6 | 98.4 |
| 查询: Pro | 97.3 | 100 |
向量存储
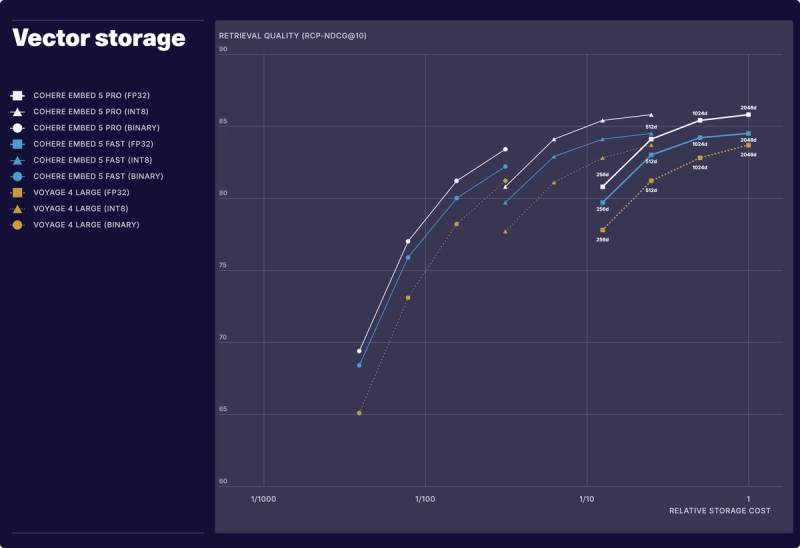
在企业规模下,向量索引的运营成本可能高于生成它的模型。Embed 5 支持 Matryoshka 表示学习和低精度输出,使团队能够缩小向量维度,并精细控制质量、存储和搜索成本之间的权衡。这些节省可能是巨大的——一个 2,048 维的 float32 向量需要 8 KB;一个 1,024 维的 int8 向量使用 1 KB;而一个 256 维的二进制向量仅需 32 字节——减少了 256 倍。在 1 亿个数据块的情况下,原始向量存储量从大约 819 GB 降至 3.2 GB。
重要的是,int8 在 Embed 5 Pro 和 Fast 中均保留了接近全精度的检索质量。对于大多数部署,我们推荐 1,024 维的 int8 向量作为理想的性能效率平衡点。二进制向量提供最小的存储 footprint,但会牺牲一些准确性,非常适合在更高精度的重排序之前进行快速初筛检索。
入门指南
通过 Cohere API、Model Vault、Microsoft Foundry(Pro, Fast)和 Amazon SageMaker 部署 Embed 5 Pro 和 Embed 5 Fast,或者直接在 North 中使用 Embed 5。对于在您自己的 VPC 或本地私有部署中,两个模型均可使用 vLLM 提供服务。批量嵌入可用于大规模数据摄入。
使用您已有的工具进行构建。Embed 5 可融入现有的检索栈,支持与包括 LangChain、Haystack、Weaviate、Qdrant、Pinecone、Elasticsearch、MongoDB、Redis、Milvus 和 OpenSearch 在内的框架和向量数据库集成。阅读文档。
首先创建一个 API 密钥,然后使用下面的代码片段快速发起您的第一次查询。
import os, cohere, numpy as np

co = cohere.ClientV2(api_key=os.environ["CO_API_KEY"])

documents = [
    "Net interest margin narrowed 12 bps to 2.61% as deposit costs rose.",
    "Torque the mounting bolts to 45 Nm in a star pattern before refitting the cover.",
    "Employees accrue 1.5 days of paid leave for each month of service.",
]

doc_embeddings = co.embed(
    model="embed-v5.0-pro",
    input_type="search_document",
    texts=documents,
    output_dimension=1024,
    embedding_types=["float"],
).embeddings.float_

query_embedding = co.embed(
    model="embed-v5.0-pro",
    input_type="search_query",
    texts=["What happened to net interest margin last quarter?"],
    output_dimension=1024,
    embedding_types=["float"],
).embeddings.float_[0]

docs = np.array(doc_embeddings)
query = np.array(query_embedding)

scores = docs @ query / (
    np.linalg.norm(docs, axis=1) * np.linalg.norm(query)
)

print(documents[int(np.argmax(scores))])
其他信息
认识 Embed 5 背后的团队。加入我们在 10 月 8 日的网络研讨会,听取我们的搜索和嵌入负责人关于 Embed 5、Parse 5 以及幕后准备工作的分享。
此外,我们的托管搜索和检索平台 Compass Cloud 现已进入私有测试阶段。申请访问权限以在自己的检索和智能体工作负载上试用。
主要贡献者
Samarth Bhargav, Fabian Schmidt, Clifton Poth, Arthur Maciejewicz, Florian Schneider, David Rau, Dennis Zhao, Timothy Ang, Nils Reimers, Carlos Lassance.
脚注
1 RCP-nDCG@10 需要在两阶段检索设置中评估嵌入模型,使用它们的相似度分数对固定候选集进行重排序。因此,分数反映的是重排序质量,而非第一阶段检索性能,后者我们将在其他地方针对 nDCG 和 Recall 进行全面评估。
2 用于使用 RCP-nDCG 评估 Vidore V3 的注释和代码在此处提供。
3 双方必须使用相同的输出维度。该兼容性同样适用于 Matryoshka 截断和 int8 量化,因此相同的模式也适用于压缩索引。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。