精选Google Research Blog短讯
Diffusion Controller 统一并简化 AI 图像生成
该算法与理论类内容探讨了 Diffusion Controller 方法,旨在通过统一架构来简化 AI 图像生成的流程。
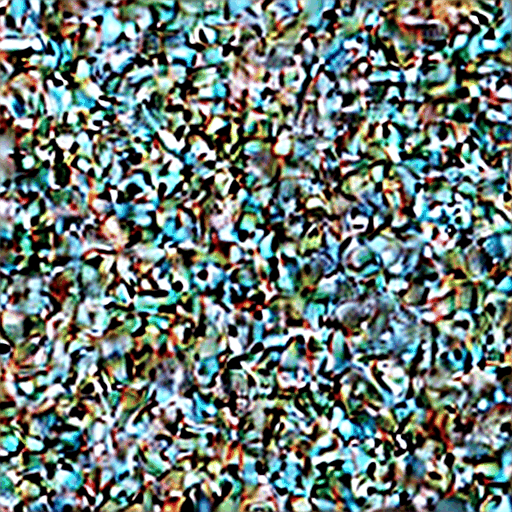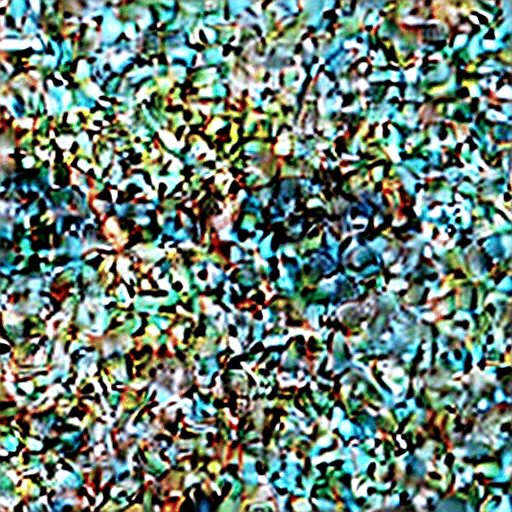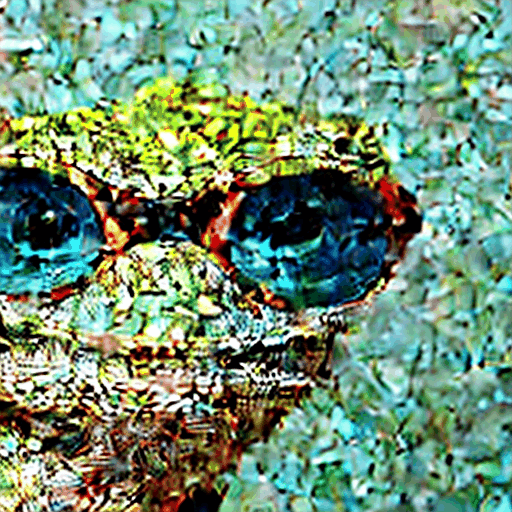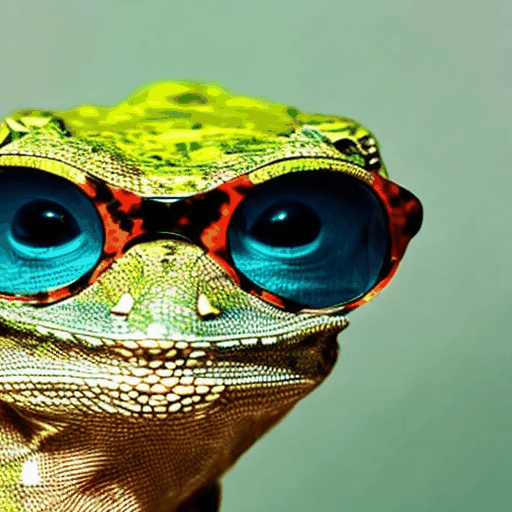
我们推出了 Diffusion Controller,这是一种轻量级的“转向阻尼器”网络,能够精确引导图像生成,从而实现显著更好的提示词对齐效果。它可以无缝附加到甚至访问受限的闭源模型上,在保持基线稳定性的同时提升图像质量。
快速链接
- 论文
- 分享 复制链接 ×
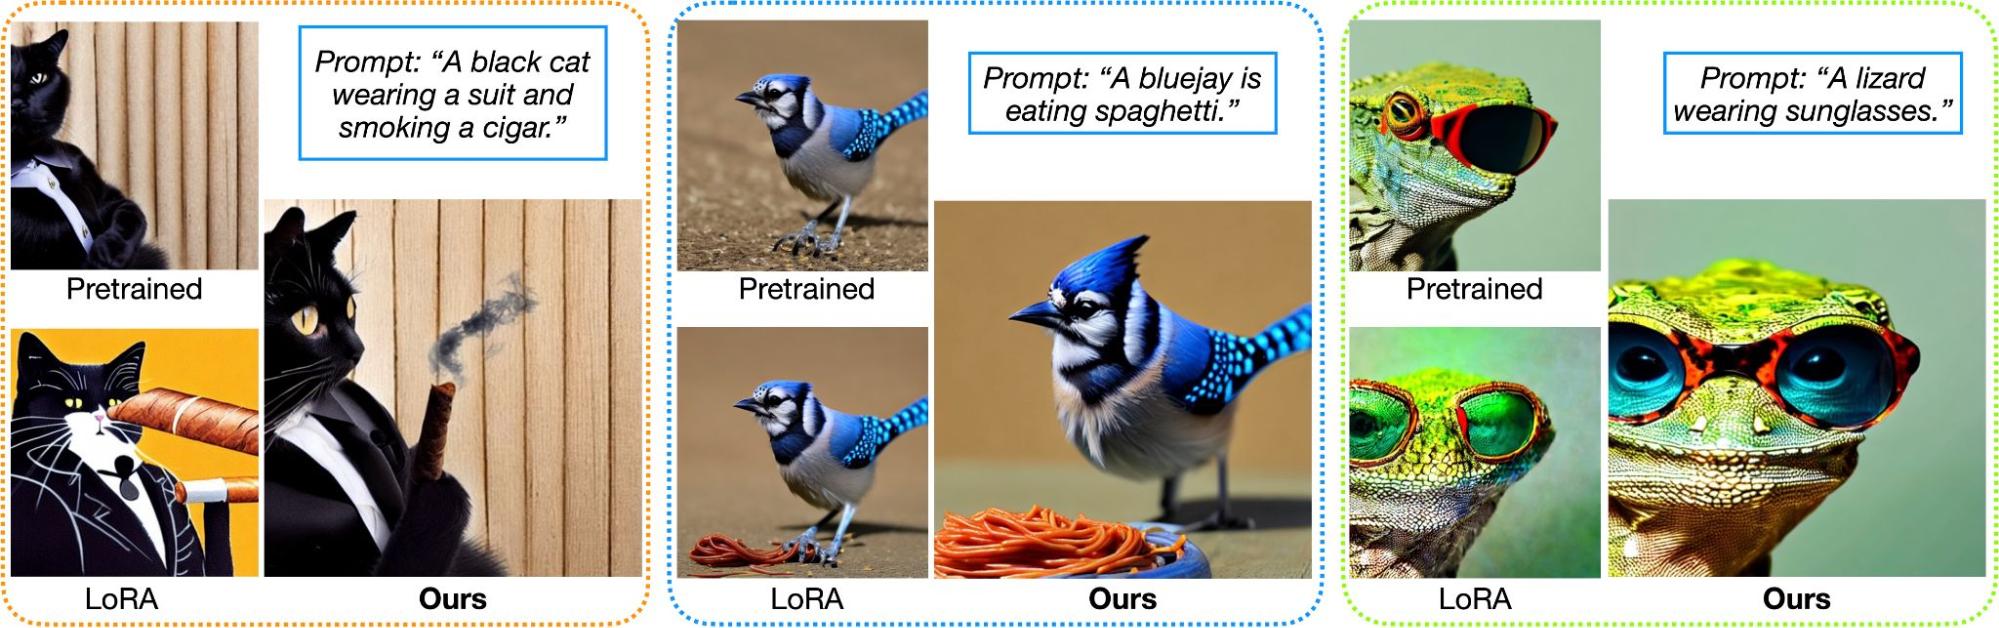
以 Nano Banana、Stable Diffusion 和 Flux 为代表的文本到图像 AI 模型的快速发展,从根本上改变了创意设计的流程,使得任何人都可以根据文本描述合成具有照片级真实感的高保真图像。然而,要引导这些庞大的模型以满足精确的用户意图、下游目标或严格的视觉约束,仍然是一项微妙且不可预测的平衡艺术。例如,假设你向模型提示“一只戴着太阳镜的蜥蜴”,模型可能会生成一只逼真的蜥蜴,但它并没有戴太阳镜。或者,强行要求模型加入太阳镜可能会导致蜥蜴的面部扭曲,从而破坏图像质量。
现有的指导或微调图像生成的方法彼此之间非常割裂。一方面,开发者使用时推理时的技术(例如无分类器扩散引导)来调整文本提示的影响,并实时引导图像生成过程。另一方面,他们依赖于使用参数高效适配器(如 LoRA)、奖励加权回归或策略梯度等进行重度微调,以改变模型的行为。
由于这些工具历史上被视为独立且不相关的修复方案,该领域缺乏一种统一的、原则性的数学语言来统一、分析和优化我们对生成模型的控制方式。这种碎片化的方法往往迫使工程师在平衡用户偏好对齐与图像质量时依赖猜测。
为了解决这一平衡难题,我们提出了 Diffusion Controller 框架。Diffusion Controller 不再将图像生成视为一系列孤立的刚性步骤,而是将整个去噪过程重构为一个平滑、连续的控制问题。我们的结果表明,Diffusion Controller 的轻量级附加网络在匹配人类偏好方面优于行业标准。此外,其完全解锁版本(即经过微调且具有“白盒”或不受限制权限以修改内部模型权重的模型)相对于基线模型取得了 90% 的胜率。
Diffusion Controller 框架
Diffusion Controller 框架将图像生成过程(AI 模型从随机噪声开始并逐渐将其细化为清晰图片的过程)视为一次平滑受控的旅程。想象一下基础预训练模型是一辆庞大而强大的摩托车;为了改变其驾驶方式而重建其核心引擎既低效又充满风险。相反,Diffusion Controller 充当附着在其上的轻量级转向阻尼器,而主模型(摩托车)则保持完全冻结且安全 untouched。
Diffusion Controller 的核心机制(转向阻尼器)并不猜测每一步该如何引导生成,而是在图像创建过程中动态调整生成轨迹。它平滑地重新校准模型的标准默认行为,赋予那些能最大化用户定义目标(例如实现某种艺术风格或上下文对齐)的方向更多的权重。
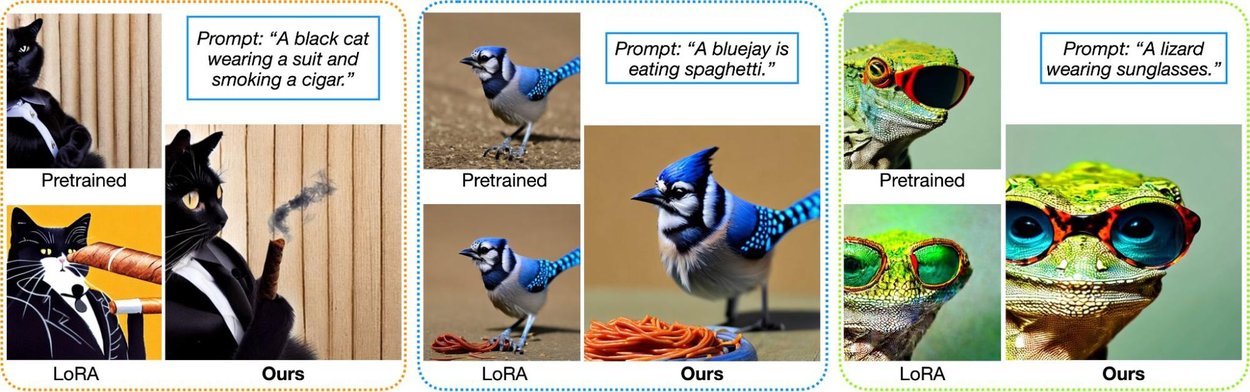
并列视觉矩阵,比较基础预训练模型、LoRA 和 Diffusion Controller 输出在不同复杂提示下的结果。
通过利用反馈对生成轨迹中的这些偏移进行数学优化,Diffusion Controller 框架取得了平衡,成功将模型的生成过程引导至新的用户偏好,同时充分保留了基础模型清晰的视觉图像质量和底层稳定性。回到上述蜥蜴的例子,这意味着转向阻尼器会引导模型确保包含太阳镜,但惩罚护栏会介入,防止系统为了达成这一目标而扭曲蜥蜴的自然鳞片和比例。
从理论到实践
为了将这个理论控制问题转化为实用工具,我们将抽象且可能难以处理的方程之间的差距缩小,提出了两种完全基于最终奖励分数的微调方法:
- 方法 1:策略梯度与 PPO(稳定优化器):这种方法通过计算出的增量调整迭代地引导模型。它内置了一个“裁剪规则”,起到限速器的作用,防止系统在模型行为上做出巨大、 erratic 的变化,从而确保训练保持平滑和稳定。
- 方法 2:奖励加权损失(捷径):这作为一种直接的优化路径发挥作用。它对产生高质量结果的生成过程给予重奖,提供了数学保证,即模型将可靠地学习生成用户意图的确切类型的图像。
“转向阻尼器”网络
Diffusion Controller 框架的运行方式类似于一个转向阻尼器,解决了一个巨大的现实商业问题。通常,要改变模型的行为,你需要“白盒”访问权限来深入其核心引擎并更改其内部设置。然而,世界上最好的图像生成模型往往是企业机密(被称为黑盒或灰盒)。
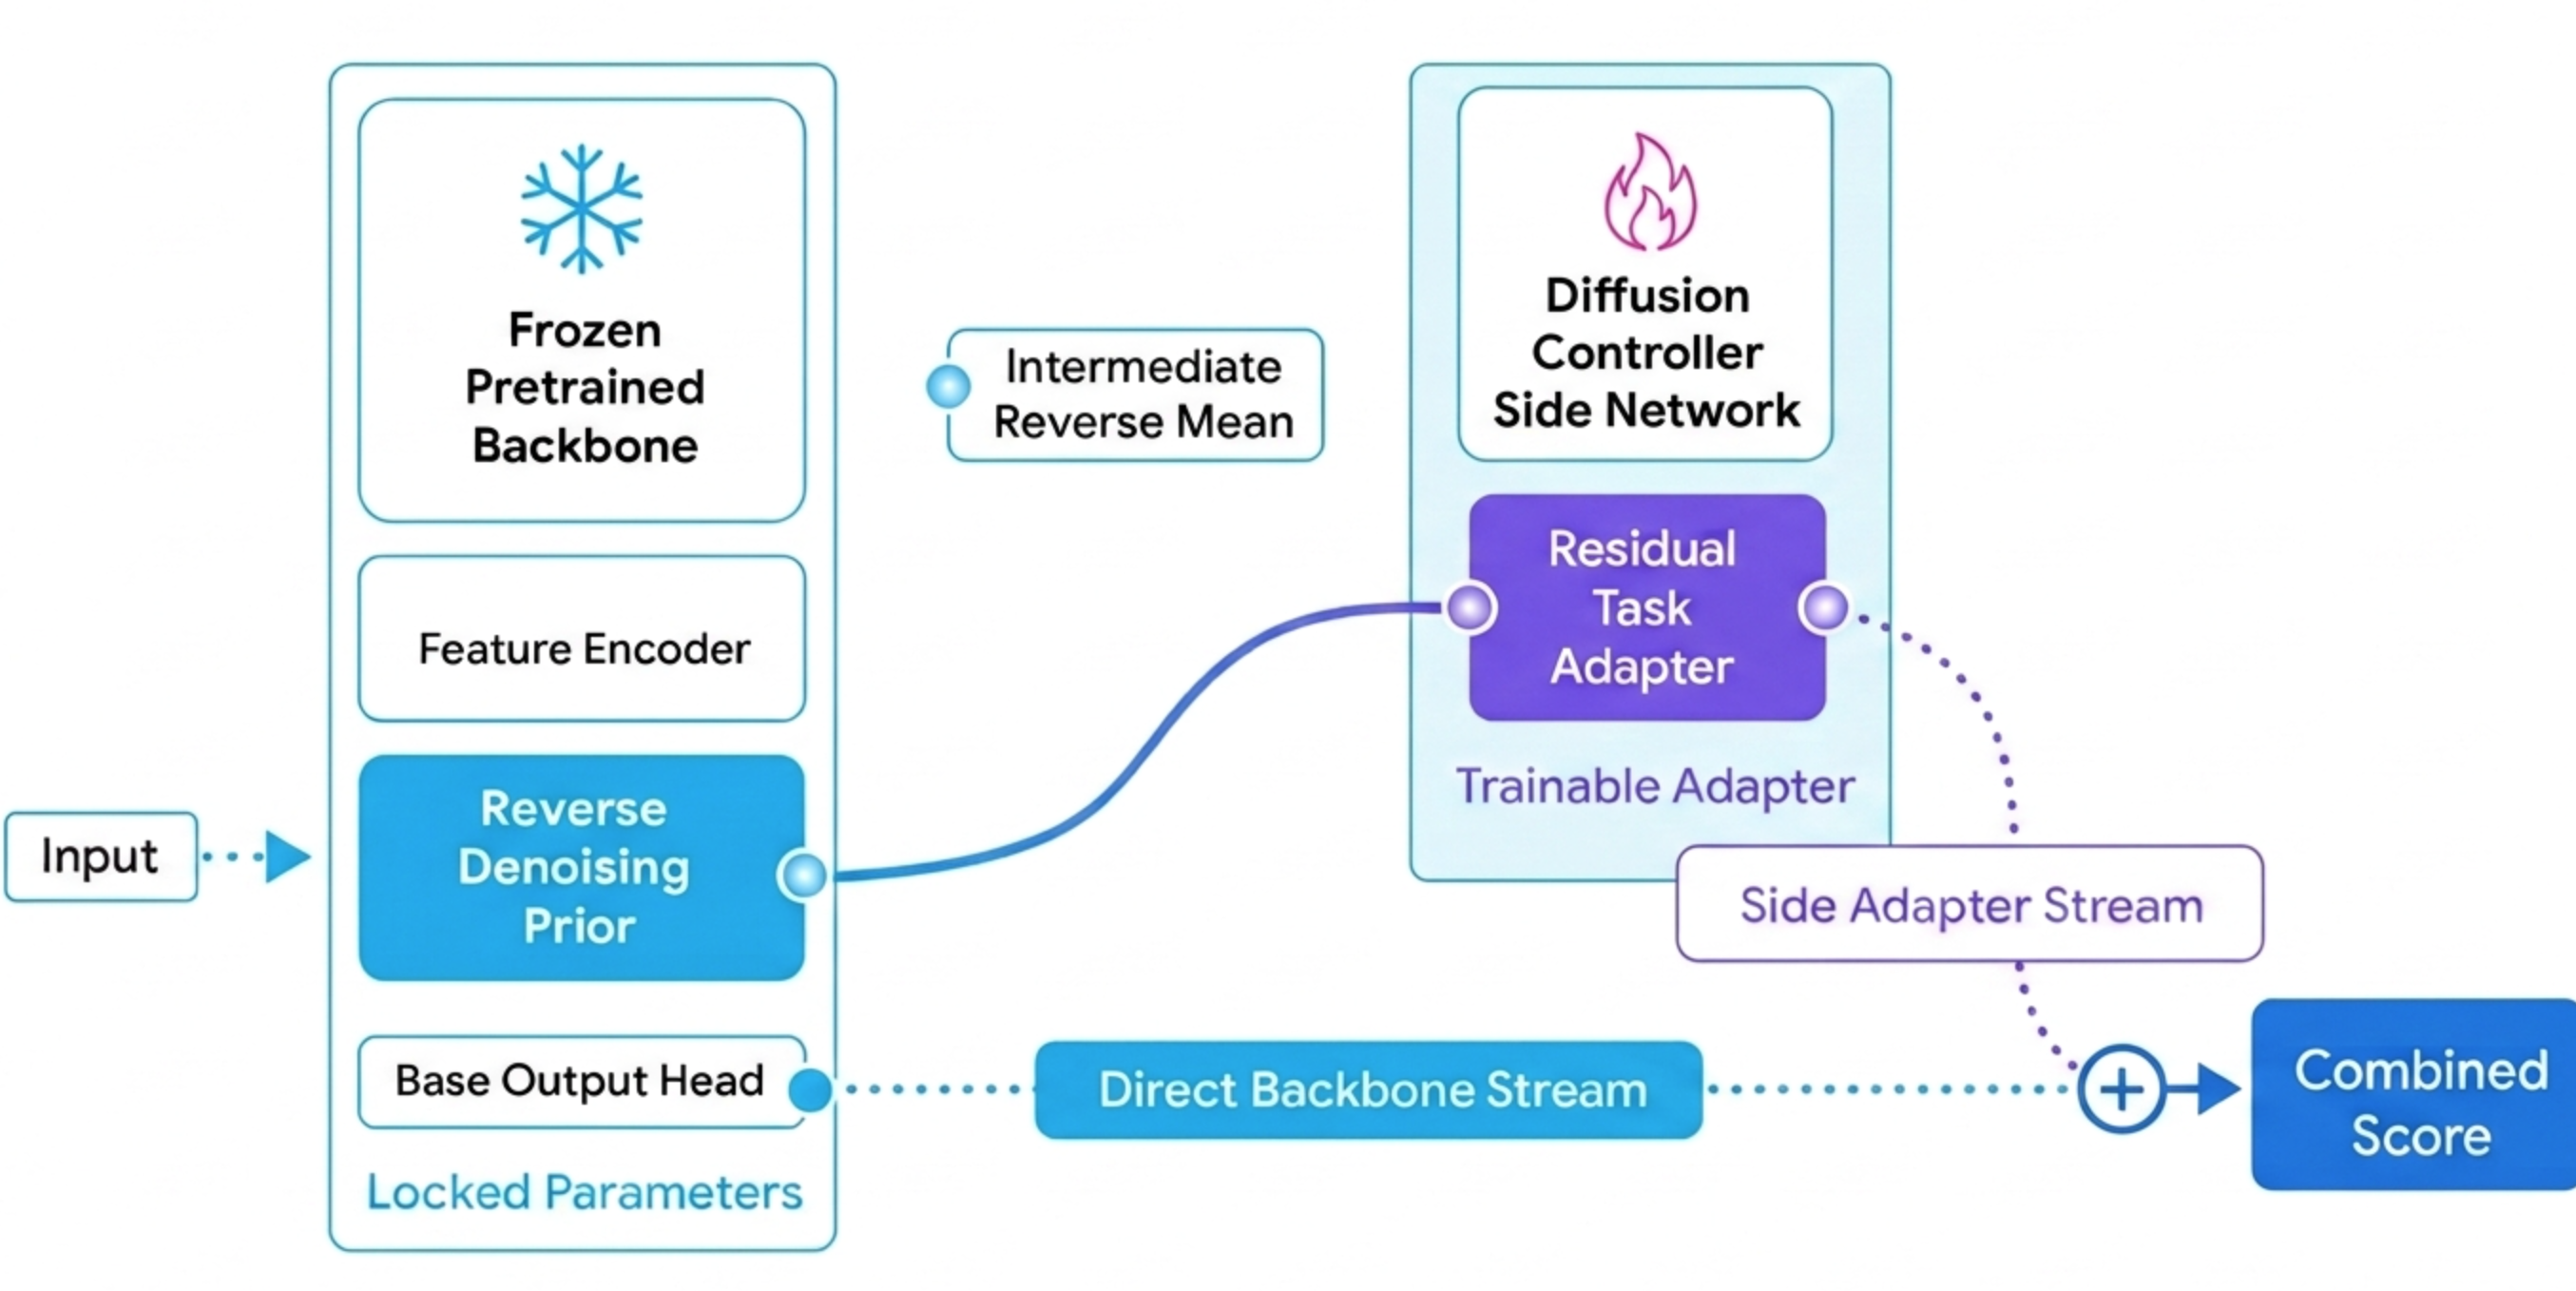
转向阻尼器网络依赖于完美的图像转向指令,这是基础模型知识与少量校正的结合。它在图像去噪过程中观察图像,并注入精确的微观转向校正。这使得工程师能够在不触碰底层代码的情况下,完美控制和定制即使被严格锁定、闭源的模型。
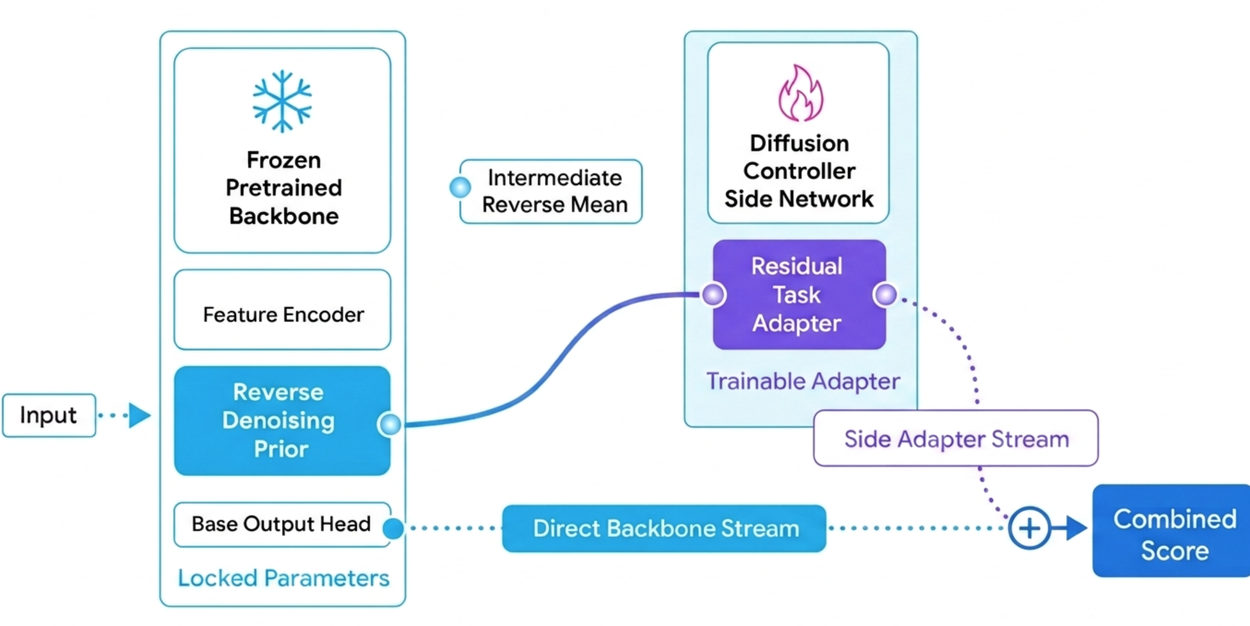
高级示意图展示了冻结的主干如何将中间反向均值传递给 Diffusion Controller 侧网络以计算组合分数。
实验与结果
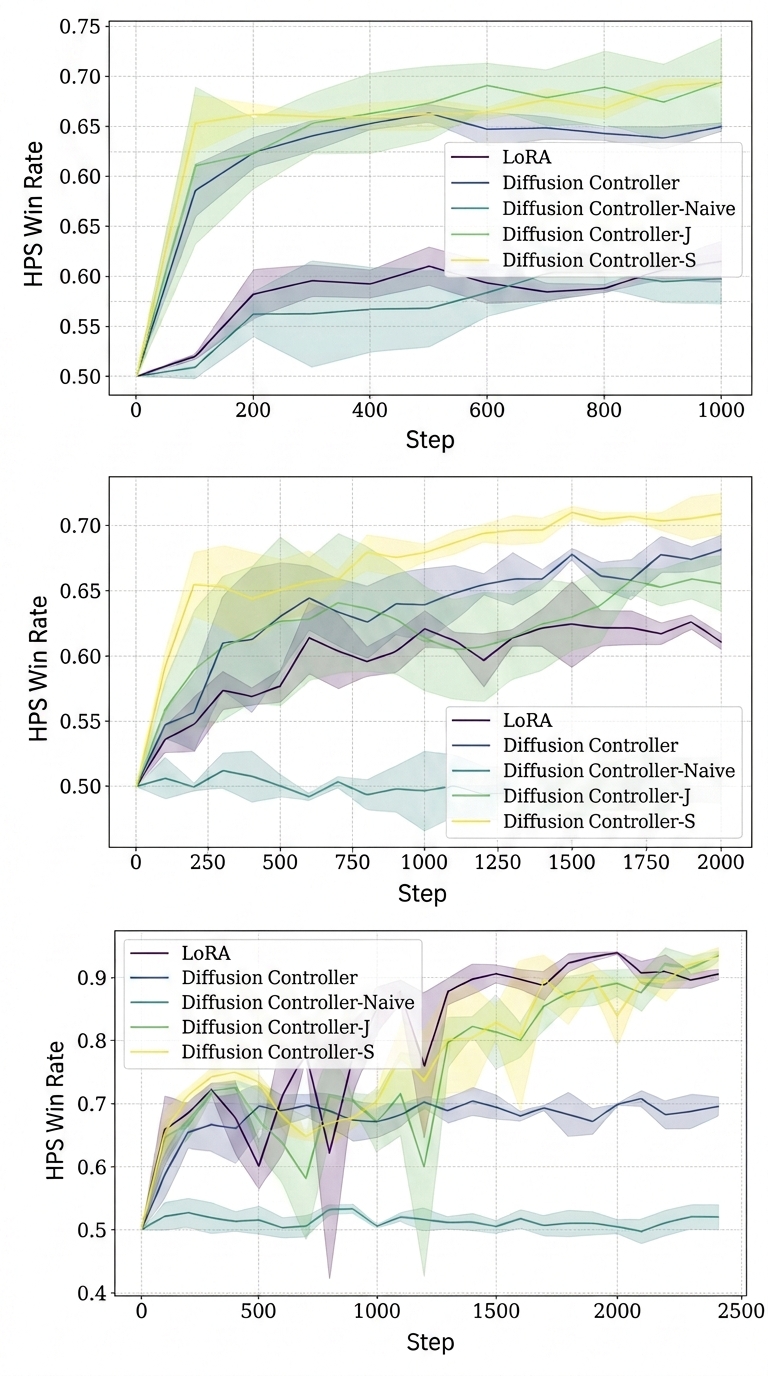
我们使用 Stable Diffusion v1.4 主干网在三种微调模式下评估了 Diffusion Controller 框架的能力:监督微调(SFT)、奖励加权损失(RWL)和 PPO。性能使用标准化的人类偏好评分(HPS-v2)进行衡量,以确定生成的图像与用户提示及审美选择的一致性程度。
- Diffusion Controller:我们的转向阻尼器网络,用于灰盒访问,以中间反向均值为输入,并采用提出的侧适配器流。
- Diffusion Controller-Naive:一种简单的转向阻尼器网络设计,既没有中间反向均值也没有侧适配器流。
- Diffusion Controller-J:我们的白盒解决方案,通过联合训练转向阻尼器网络和基础模型实现。
- Diffusion Controller-S:另一种白盒解决方案,通过分别训练转向阻尼器网络和基础模型实现。
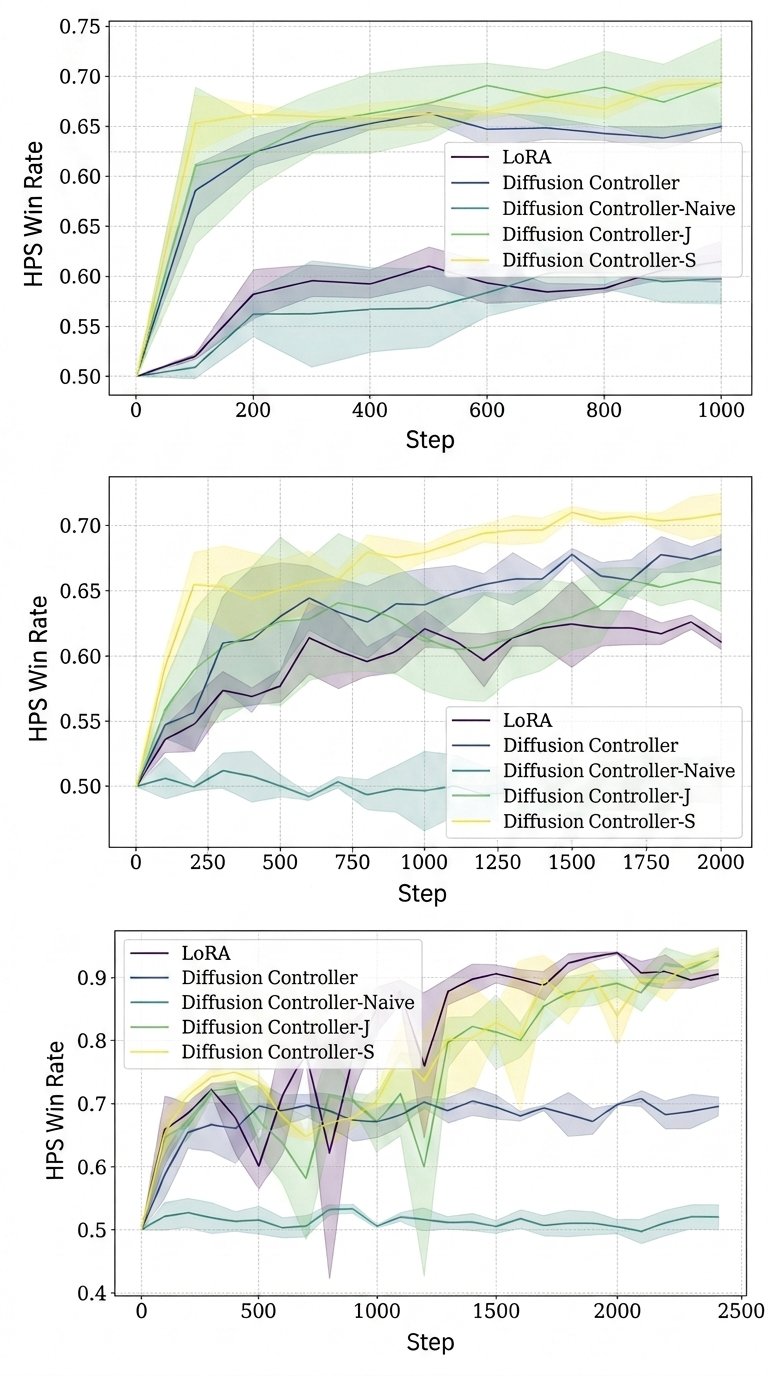
在所有设置下(每个设置在其报告的检查点),相对于预训练模型在 HPS-v2 测试提示集上的 HPS-v2 胜率:SFT(顶部)、RWL(中部)和 PPO(底部)。
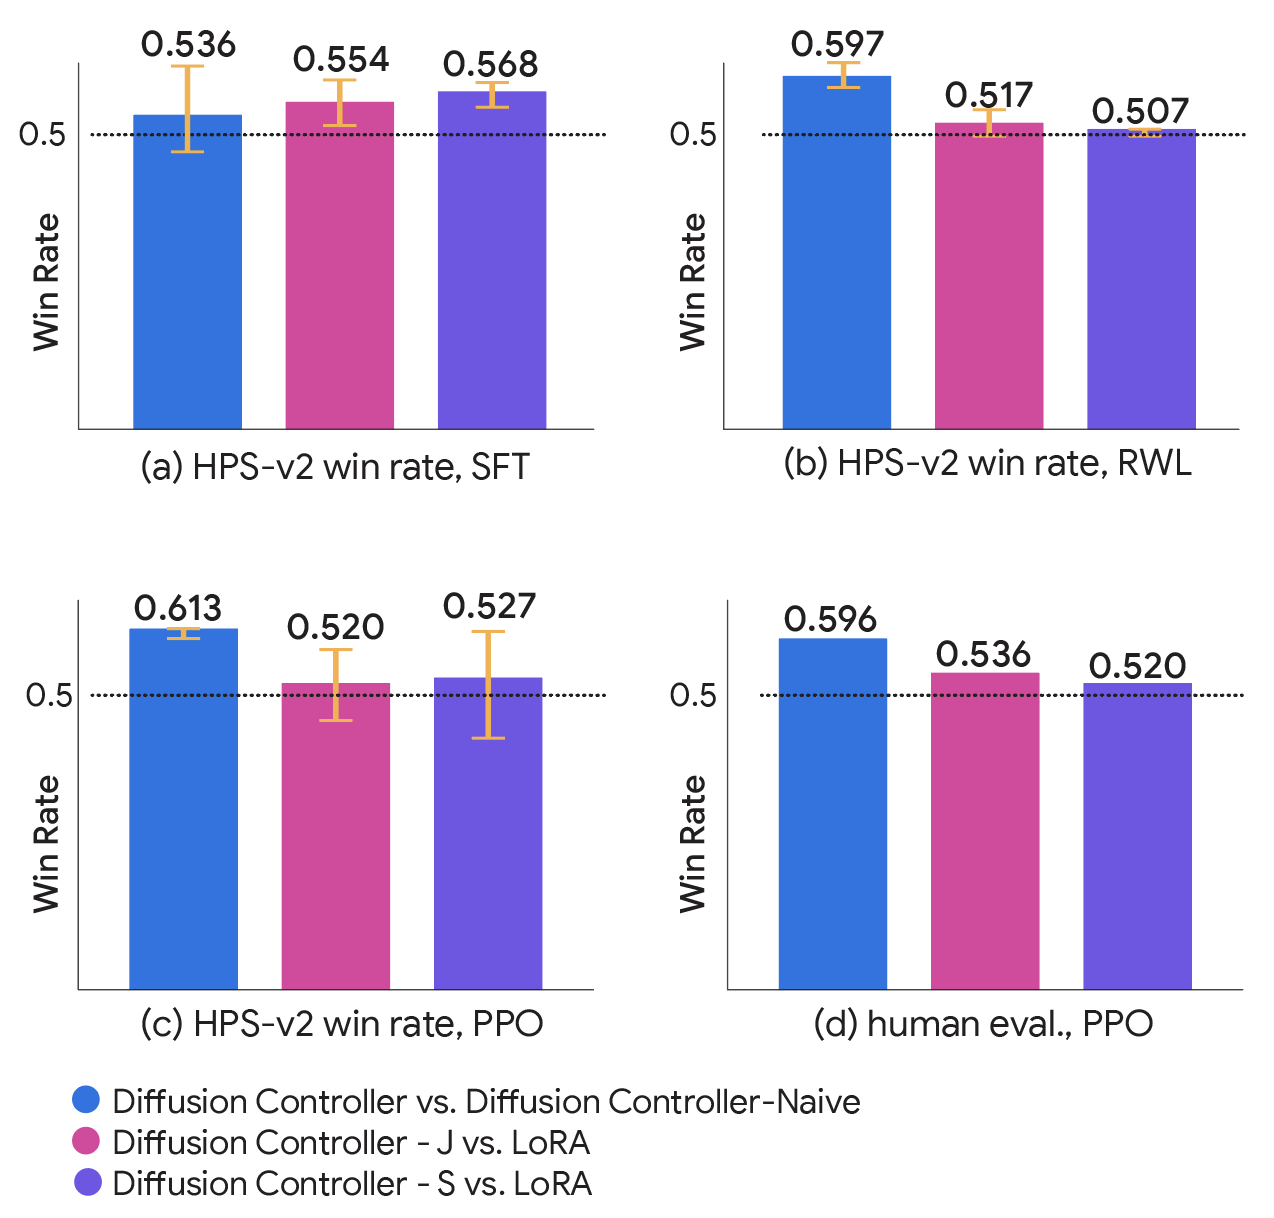
结果表明,Diffusion Controller 在完全可访问的“白盒”环境和高度受限的“灰盒”环境中都表现出色,始终优于其相应的基线模型,并实现了更好的质量效率权衡。
在 SFT 和 RWL 赛道中,灰盒 Diffusion Controller 转向阻尼网络在 HPPS-v2 胜率上优于 LoRA——这是一种最先进的参数高效白盒方法。考虑到 Diffusion Controller 在操控的内部模型层数远少于 LoRA 的情况下实现了这一成就,这是一个重要的里程碑。此外,在综合人类评估小组中,Diffusion Controller 在复杂的多属性测试提示下,取得了最佳的主观质量和提示匹配结果。
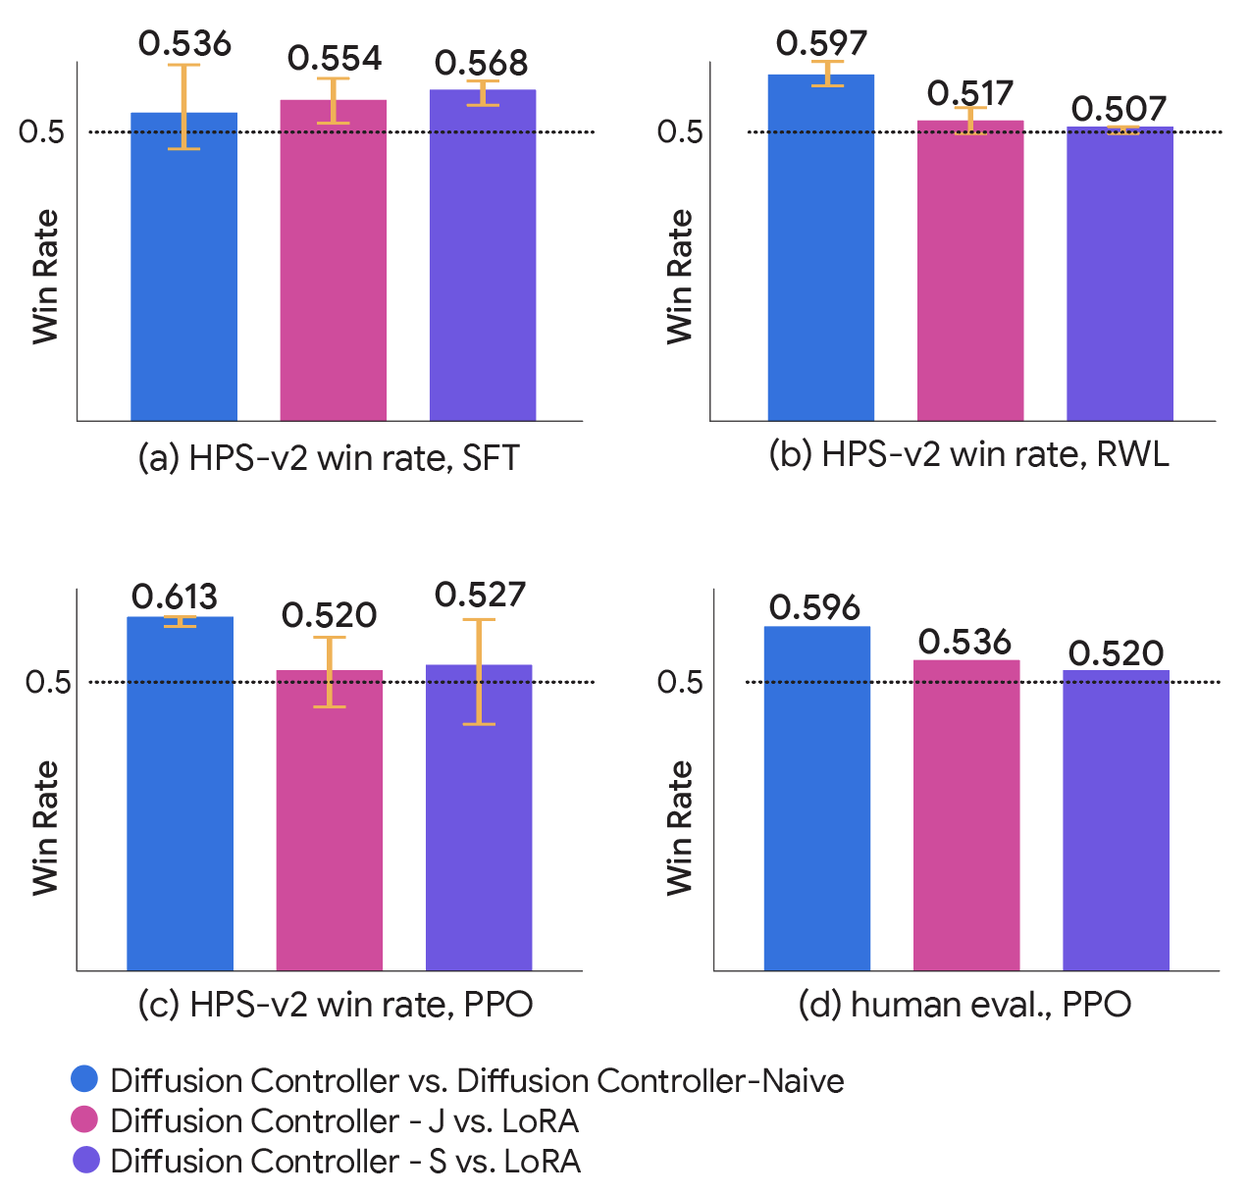
训练结束时的胜率与基线对比。每个子图报告了三种配对比较:(灰盒)Diffusion Controller 与 Diffusion Controller-Naive;(白盒)Diffusion Controller-J 与 LoRA;(白盒)Diffusion Controller-S 与 LoRA。(a-c):SFT/RWL/PPO 的 HPSv2 胜率,橙色误差条显示标准差;(d):PPO 的人类评估胜率。
该框架的一个核心特性是其运行时的灵活性。通过调整单个推理时引导强度参数,用户可以动态调节控制约束的强度。这允许在不破坏基线图像稳定性或导致旧式引导方法典型视觉畸变的情况下,实时平滑、精细地调整提示对齐程度。
结论
通过将数学控制与图像生成模型相结合,Diffusion Controller 弥合了纯数学与现代创意工具之间的差距。它不再依赖于一堆猜测和快速修复来微调模型,而是提供了一个单一且数学上严谨的系统来引导图像生成。最重要的是,它提供了一个实用、轻量的“转向阻尼器”蓝图,即使在访问受限的闭源模型上也能完美运行。
展望未来,这一统一框架为研究开辟了令人兴奋的新路径。由于控制层与模型的核心引擎完全分离,未来的开发者可以利用 Diffusion Controller 实现远超文本提示匹配的更多功能。接下来的直接步骤包括利用该框架构建高级个性化工具、开发强大的安全机制以帮助减轻有害内容的生成,以及将转向阻尼器网络适配用于控制复杂的下一代视频模型。
致谢
我们要感谢来自 Google Research、Google DeepMind 以及学术界的共同作者和合作者对本工作的贡献。
- 标签:
- 算法与理论
- 机器智能
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。