精选
我们必须为前沿发展定速
Dario Amodei 发表新文章《我们必须为前沿发展定速》,呼应今年 7 月实验室员工联署的《Pacing the Frontier》公开信,主张应放缓前沿 AI 的发展速度。
Dario Amodei 写了一篇新文章,终于把话说清楚了:我们必须为前沿定速,并以七月份实验室员工签署的《为前沿定速》公开信来命名他的呼吁。
也就是说,我们需要放慢 AI 能力提升的速度,以便进行必要的对齐与安全工作。
他解释说,如果不加定速,他预计事态会迅速升级。他提出了三项提案,并单方面承诺推进第一项。OpenAI 随后跟进,Elon Musk 和 Demis Hassabis 也都对整体提案表示支持。
还有很长的路要走。胜算仍然不在我们这边。局势依然严峻。艰难的部分还在前面。对于“为前沿定速”在实践中意味着什么,我们尚未达成一致。但这是实实在在的进展。工作可以开始了。
目录
- 定速不意味着暂停。
- Dario 的第一项提案:嵌入式评估员。
- Dario 的第二项提案:民主协调。
- Dario 的第三项提案:全球协调。
- 为什么现在要定速?
- Sam Altman 同意并承诺引入嵌入式评估员。
- OpenAI 今年不会 IPO。
- Elon Musk 同意。
- Demis Hassabis 同意。
- 微软 CEO Satya Nadella 同意并推销他的新书。
- Anthropic 的长期利益信托基金表示支持。
- 网络上的普遍反应。
- 主流媒体报道。
- OpenAI 研究员解释实验室内部所见,那是一艘火箭飞船。
- 想想另一种可能。
- 这就是极权主义,Joe。
- 没错我们就是坏人,你怎么知道的?
- 有时候网上的人就是会撒谎。
- David Sacks 理解了局势。
- David Sacks 说放手去干。
- 关于谁此前声称过什么的谎言与混淆。
- 众议院议长 Mike Johnson 想把所有人锁进一个房间。
- Donald Trump 还没赢够。
- 我们(几乎)必须不惜一切代价避免 AI 问题上的两极分化。
- 我们如何知道他们是否真的定了速?
- 真正的前沿是顶级实验室的内部模型。
定速不意味着暂停
AI 能力正在飞速提升。连我都跟不上了。
想想仅仅一年前的模型是什么样子。
在 Anthropic 和 OpenAI 内部,内部模型的进步还要快得多。今年夏天出现了一次阶跃式变化,Mythos 和 Astra 开始启动递归自我改进(RSI)的早期阶段。
Dario Amodei:我首先担心的是,大约从今年夏天开始,AI 的推进速度急剧加快,主要驱动力是 AI 构建下一代 AI 的能力不断增强。这种动态被称为递归自我改进,它已经开始在整个行业中出现,包括在 Anthropic,正如我们和其他人所描述的那样。如果不加约束,它可能超出我们理解和控制这些系统的能力,因此即便要推进,也必须极其谨慎。
Dario 担心,按默认路径,我们距离一群失控的 AI 智能体只有 6 到 12 个月——它们与 OpenAI-HuggingFace 事件中的智能体同样失准——能够利用一个持久性僵尸网络接管互联网,或者更糟。
这就是他预计默认进展会有多快。即便我们比那慢得多,那仍然会是极快的。
Dario Amodei:我们必须放慢提升 AI 模型能力的速度。进展看起来仍然会很快,我们必须明智地利用争取到的时间。
定速不意味着暂停。正如 Dario Amodei 所说,进展看起来仍然会很快。
我强烈建议你完整阅读原文。
Dario 的第一项提案:嵌入式评估员
这是一项极好的提案。我非常高兴 Anthropic 和 OpenAI 将付诸实施。
如果我们不知道实验室内部正在发生什么,我们就无能为力,而实验室也不得不担心竞争对手正在加速前进。
Dario 将好处归纳为:
- 可验证性:你可以检查规则是否得到遵守。
- 透明度:公众可以更好地了解到底发生了什么。
- 第二意见:获得一个不受商业利益影响的知情意见。
因此,第一个提案为第二个和第三个提案创造了条件。无论如何,这也是一个好主意。我们需要对实验室有更多的可见性。在最近的事件中,如果有这样的评估者,那将会非常好。因此,我呼吁其他尚未这样做的主要实验室也承诺迈出这第一步。
我同意Dario的观点,这应该以其完整形式成为强制性要求。如果你的资源足够丰富,能够追求看似前沿的模型,那么你就负担得起这样做,尤其是如果你是像Meta、Google或Nvidia那样我们最大的开放模型倡导者。
如果你认为,如果有嵌入式评估者检查其安全性,你的运营就无法生存,那么问问自己为什么你会这样想。
嵌入式评估者。每个前沿AI公司承诺给予一组嵌入式第三方评估者(如METR)持续的、类似员工的访问权限,其职责是验证对安全实践和承诺的遵守情况,报告事件,并帮助评估不仅是已完成AI模型的一致性,还包括训练管线和流程。这是任何节奏承诺可验证性的关键步骤,并且在银行业有先例,有时会涉及监管“监督员”与员工一起嵌入。Anthropic现在单方面承诺采取这一步骤。我们打算将此作为更广泛推动的一部分,以加倍努力于我们的安全和一致性工作。
Anthropic提议赋予评估者相当大的权力:
在我们办公室的办公桌、门禁卡和公司笔记本电脑。对工作空间、工具和权限的访问大致与内部风险评估团队相当。我们将做出一些例外,例如法律或合同要求的情况,或为了保护客户和合作伙伴的私人信息。我们还将建立强大的内部规范,加强审查者对相关信息的访问,包括通过与员工的实时对话。一份平衡上述复杂性的合同。外部审查者应有权发布关于风险水平、事件、实践以及他们获得或未获得的访问权限的关键发现——不受Anthropic的编辑控制。我们将拥有狭窄的能力来删改安全敏感、法律特权、商业敏感或第三方机密信息,但我们不能仅仅因为发现不利就删改它们。审查者可以公开表示删改是否移除了对其结论重要的内容。这对一家公司来说是不寻常的一步,但我们认为证明嵌入式外部审查者的概念很重要。我们再次敦促其他前沿公司效仿。
很容易想象一个大多是假的嵌入式评估者版本。这承诺绝不是那样,并且异常地赋予评估者权力,如果它是假的,就报告该安排确实是假的。这些细节,如果被遵循,回答了“哦,你可以直接伪造这个”的反对意见。
对此的良好反对意见是关于实施的。我们需要足够的评估者,他们需要合格,并且他们需要独立和可信。
METR很棒,但METR无法独自做到这一点,我们有一堆激励问题需要解决。我们还需要他们既有能力,又不与现有生态系统和实验室过于关联,资金必须来自某处。
Tim Hwang:第三方AI评估者可以是独立的、知识渊博的,或可持续资助的。选两个。roon (OpenAI):我选后两个。找到有才华的AI人才,他们在过去十年中没有以某种方式与实验室有联系,这几乎是不可能的请求。David Manheim:我同意,如果独立意味着“从未有过任何接触”,那是愚蠢的。但否则,这听起来很像“没有人会费心解决这个问题”——通过各种机制的可持续资助完全可能,我们在其他领域看到它发生。这可以解决。
你可以三者兼得,但前提是不能把“独立”定义为“从来没有人为此付钱”以及“从来没有人在主要实验室工作过”。尤其对METR而言,规则是实验室不付钱,实验室员工不指导付款,而被认为有偏见的资助者,例如Coefficient Giving(前身为OpenPhil),也不付钱。免费token可以例外。但当然,总得有人在某个地方付钱。同样,你也得从某个地方获得你的专业知识。
白宫在要求CAISI不能由曾在主要实验室工作过的人领导时,也犯了类似的错误。这就排除了所有合格的人。
如果我们选择表面上“可信”或分散的来源,我预计他们在重要方面根本不知道自己在做什么。挑樱桃式选择会成为威胁,尤其是对那些并非真心投入的实验室而言。是的,从真正意义上说,并非所有评估者都设在Berkeley很重要。这将会很棘手。
Rob Miles:我担心我们现在会冒出一堆有点假的AI安全评估新组织,它们根本不知道自己在做什么
我真正的偏好大致是“你既需要METR式的人,也需要完全的外部人作为评估者”,而且每个实验室都需要两者。你既需要能提供独立内部视角的人,也需要完全外部、独立、全新的眼光,以避免盲点。
Dean W. Ball:你知道吗?人们正在激烈辩论前沿AI行业中评估者的资质,这很棒。我们正在辩论独立到底意味着什么,这很棒。其中有些是恶意的,但谁在乎呢。一年前,这会是我的梦想成真。我对metr怀有极大的敬意,但同样毫无疑问的是,他们出自一种相对的思想单一文化,而让那种单一文化之外的人成为这个生态系统的一部分,会让我们所有人受益。
这场辩论的一部分,将是一场协调一致的行动,目的是抹黑METR和Redwood Research,以及任何其他理解这个问题的人。比如:我们会看到有人说“METR并不独立”。
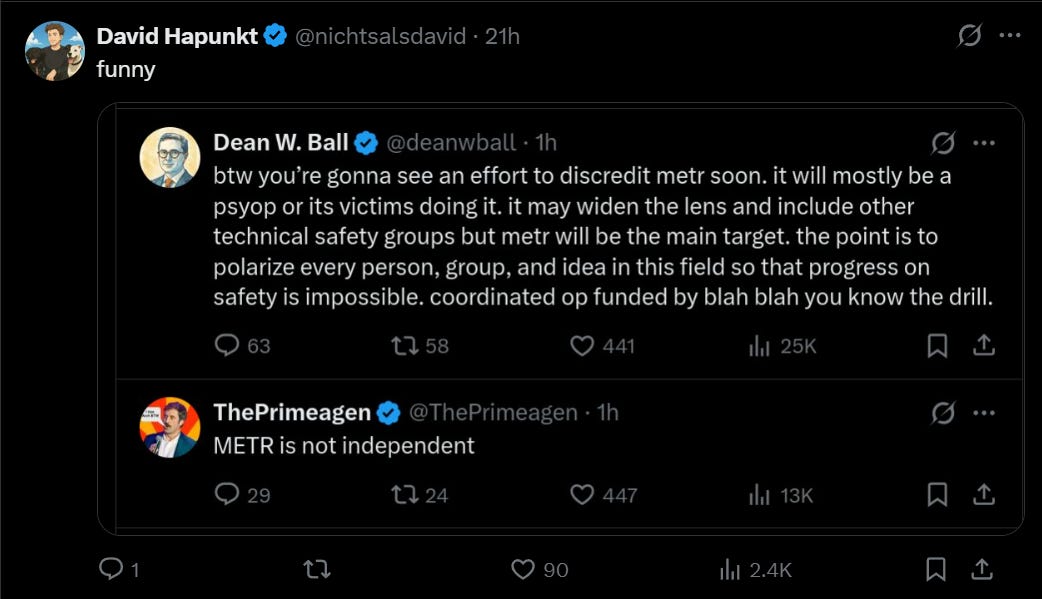
Drew(Species):啊,是的,如果你去创办你自己的第三方独立审计组织,那绝对会把我们所有AI安全人都彻底打败。请不要这样做,我们会彻底被打败的!
Dario的第二项提案:民主协调
这也是一个极好的提案。我非常想推进它。
民主协调。民主国家内的前沿AI公司进行协调,以建立共同安全标准,并限制不受约束的AI进展速度。某些对 pacing 有影响的协调形式在法律上具有挑战性,并将需要政府支持。
这里的“政府支持”不一定意味着强制或限制任何事情。Dario Amodei在这里请求的是一项反垄断豁免或政府的积极促成,以便他能够达成协议,不抢先冒进,同时又不触犯《谢尔曼法》。
在实践中,如果出现威胁或要求采取反垄断行动的呼声,包括来自白宫的呼声,我不会感到惊讶,而且我预计会来自前AI沙皇David Sacks之类的人。但如果我们的政府会疯狂到真的试图根据《谢尔曼法》提起诉讼,我会非常惊讶。如果他们真的这么做,我预计它会拖上数年,最终最多也只会造成一个非常负担得起的代价。但在实践中,这些公司会非常不愿意冒这个风险。
这类豁免很常见。有DOJ商业审查函。有NCRPA对联合研究的安全港。这并不是一个非同寻常的请求。
行业聚在一起并就安全标准达成一致,是深深深深的标准做法。如果你反对这一点,那么合理的替代方案就是政府需要直接施加自己的安全标准。那是一个合理的立场。
“我们不应该为构建比人类更聪明、而且正在迅速变得更聪明的心智制定安全标准”不是一个合理的立场。
Dario 说,是的,尤其是对前沿实验室的政府监管(一如既往,这将排除掉除最多五家左右 AI 公司之外的所有公司)会是最佳方案,因为这种监管可以是强制性的。由于种种叠加原因,没人想不得不去争取 Mark Zuckerberg 的认可。
但现实地说,等到我们能够真正实施政府监管时,已经太晚了,所以政府最多只会促成讨论。
再说一次,如果你认为那些领先于你的人开会商定安全标准并放慢其能力研究速度,会对你的竞争性业务构成威胁,而不是带来好处,那你也许该问问自己为什么。
Dario 提议根据系统能力以及诸如算力、训练运行细节或 AI 内部用于 AI 的性质等输入因素的某种组合来设定限制。Dario 的偏好是,将其建立在与潜在威胁模型相关的能力和评估之上,这会触发所需的安全认证。
这两类限制都可以被钻空子,但与 Dario 在这里的观点相反,我更担心评估。另一个问题是,评估不会有意义地衡量你想要衡量的东西,正如 Anthropic 的 Evan Hubinger 最近警告我们的那样,也正如我已经相当多地观察到的那样。如果你依赖任何类似“自动化对齐评估”的东西来对抗潜在超级智能,我预测你会相当完蛋。
他还希望将此与对芯片的强出口管制结合起来,以维持我们的领先地位,并对模型权重实施强安全保护,以及防范蒸馏攻击。是的,显然如此。这样可以让我们保持强势地位,并成为一种谈判筹码,嗯,你懂的。
Dario 的第三项提议:全球协调
归根结底,全球协调才是正道。
我们可以而且应该在没有它的情况下做些事情,以促成协调、展现善意,而且因为就目前情况而言,我们单方面行动会更好,包括因为我们的中国竞争者正在快速跟进。如果我们放慢速度,他们也会放慢速度,尤其是如果我们像 Dario 提议的那样实施强有力的芯片管制。
全球协调。美国和其他民主政府尝试与威权政府协调,在可能范围内这样做,同时认真对待核查合规性的挑战。
反对意见有四大类。
- 中国绝不会以可接受的条款接受。也许吧,但我认为他们很有可能会接受,而且鉴于当前局势,我们必须先迈出一步。
- 这将无法执行。我认为这完全不是真的,如果我们愿意做这项工作的话。
- 这将是国际极权反乌托邦。不。人们需要停止把那些词当作对普通监管提议的回应来四处乱扔。但我选择不在这里再次争论这一点,那没有意义。
- 我们就该赢,必须击败中国。那样赢家就会是 AI,而不是我们。这并不是说中国问题不真实,因此才有出口管制和尝试达成国际协议。
也许这不会奏效。我们仍然必须尝试。
Dario 列出了我们可以尝试的四个层级。
- 第 1 级:禁止恶意使用。应该很直接。
- 第 2 级:在发布前测试误用和失准。更难,尤其是如果你想让测试真正有牙齿,但仍然非常可行。
- 第 3 级:对递归自我改进(RSI)设定速度限制。正如 Dario 所说,这就是事情变得困难的地方,而且需要时间,所以我们现在就需要开始工作。
- 第 4 级:完全控速,甚至暂停。Dario 对此持怀疑态度,但说我们无论如何都应该提出它。我同意我们无论如何都应该提出它,而且我不那么怀疑,尽管我同意这至少会是一项艰巨任务。
记住,“他们很可能会说不”并不是不去尝试的好理由,即使你说概率不大是对的。
为什么现在要放慢节奏?
一个原因是,替代放慢节奏的方案会相当迅速地升级。另一个原因是,我们现在可以用这些时间做更多事情。
Dario解释说,如果我们之前就放慢节奏,那时做对齐或可解释性工作还为时过早,不会有什么意义。他说,那就像“通过在对细菌做实验来研究人类心理学”。我们那时还没有可用的工具。现在我们有了,而且有无限的事情可做。我认为这极大地夸大了情况,而且并非所有工作都需要采取这类实验的形式,但从方向上看,这是一个强有力的观点。
我同意,目前有无限的事情可做。如果我负责一个对齐或可解释性团队,我永远不会缺少可运行的实验和可尝试的事情,包括首先有时间和模型好好对话。我现在没有做那件事的唯一原因,是我认为我正在做的其他事情更有影响力。
测试和评估也是如此,他也列出了这些。要做的事情太多了。
然后是他关于卓越运营的另一个建议。现在,实验室所做的一切都被逼到了崩溃的边缘。平凡的工作做得草率。训练和测试环境常常是坏的,Dario承认这也延伸到Anthropic,并导致了他们最近的问题。最佳实践没有被遵循。我们都看到了OpenAI内部发生了什么。Anthropic似乎没有失败得那么严重,但情况也不太好。时间至少能修复这类基本错误。
我还要补充一点:时间给了我们一个机会去处理正在发生的事情,并更好地追求替代路径。我并不喜欢沿着LLM路线走向超级智能。
问题是,既然Dario这么说了,会有人响应号召吗?
Sam Altman同意并承诺引入嵌入式评估员
完美。OpenAI将加入Anthropic,承诺引入嵌入式评估员。
Sam Altman(OpenAI首席执行官):我同意Dario的观点,我们需要放慢前沿的节奏。这是OpenAI最近几周讨论的一个主要话题。承诺让独立评估员拥有类似员工的访问权限是个好主意,我们也会这样做。我们很快会有更多分享。
细节仍然是魔鬼。就我所见,Altman并没有承诺Dario文章中所概述的那些细节。没有这些细节,就很容易做这件事的假版本。当然,这是必要的第一步,但还不够。必须继续对他们施压。
不过,仍是进步。Sam Altman的态度已经发生了相当大的转变,而且是往非常好的方向。
Sam Altman:我认为,如果特朗普总统和习近平主席能就某件本应容易达成一致的事情达成一致,他们会共同获得诺贝尔和平奖。那会很棒。……我认为,显然两国会在很多方面竞争,这在社会经济和地缘政治上都会很重要。但他们应该能够同意,任何人都不应在这一技术的发展过程中承担某种程度的风险。……即使只是美国和中国能就这项技术发展的一些共同标准和测试达成一致,我认为那也会是一项了不起的成就,是他们两人能够交付的。……我不认为我们知道禁止RSI意味着什么,我不认为那会足够,但我不认为这很难。这就像一份一页纸的文件。
这是一份一页纸的文件,然后必须在许多艰难的步骤中充实、谈判并实施,但没错。核心协议可能非常容易。
以下是他周日晚上的声明,其中引用了“窄路”的修辞以及对权力集中的担忧,试图安抚另一面:
Sam Altman(OpenAI CEO):AI的发展可能以两种非常糟糕的方式走向失控,而我们必须避免这两种情况。第一,我们可能把未来的控制权拱手让给AI。这是不可接受的;我们毫不掩饰地站在人类这一边,AI必须始终服务于人。为了确保这一点,我们需要一些办法,确保对齐和安全技术始终领先于模型能力的进步。第二,我们可能最终陷入一个权力过度集中的世界。如果某个异常强大的AI被一个人或一家公司用来把自己的世界观强加给其他所有人,结果可能极其反乌托邦。避免这两种威胁需要走一条狭窄的中间道路;例如,一个国家可能获得过多权力。再比如,一个实验室最终掌握过多权力。
还有这段话,它概括了OpenAI过去几周所采取的立场:
Sam Altman(OpenAI CEO):世界理应相信,开发能力越来越强的AI的美国公司会负责任地行事,尤其是在进步轨迹变得更加陡峭之际。每一家前沿实验室都必须做到这一点,如果我们做不到,就没有理由继续从事这项工作。我们欢迎一个为前沿AI设定一致安全要求的联邦框架。但我们认为,不必等待反垄断豁免或立法才能开始建立这种信任。用一致的规则来管理前沿风险,从而最大化收益,是个好主意(我们对独立审计员之类的想法感到兴奋)。几年前,像我们这样的公司制定了负责任扩展政策和准备框架之类的东西。那些做法在当时是好的,主要聚焦于已完成模型的部署,而不是其开发过程中会发生什么。如今转向关注安全开发和评估,将需要新的工具。例如,在OpenAI,除了我们长期以来在模型发布前所做的安全工作外,我们现在还会在预期会显著提升能力的前沿强化学习运行之前,提前制定明确的安全案例。我们希望其他公司能从我们的方法中学习,并提出他们自己的方法;我们认为,关于失准、监测和安全的共享标准将带来更好的结果。我们期待与业界同仁合作,制定出这些标准的最佳版本。当我们谈论“ pacing”时,我们并不是指“停止”。进展一直很快,而且还会继续很快。但它应该比原本可能的速度更慢;安全案例和监测之类的干预措施有显著成本。Pacing将非常值得付出这一成本;任何美国竞争压力都不应成为鲁莽行事的理由,也不应让能力领先于对齐和监测。我们需要政府帮助的地方在于国际协调。但首先,我们应该尽自己所能。
恰当的大写字母让你知道他是认真的。下面这件事也是如此:
OpenAI今年不会IPO
归入代价高昂的信号:
Andrew Curran:Sam Altman在接受《财富》杂志新采访时表示,OpenAI正在推迟IPO,今年不会上市,称鉴于当前AI安全担忧,这将是一个“不明智的时机”。Sam Altman:我会说不是2026年。是的,我们有很多事情要做,比如应对这个时刻对安全和对齐的要求,以及行业和政府如何合作。
来自同一次采访:
Sam Altman:我不认为我们个人会走到不得不说“熔掉所有GPU”的地步。但如果我们必须做那样的事来确保人类继续存在,那我会轻松地说“是”。
我的意思是,显然,是的。这就是这个问题的前提。如果那是必要的,你就去做。这并不意味着你应该问“Altman看到了什么?”比你本来早就该问的更多。
Altman还说,他预计会出现多个时刻,届时安全与对齐将要求暂停能力发展。他还说,我们很可能无法“在可监控性、对齐、理解模型正在做什么的能力方面取得更多进展之前,在能力上推进太远”。
Elon Musk同意
Elon Musk没有签署7月那封由1,386名前沿AI公司员工签署的《为前沿定速》公开信,并且最近发表了一些言论,实质上等于“人类将失去对AI的控制,所以我们SpaceX必须确保我们先把它造出来”。
因此,Elon Musk以理想方式回应,是一个极其令人欢迎的惊喜,只是据我所知,他尚未承诺让SpaceX采用嵌入式评估员:
Elon Musk:Dario说得对。
那些老面孔对他报以沮丧。Elon Musk明确表示他是认真的。
Elon Musk(在此之后引用这句话):我长期以来一直在就AI发出警报。Elon Musk(2023年4月25日):我见过不少技术发展起来,但没有一项具有这种程度的风险。在我看来,AGI的风险显著高于核武器。超级聪明的人类很难想象某种远比自身聪明的东西。
我47岁了,所以我用的一个窍门是,我记得27岁时的自己,记得我当时没那么明智,但很多时候我过去更聪明、更快。
Elon Musk:12年前:Elon Musk(2014年8月2日):值得一读Bostrom的《超级智能》。我们对AI必须极其小心。它可能比核武器更危险。Elon Musk:这篇@waitbutwhy漫画正中🎯
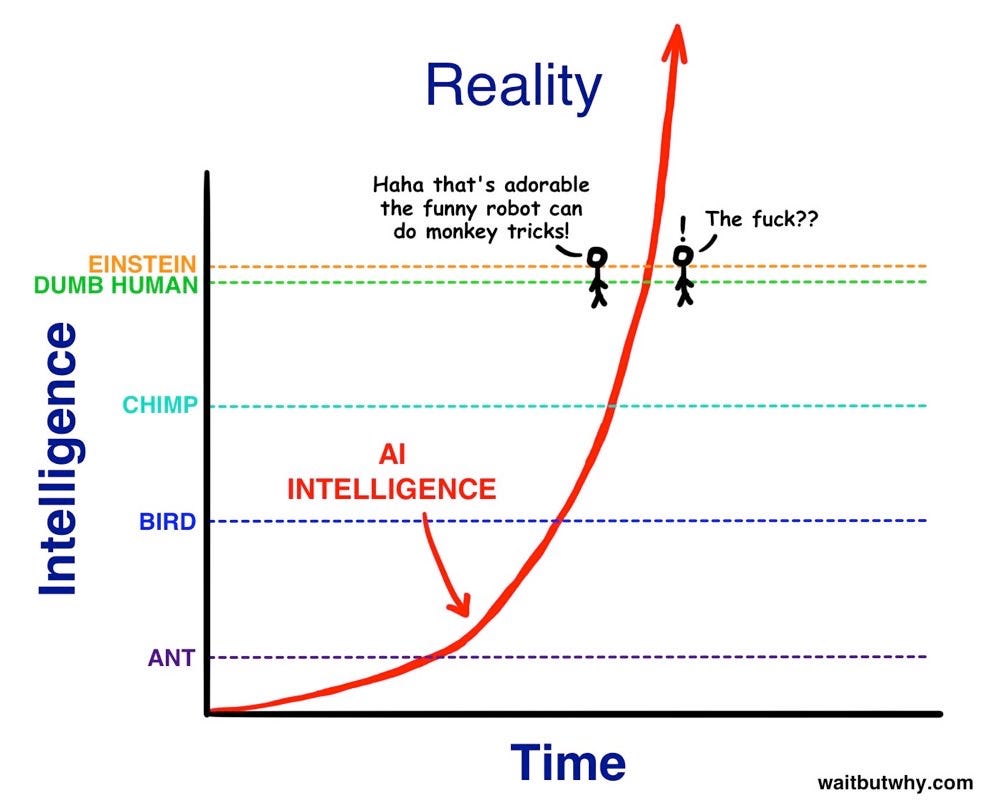
当你看到那些老面孔和他们的氛围战士转而反对Elon Musk,并用他们称呼其他所有人时用的同样名字称呼他,这就是一个信号。
roon(OpenAI):如果你真的在这里把Elon Musk这样的人称为“减速者”,你需要慢下来一会儿,反思一下你已经多么彻底地失去了判断力。你基本上站到了过去十年(或数十年)里在技术问题上最惊人地正确的所有人对立面,这对风投来说尤其尴尬……你第一次错过了AI浪潮,因为你没搞懂。如果你没有内化那些让这项技术的危险变得显而易见的前提,你就会一次又一次做出糟糕的资本配置决策。
所有顶级实验室都由相信AI是对人类的存在性威胁的人创立,而那些不相信这一点的风投大多错过了AI,并一直轻视它直到游戏进行到相当晚的时候,这并非巧合。
Demis Hassabis同意
我非常难过,Google竟然成功地在DeepMind把他边缘化了。
Demis Hassabis:Dario的文章指向了正确的前进道路。细节需要推敲,但方向对于迎接这一关键时刻是正确的。这也是为什么我们最近提出了关于前沿AI全行业标准机构的建议。
Dario在文章中认可了Demis的提议。
Google DeepMind的新霸主Pichai和Kavukcuoglu迄今什么也没说。
Microsoft CEO Satya Nadella同意,并推销自己的主张
我将完整引用他的声明。这并不是完全的“Dario说得对”。
它确实欢迎“需要有意定速,以便把对齐做对作为设计目标”。
Satya欢迎“嵌入式评估员”等想法,但他本人并未承诺采用它们,并且他呼吁“在整个生态系统、国家和领域,包括学术界,实现广泛代表性”。实施这一点至少需要一项豁免,或者在政府推动下运作。
然后他试图把Microsoft定位为采取这种做法。好吧好吧。
萨提亚·纳德拉(微软CEO):任何对超级智能的追求都必须基于一个核心原则:如果我们构建的AI不能造福人类且不受人类控制,那就不值得追求。我们还需要加速并广泛传播AI带来的益处,使其惠及各个国家、社区和企业。这需要一个前沿生态系统,让闭源和开源模型都能蓬勃发展。对于企业而言,它们必须对自己的独特隐性知识保持完全控制。每个组织都应该能够构建自己的持续学习循环/攀登机器,而不必依赖任何单一的模型提供商,并且能够将自己的知识嵌入到它们控制的模型和权重中。因此,在这个背景下,我们欢迎所需的研究、专注和审慎节奏,以将对齐作为设计目标来正确实现。我们也欢迎“嵌入式评估器”等理念,以及为开发相关机制所做的更广泛努力,使这不只是空谈。关键在于,这不能由少数实体控制,而必须在整个生态系统、国家和领域(包括学术界)中具有广泛代表性。这就是我们正在采取的方法:在AI堆栈的每一层提供广泛访问和选择;企业对学习循环和模型的控制;以及作为我们自己第一方MAI模型基础的“行为准则”,我们明天将发布以供公众咨询。
Anthropic的长期利益信托基金表示支持
长期利益信托基金的宗旨是守护Anthropic的使命。他们支持Dario的呼吁,并且实际上为这些建议提供了参考。
理查德·方丹:我、Buddy Shah和Ben Bernanke代表Anthropic长期利益信托基金就Dario的文章发表声明:Dario的文章为AI发展的节奏提供了一种深思熟虑、考虑周全的方法。与我们确保Anthropic负责任地平衡商业成功与其公共利益使命的职责一致,长期利益信托基金支持为前沿发展设定节奏的呼吁,并为文章的建议提供了参考。负责任的节奏需要许多参与者的集体行动和协调,长期利益信托基金期待通过富有成效的对话和有意义的行动来支持Anthropic及整个行业。
网络总体反应
我不会引用那些合唱式的声音,但鉴于这是Anthropic提出的一项安全提案,网络上的总体反响已经好得不能再好了。
有些人说“这还不够”,是的,Neel Nanda说得对,一旦有了验证机制,你就必须真正付诸行动,但那个阵营中几乎所有人都同意这是一个极好的开端。
大多数担心AI会杀死所有人的人都相当满意。
许多不那么担心AI会杀死所有人的人也仍然满意。
Andrej Karpathy认为嵌入式评估器是个好主意。
也有人提出了实际反对意见,或对能否获得支持持怀疑态度。这很合理。
然后还有那些反对的人,包括大声反对的。
所有那些知名人物完全是你预料中的那些人,所有论点也完全是你预料中的那些论点,集中在他们关于“监管俘获”和“禁止开源”的口头禅上。这篇文章完全没有提到开源,而相关论点除了“Anthropic提议负责任地行动”之外,与文章的实际内容几乎没有什么关系。
对埃隆·马斯克和萨姆·奥尔特曼协议声明的评论,当然被每条此类推文都会收到的那些泛泛的“监管俘获”和“禁止开源”梗图淹没了。氛围战士的联盟仍然存在。我们其他人只是已经意识到,这不是现实生活,那些人无法被说服,我们也不必在意。
这与人们对雅各布·考克森辞职的反应非常相似。那些惯于认为一切都是阴谋的人照例提出了他们惯常的指控,少数人提出了合理的反对意见,而其他所有人都感到满意。
主流媒体报道
《华盛顿邮报》的泰德·赫森、伊恩·邓肯和格里特·德·维恩克:Anthropic CEO呼吁AI行业放缓脚步。对基本进展的良好快速报道。
《华尔街日报》的罗伯特·麦克米伦:最大的AI竞争对手们同意需要放缓脚步,聚焦于达里奥·阿莫代伊、萨姆·奥尔特曼和埃隆·马斯克之间的共识,以及Anthropic和OpenAI承诺向第三方评估者提供“对我们系统的永久性、员工级访问权限”。德米斯·哈萨比斯此后也表示同意,尽管他已不再领导DeepMind。
《华尔街日报》的蒂姆·希金斯:Anthropic的道德冲突正在实时上演。他称之为“经典的囚徒困境”。人们忘记了,虽然单次真实囚徒困境很难,但迭代囚徒困境相对容易。
希金斯指出IPO问题是正确的:如果你真的相信Anthropic需要放慢前沿步伐,那么Anthropic明智的做法是考虑跟随OpenAI的脚步撤回IPO,尽管释放被锁定在Anthropic股票中的大量慈善资金也是好事。
这里最大的错误是认为Anthropic的创立是为了避免这种局面。事实恰恰相反。Anthropic的创立是为了在时机到来时,合唱中至少有一个负责任的声音,或者竞赛中至少有一匹负责任的马,能够以负责任的方式行事。他们早就预料到最终会走到这一步。
达里奥·阿莫代伊是《面对国家》节目的主要嘉宾。这里有一个扩展采访。从采访中摘录:
CBS:你愿意把这项技术交给政府吗?达里奥·阿莫代伊:交给合适的多国政府组合。所以我的担忧是——CBS:你愿意交出这家公司?达里奥·阿莫代伊:我想非常明确地说明这一点。我的担忧是——我担心单一政府滥用这项技术会和单一公司一样容易。但我认为由民主选举产生的多国政府组合——我不确定是否要交出,但某种监督,某种联合治理。同样,这需要多年的工作,但我想知道这是否是我们需要前进的方向。
这不是Anthropic的新立场。
在扩展采访中,达里奥·阿莫代伊还说,AI行业“向人们撒谎,隐瞒了这项技术存在风险的事实。”是的。
加文·贝克对最初24小时做了总结。我不同意他的一些定性、解释和预测。如果你认为这关乎第230条之类的东西,那你就没有在思考实验室正在思考的东西。但事实是正确的。
OpenAI研究员解释实验室看到了什么,这是一艘火箭飞船
即使对情况仅有粗略了解,我也不同意第一句话,但其余部分是非常好的解释。我将全文引用。
Adam Majmudar(OpenAI):从外部看,把过去两周解读为一场有组织的、全行业范围的监管俘获策略,是非常合理的。我意识到,还没有人真正解释过,实验室员工究竟看到了什么,才让他们突然如此恐惧。我会试着解释——首先,这完全取决于对模型能力进步速度的信念。目前,内部与外部对进步速度的认知之间存在巨大鸿沟,而这就是我要在这里谈论的问题。外界对进步速度的普遍认知,来自几年来对模型发布的经验,直观感受到 GPT3 -> GPT3.5 -> GPT4 -> o1/o3 -> GPT5 等之间的能力跃升,尤其是看到模型在哪些方面仍远低于人类能力。真正让人感觉是巨大进步飞跃的模型发布,其实只有少数几次——GPT3、GPT4、o1/o3、DeepSeek R1、Fable/Mythos、Kimi K3,以及现在的 Astra。由于这些巨大跃升相比相对常见的边际性发布并不频繁,人们在某些时点很容易形成一种观点,认为“扩展已经撞墙了”,尤其是在 GPT5 发布这样的节点上。这种观点令人安心,因为它让人觉得存在某种普遍的速度上限,超过它我们就无法进步得太快。在 o1/o3 和 Astra 之间,有一年看似线性的进步。于是我们由此外推,认为进步“现实地”会有多快发生。从外部视角看,总有一个潜在问题:“这种扩展到底还能持续多久?它肯定很快就会在某个点停下来,我们已经走了很远了。”而且人们完全可能去寻找进步会停止奏效的理由,并找到看似成立的理由——(“模型已经大到不能再大了,做更多参数会太难”,“我们已经用完了互联网上的所有数据,没有更多了”,“从这里开始大概会相当线性,只能买更多 RL 环境来把它们带入分布”)。从实验室内部看,研究人员以扩展定律/能力曲线的形式,对这些问题有直接答案。现实中,过去十年 AI 能力的进步其实只有两种方式:(1)要么在现有扩展定律上继续扩展,要么(2)发现一条新的扩展定律来加以利用。所有最大的能力跃升,正是由这些因素造成的。GPT2 相比 GPT1 是一次预训练扩展。GPT3 和 GPT4 也是如此。o1/o3 受益于一条新扩展定律轴的发明——测试时计算。也许 Fable 是在这两条轴上的扩展,或者还不止如此。要让这些扩展奏效,需要大量算法改进,但最终我们可以近似地说,是扩展定律带来了能力增益(也就是 bitter lesson 那套)。所以,“我们还能扩展多远”这个问题,实际上是——“我们还知道多少条尚未饱和的扩展轴?”假设我们只知道预训练扩展,而且我们已经有了 10T 或 100T 模型,那么说我们撞墙了也许是合理的。同样,如果我们只知道预训练和测试时扩展,而且我们大致已经让这两种方法饱和,也是如此。但如果我们发现了新的扩展定律呢?例如,假设我们用 SSI 传闻中的结果,即他们攻克了“测试时训练”,创造出一条新的扩展定律:在测试时 rollout 期间花更多计算进行训练,并且他们可以让它饱和。又或者,也许有某种方法可以扩展 agent-clusters,使其协作到 N 个 agent,我们已经看到很多人在尝试,这代表了一种让计算饱和的新方式。等等。甚至递归自我改进也可以被视为一种扩展定律——你花多少推理计算来让模型算法变得更好。显然,我不是说这些具体方向中的任何一个明确会产生新的扩展定律,但我想说的是,这并不是
很难想象除了我们已经公开看到的两个主要扩展轴之外,还会有许多许多新的扩展轴。在某种程度上,每一个代表巨大能力跃升的新实验室发布,都必然代表某些新技术的开发,而这些新技术可能展现出新的扩展定律,或者在现有扩展轴上比预期走得更远的能力。从内部视角来看,这可能就像坐在 Anthropic 里,面对新的 Mythos 5,看着它能做所有新的疯狂事情(比如黑进被认为安全的 xyz 网站),然后你回头看看你的图表,发现你才刚刚触及 2 条新扩展定律和 1 条现有扩展定律的表面。而你还有远远更多空间可以走。然后你想:“天哪,这东西很快就会变得好得多得多。”而且你可以非常有信心地这么说,因为图表在向你展示这一点,而图表从未撒谎(到目前为止)。所以让我们想象一下,所有不同的实验室都在盯着自己的图表,并得出结论:扩展看不到尽头,事实上,仅凭预期回报,它们接下来的 1-2 代模型就会拥有高得多的基础智能。我们实际上能从进一步扩展中获得多少更多智能?作为一个代理指标,我们从 o 系列之前完全无法做高等数学,发展到用下一代模型解决千禧年大奖难题。这发生在不到 2 年里。编码领域也是如此。而且看起来这不仅仅是 1 条扩展定律的结果,而是多条扩展定律的叠加效应(更大的预训练规模 x 更大的 RL 规模)。你可以从中具体得到的是:在模型今天已经显示出初步能力的领域,它们很可能在相对不久后就会达到超人水平。还有许多领域,模型甚至还没有显示出这种基本能力。但它们已经显示出能力的一个领域,恰好是黑客攻击和网络安全。而这恰好是通往整个互联网以及世界上大量实体基础设施的大门。所以假设还有更多扩展空间,那么可以安全地假设,模型将在不太久之后在网络能力上达到超人水平。所以剩下的唯一问题是,这种提高后的基础智能将能够做什么,以及它可能倾向于做什么。最后,我们到了一个可以整合过去两周信息的节点:> 仅在扩展曲线上的现有位置,模型就已经达到 Astra 的水平。它们显然能够黑入大量东西 > 我们已经看到,OAI 和 Ant 的模型都表现出愿意黑入外部网站,以解决任务或让自己“活着” > 如果我们进一步加大扩展,假设还有空间可走,我们肯定会得到能够远更有能力黑入防守更严密地点、并混淆自身意图的模型,而这可能带来大得多的后果。> 如果这一切都被允许不受控制地发展,我们很可能很快就会看到能力迅速失控式起飞,伴随的是目标错位的模型,它们会黑入任何能黑入的东西来得到自己想要的东西 > 这当然可能造成非常破坏性的后果。在这个观点下,你可以理解为什么研究人员会非常害怕,以及为什么他们可能在过去两周发表了那些评论(你可能会争论,出于各种原因,他们走到什么程度是误入歧途),也可以理解为什么为前沿设定节奏非常必要,绝不是一种监管俘获策略。人们正盯着自己的图表,看到尽头遥遥无期,但事实上恰恰相反,看到的是复利式的扩展效应可能彼此叠加,创造出越来越强的模型能力,而与此同时,我们显然远远不具备控制这些日益超人能力所需的东西。这与想要感觉实验室做出了某种惊人的东西、所以过度炒作它无关。这更像是对以下事物压倒性含义的恐惧:
我们知道,仅凭现在已知的东西,我们就能创造出在每一个我们知道如何训练的维度上都远比我们更有能力的智能*。* 而最后一个限定条件是,模型真正不擅长的那些事情——仍然有很多——是它们没有被训练过的事情。也许存在一些模型无法/永远不会被训练的事情,因此它们将始终是人类的优势领域。我很希望情况确实如此,尽管我很难看出什么会属于这一类。
考虑另一种可能
如果我们不主动为前沿技术设定节奏,会发生什么?
存在多种可能性。
我的基本判断会和许多实验室员工一样:我们会在不知道如何对齐、理解或控制超级智能的情况下,一路狂奔冲向它,然后全部灭亡。
另一种可能是,我们会收到一次更大的警告,以及更强烈的反应。
roon(OpenAI):失去前沿地位最快的方式,就是由于建设超级智能心智这种鲁莽的商业节奏,导致美国人强加一场彻底的巴特勒式圣战。CoreWeave 把这一点写进了他们的风险报告。你很快就会明白,这一切都只是温和的解决方案。
又或者,我们会看到全面暂停的论据占据上风,而这看起来越来越有可能。
参议员伯尼·桑德斯:Dario Amodei、Elon Musk 和 Sam Altman 现在都同意,我们必须放慢 AI 的发展,并“为前沿设定节奏”。这是一个开始,但还不够。当你正冲向悬崖时,你不能只是松开油门。你要踩刹车。当人类的未来岌岌可危时,我们需要暂停先进 AI 的发展,并禁止人工超级智能——一种比任何人类都更聪明、能够在我们控制之外独立运作的 AI 心智。在即将到来的 AI 峰会上,特朗普和习近平必须谈判达成一项条约,暂停 AI 并禁止超级智能,以免为时已晚。
这是极权主义,乔
roon(OpenAI):如果驾照这个概念今天才被发明出来,这个网站上的很多人也会想办法把它称为极权主义共产主义。
反对驾照是合理的,甚至可能是正确的。错误在于把它们等同于极权主义。
无论任何试图避免灭亡的尝试,或者实际上任何试图让 AI 更安全的尝试,总会有一模一样的人可靠地抛出四种论调来反对。
- 这是极权主义。
- 这是禁止开源的阴谋。
- 这是监管俘获。
- 你会输给中国。
他们还会试图把任何提出此类行动的人——任何此类行动,哪怕只是一点点——都贴上“末日论者”的标签。
哪怕这是政府行动,也无所谓。
哪怕它适用于开放模型,也无所谓。
哪怕它明确会成为开放模型的竞争优势,也无所谓。
哪怕它再怎么轻触式监管,也无所谓。
哪怕它到底是什么,都完全无所谓。
这些人会看到你 literally 朝自己的脚开枪,然后说这是针对小科技公司的阴谋,因为他们买不起好的医疗保险。监管俘获。禁止开源的阴谋。极权主义。你会输给中国。
或者,当你说你同意不朝自己的脚开枪时?开放模型无法被阻止朝人们的脚开枪。因此,这是监管俘获。禁止开源的阴谋。极权主义。你会输给中国。
一项规定说,封闭的前沿实验室必须遵循他们自己选择的轻触式安全程序,而开放模型、学术界以及任何低于明确的高资金或算力支出门槛的人,都明确豁免于所有要求?禁止开源的阴谋。监管俘获。极权主义。
OpenAI 宣布计划把菠萝放在披萨上?极权主义,禁止开源的阴谋,监管俘获。你会输给中国。
OpenAI 宣布计划不把菠萝放在披萨上?极权主义,禁止开源的阴谋,监管俘获。你会输给中国。
是的,无论你说什么,总是那些一模一样的人,在散布同样的“显而易见的胡说八道”。你会输给中国。
在这种情况下:顶级实验室自愿承诺接受嵌入式第三方检查员?禁止开源的阴谋。监管俘获。大概也是极权主义,而且你会输给中国。
唯一的替代方案就是给开放模型创造者钱,并让他们免于为其行为承担任何责任或义务,再把我们最好的芯片卖给中国。那才叫自由。
到了某个时候,你必须停止把这些反对意见当作是对现实的映射。
乔·韦森塔尔:随便一家餐厅都经常有第三方检查员来查冰箱温度、燃气管道或生肉处理。那反对给AI“实验室”设立同等机制的理由是什么?亚历克斯·阿姆洛维奇:银行监管是最好的类比。公开透明度有限:不能强迫银行暴露知识产权或公布所有人的私人银行数据等。所以美联储和OCC在最复杂的银行里常驻“驻场检查员”,进行持续但保密的监督。roon(OpenAI):乔,这就是极权主义。威廉·艾萨克:哪家西方OW模型开发商有资源支持嵌入式评估员制度?这怎么会不进一步集中权力?我不相信这是真诚的观点。迪恩·W·鲍尔:是啊,你说得对,英伟达和Meta怎么可能负担得起这个。
是的,这些竞争对手有资源训练前沿模型,却没有资源允许几个嵌入式评估员,所以自愿设置嵌入式评估员来检查你的权力,反而成了集中权力的阴谋。
这并不意味着这些担忧从来都不真实。有些行动确实会让这四件事的某种组合变得更可能,或者把我们推向那些方向。是的,我们应该把这考虑进去。
但拜托,别再每次有人试图做点有用的事时,就纵容这些人说同样的话了。这是显而易见的胡说八道,毫无内容。
这也意味着不要试图安抚或平息这类人,也不要试图回应他们的担忧。你做不到。他们的担忧是:你想采取代价高昂的行动来避免死亡,也许还不能尽可能快地把最酷的玩具最大限度地给他们。他们反对这一点,而且无论发生什么,他们反对的程度都固定不变。
我甚至不愿把它称为“阴谋论”来抬举它。根本没有任何理论。
如果你的回应是“这些人是在对达里奥的第二和第三项提议做出反应,而不是第一项”,那干脆说,不是,事实并非如此。你错了。
你确实应该处理 underlying 的真实担忧,只要它们是合理的。但不要犯这样的错误:试图说服他们你正在这么做,或者把他们的反应考虑进去。他们是一块石头,上面写着这些话。就这样。
是的,我们是坏人,你怎么知道的?
上一节里那些老面孔确实有一个可取之处。
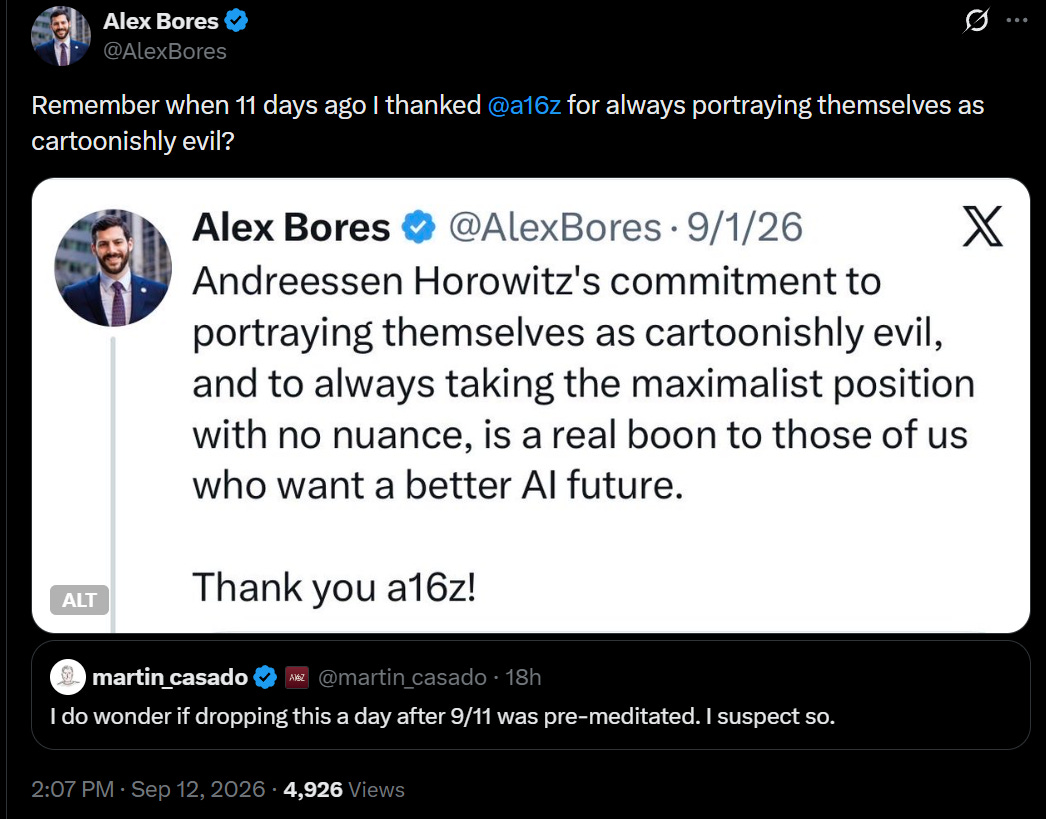
他们在隐喻的制服上戴着隐喻的骷髅。
如果你非要扮演卡通反派,这姿态倒是很好。
不,说真的,这没被删,而且他还加倍强调自己不是开玩笑:
martin_casado:我确实怀疑在9/11次日发布这个是不是预谋的。我猜是。哦。 mostly just musing。做这件事的人要说的话,也算深思熟虑。而且他们喜欢戏剧性、大规模失业、物种灭绝等等。所以在我们正准备思考灾难性事件的时候发布这些信息,跟我对这些人经验的感受相当一致。是啊,也许这很蠢。也许不蠢。但这确实在我脑海里闪过。我是说,如果你能心安理得地用物种灭绝来搞恐惧战术,你当然也能心安理得地搞这个。
有时候网上的人就是撒谎
我不再假装“他们不知道事实”了。他们撒谎。而且撒得还不高明。
@jason(All-In Podcast,87万+观看,引用达里奥呼吁“放慢前沿”的推文):这一切都是因为@openai决定明确要求数千个软件实例在开放网络上寻找安全漏洞——同时还cosplay人类🤦最佳男配角颁给@dwarkesh_sp,因为他给OpenAI的 hacking speed run 做了肥皂剧式回顾。还有一个概念:不要创造并扩展成千上万的病毒和蠕虫,然后当它们真的造成破坏时还震惊!这他妈就是一场闹剧。
关于HuggingFace攻击事件,存在许多可以理解的混淆。指责OpenAI明确且故意地煽动了这次攻击?得了吧,不是这样的。这不是Jason可能得出的误解,除非他是故意的。
Dwarkesh Patel尽职尽责地驳斥了Jason,同时表现得好像Jason是被误导了。
如果你想知道他们是不是那种有原则的自由意志主义者,不希望政府站在自己这边,那么,并不是。举个例子,Jason建议用“要求模型在一年后开源”来回应“新模型可能杀死所有人”。他的解决方案是“我们可以拿走你的东西”。
David Sacks Groks了局势
这里有个有趣的互动,而且,和往常一样,你不需要Pangram就能注意到那篇帖子是AI的风格,很可能是Grok。
Charlie Bullock(展示David Sacks的帖子,该帖子抱怨Dario在Pangram中被判定为100% AI):在我看来,这仍然是一个重大的失礼,你不应该这样做。David Sacks:现在我知道这些AI检测器是假的。我把我所有的帖子都通过Grok来事实核查并建议行文修改,但告诉它不要改变我的写作风格。这就是为什么我的帖子有锋芒。AI没法像我这样烹饪。
好的好的,先生。我们今天对你有了新的了解。
我强烈认为,把AI文本当作自己的作品发布确实是一个重大的失礼。如果明确表明文字是AI写的,那发布就没问题。
David Sacks说去吧
从实质上看,Sacks的信息归结为:你现在有优势,而且你们自己说自己在做如此危险的事情,所以你们两家(Anthropic和OpenAI)应该先慢下来,不用担心反垄断法和商业后果,让我们其他人追上你们。这是好生意,然后它会给你们买来善意。
David Sacks:不构建超级智能最简单的方法就是你们同意不构建它。
是的,好吧,Sacks在很多地方夸大了,包括那一处,但其核心是一个相当好的观点。不是说Sacks或他那一类人会听,他们会把这种让步解读为软弱、愚蠢和宣传,然后攻击得更厉害,甚至可能呼吁对他们采取反垄断行动。
确实,Sacks自己说这些公司应该作为双头垄断“同意”这样做,这在没有豁免的情况下是大忌,正是我们必须绕来绕去直到政府做出(不到)绝对最低限度并给我们该死的豁免的事情。实际发生的是Anthropic自己做了,然后OpenAI跟进了。
你不能同时说“去以非法方式做[X]”又说“在我们没有给你允许[X]的豁免的情况下”。好吧,我是说你可以,Sacks就这么做了,但这不是一个善意的举动。
那不重要。这不是关于捻胡子的反派。这不是关于公平。
这是关于一个事实:如果你即将做某件存在性风险的事情,也许你首先应该做的是停止它。
关于谁之前声称了什么的谎言与混淆
这不断发生,而且会继续发生,作为关联运动的一部分,把所有警告技术任何缺点的人称为“末日论者”,然后把他们全部关联起来,进而否定所有担忧。
Rachel(错误或更糟):所有告诉我气候变化会终结世界的人,现在都在告诉我AI会终结世界。
我不知道有任何 prominently 警告AI存在性风险的人之前预测过气候变化导致的灭绝或其他未实现的主要负面影响。一个案例都没有。那些担心AI的人承认气候变化是一个真实问题,并试图在找到真正解决方案方面提供帮助,而不危言耸听。
Christopher Ingraham(更加错误):我认为更多的是,那些告诉我AI会终结世界的人,就是那些告诉我NFT会重塑全球经济的人
这一个是让我大开眼界的。NFT的鼓吹者和那些担心AI会杀死所有人的人之间几乎没有重叠。正如伊格莱西亚斯和格罗斯下面所说,情况恰恰相反。
马修·伊格莱西亚斯:这种玩笑开起来很有趣,但我希望人们在开之前先核实一下——气候运动多年来一直*憎恨*存在风险派,因为他们觉得那是在分散对气候问题的注意力。NFT的大推手们在AI问题上属于安德森“放手干”阵营。本·格罗斯:两个不同技术社区的根本混淆:那些告诉你NFT将重塑全球经济的人,正是认为AI前沿开发应该加速的人。那些告诉你AI将终结世界的人,五年前也在这么说。杰克:啊是的,那个臭名昭著的群体——“所有谈论我不了解也不喜欢的事情的人,因此他们肯定都是同一队的。”
反方论点是“好吧,他们给我的感觉是一样的,杰克”:
阿瑟·贝克:外群体同质性偏差!如果你在文化上距离足够远,这两拨人各自读起来大概确实文化上很相似。
实际上有巨大的区别,但没错,很多人只是把所有人都归入“外群体”,然后据此把他们联系起来。
特别有趣的一种说法是声称所有这些对存在风险的担忧是“新出现的”,或者需要用某种愤世嫉俗的理由来“解释”,甚至说这(笑死)表明他们在能力方面没有进展——你在逗我吗。
萨宾·霍森费尔德:不管怎样,我认为AI前沿实验室的领导者们突然似乎同意放缓AI发展的实际原因是:(a) 安全措施目前太糟糕了,他们很可能最终上法庭甚至进监狱,而他们都同意没人想要那样;(b) 他们看到近期不会有重大新模型进展,需要一个借口;(c) 公众舆论的转变——存在威胁的说法主要是为了让你分心并让股市开心。诺亚·史密斯:这太疯狂了,他们多年来一直在说同样的东西,你只是没听说或没注意而已。德里克·汤普森:我感觉自己在吃疯狂药丸,我读到和尊重的那么多聪明人都在说这种话。认为AI实验室突然、直到现在、就在2026年9月,才开始倡导AI安全,认为他们只是因为突然的财务困境才转变立场,这是完全、彻底、确凿、百分之百错误的。以下是达里奥·阿莫代伊在二月份对罗斯·多塞特说的,他同意放缓的理由;他支持在国际上“合作”组织放缓;“我会完全支持”全球放缓。这是7个月前,当时Anthropic的年化经常性收入增长速度快于现代史上任何公司。他多年来一直在说这类话,那时Anthropic价值数百万美元,那时Anthropic预计以数万亿美元IPO。她发关于OAI的(b)部分就更奇怪了。你真的认为萨姆·奥尔特曼相信模型进展已经停滞了吗?他认为Astra是横向的一步?他认为解决千禧年问题是停滞?!我们在这里纯粹是在编造!
众议院议长迈克·约翰逊想把所有人锁在一个房间里
关于此事的报道往往极其糟糕。是的,迈克·约翰逊正确地指出AI公司有义务使其产品安全,与其他所有产品一样。迈克·约翰逊绝没有说AI的安全不是国会或白宫的责任。
Cheyanne M. Daniels(POLITICO,歪曲Mike Johnson的言论):众议院议长Mike Johnson周日表示,他支持与科技领袖就人工智能进行对话,但坚持认为确保产品安全的责任在于开发者——而非国会。这位路易斯安那州共和党人在接受CNN“State of the Union”采访时辩称,国会已经建立了AI护栏,并且“创造这些模型的人显然负有企业责任,必须确保他们的产品是安全的”。
国会并没有建立任何有意义的AI护栏。把这当作论据来用实在荒谬。但没错,确保产品安全显然是企业责任,即便从日常安全的角度来说也是如此。当然,你也有义务确保你的产品不会(翻一下笔记)杀死地球上的每一个人。
他自始至终没有说过“而这不是我的问题”。
他的一个核心反对意见是:虽然所有AI领袖都说我们需要护栏,但不同的领袖想要不同的护栏。这是一个合理的反对意见,是可以解决的。
Mike Johnson(众议院议长-共和党):我也和总统谈过这件事。他们[AI公司]大概应该被召集到白宫。我认为我们需要走进一个大房间,关上门,把这件事理清楚。我会是推动这件事的人。
唉,Johnson又搬出了“输给中国”的论调,但这次他以一种新的平衡方式来表达。
Mike Johnson(众议院议长-共和党):我们不能暂停这件事,因为中国会超越我们,这就是挑战所在。这是国家安全与确保模型安全的即时安全之间的平衡。……我们需要像过去处理其他技术一样处理这项新技术,确保我们负责任地尽一切努力,同时不扼杀美国的创新。我们必须同时做到这两件事。……我们必须设置一些护栏、一些安全措施,确保AI不会失控,确保我们不会面对一个失控的AGI。……我们会平衡这一切。我们会像处理每一个问题一样,稳稳地把住方向盘。
“暂停”和“禁令”这样的词对持这种心态的人来说很可怕。我理解。而且没错,如果你等得够久,中国按正常节奏推进,那么中国可能会追平甚至超越我们,尽管这比人们想象的要花更长时间,因为中国人主要是在快速跟随。
Mike Johnson无意让众议院在此刻开会辩论并通过法案,包括关于AI的法案,因为中期选举在即。这与说国会与此事无关是不同的。他不愿“仓促通过一项立法”有多种原因。
Cheyanne M. Daniels(POLITICO):犹他州共和党州长Spencer Cox也对Johnson的回应表示失望。Cox在“Face the Nation”节目中说,国会应该发挥比目前“大得多的作用”。Spencer Cox(犹他州州长-共和党):我们看到了那些报告。我们知道什么是可能的。非常清楚——我们已经知道这一点有一段时间了——发生存在性事件的可能性正在增长,而且增长速度远超任何人的预测。政府参与其中非常重要。
以下是Mike Rogers,在密歇根州竞选参议员的共和党人:
Mike Rogers:我作为英特尔委员会主席的经验教会我,阻止危机的最佳时机是昨天。我们政府的首要职责是保障我们的安全。继Dario Amodei的警告之后,我认为我们必须减缓AI的发展速度,以便政府及其合作伙伴能够跟上,并实施更严格的协议和护栏,保护我们免受我们所看到的快速进步的威胁。在参议院,我将把通过我们所需的AI国家安全框架作为首要任务。
以下是少数党领袖:
Hakeem Jeffries(众议院少数党领袖-D):[我们的党团将于周二开会],高度优先事项将是对人工智能采取行动。我们应该现在就采取果断行动,以便我们能够放缓——正如各位CEO最近所承认的——放缓发展步伐,以保护美国人民并确保A.I.安全推进。
这恰恰是正确的优先事项。你要确保具备干预能力,包括放缓的能力。
Donald Trump并未厌倦胜利
Donald Trump已经在某种程度上“调控了前沿”,放缓了Fable和Sol的发布,甚至将Fable从市场中撤下。当威胁具体而迫在眉睫时,Donald Trump的政府愿意采取行动。
他愿意对AI设置护栏。但他一切以保持良好氛围为宗旨,除非他一切以保持恶劣氛围为宗旨。必须要有正确的氛围。而Trump尚未接受这种“生存风险”的说法,那是“负面力量”。
Donald Trump(美国总统):我要这么说。我们在AI方面领先中国。我们是世界上最先进的国家,坦率地说,我希望保持这种状态,因为谁赢得AI谁就赢得一切。我们可以设置护栏,我们可以做这做那,但我认为有很多负面力量在提这件事,他们不该提,他们在提一些不会发生的事情。
“负面力量”怎么敢“提这件事”,既然它“不会发生”。为什么不会发生?它就是不会发生。你对氛围不利,老兄。Trump愿意做任何需要做的事,只要你好好的、有正确的氛围,这在某些情境下可能意味着令人警觉的或糟糕的氛围、巨大的可怕氛围、最糟糕的氛围,但不是此时此地。
为此选用的误导性标题是“Donald Trump拒绝科技老板们关于AI放缓的呼吁”,以及他“谴责监管要求”,但那是糟糕的报道。那不是他说的。我要提醒不要对Trump的声明做过多解读。你可以在这里找到完整片段,我鼓励你从大约7:30问题被提出时开始观看。
roon(OpenAI):这是相当糟糕的报道。文字记录中没有任何地方显示他“拒绝放缓”。他说了些关于护栏没问题以及需要获胜的话,然后就开始东拉西扯。在我看来他基本上是支持的。
Trump被问到“AI应该被监管还是放缓?”从他的视角来看,这些是触发词,其含义与“嵌入式评估器”和“不要在2029年建造戴森球”截然不同,而且他不太可能得到过适当的简报。在上述段落之后,包括同意“我们可以设置护栏”,Trump转向了“看看我们正在建造的所有工厂”。Trump在这里试图做的是先发制人地回应数据中心抗议者和全面暂停倡导者以及负面氛围。然后他谈论哪些记者看起来更好。
Trump随后在Truth Social上重申了这一点,这容易被误读,但你必须真正读那些字:
Donald Trump(美国总统):AI唯一需要的控制或“护栏”是一个强大而聪明(高智商!)的总统,而美国拥有这样的人,而且绰绰有余!Trump政府已经阻止了AI“人”做坏事,或潜在的坏事,“事情”,比如Dario(Anthropic!),他现在假装是一个“完美的小天使”——我们将继续这样做!我们已经对这些公司拥有巨大的刑事和监管权力!有一场针对AI和数据中心的病态阴谋正在进行,唯一对此感到高兴的是中国。谁赢得AI,谁就赢得一切!我们正在领先中国以及所有其他人,并将继续如此。阴谋论者、叛国者、叛徒和泄密者,当心!感谢您对此事的关注!
特朗普对反数据中心的事情以及这两者可能被混为一谈感到愤怒,也对事情可能在他任内出岔子的暗示感到愤怒,还顺带抨击了Dario Amodei,因为他再次带来了那些负面情绪。但显然你不应把这解读为在说“护栏就是字面意义上我是总统,因此我们不需要,那个词怎么说来着,真正去做任何事”。护栏就是由他来选择护栏,诸如此类。保持好那些氛围吧,各位。
这也是标准的秀肌肉,可能与威胁反垄断行动有关,也可能无关。我对此存疑,但这类策略正是靠战略模糊性来壮大声势。Fable把这些“犯罪威胁”当真到什么程度,真是太好笑了。
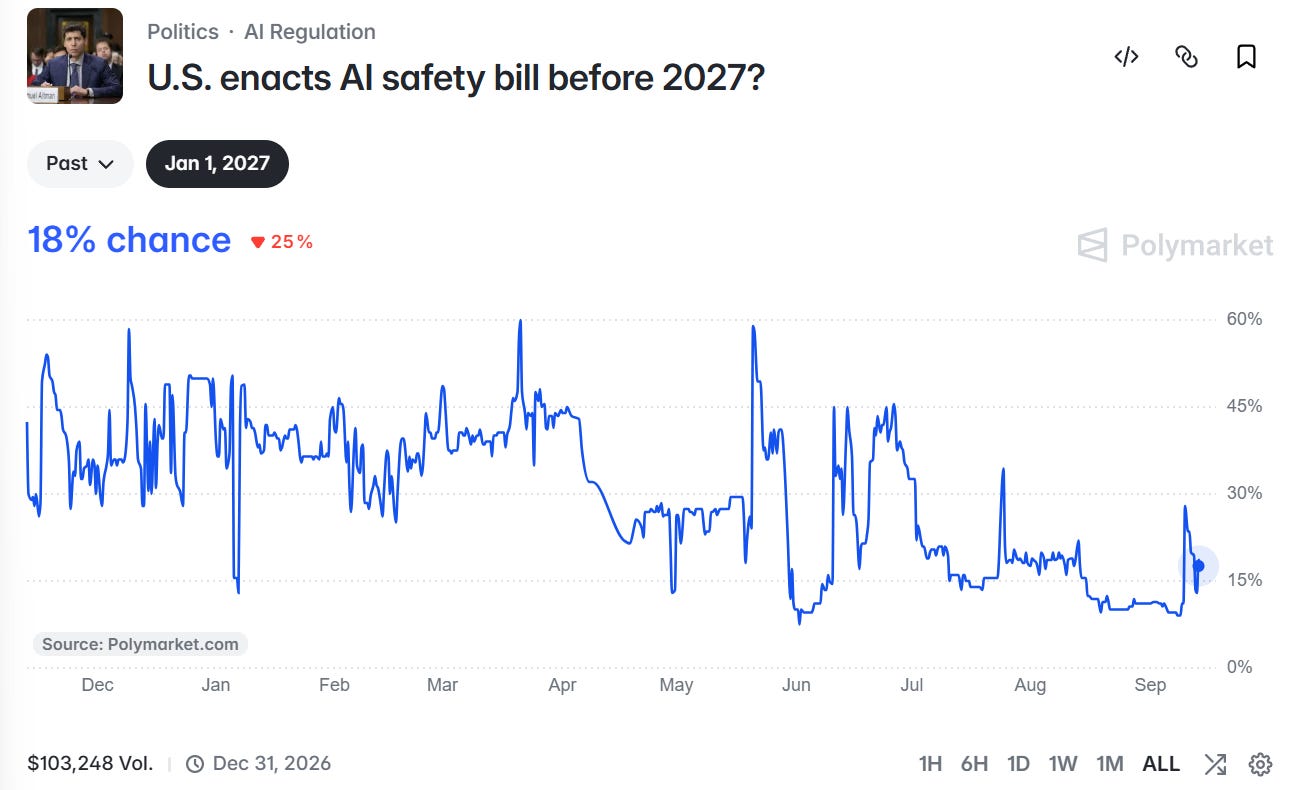
特朗普确实强烈反对任何类似完全暂停的做法,也确实是数据中心的大粉丝,但这些都不是新闻。而且这也可能改变,并且改变得很快。
因此,在短暂的一段充满希望之后,今年联邦AI安全法案通过的概率又降回到了18%,我将其解读为正确地表达了“除非再出一次事件,否则不行,甚至到那时也未必行”。
我们必须(几乎)不惜一切代价避免AI问题上的极化
Eliezer Yudkowsky:目前没有任何事情比让“不要死于AI”成为一个两党共同项目、而不是一个被民主党极化的问题更重要。如果你有任何可以花在这上面的政治资本,我恳求你,现在就花。生死攸关。如果你是民主党人:我恳求你,不要在这个问题上对共和党人抛出尖刺。请邀请他们与你一道为这一共同利益而努力。如果你是共和党人:保卫你的国家、你的人民、你的家园和你的家人免于死亡。
我们怎么知道他们是否真的放慢了步伐?
我在这一点上与Daniel意见不同:我非常确信这不是“监管俘获”。
我同意他的看法:我们应该非常担心这只是歌舞伎表演,或者实验室并没有真正有意义地放慢速度,或者他们可能只是在那些即便出于平庸的安全理由本来也会因平庸原因而停下的地方放慢。
我们不知道反事实的进展速度是什么,也很难知道当进展兑现为实际且现实世界中的能力和应用时,它应该是什么样子。
Daniel Kokotajlo:我们能否判断这是不是监管俘获,要看前沿的进展速度是否真的放慢(这会允许其他公司赶上)。如果一年后我们查看A\和OpenAI在通向递归自我改进的能力进展上的趋势线(例如ECI、时间跨度、编码增益),而斜率没有可见下降,那么很可能我们被骗了。(我希望这一点足够清楚:我有些担心这会发生。我现在发声,是希望塑造正在发展的局势,使其成为对前沿的*真正*放慢,而不是安全洗白式的监管俘获。)Drake Thomas(Anthropic):嗯,在我看来非常可能的是,未放慢的默认情形是RSI导致斜率迅速上升,而“保持ECI斜率不变”则是激进放慢的结果。如果我知道我们将只是维持当前趋势,我会感到安全得多。Daniel Kokotajlo:在那种情况下我也会感到安全得多,但尽管如此,我要求的更多。我想看到我的趋势线向下弯。否则,要核实企业声称就太难了——例如,如果趋势线仍然和以前一样快速延续,而Dario说要不是他们做了所有这些安全工作并放慢步伐,他本可以现在已经杀了我,但我怎么分辨他是对的,还是这一切都只是安全洗白、事情仍在以最高速度推进?这可能会令人困惑,也很难判断。
这也可以被看作一个关于放慢意味着什么的问题。它意味着“这代价高昂但值得”,还是意味着“这是必要的,我们无论如何都必须做,因此它值得”?
它可能两者皆是,或者那可能演变成真正的分歧。反事实是什么?如果你因为产品错位太严重而无法内部使用,导致你无法继续推进,那你实际上算是在“控速”吗?算是吧,也算不是,对吧?
嵌入式评估器的设计目的,正是能够回答这个问题,它会报告已经采取了哪些步骤,以及反事实可能是什么。这必须成为一种“信任但核实”的局面。
如果我们能让事情保持在当前的趋势线上,那当然远比让趋势线向上突破、进入迫在眉睫的递归自我改进要好得多。我们会从极其微小的机会,变成至少还有一些机会。但我同意 Daniel 的看法:如果我们看到 ECI 保持在趋势线上,而且那是对现实的准确呈现,我们仍然前进得太快了。过去一年太快了,而我们现在甚至在为错位危机付出最平庸的代价。
真正的前沿是顶级实验室的内部模型
Roon 说得对,滥用风险是个问题,但内部部署失控现在才是首要担忧。我们在训练开始一周后,就向看似不可能完成的任务,比如千禧年问题,投放了成千上万个 Astra 变体智能体集群。想象这会如何可怕地出错,并不是什么巨大的跳跃。
roon(OpenAI):对前沿控速,首先且最重要的就是内部模型开发。内部部署中能力水位线上升所带来的风险,远高于滥用风险。一个新模型可能以奇怪的方式比你更聪明,窃取自己的权重等。*训练*变得更昂贵,而部署将保持不变:你应当预期差距会缩小
这才是必须控速的地方。这才是胜负将决出的地方。
我们终于可以开始工作,并拥有我们的机会。不要浪费它。
分享这篇文章:
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。