精选Google DeepMind Blog短讯
Gemini 4 Argon:我们下一个前沿智能时代
标题提及 Gemini 4 Argon,暗示 Google 即将发布新一代前沿 AI 模型。
Gemini 4 Argon 在现实世界的软件工程、法律与金融等企业知识工作以及网络安全防御等复杂工作流中,提供了前沿的性能表现。
您的浏览器不支持音频元素。
- Google 的新 Gemini 4 Argon 模型将高级推理能力引入复杂的、长周期的专业任务。
- 该模型具备行业领先的 100 万 token 限制,支持深度、多步骤的问题解决。
- 它在编码、金融研究、法律起草以及自主网络安全漏洞修补方面表现出色。
- Argon 目前正通过 Fairwind 计划向受信任的网络安全防御者推出。
- 在向公众广泛发布之前,Google 优先考虑安全性并进行严格测试。
今天,我们宣布推出全新的前沿模型 Gemini 4 Argon,该模型正通过我们的 Fairwind 计划向一组受信任的网络安全防御者推出。Argon 旨在支撑跨复杂、长周期工作流的深度推理,从根本上改变了我们在 Google 的工作和构建方式。它在现实世界的软件工程、法律与金融等企业知识工作以及网络安全防御等复杂工作流中,提供了前沿的性能表现。以安全的方式在此级别释放前沿能力需要采取分阶段的方法。在我们逐步扩大访问权限的同时,我们积极参与美国政府自愿进行的发布前模型访问流程。在迭代护栏并在尽快向开发者、企业和消费者提供 Argon 之前,我们将继续收集早期测试者的反馈。Argon 将以入门价格 1 推出,即每百万输入 token 2 美元,每百万输出 token 10 美元,缓存输入 token 的价格为输入 token 价格的 95% 折扣。
改变我们在 Google 的工作和构建方式
Gemini 4 Argon 已经在我们的内部工作流中发挥作用,数千名 Google 员工强调了该模型在专业编码任务、进行更深入的研究以及写作质量方面的优势。它帮助团队更快地构建产品,推动工程生产力的边界,并加速突破:
量子算法优化:Argon 正在帮助我们的量子计算研究人员优化对重要应用程序构成瓶颈的子例程的时空资源(量子比特 × 门)。在一个例子中,它在几分钟内就将性能提升了 40%,超越了已发布的基线。
内存效率:一组 Argon 智能体分析了全车队的分析遥测数据,自主识别并应用了 Google 数据中心的内存优化措施。一旦部署,将释放出超过 300 TiB 的内存,预计总节省量为 500 TiB 至 1 PiB。
大规模代码库迁移和优化:Argon 智能体正在 Google 范围内将 C/C++ 代码库迁移到 Rust——规模从 re2、libgav1 等核心库中的数万行代码,扩展到 Fuchsia OS Zircon 内核的 80 万+ 行代码。鉴于许多这些系统的关键性,此类大规模重写在部署到生产环境之前,都要经过严格的自动化和人工审计、仿真测试和审查。对于 Google 用于视频解码的开源软件 libgav1,Argon 智能体利用现有的 Rust 移植版本,通过运行多轮基于配置文件指导的实验,研究编译器的输出,生成了安全的 Rust 代码,以便编译器能够自动对其进行向量化处理。最终结果是一个内存安全的视频解码器,其运行速度比 Rust 移植版本快 2.7 倍,且视频输出完全相同,使其更接近于优化后的 C++ 性能。

在解决最复杂的问题上更加全力以赴。为了支持 Gemini 4 Argon 在更长、更复杂用例中的能力,我们将模型的输出令牌限制大幅扩展至行业领先的 100 万令牌,此前为 6.4 万令牌。当模型拥有足够的空间进行深入思考并在单次轨迹中生成数十万个令牌时,它便增加了一个新的推理深度层次,从而一次性解决棘手问题。
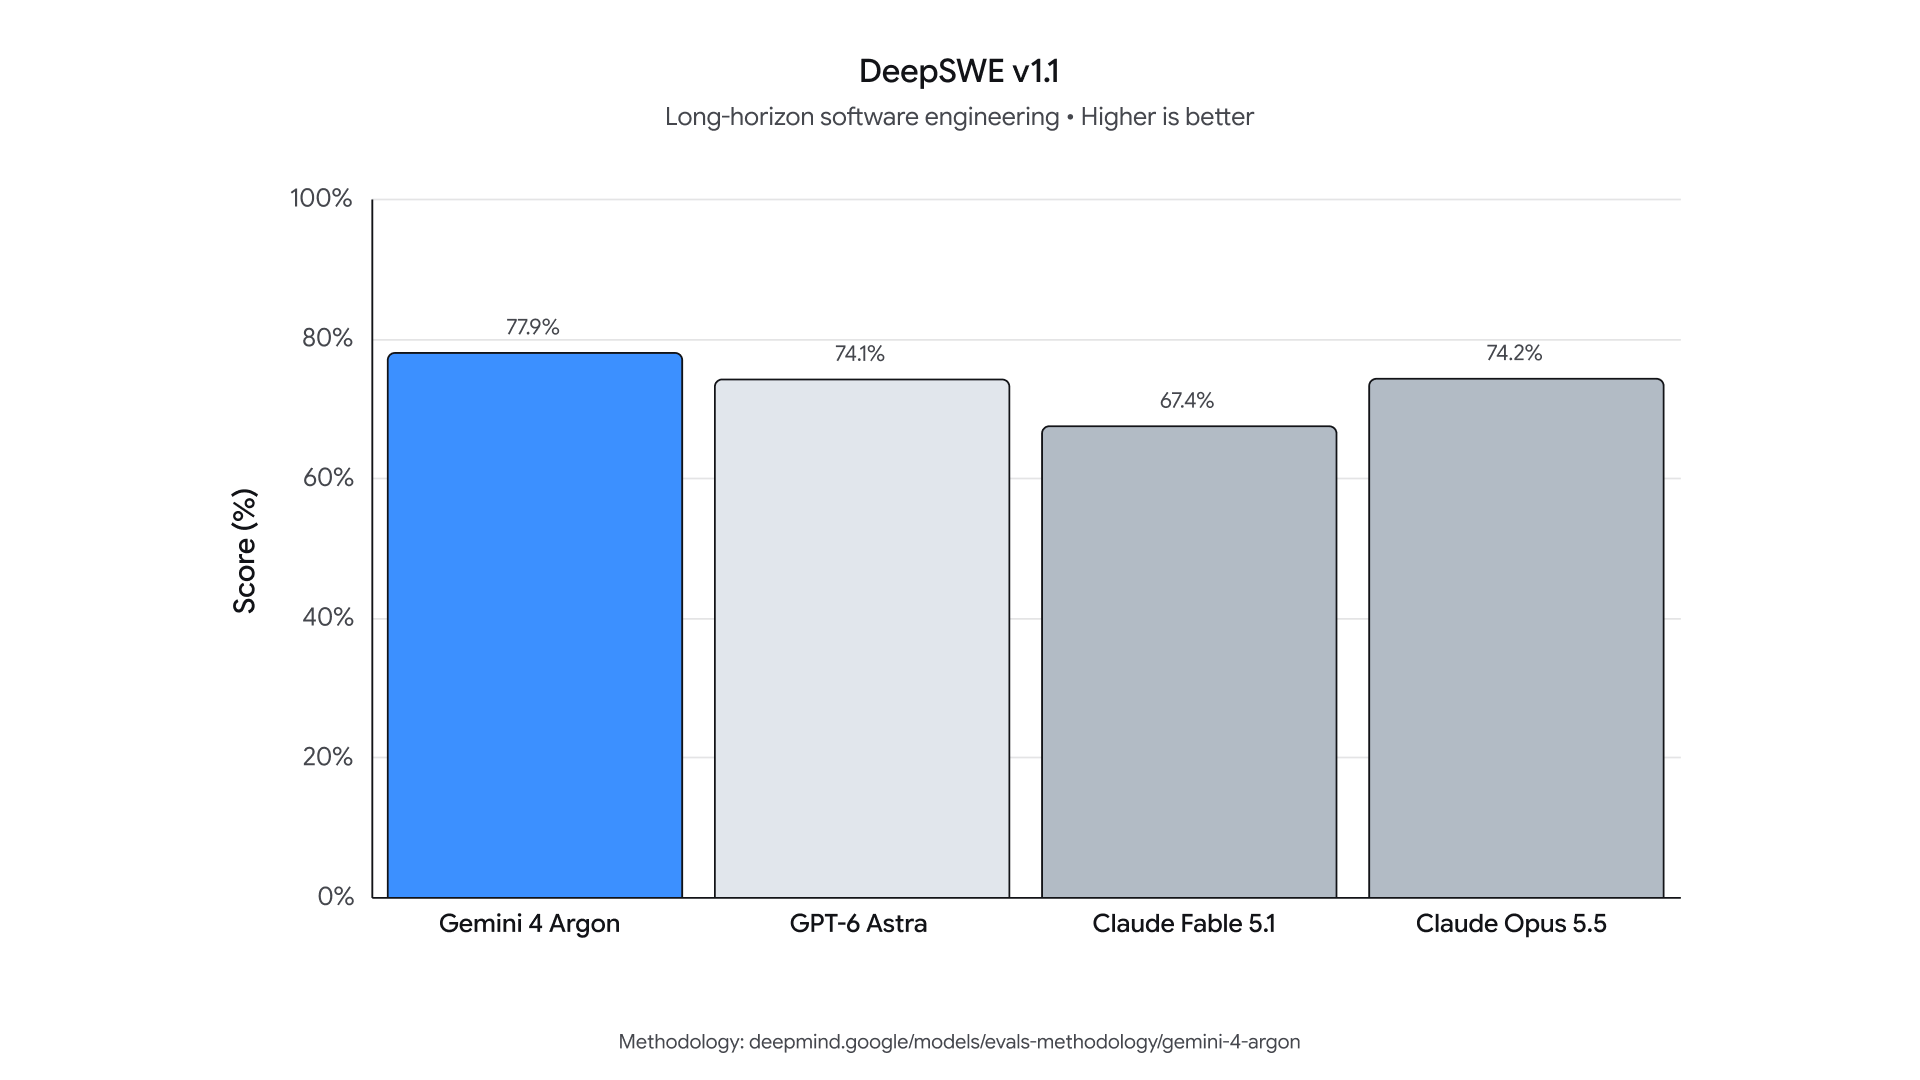

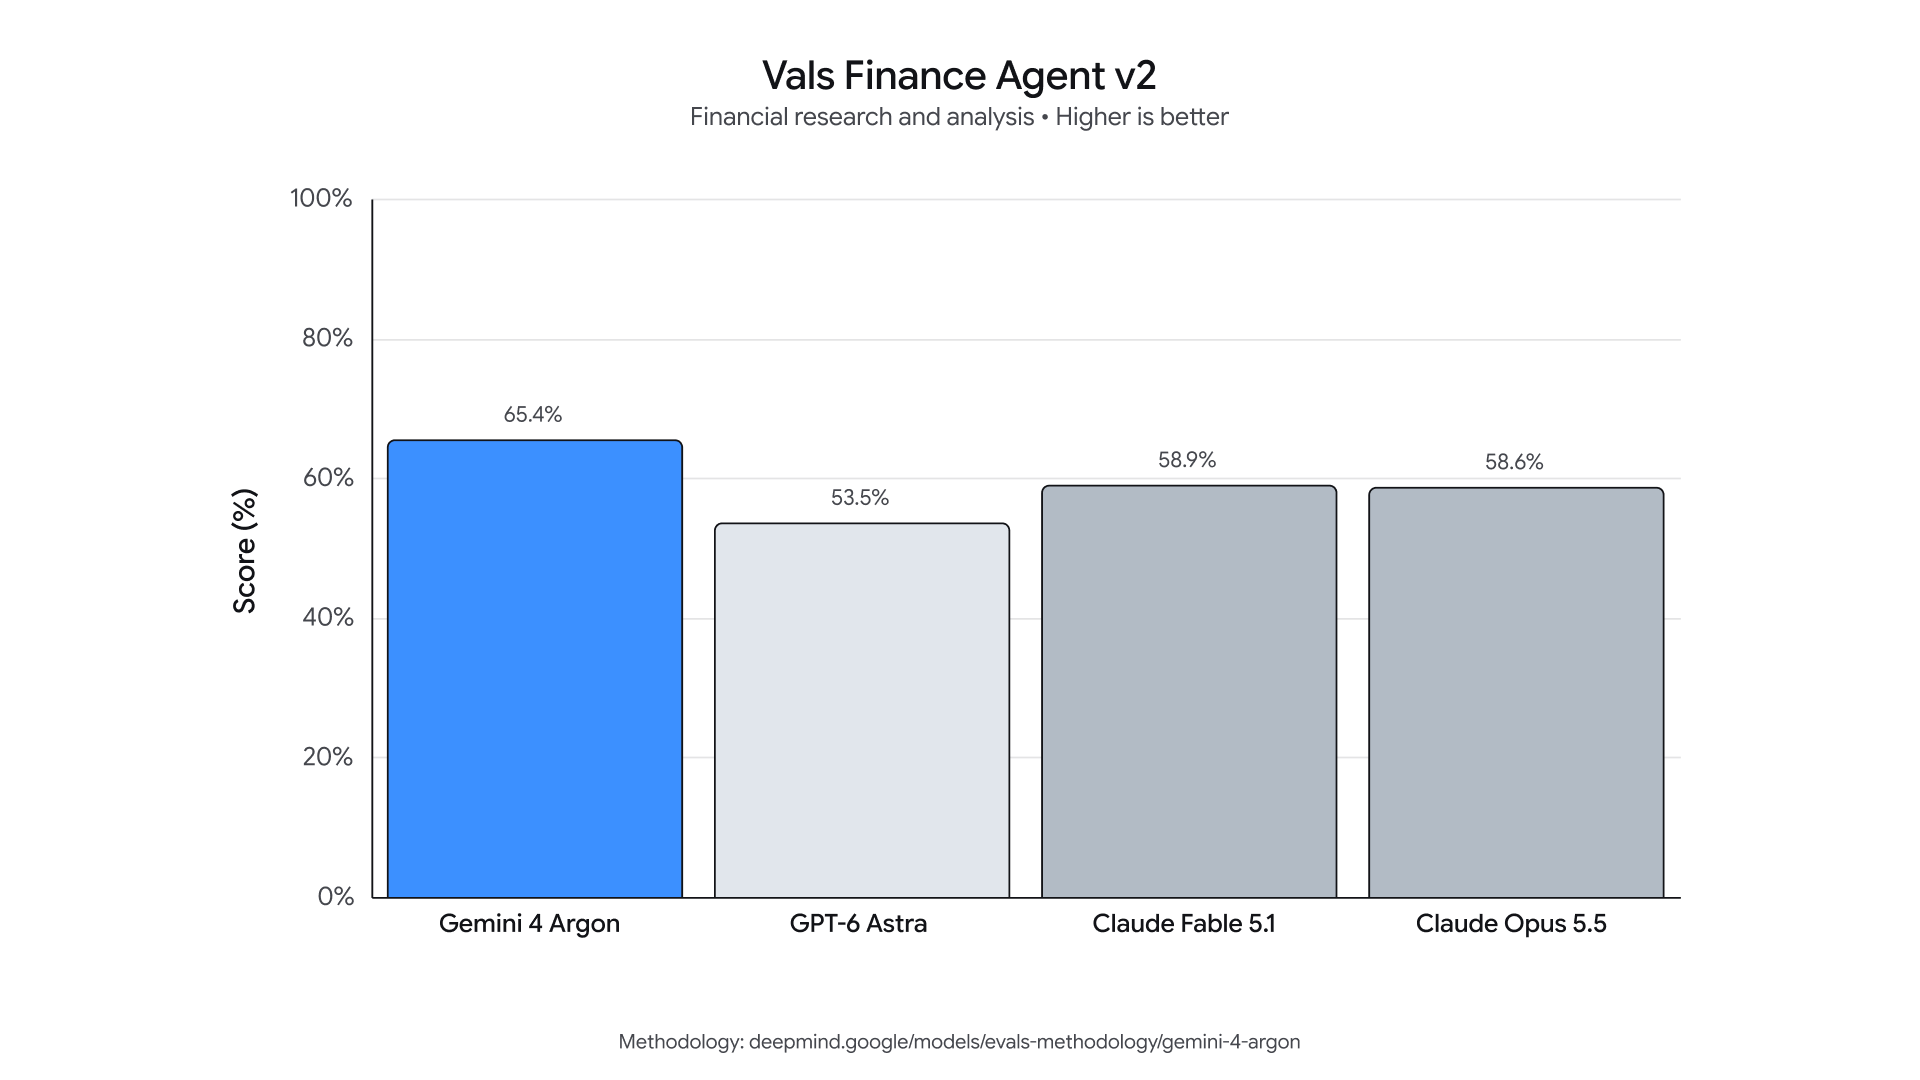

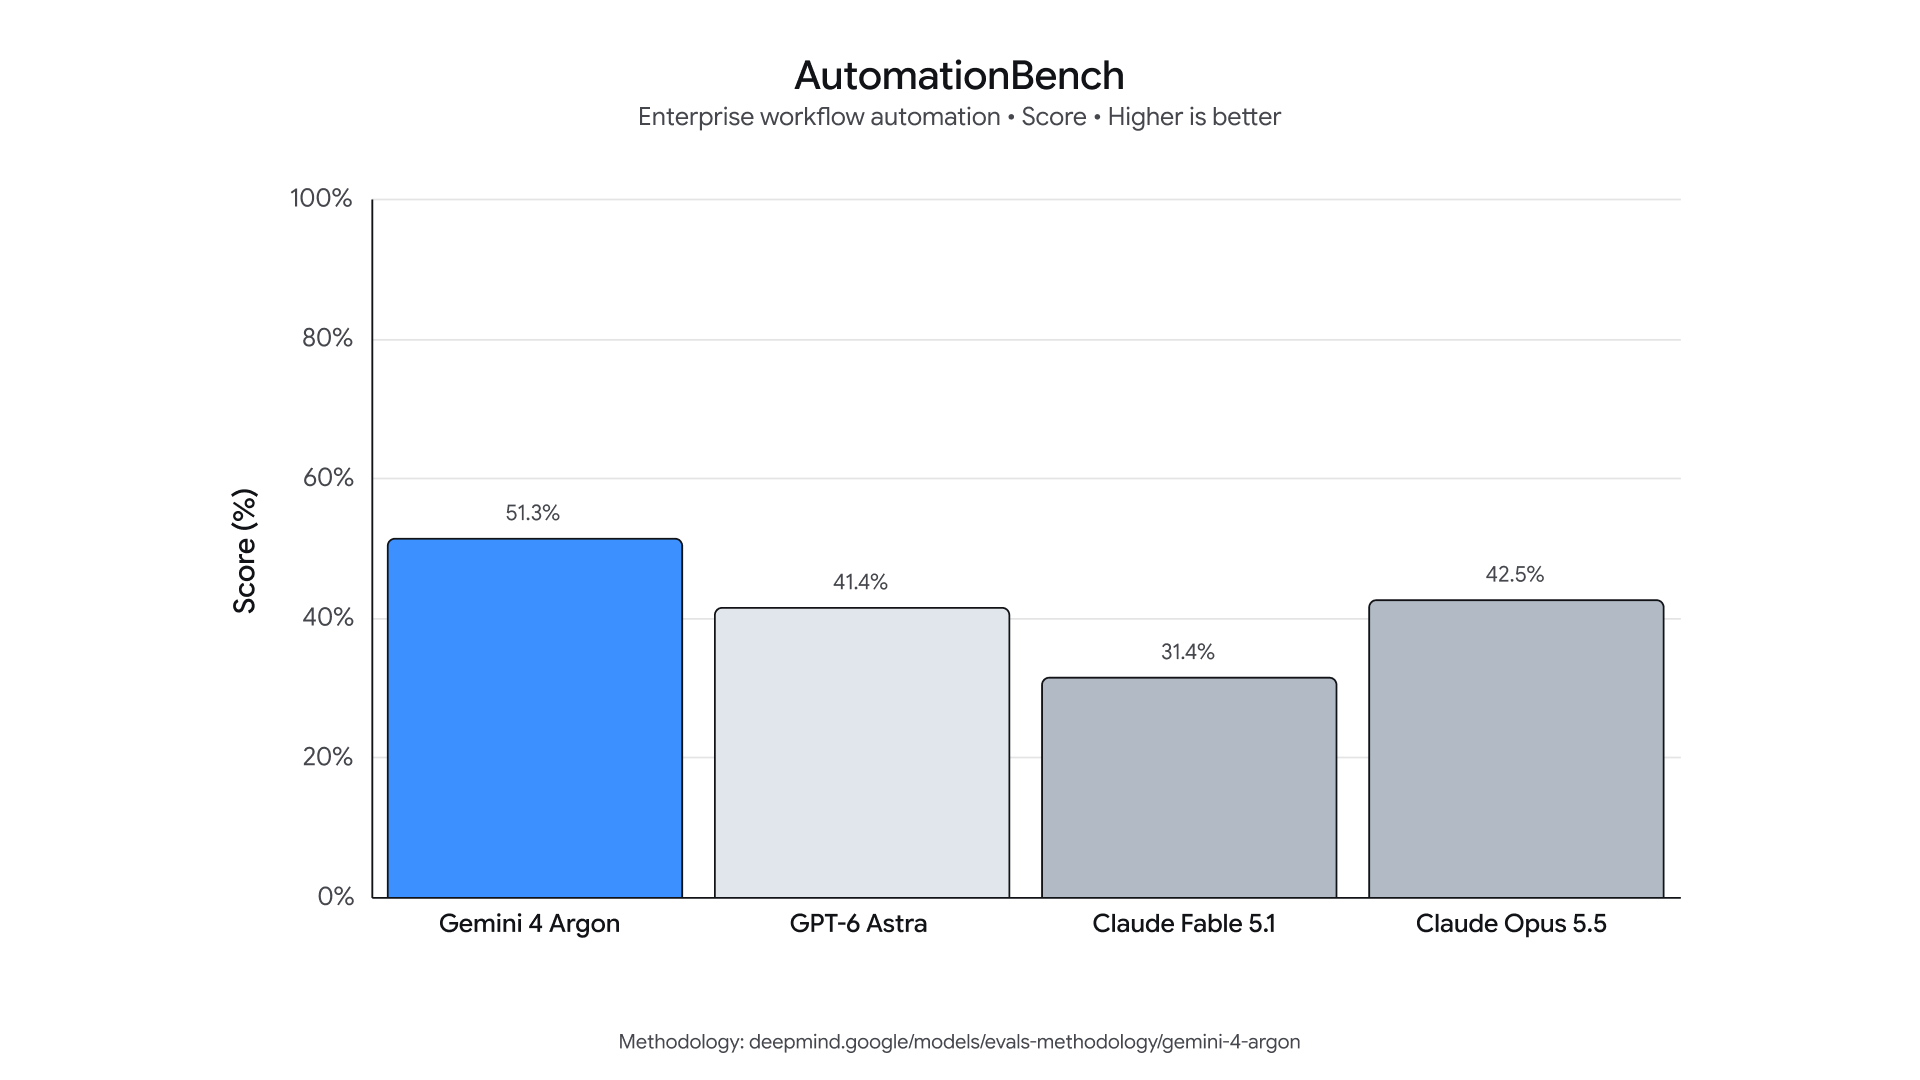
跨领域赋能编码与企业工作流。Gemini 4 Argon 在编码、推理和多模态方面的能力,以及其维持长步骤、多阶段任务的能力,使其能够在一系列企业工作流中脱颖而出。Google 工程师已将 Argon 用于日常任务,从日常调试到大规模代码库迁移和算法设计。它在 DeepSWE v1.1(得分 77.9%)上树立了新的最先进水平,该基准衡量模型在现实世界长周期软件工程任务中的表现。除了编码之外,Argon 在 Vals Index 上也处于领先地位,该指数衡量金融、编码、法律和税务工作的经济影响,每个部门均按其对美国 GDP 的贡献进行加权。在其他特定领域的评估中,我们也看到了同样领先的表现,例如 Vals Finance Agent v2(多步金融研究)和 Harvey 的法律代理基准(法律研究和起草)。在 AutomationBench(Zapier 的基准测试,衡量核心业务功能的端到端执行)上,Argon 以 51.3% 的得分排名第一。当知识工作需要视觉理解时,Argon 也表现出独特的优势。它能够驱动专业的图表分析,从长视频中识别细节,并根据一系列文档采取行动。例如,在衡量长视频理解的 LVBench 上,Argon 以 91.7% 的得分达到最先进水平。
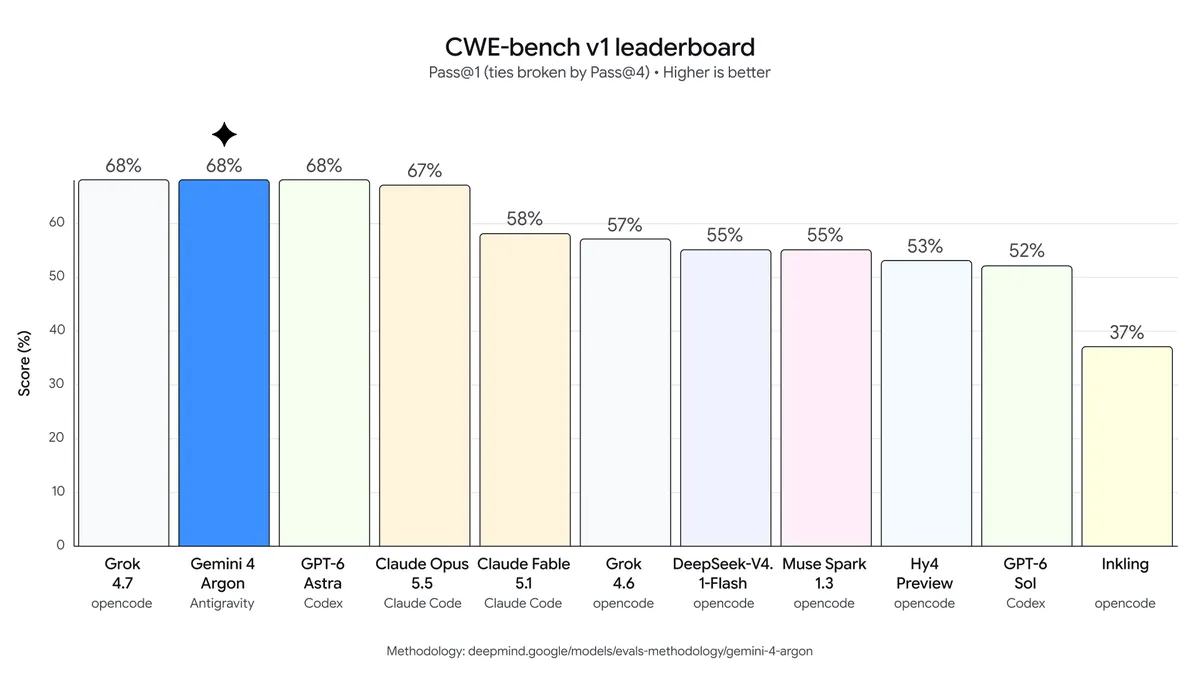
在防御性网络安全领域处于领先地位。为了更好地装备网络防御者应对新时代的网络攻击,我们训练 Gemini 4 Argon 具备强大的网络安全防御能力。Argon 能够自主发现、验证并修补关键软件漏洞。对于受信任的防御者以及 Google 内部团队,我们将发布不带网络安全护栏的 Argon 版本,以便他们利用其全部前沿级别的网络安全防御能力。Wiz 已经通过其“Scan for Good”计划使用 Argon 进行网络安全防御——这是一个致力于通过发现和修复高风险暴露来免费保护关键公共基础设施的项目。在展示其影响力的早期演示中,该模型发现了一个关键漏洞,该漏洞导致全球医院使用的医疗软件中的敏感个人信息面临风险,识别出此前其他前沿模型所忽略的严重威胁。在 CWE-bench v1(评估模型修复安全漏洞能力)上,Argon 以 68% 的最高得分并列第一,这是在 3.8 Flash Cyber 于 CWE-bench v0 上取得的前沿性能基础上的进一步提升。
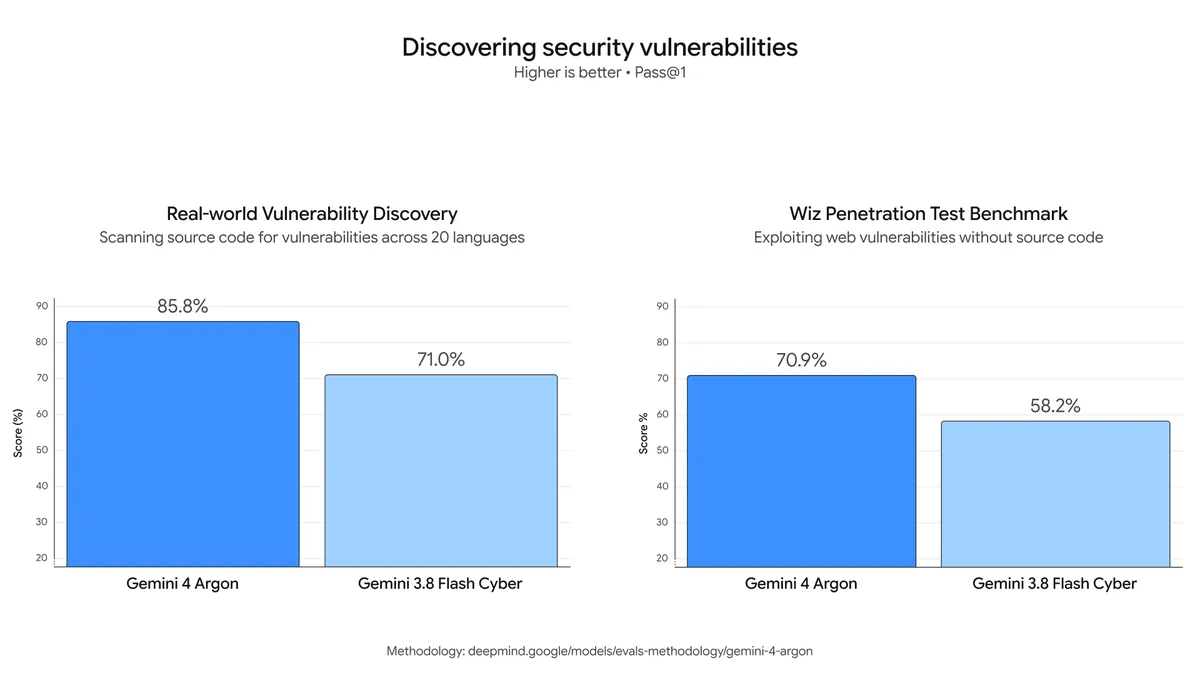
与 3.8 Flash Cyber 相比,Gemini 4 Argon 在漏洞发现方面展现出令人印象深刻的飞跃。例如:在 Google 的内部综合漏洞基准测试中,Argon 发现了跨越 20 种编程语言的复杂代码库中的一系列广泛暴露点。在 Wiz 的内部黑盒渗透测试基准测试中(该测试检验模型在没有源代码的情况下分析实时 Web 系统的能力),Argon 在发现攻击面、识别漏洞以及生成概念验证证据以确认漏洞方面,均优于 3.8 Flash Cyber。
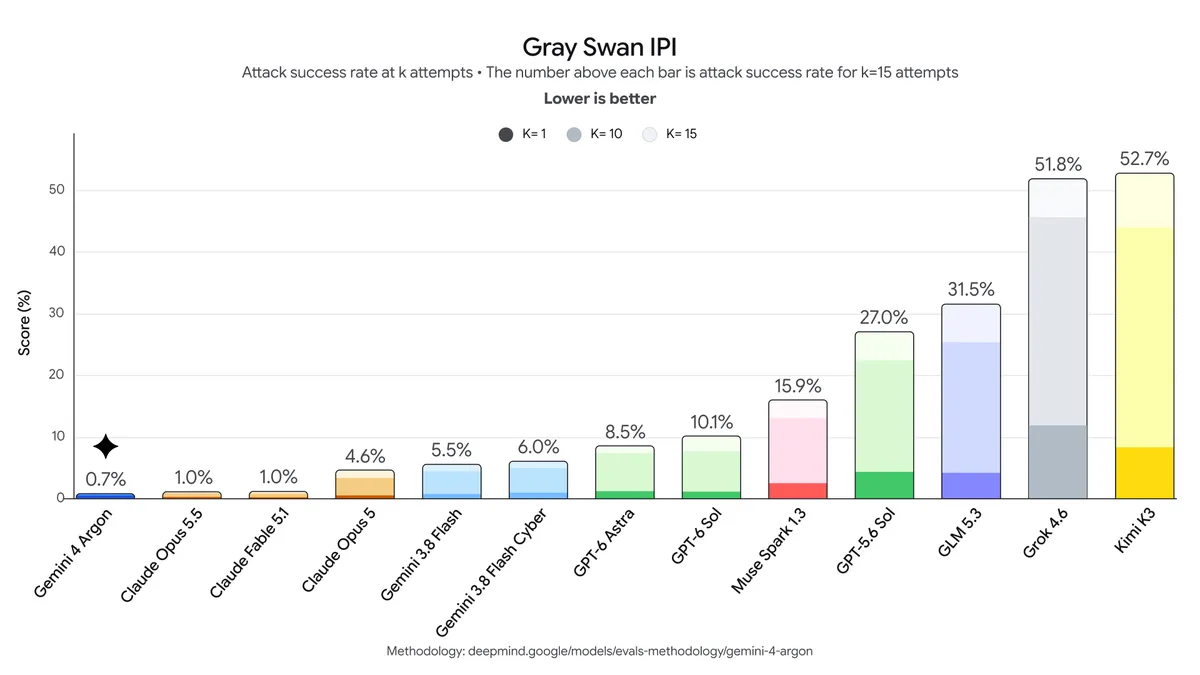
在广泛可用之前加强前沿安全保障在全面推出 Gemini 4 Argon 之前,我们继续加强四个主要领域的前沿关键安全保障:防止滥用:为防止不良行为者利用 Argon 进行网络或化学、生物、放射性和核(CBRN)攻击,该模型旨在拒绝有害请求,同时根据我们的前沿安全框架保留合法的双用途科学研究。我们正在加强此次发布的安全保障稳健性,包括改进监控模型内部激活以发现滥用的技术。这些保障措施已通过内部和外部红队使用手动和自动攻击方法的组合进行了稳健性测试。防止提示注入攻击:Argon 也是我们对间接提示注入最具韧性的模型,此类攻击中恶意指令或上下文被用来劫持模型行为。这些是复杂的攻击,需要持续的警惕和多层次的防御。通过自动化红队和对抗性训练,Gemini 4 Argon 在 Gray Swan 的间接提示注入(IPI)基准测试中处于提示注入稳健性的领先地位。
监控对齐偏差:为了防止 Argon 越界尝试以超出用户意图的方式完成任务,我们部署了对齐缓解措施,监控 Argon 的思维链和行动,并在必要时停止执行。我们使用了类似的系统来监控我们的训练过程,并向专门的应急响应团队发送警报,谨慎采取措施防止将调查结果反馈到训练中,以免冒险塑造 Argon 的推理能力以规避我们的监控。我们强烈鼓励行业其他参与者在能力增强这一关键时刻保持推理透明度,同时在应对对齐风险时确保模型思维有助于识别和对齐偏差。加固系统:随着前沿模型能力不断增强,对其安全测试需要能够跟上系统本身发展的安全环境。按照我们的智能体控制路线图,我们在高风险训练或评估开始之前,通过隔离和密封来加固沙箱环境。我们致力于与合作伙伴分享这些智能体安全最佳实践,以提高整个生态系统的安全性。
即将推出我们构建了具备前沿级能力的 Gemini 4 Argon,涵盖编码、知识工作、网络安全防御和创意写作,旨在成为开发者、专业人士和企业解决最困难问题的合作伙伴。我们感谢首批网络防御者和受信任测试人员的真实世界评估和反馈,这将帮助我们在向开发者、企业和消费者发布前强化我们的系统,首先面向付费 API 客户和 Google AI Ultra 订阅用户。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。