精选Together AI新闻
ThunderKittens 移植到 NVIDIA Vera Rubin NVL72
ThunderKittens 团队将其内核库移植到 NVIDIA Vera Rubin NVL72,并围绕新硬件重写 NVFP4 GEMM,性能从 roofline 的 42% 提升到超过 22 PFLOPS,与 cuBLAS 和 CuTe DSL 相当。文章还介绍了 ISA 的变化及适配方式。
Together 的内核团队最近获得了 NVIDIA Vera Rubin NVL72 平台的访问权限。过去几天里,我们深入研究了新的 ISA,并用微基准测试对芯片进行了各种试探。其中有许多有趣的新特性!我们已完成向 ThunderKittens 添加部分功能,使其能够在 Vera Rubin 上编写 NVFP4 和 FP8 GEMM,同时也帮助其他小猫探索星辰大海。

在深入探讨 Vera Rubin 带来了什么之前,我们先快速回顾一下 Blackwell GPU GEMM,以此作为旅程的起点。
起点:NVIDIA HGX B200 GEMM
NVIDIA Blackwell 架构的第五代张量核心从根本上改变了 GEMM 的编程模型。NVIDIA Hopper 架构的 wgmma 指令由 warpgroup 集体发出,而 Blackwell 的 tcgen05 指令由单个线程发出,使得一个小型生产者 warp 就能驱动张量核心。累加器也从寄存器移到了 Tensor Memory 中,操作数直接从共享内存读取,使得单次 MMA 可以跨越两个 SM 上的两个 CTA。
- 启动线程块集群,使每对 CTA 可以通过 TMA 多播共享操作数,将 HBM 的内存流量减半。
- 在集群内对 warp 进行专业化分工:加载器通过 TMA 将 A 和 B 带入共享内存,单个 MMA warp 驱动张量核心,消费者 warpgroup 将完成的累加器从 tensor memory 搬运到 HBM。
- 持久化运行,一个 tile 的输入还在流入时,前一个 tile 的输出仍在排出。
通过这些努力,我们取得了以下结果。
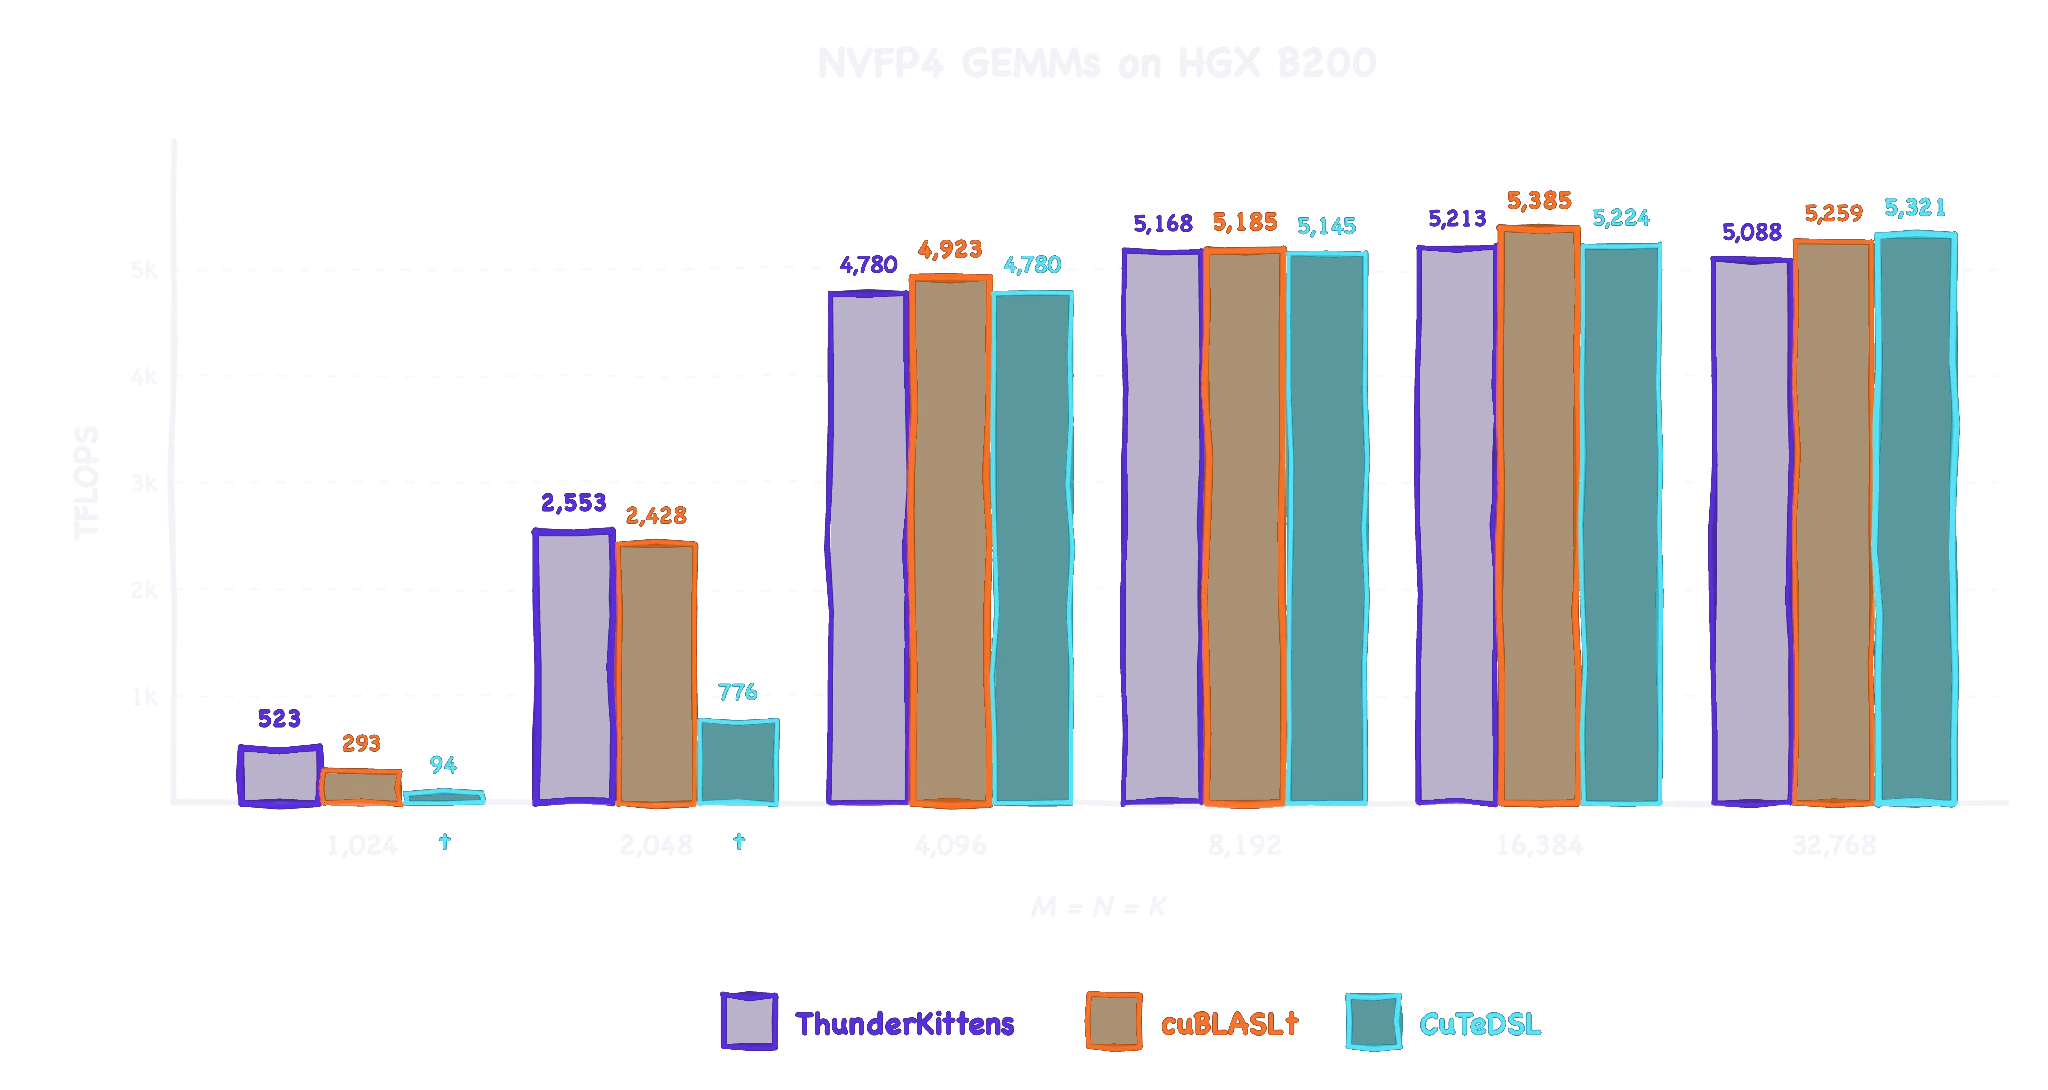
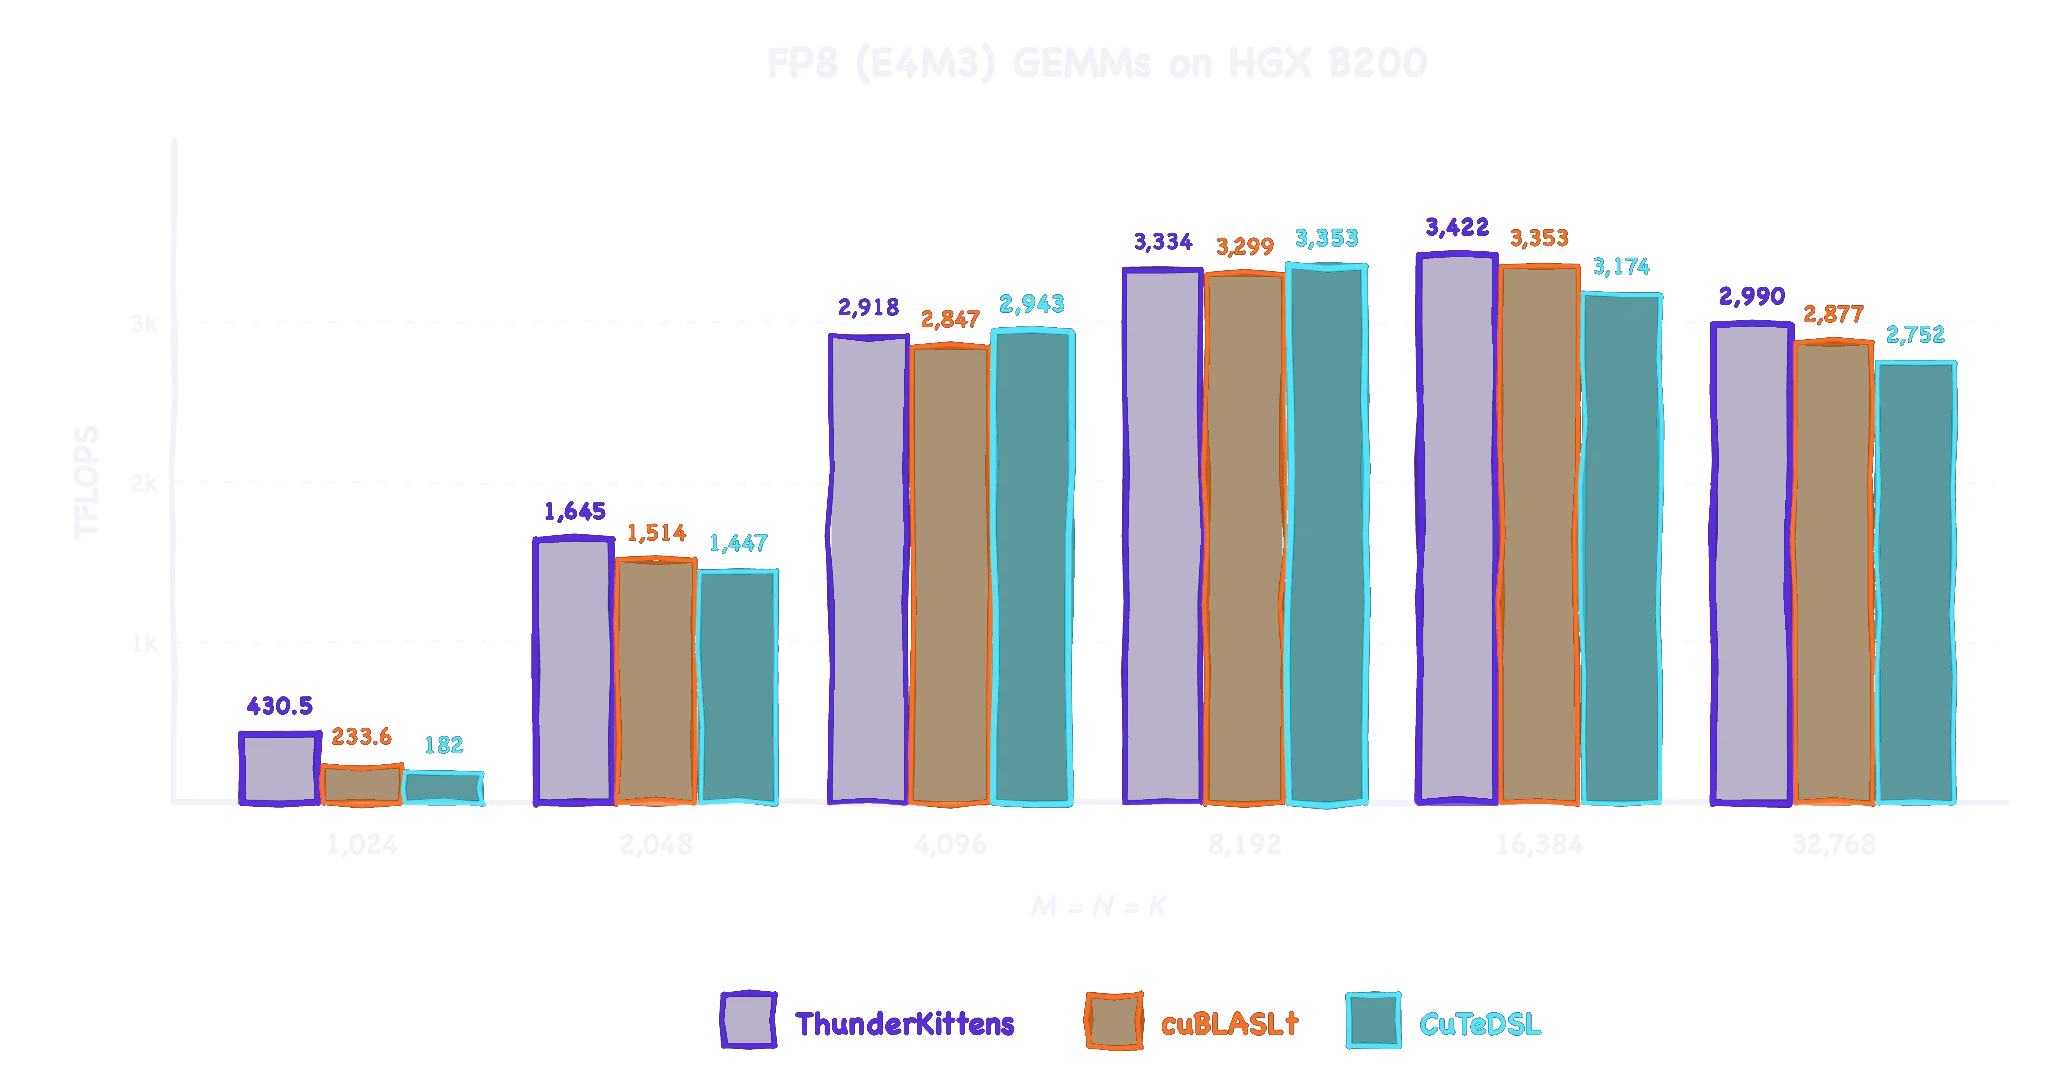
更多关于这些内核及其优化的内容,请阅读我们之前的 Together 博客文章或 ThunderKittens 2.0 发布说明!
由于 Rubin 保留了 Blackwell 的编程模型,我们的旧 GEMM 仍然可以运行。然而,在 Vera Rubin 上朴素地运行它们时,我们观察到 NVFP4 和 FP8 内核分别只达到了 roofline 的约 42.1% 和 44.4%——还有很大的优化空间!
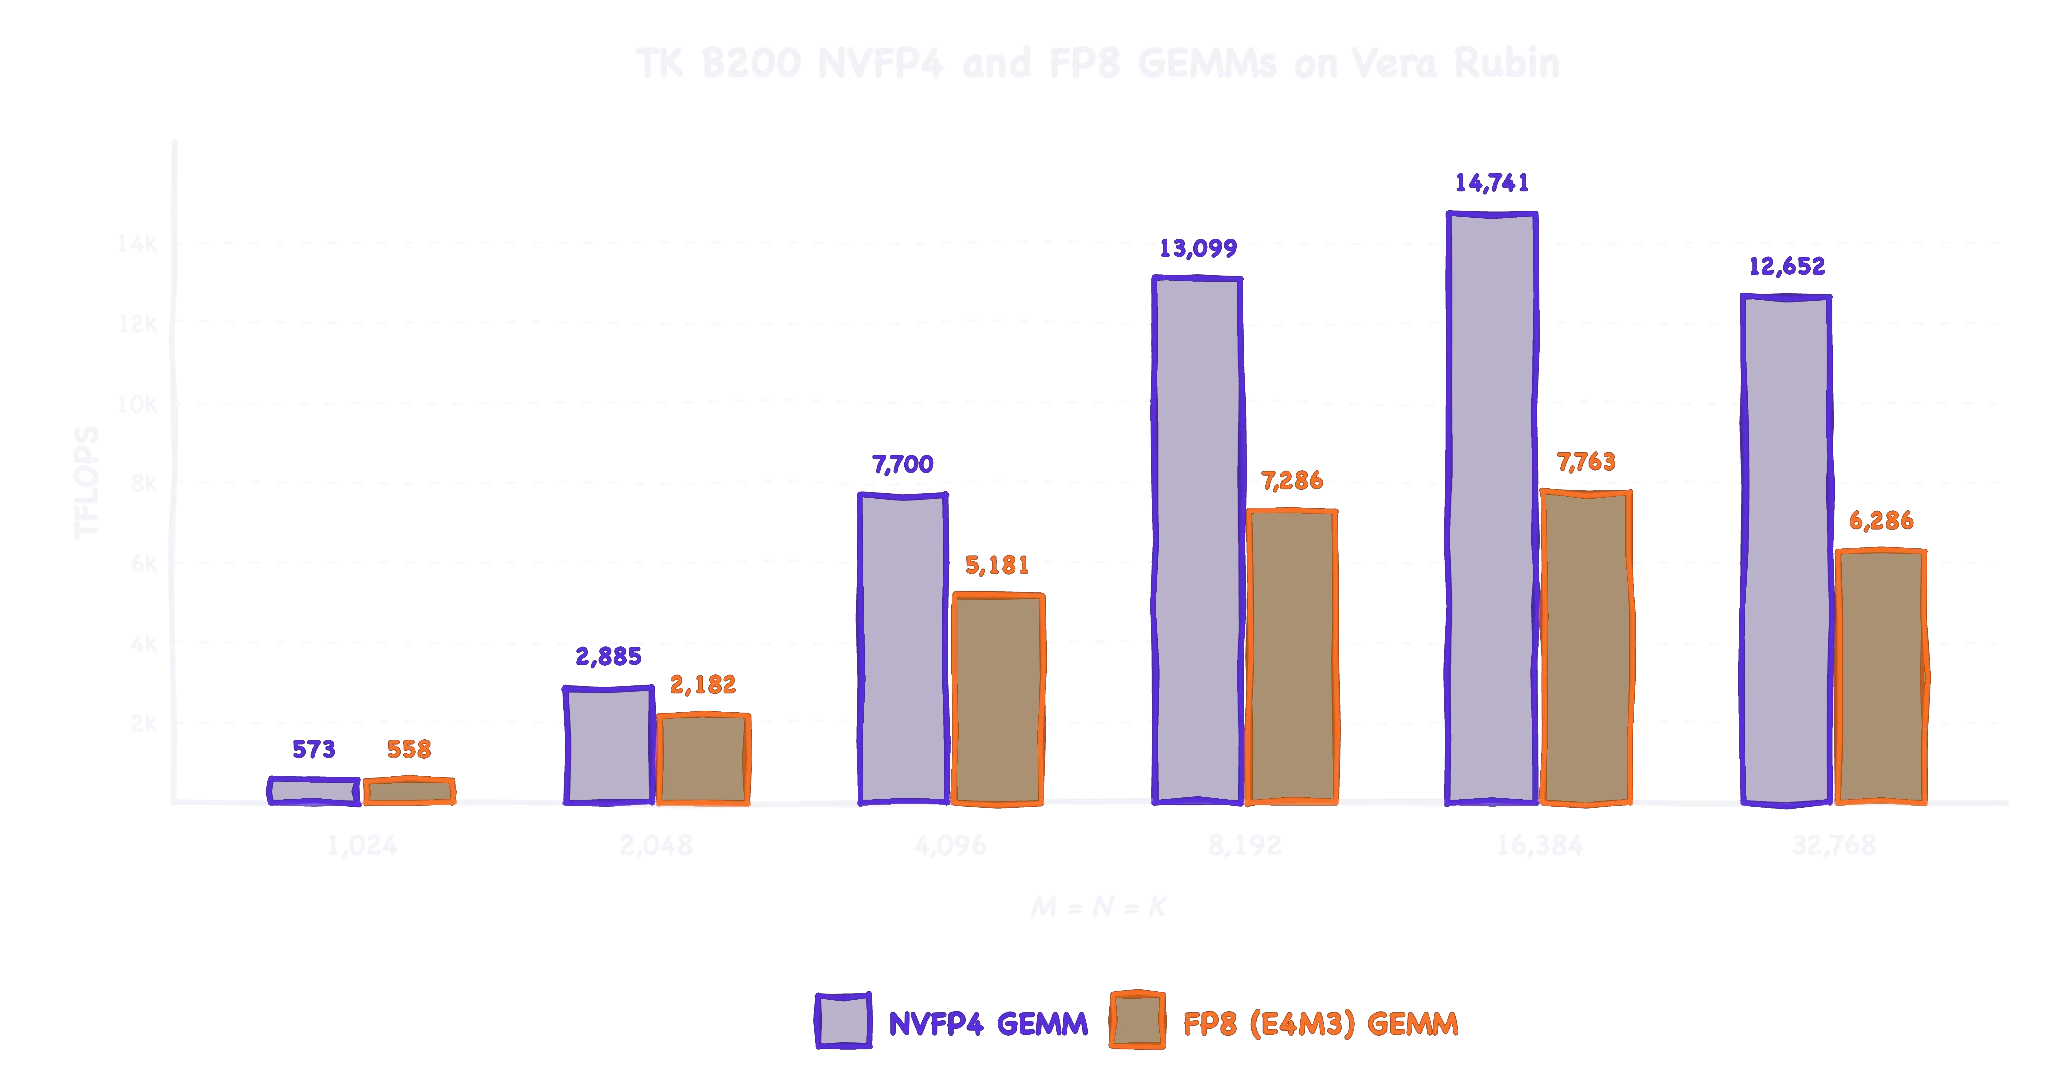
本文剩余部分分为两部分。首先,我们介绍对 GEMM 重要的 Rubin 新特性,以及如何在 ThunderKittens 中使用它们。然后,我们逐步将这些特性集成到现有的 Blackwell NVFP4 内核中,将其提升到超过 22 PFLOPS,并与 cuBLAS 和 CuTE DSL 竞争。
我们发现的核心问题是:虽然 Rubin 使张量核心消耗操作数的速度翻倍,但我们旧的 Blackwell 内核供给数据的速度不够快。要达到计算上限,我们需要让 tile 从已在芯片上的数据中榨取更多复用。
NVIDIA Vera Rubin 平台有什么新东西?
对比厂商规格,我们看到从 Blackwell 到 Vera Rubin 的以下改进。
| NVIDIA HGX B200 | NVIDIA Vera Rubin NVL72 | |
|---|---|---|
| NVFP4 张量核心 | 9 PFLOPS / GPU | 35 PFLOPS / GPU |
| FP8 张量核心 | 4.5 PFLOPS / GPU | 17.5 PFLOPS / GPU |
| FP16 / BF16 张量核心 | 2.25 PFLOPS / GPU | 4 PFLOPS / GPU |
| 内存带宽 | 8 TB/s / GPU | 22 TB/s / GPU |
| SM 数量 | 148 / GPU | 224 / GPU |
| 峰值功耗 | 1000W / GPU | 2300W / GPU |
就编写高性能 GEMM 而言,我们特别注意到以下特性。
- 张量核心的 K 步长翻倍
回顾一下,tcgen05.mma 在 MxNxK 的 tile 上计算 C = A@B + C,每一步沿 K 消耗固定数量的字节。在 Blackwell 上,这个步长为 32 字节,但在 Vera Rubin 上可以增加到 64 字节。MMA 本身仍然需要相同的周期数,因此 K 翻倍使我们能够在相同的指令窗口内打包两倍的工作量。

在 ThunderKittens 中,我们通过为现有的 mma 操作添加一个新的模板参数来表达这一点。
mma_ABt    (...);   // Blackwell 默认:32 字节 K 步长
mma_ABt<64>(...); // Vera Rubin:64 字节 K 步长- Tensor memory 增长到 576 列
Blackwell 引入了张量内存的概念,这是一个 128 通道 x 512 列 x 32 位的空间,张量核心可以直接对其进行读写。在 Vera Rubin 上,这个空间增加到 576 列,额外提供了 32 KiB 的张量内存可供使用。
请注意,这些额外的列只能通过 .exclusive 限定符访问,这是 PTX 9.4 新增的特性,确保一个 SM 上只有一个活跃的张量内存分配。非独占分配仍然限制在 512 列,且必须是 2 的幂。
在 ThunderKittens 中,用户可以通过向张量内存分配器传入模板参数来请求这一功能,指定该分配为独占。
template<int _nblocks_per_sm, int _ncta, bool _managed = true, bool _exclusive = false>
struct tensor_allocator { .... }

tensor_allocator<1, C::CLUSTER_SIZE, false> tm; // Blackwell 默认:512 列
tensor_allocator<1, C::CLUSTER_SIZE, false, true> tm; // Rubin:最多 576 列- 共享内存增加到 328 KiB
Hopper 和 Blackwell 提供了 228 KiB 的共享内存,而 Vera Rubin 引入了超大共享内存模式,可以动态增加到 328 KiB。这是一个主机端规范,可以按如下方式调用。
CUfunction function = nullptr;
cudaGetFuncBySymbol(&function,reinterpret_cast(kernel));
cuFuncSetAttribute(function, CU_FUNC_ATTRIBUTE_SHARED_MEMORY_MODE,
CU_SHARED_MEMORY_MODE_ALLOW_OVERSIZED_SHARED_MEMORY);- B 侧收集器
Blackwell 引入了收集器缓冲区的概念,这是一个小型 MMA 暂存缓冲区,可以锁存一个 A 块,使下一条指令从那里获取数据,而不是从共享内存中获取。Vera Rubin 通过 .collector::b::* 将这一功能扩展到了 B 块。

为了利用这一点,我们用四个标签之一来标注每个 MMA 的操作数,描述其对收集器缓冲区的操作。
- “FILL” 从共享内存读取操作数并锁存
- “USE” 从缓冲区读取
- “LASTUSE” 从缓冲区读取并释放
- “DISCARD” 是默认值,跳过锁存
这些标签是复用的权限限定符,而非保证。这意味着即使张量核心有权限复用,它仍然可能重新加载矩阵。
现在任一操作数都可以驻留在收集器缓冲区中,我们可以尝试新的模式。例如,在一个 2x2 块上,两侧都进行收集可以将四次 MMA 的八次操作数读取减少到仅五次。
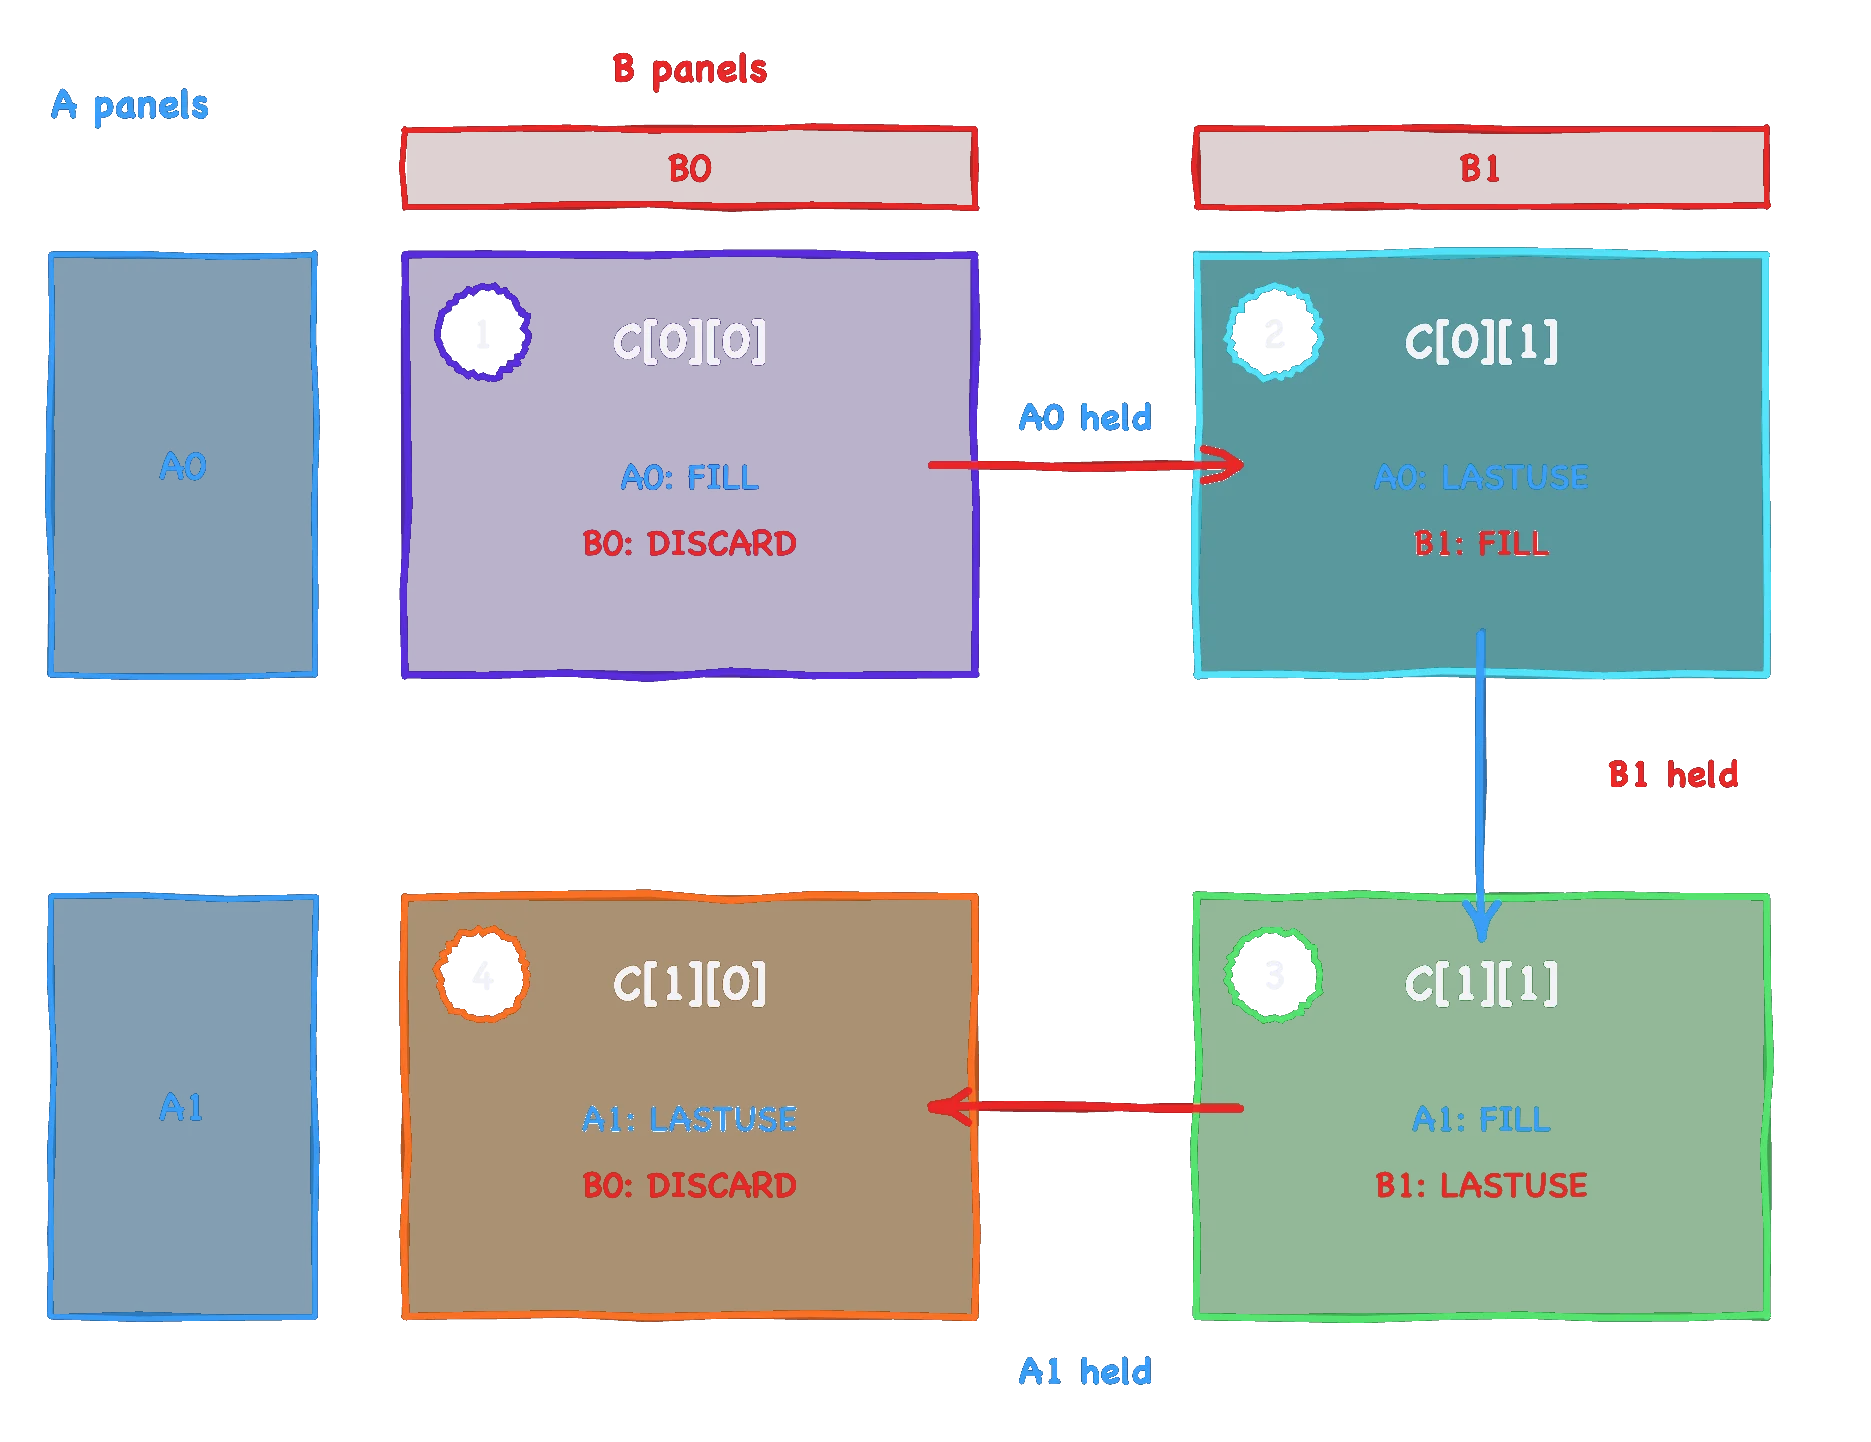
在 ThunderKittens 中,我们可以通过以下方式暴露这一功能。
mma2_ABt_chunk<64, false, false, collector::FILL,collector::DISCARD>(C[0][0], a0, b0, ...);
mma2_ABt_chunk<64, false, false, collector::LASTUSE, collector::FILL   >(C[0][1], a0, b1, ...);
mma2_ABt_chunk<64, false, false, collector::FILL,    collector::LASTUSE>(C[1][1], a1, b1, ...);
mma2_ABt_chunk<64, false, false, collector::LASTUSE, collector::DISCARD>(C[1][0], a1, b0, ...);- A 提前释放
tcgen05.commit 在其处理的 MMA 完成后到达 mbarrier,通知生产者某个阶段槽位可以复用了。PTX 9.4 引入了 tcgen05.commit.sync_restrict::shared::read::mma::a,这是一条新指令,允许我们为 A 块提前发出信号。我们不必等待 MMA 完成,而是可以在 MMA 完成从共享内存读取其 A 操作数后立即触发屏障,从而使我们能够通知 TMA 加载器开始存储下一阶段的内存。

ThunderKittens 引入了一种新的 commit 类型供用户表达这一点。
tensor_commit<2> (inputs_finished[stage], mask); // 在 MMA 退役时到达
tensor_aread_commit<2>(A_finished[slot], mask); // 在 MMA 完成读取 A 时到达
构建 GEMM
我们现在有了新特性和一个 Blackwell GEMM。以下各节将逐步把这些特性集成到我们现有的 Blackwell 内核中,并解释为什么在迈向 Vera Rubin 时需要它们。
扩展指令:
最直观的瓶颈来自仍然依赖 Blackwell 的 32 字节 K 步长。在 Vera Rubin 上,这种编码的 ISA 上限约为 16.8 PFLOPs,而我们的 NVFP4 Blackwell GEMM 已经开箱即达到 14.7 PFLOPs(达到上限的 88%)。要进一步推进,我们必须让 MMA 处理的 K 字节数翻倍。

然而,仅仅为现有的 Blackwell 内核启用更宽的编码,我们注意到性能只有 marginal 提升,而不是预期的 2 倍。虽然更宽的 MMA 使张量核心消耗操作数的速度翻倍,但它无助于我们供应操作数的速度。为了让 double-K 发挥作用,我们拉动两个杠杆来让核心保持满意:移动更少的字节,并加深流水线以确保这些读取被重叠。
读取更少的字节:
为了读取更少的字节,我们在同一对 CTA 上沿 M 维度堆叠第二个输出 tile。由于两个累加器仅在 M 上不同,我们能够为它们共享相同的 B chunk。我们最初的 Blackwell NVFP4 内核采用 1x1 tiling 格式,这意味着覆盖 M512xN256 的输出需要两个 pair 任务,每个任务独立传输自己的 B 副本。通过转向 2x1 格式,我们可以只读取一次 B 并覆盖相同的输出,从而减少操作数流量。
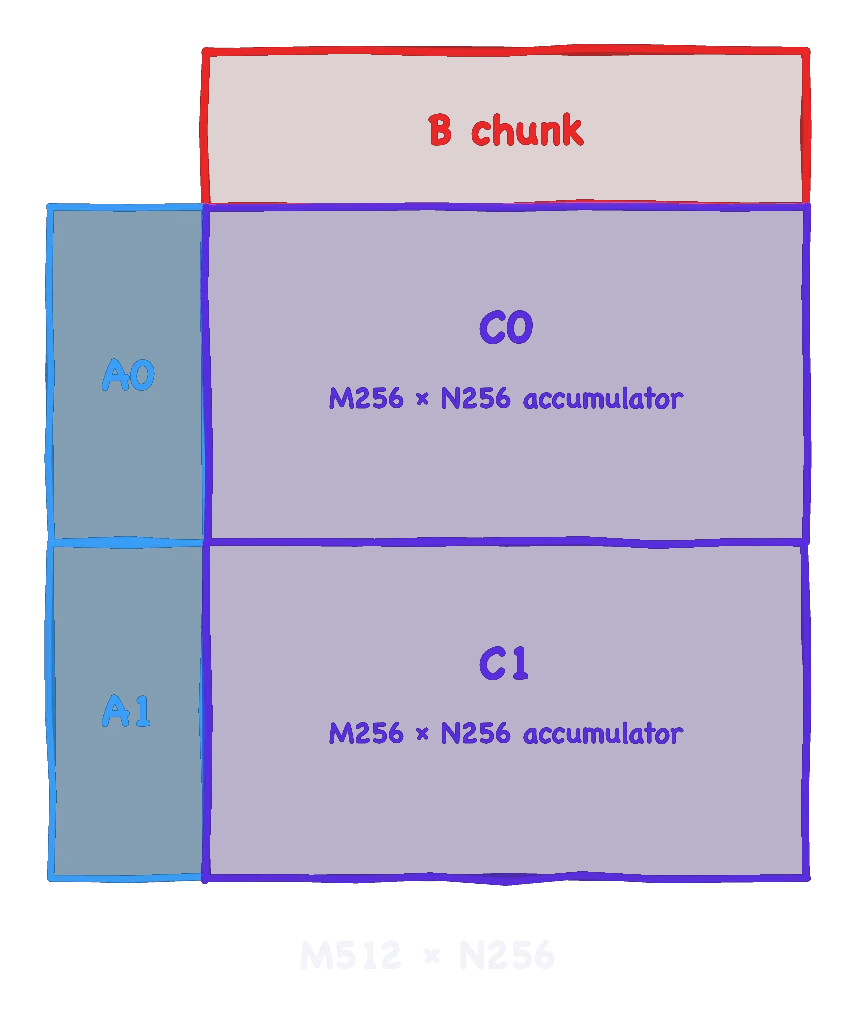
这种 2x1 tiling 格式在我们的 NVFP4 Blackwell 内核中并不容易实现,因为 tensor memory 上限为 256 KiB。两个 M256xN256 累加器已经占用 512 列,这意味着 block-scaled MMA 没有空间存储它们的 A 和 B scales。虽然程序员可以通过让 epilogue warps 仅加载累加器列的子集,然后发出 MMA-empty 状态信号,从而允许下一个 K tile 的 MMA 开始,来绕过这一限制,但这引入了少量无法隐藏的延迟。幸运的是,借助 Vera Rubin 额外的 64 列,我们可以存储缩放因子,而无需进行这种舞蹈。

加深流水线:
改变的 tiling 格式减少了操作数流量,但无助于减少每次读取所需的时间。下一个挑战是让张量核心持续得到供给。Vera Rubin 更大的共享内存允许我们创建更深的流水线,提前暂存更多 tile,并给传输更多时间来完成。对我们的 NVFP4 和 FP8、16k 方形 GEMM 进行 ring depths 扫描,我们看到以下结果。
NVFP4 16k 方形 GEMM:
| # Smem Tile Stages | Required Shared Memory | Achieved TFLOPS |
|---|---|---|
| 3 | 202 KiB | 17,054 |
| 4 | 258 KiB | 20,595 |
| 5 | 314 KiB | 22,239 |
| Config | Required Shared Memory | Achieved TFLOPS |
|---|---|---|
| 4 | 209 KiB | 10,895 |
| 5 | 257 KiB | 11,995 |
| 6 | 305 KiB | 11,288 |
虽然最大的增益似乎来自这最后一个 peg,但我们注意到这些增益依赖于我们之前的优化。以下是独立扫描 K 步长、共享内存流水线和 tiling 策略的结果。
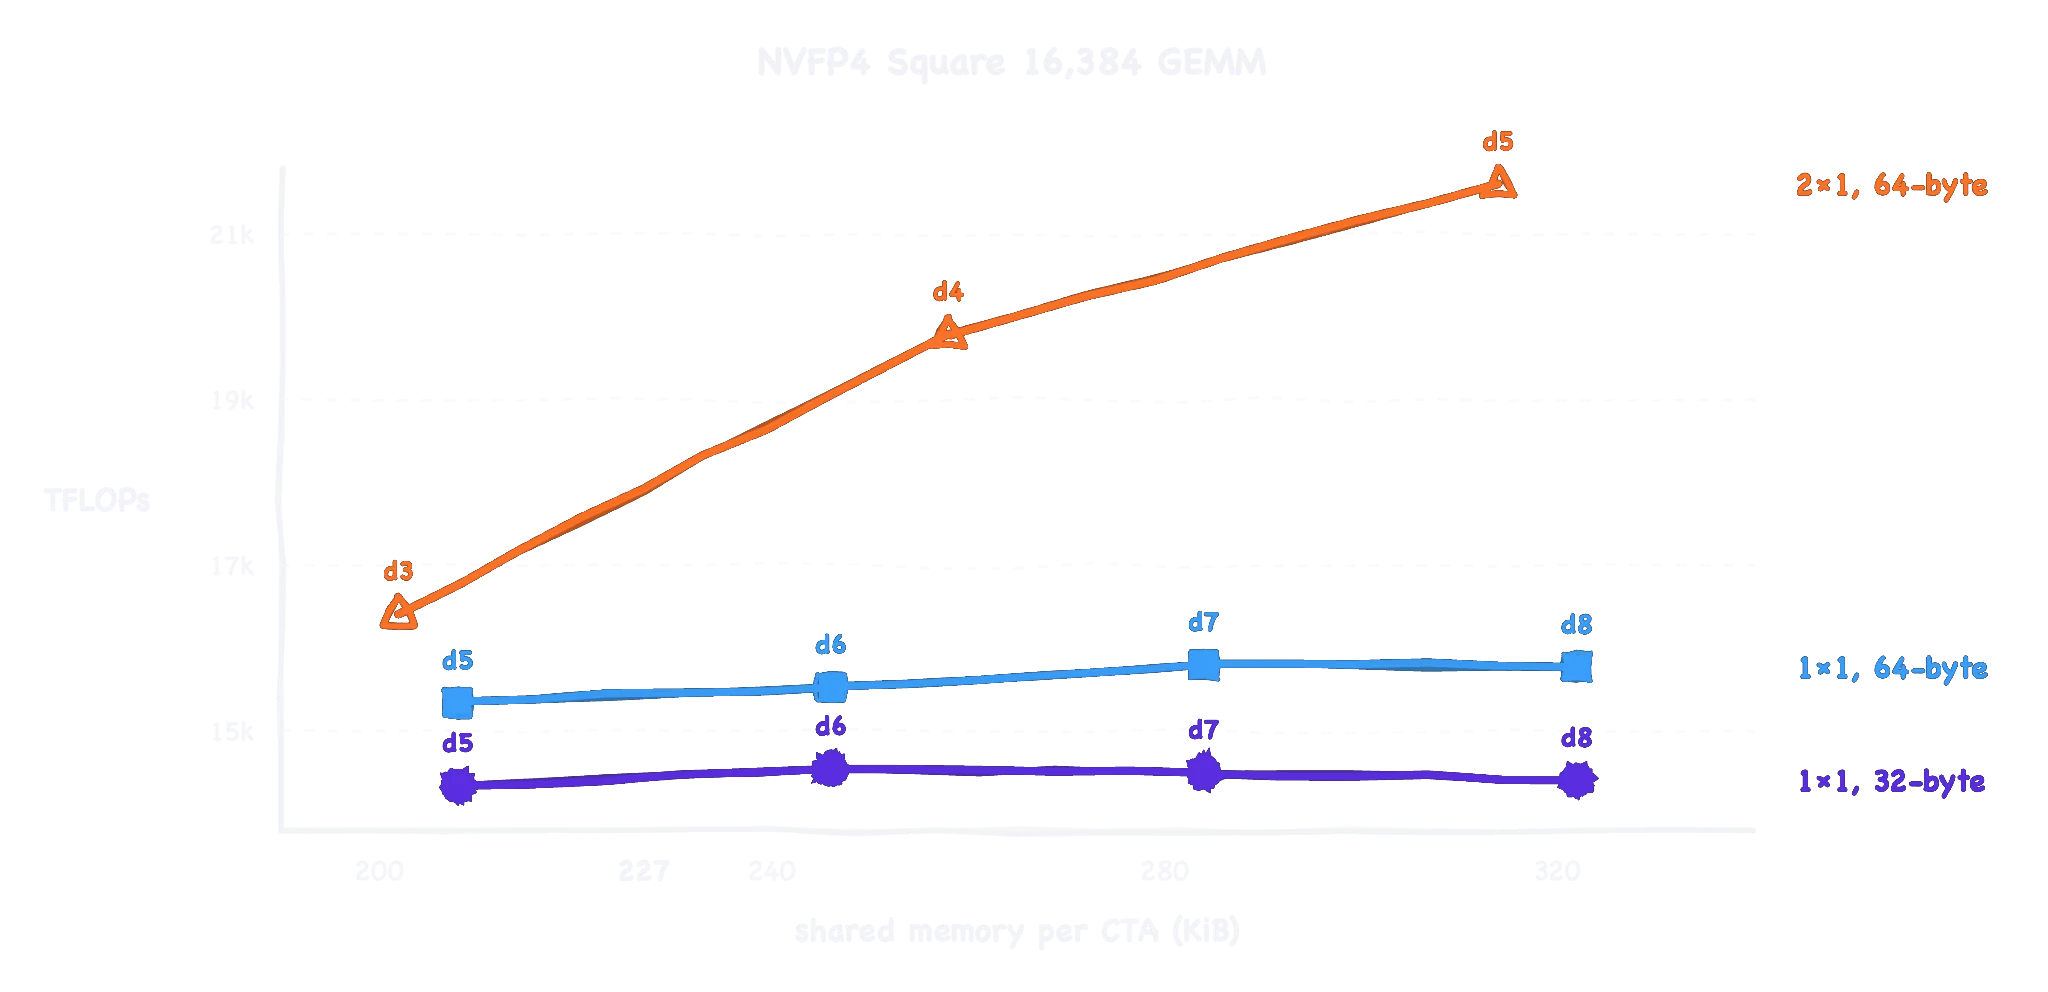
最后润色:
- 内核配置调优:我们进一步针对不同工作负载调优内核,以实现最大性能。关于 CTA 对大小,我们发现 Blackwell 内核原有的 1x1 tile 格式在较小的方形工作负载上性能最佳。对于更大的形状,我们采用 2x1 CTA 对分块,并使用经过调优的 2、4 或 8 个 CTA 的 cluster 大小。此外,在所有形状上,我们都会对 tile 光栅化顺序进行排列,以改善内存局部性和性能。
- B 侧收集器:由于我们采用 2x1 分块格式,我们可以利用 B 侧收集器。通过在一个 MMA 上指定“FILL”,在下一个 MMA 上指定“LASTUSE”,我们可以将 B 的读取次数从两次减少到仅一次。我们测得这大约有 1-3% 的提升。
- 利用 sync_restrict::shared::read::mma::a:对于更大的 64k 和 128k 方形 NVFP4 GEMM,我们观察到提前释放 A 分别带来了 13.5% 和 22.1% 的加速。我们发现这条指令在较大尺寸下很有用,此时 A tile 会与其他资源竞争驻留,导致其行在重用之间被驱逐,并迫使加载器等待它们。这使我们随后能够实现提前重用 A 所带来的收益。在较小尺寸下,A tile 从不离开 L2,这意味着读取已经足够快,无需提前释放 A。为了利用这条指令,我们修改了传统的环形顺序逻辑。在普通 GEMM 中,A 和 B tile 属于同一个环,并在单个 commit 下同步运行。然而,为了让提前释放 A 生效,我们需要解耦这两个 tile,使 A 的加载能够独立运行。提前释放 A 需要在更早的信号上释放 A 的槽位,因此我们给 A 分配了自己的环以及自己的 arrived/finished 屏障对。
- L2 驱逐提示:我们用 EVICT_LAST 标记 A 操作数,以鼓励 L2 驻留,供后续重用它们的作业使用。重用收益来自跨作业,而非 cluster 内,并能带来几个千分之一百分点的帮助。
结果:
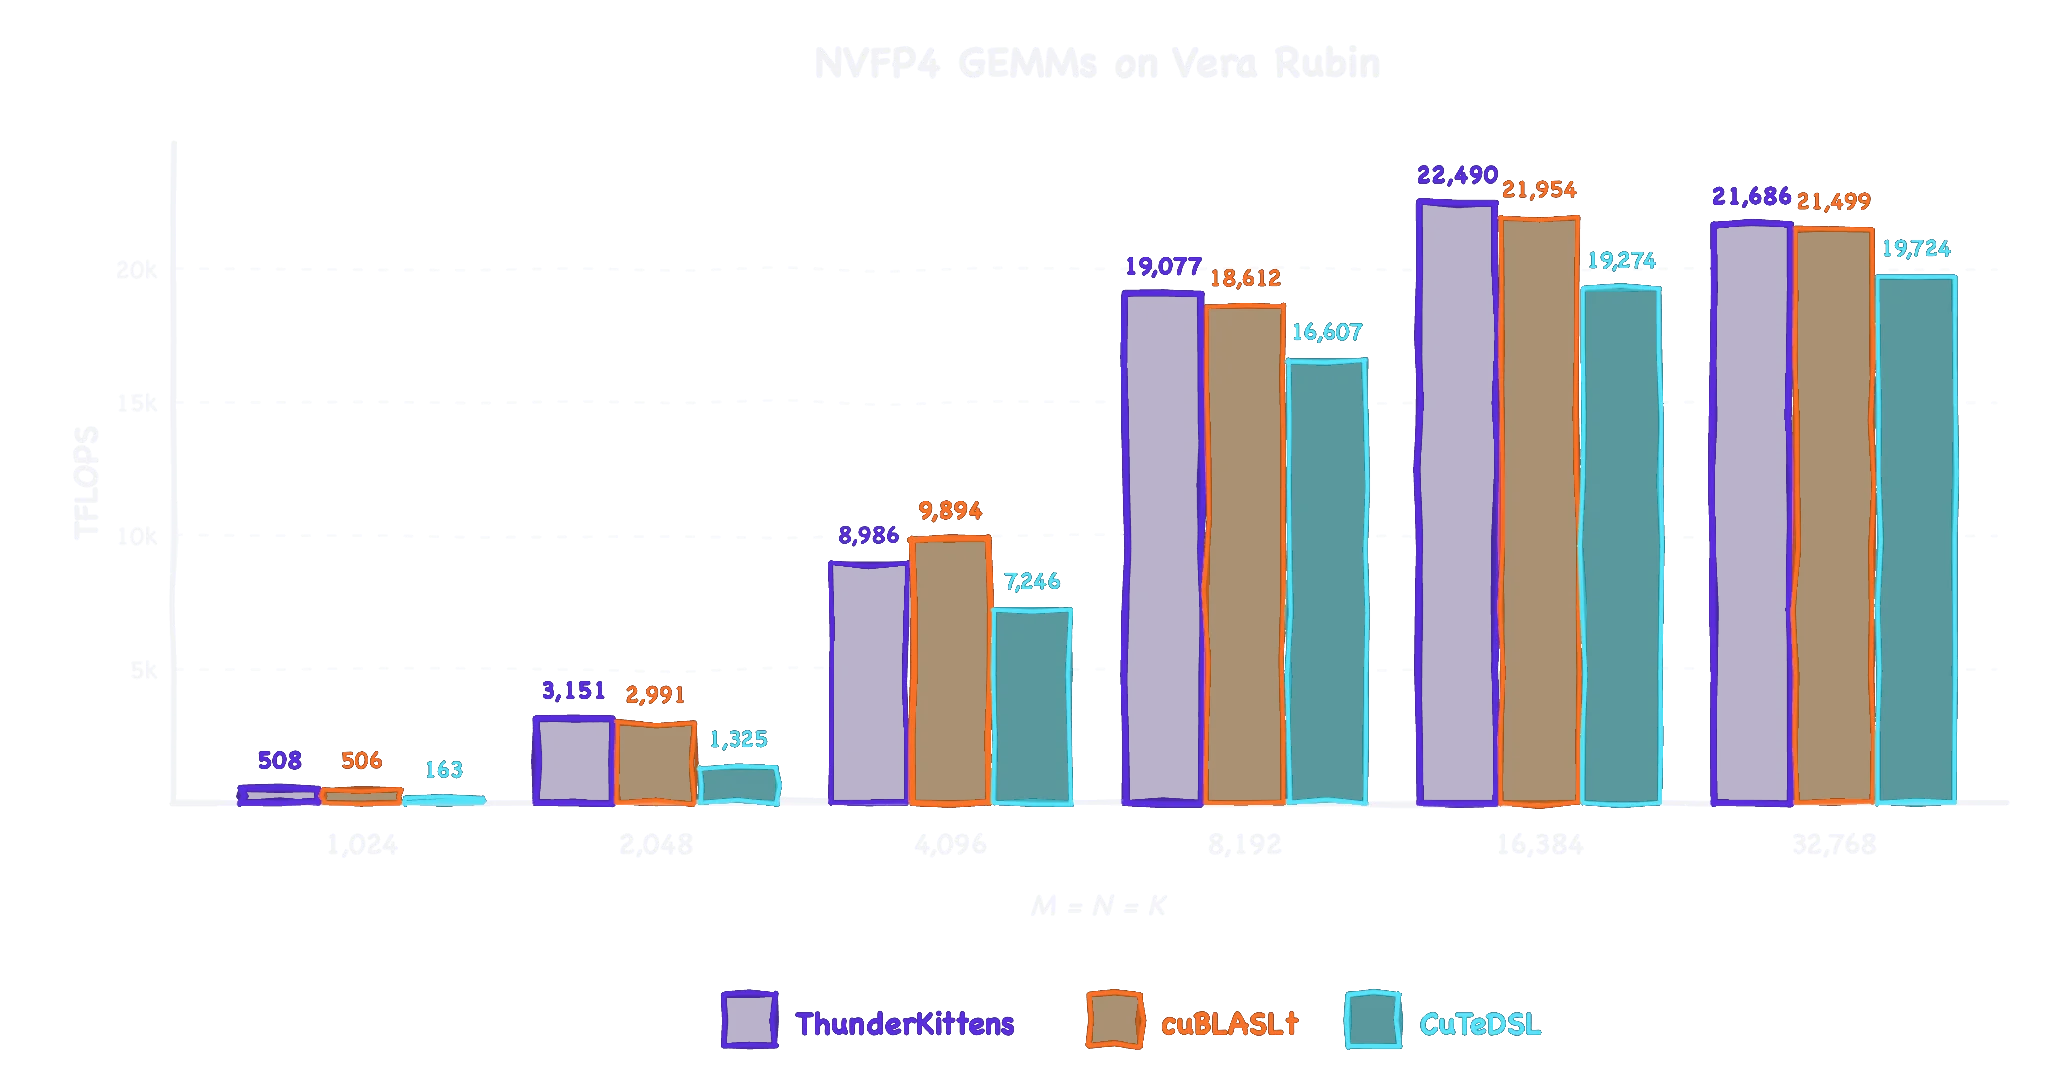
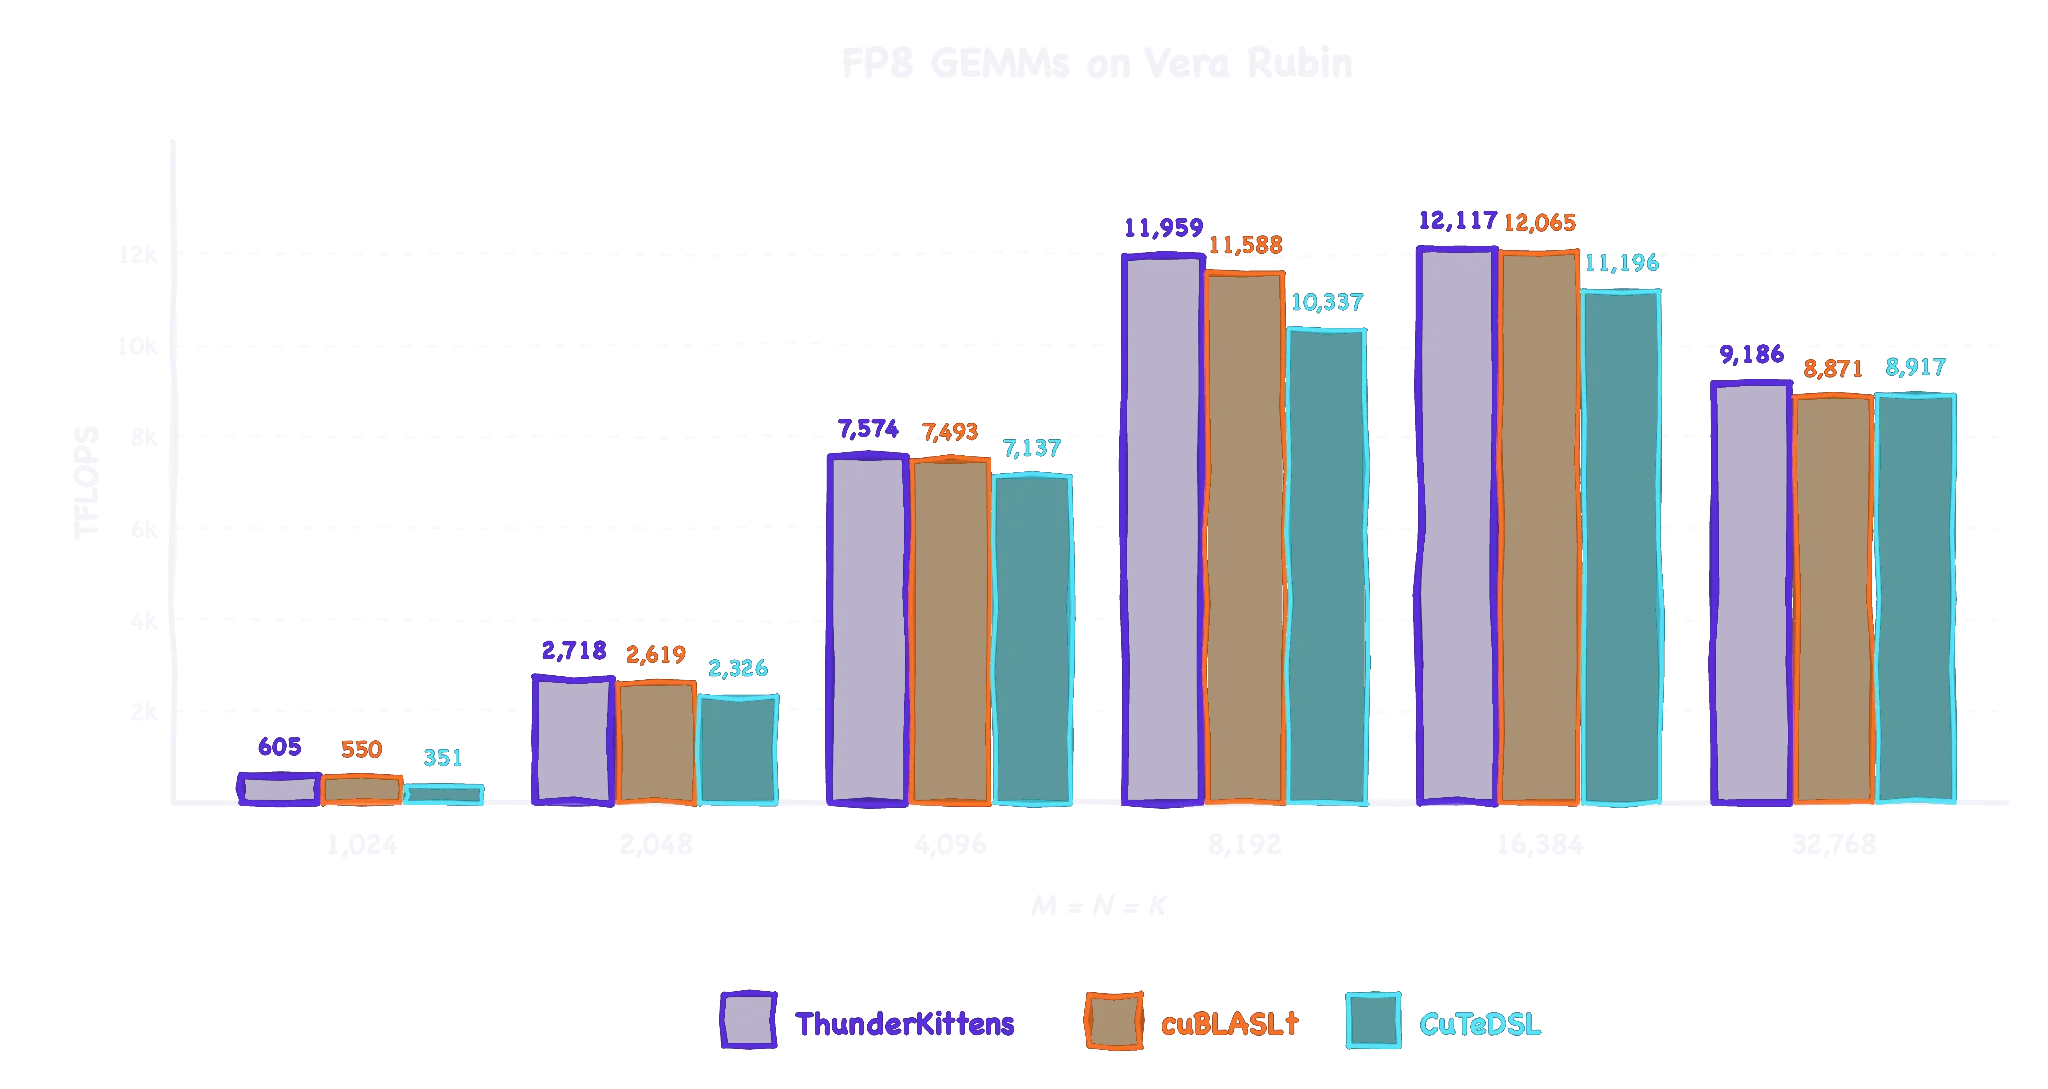
我们注意到,上述所有测量均是在 Qualification Sample(QS)GPU 上使用 NVIDIA CUDA 13.4 生成的。我们预计,随着 Vera Rubin 软件版本的发布,所有基线的性能将继续提升。
结论:
我们希望其中一些内容对您有所帮助,并且我们很期待大家很快开始试用它们。从 LUT GEMM、硬件原生 megakernel 到新的引擎优化,仍有大量有趣的片段可以分享。更多内容即将推出!
Together AI 的内核和性能团队正在积极招聘!如果您想进一步了解这些内核,或与我们一起开发下一组更新,请联系 Simran 或 Dan!
- Simran: simran@together.ai
- Dan: danfu@together.ai
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。