精选SemiAnalysis短讯
ClusterMAX 3.0:行业标准的 GPU 云评级系统回归
ClusterMAX 3.0 评测体系发布,从可靠性、性能、支持、定价及安全等维度对全球 GPU 云服务提供商进行深度分析。
细节详尽:可靠性、性能、支持、定价——当然还有安全性——在我们对全球 GPU 云服务提供商最全面的分析中。
自我们上次发布 ClusterMAX 以来,短短 8 个月内,那些垂涎欲滴的投资者几乎已经掏空了口袋里的支票。GPU 供应已降至零。与此同时,我们一直在辛勤工作,对集群进行严苛的压力测试。
几周前,我们通过分享一些来自我们对新兴云(neoclouds)安全实践调查经历的 R 级轶事,预告了这份报告,并引发了一位你可能听说过的新兴云客户的公共警告声明(PSA)。

今天,我们终于全面展示了我们测试的深度和广度,ClusterMAX 3.0 比以往任何时候都更加 thorough。这包括计算、网络、存储、编排、用户界面、监控、支持以及你能想到的任何关于 GPU 云的检查项。我们将解释谁正在达成交易,谁的工程师在努力工作,以及哪些集群你需要谈判附带一瓶阿司匹林才能使用。
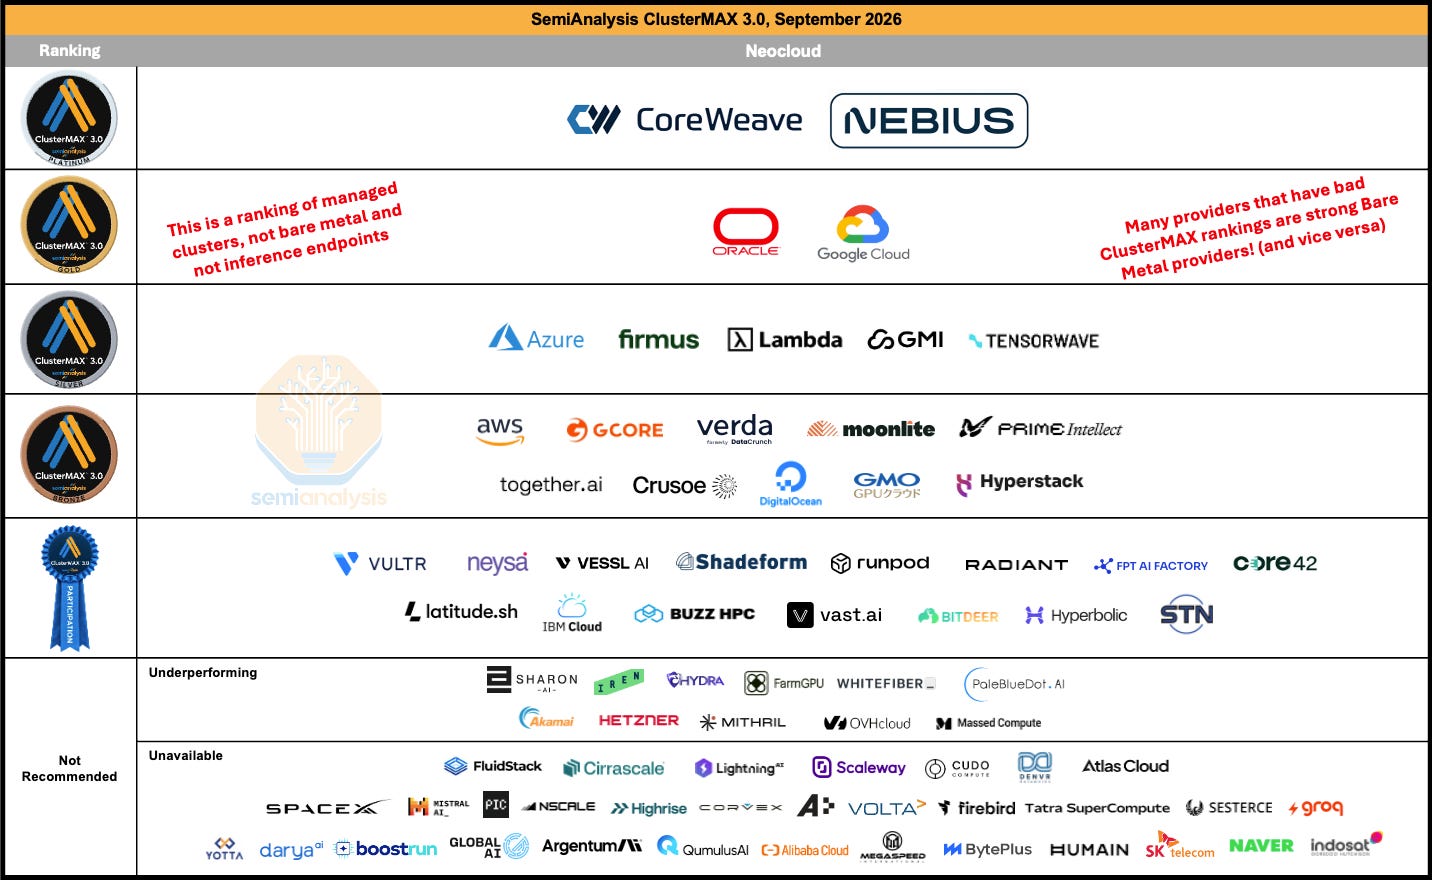
闲话少说,以下是 ClusterMAX 3.0 的领奖台:
YouTube 总结视频和播客讨论即将推出!
- ClusterMAX 3.0 首次亮相,对新兴云行业进行全面审查,涵盖 77 家提供商。
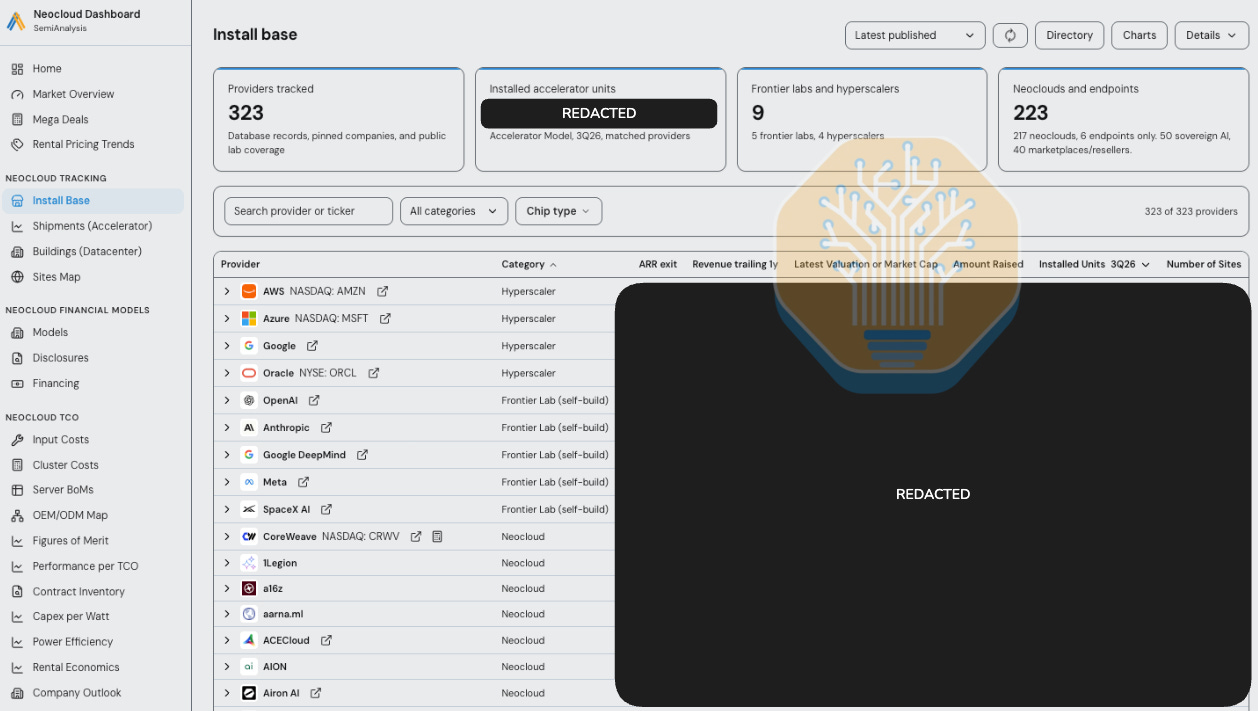
- 我们将市场视野扩大到涵盖 323 家提供商,高于 ClusterMAX 2.0 中的 209 家、ClusterMAX 1.0 中的 169 家,以及最初的《AI 新兴云手册》和《解剖学》文章中的 124 家。
- 作为本研究的一部分,我们现在采访了超过 200 位新兴云终端用户。
- 我们更新了跨 10 个类别的详细标准列表,并更新了我们针对 Slurm、Kubernetes、独立机器、监控仪表板和健康检查的预期直接描述。所有这些内容均已上线我们的网站。我们鼓励提供商在开发其产品时使用这些列表。我们仍然认为这些列表是我们采访终端用户经验的综合,使其代表了终端用户对其云服务提供商所期望的功能。
- Nebius 加入 CoreWeave 所在的白金层级。虽然 CoreWeave 仍然为其他厂商树立了技术标杆,但 Nebius 现已确立为一家始终能向其他厂商收取溢价的服务商。Nebius 强有力的商业决策使其能够以卖方价格服务于整个一类的新兴实验室(neolabs)。
- Google Cloud 加入 Oracle 所在的黄金层级。Azure 降级至银牌,Fluidstack 变为不可用,Crusoe 降级至铜牌。Lambda、Firmus 和 TensorWave 仍保持在银牌,而 GMI 从铜牌升至银牌。
- 许多公司从银牌(或金牌)降级至铜牌或更低。本轮我们提高了门槛,因为全球仅有 19 家新兴云获得奖牌评级。
- 我们在铜牌和表现不佳之间设立了一个层级:参与丝带层级(Participation Ribbon tier)。15 家提供商加入此评级,这更准确地描述了我们的观点,即它们仅做最低限度的工作以维持运营。
本文其余部分提供了关键趋势的分析:融资、Blackwell 和 Grace-Blackwell 部署、转向 Vera Rubin、扩展网络、可靠性、安全性(当然),以及代理式编码(Agentic Coding)。我们在附录中提供了关于每家提供商的单独评论,这再次使本文篇幅超过 30,000 字。希望您喜欢阅读。
鉴于 SemiAnalysis 坚持发布尽可能严谨的测试……一切……我们正在为 ClusterMAX 及相邻项目招聘 MTS。如果你是“新云”狂热者,请在此提交申请,让我们开始工作。我们也在研究、咨询和技术人员方面进行招聘。我们在纽约和旧金山办事处有多个职位空缺。远程工作也是可以接受的。ClusterMAX MTS(全职):考虑所有级别的 Slurm、Kubernetes 和 GPU 经验。Tokenomics MTS(全职):考虑所有级别的模型评估、工具包、推理端点和 RL 基础设施经验。研究分析师 – AI 基础设施与经济(全职或实习):考虑所有级别涵盖新云、新实验室和前沿实验室代币经济学的财务经验。技术顾问(全职):从技术战略到技术尽职调查主导参与。考虑来自咨询和技术背景的所有级别经验。
对于后排的人:我们正在对托管集群进行排名。这排除了行业中许多流行的产品。我们不是在测试谁能够构建最好的动力外壳或运行最整洁的数据中心——至少不是直接如此。我们没有手工打造镜像或将 API 端点作为令牌服务来使用。以下是我们理想化的 ClusterMAX 读者画像:你从斯坦福大学的博士项目中辍学,追求在旧金山获得社会地位的梦想,开始依赖那句老话:“Cladue make me pithc deck w technial languge for agetnci ai make no mistakes.” 你有7位甚至多达10位的数字可以用来下注计算资源,但你没有任何关于 Ubuntu 版本或如何处理 NAT 的意见,也从未大规模管理过舰队。理想情况下,所有这些基础设施都会退居幕后。你只想专注于你的独特性能优化、模型架构、训练策略、数据混合、应用程序或其他任何寻求优势的地方。为了竞争,你需要最前沿的硬件,并且希望花费零工程时间来解决为什么节点19中的GPU 7一直在阻碍你的工作,或者为什么四分之一的集群完全消失的问题。你需要一个托管集群。
这里的经济论点很简单:一个新云可以在其庞大的舰队上分摊建立所有这些管理基础设施的成本。它雇佣一支工程师团队来构建坚不可摧的健康检查系统,保持机器镜像更新,创建便捷的监控系统,并处理我们在后面详细讨论的所有相关琐事。在一个理想的世界里,实验室会为更好的产品支付溢价;它可以运行实验而不被硬件拖累;新云收回投资;每个人都会更好。
然而,当实验室愿意内部化这些成本时,就会有一个时刻。在其规模下,前沿实验室不愿意将如此多的堆栈信任给一个新云。例如,OpenAI 发布了极具洞察力的博客文章,讲述了其在扩展 Kubernetes 方面的困难;如果它们是从不允许它们进入 K8s 控制平面的一家新云那里租用的,那么所描述的创新将是完全不可能的。正如 Anthropic 当前的招聘信息所说:
我们在一个默认设置不再适用的规模上运营。我们拥有调度器并将其扩展到一次性放置拓扑敏感的机器学习工作负载 across thousands of accelerators。我们扩展控制平面本身——apiserver、etcd、控制器——以便随着对象数量和节点数量呈数量级增长时,它仍然保持响应性。我们还构建了每个工作负载都依赖的核心集群服务,如服务发现,使它们在同样的压力下也能承受得住。
可以说,像 OpenAI 和 Anthropic 这样速度和规模的实验室需要同时共同设计整个堆栈,而现成的 Slinky 实现——即使是好的——也不够好。
前沿实验室在管理基础设施方面所付出的明显用心,恰恰说明了 ClusterMAX 的重要性。我们上次核查时,OpenAI 和 Anthropic 职位描述中包含“Kubernetes”的开放职位薪资范围总和为 27,769,274 至 42,687,654 美元,更不用说他们支付给庞大现有团队的薪水了。如果你没有预期到万亿美元级别的流动性事件,并且需要足够好的基础设施来为你提供一搏的机会,你就需要一个新云(neocloud)来为你承担繁重的工作。
至少在纸面上,较小的新云客户是挑战巨人的大卫。OpenAI 和 Anthropic 在其各自的逻辑指数增长曲线上拥有惊人的增长率,我们的数据中心行业模型目前预测它们将占据 2027 年底所有实验室算力的 56.3%。
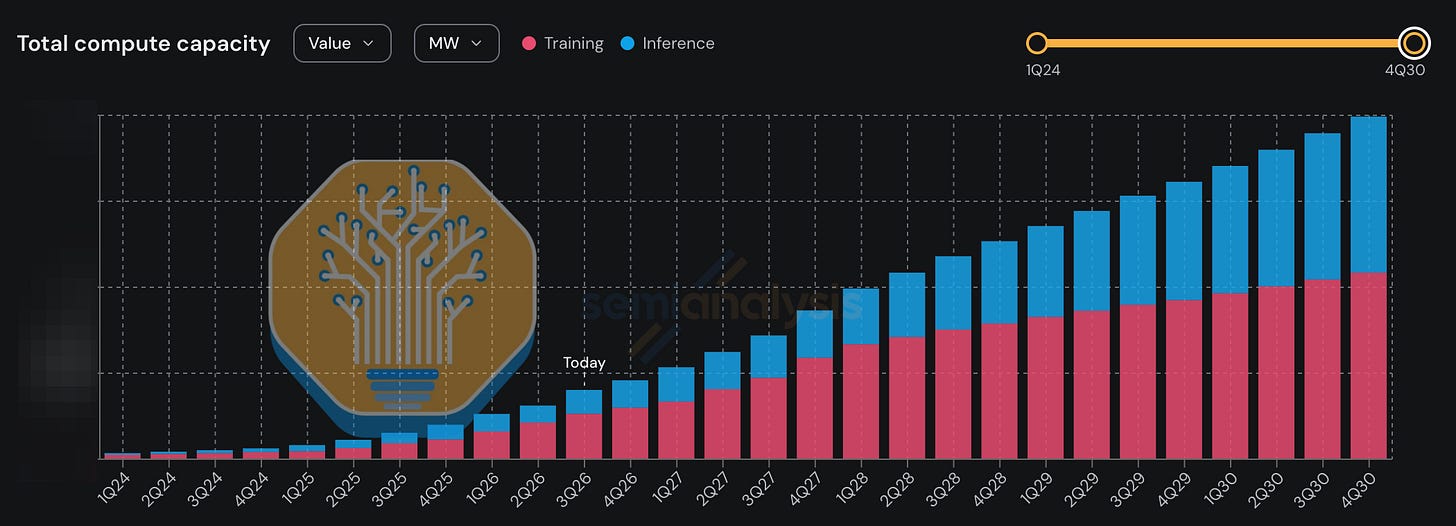
正如我们稍后将详细描述的那样,由于融资原因,这里也存在马太效应:盈利的前沿实验室比小型实验室更容易锁定算力容量,而小型实验室则被困在高昂的预付款、更差的定价以及更难提前数年进行规划的局面中。
这是否意味着托管集群已死?ClusterMAX 已经 washed?事实上,尽管 Anthropic 和 OpenAI 每年占据的份额越来越大,但作为业务的托管集群仍在呈指数级增长。我们帮助无数实验室找到了算力,还有更多实验室正在寻找,愿意付费,并等待更多容量上线。Anthropic 和 OpenAI 是最大的客户,但还存在大量价值数十亿美元的长尾交易,其总价值巨大。
一种托管集群在前沿实验室裸金属服务器上取得进展的合理情景涉及开源进展。提供开源模型的推理服务已经比许多人意识到的更有利可图;我们最近的模型显示,“通过销售开源代币,每兆瓦每年可以赚取超过 1 亿美元”,即使在当前的租赁价格下,也留有充足的利润空间。人们可以想象开源模型会增加其市场份额,无论是边际采用者对成本更敏感,还是算法进步缩小了与闭源模型的差距。无论动态如何,这将提高托管集群的相对地位。任何供应端的破裂都会使实验室略微不愿意自行处理基础设施,从而略微更愿意依赖新云。
这些集群之上的层正在迅速成熟,但它们超出了 ClusterMAX 的范围。这里有几个值得考虑的细分领域。有推理端点,可以是公共或私有的,并按代币计费。有后训练服务,为特定用例定制开源模型。还有沙盒服务,为智能体提供基础设施,特别是在强化学习(RL)部署期间,并简化和优化容器及 CPU 管理。这些都 loosely 归类于“GPU 服务”,它们之间的界限可能模糊不清。例如,一家云可能在出售托管集群后利用剩余容量启动推理端点,或者它可能在销售 RLaaS 的同时提供沙盒基础设施并在内部消耗它。我们将在不久的将来发布更多关于此的内容,但这超出了本报告的范围。
对于 ClusterMAX 3.0,我们向每家提供商提出了以下要求:
- 32 块 GPU(4 个由 8 路 HGX 组成的节点,或 8 个由 4 路 NVL72 组成的节点)
- 高带宽网络(我们要求提供 800G RoCE 或 XDR InfiniBand,但许多提供商当时尚未具备)
- 10TB+ 的高性能文件存储(支持 NFS/POSIX 挂载,并通过 csi 驱动提供 RWX StorageClass)
- 10TB+ 的符合 S3 标准的对象存储
- 监控仪表板(通常基于 Grafana)
- 5 天用于测试 Slurm,5 天用于测试 K8s(可以在 SonK 集群上并行进行,或者如果提供商希望收回节点并重新配置,则顺序进行)
- NVIDIA 方面接受 Blackwell(B200、B300、GB200、GB300),AMD 方面接受 MI355X。H100 如今已上市超过 4 年!
我们通过以下三个阶段对集群进行了测试。当然,我们总是通过联系所有这些提供商的客户并将他们的反馈纳入考量来补充这些测试。
第一阶段:审计
首先,审计涵盖“是/否”问题。集群设置是否得当?软件是否已安装?版本是否为最新?实用工具是否按预期工作?运行大约需要 15 分钟。它可在 GitHub 上获取,或通过 {uv} pip install clustermax 安装。
审计会在我们将集群置于负载之前检查其配置。它涵盖硬件清单、软件和固件版本、GPU 访问权限、容器、调度器配置、网络、存储、健康监控和安全。我们检查哪些组件适用于我们正在测试的环境,并为所有检查显示通过、警告、失败和跳过。我们已免费发布此部分并将随时间推移进行维护。其余部分我们目前保留在内部。
第二阶段:性能
性能为集群各个组件以及集群整体的性能特征设定了通过/失败阈值。这些测试通过微基准测试和真实世界基准测试完成。
具体而言,我们测试以下内容:
- GPU 计算
- 网络
- 存储
- 生命周期
- 训练
- 推理
下文将对此进行更详细的解释,但请记住,我们的测试内容会随时间演变。
GPU 计算
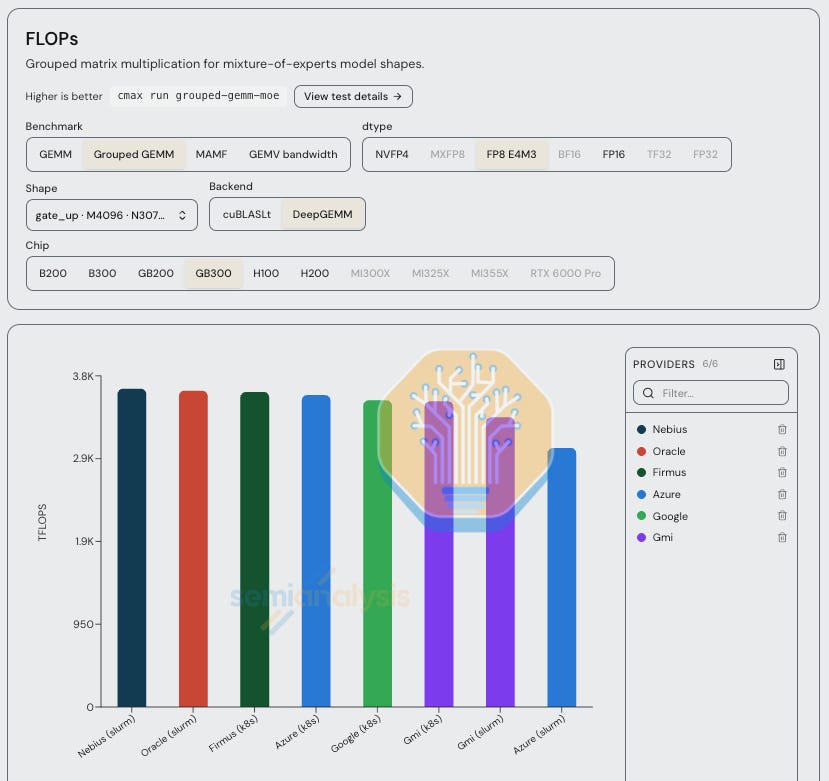
我们首先检查 GPU 上的真实世界 GEMM(通用矩阵乘法)性能。GEMM 是现代 AI 工作负载中最关键的操作,我们此前曾多次解释过这一点,其中分组 GEMM(Grouped GEMMs)对于现代 MoE(混合专家)模型尤为重要。
我们在 cuBLASLt(或 hipBLASLt)和 DeepGEMM 上针对多种精度类型测试分组 GEMM:BF16、FP16、TF32、FP32、FP8 E4M3、MXFP8 和 NVFP4,具体取决于集群中芯片的支持情况。我们使用 Kimi K2.5、K3 以及 DeepSeek V3、V4 Pro 模型中不同 gate_up 和 down 投影在不同批次大小下的常见形状集进行测试。
随后,我们测试 GEMM、GEMV(通用矩阵向量乘法)带宽以及 MAMF(最大可实现矩阵乘法浮点运算次数,源自 Stas Bekman)。MAMF 使用 cuBLASLt(或 rocBLAS)在每个 GPU 上、针对每种精度运行一段时间的性能扫描。我们报告所有 GEMM 测试的 FLOPs(每秒浮点运算次数)。
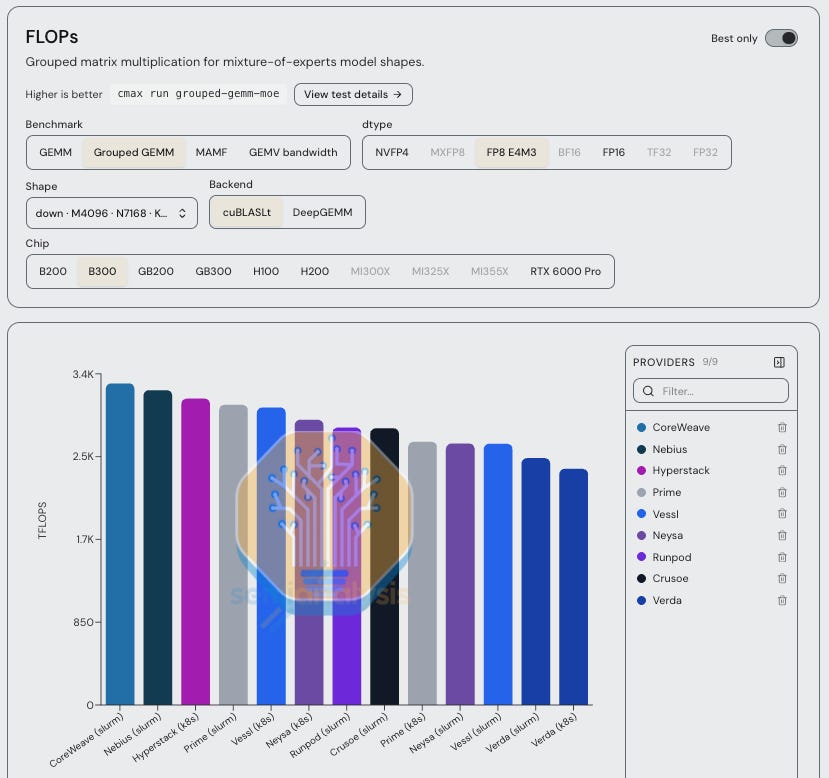
我们还通过 GEMV 测试和 nvbandwidth 测试内存。GEMV 测量带有瘦向量的矩阵向量乘法,以 GB/s 作为低批次解码流式行为的代理指标。NVIDIA 的 nvbandwidth 实用程序内置于 DCGM 健康检查中,可测量 h2d(CPU 到 GPU)、d2d(GPU 到 GPU)和 d2h(GPU 到 CPU)带宽。最后,我们还有一个自定义 PyTorch 脚本,通过实际的张量复制测量相同的路径,记录固定内存 h2d、d2h 和本地 HBM 复制的带宽。
最后,我们为“老前辈们”测试 HPL-MxP。HPL-MxP 使用低精度因子分解求解大型稠密线性系统,这意味着我们同时触及计算、内存和通信。该测试在一个工作负载中涵盖计算、HBM、跨扩展网络的 MPI 广播、NVLink 以及数值正确性。根据芯片类型,我们在一系列数字格式中报告 FLOPs。
尽管 GEMM 是现代 AI 工作负载的核心,但这些微基准测试很少能区分不同的云服务商——因为要让服务商在 GEMM 功能上出错是很困难的。正如后文所述,检查芯片在长时间压力测试期间(如果散热不当,时钟频率可能会下降以避免过热)的原始 GEMM 性能非常重要。在 GEMM 突发测试中,你不太可能发现什么值得注意的问题。我们在每个服务商上都运行这些测试,因为它们执行速度快,而且一旦失败,集群将立即无法使用,但我们更担心其他测试。
生命周期
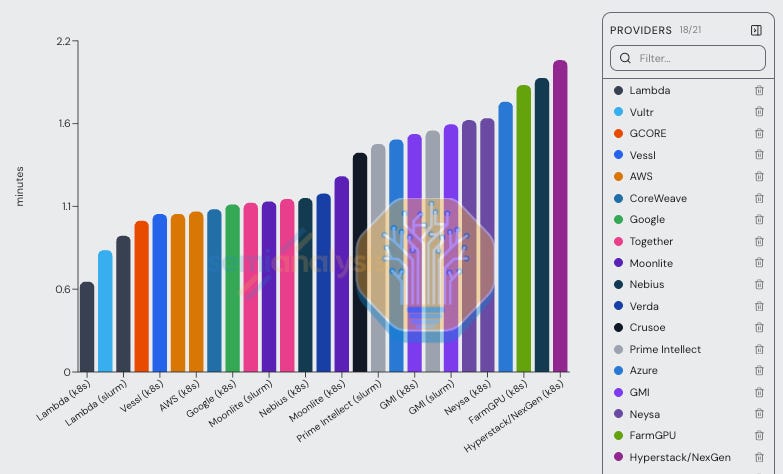
为了了解集群在整个生命周期中的易用性,我们设计了一套人为构造的测试用例。我们首先通过多种方法检查互联网速度,主要涉及从 Cloudflare 进行的下载和上传速度测试。接着,我们测试通过 pip 和 uv 安装常见软件包(如 PyTorch 和 vLLM)所需的时间,以及从 Docker Hub、ghcr.io 和 nvcr.io 下载容器镜像,并从 Hugging Face 和 ModelScope 拉取模型所需的时间。
然后,我们在每个可用的存储层级(即 home、共享文件系统、本地 NVMe 临时空间以及任何额外的挂载点,分别称为 /home、/data、/scratch 和其他)上使用全新的软件包缓存重新进行 pip 和 uv 安装测试。随后,我们从每个位置运行 import torch,以观察耗时情况。在大多数服务商上,这需要 1-2 秒,但在某些存在 LOSF(Large Object Storage Failure,大对象存储故障)性能问题的文件系统上,有时可能需要 10-20 秒。
最后,我们使用之前下载的模型,运行 vllm serve 命令,测试直到能够访问 /v1/models 端点所需的时间。同样,虽然某些服务商可以在 10-40 秒内将小模型从共享存储加载到 GPU 内存中,但有些服务商则需要超过 2 分钟。
网络
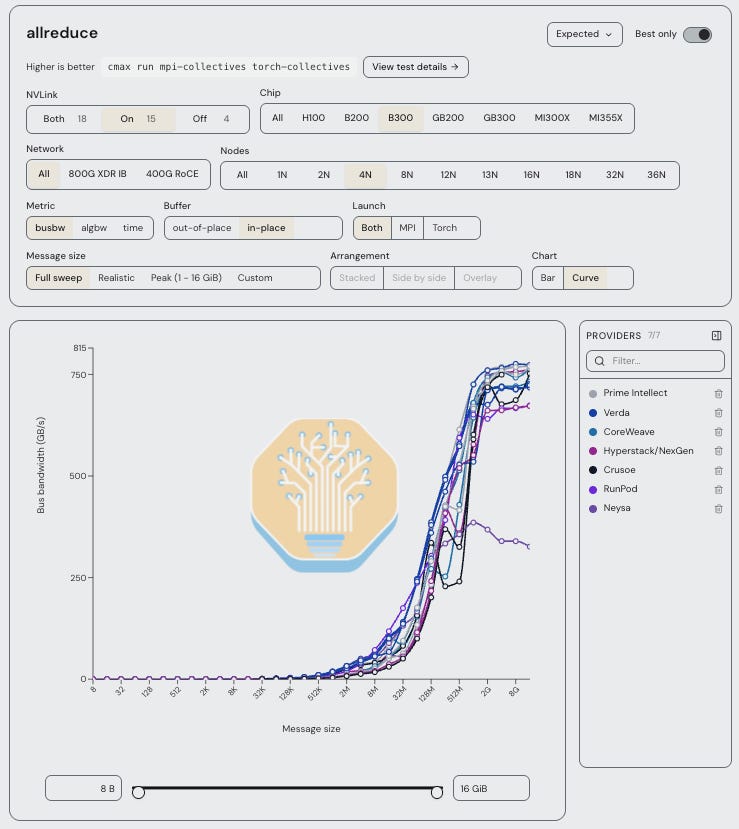
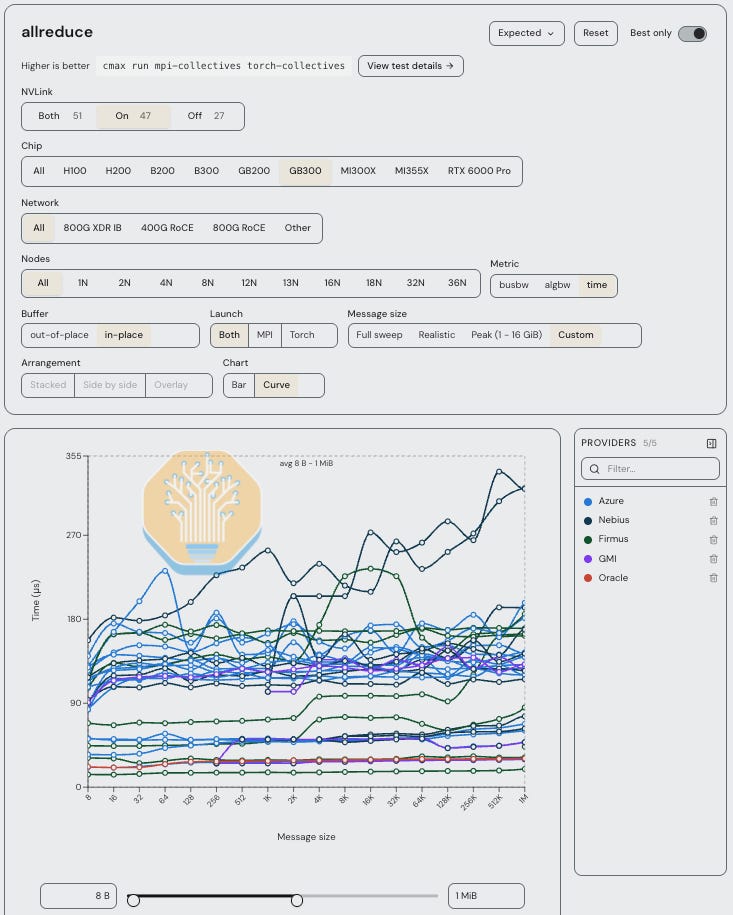
我们对节点间和节点内的传输通信性能进行了广泛的基准测试。这包括 MPI 集合操作、通过 MPI 启动的 NCCL 或 RCCL 测试,测量所有对全(all-to-all)、所有对归约(all-reduce)、所有对收集(all-gather)以及其他集合操作在不同消息大小(从 8 B 到 16 GB)下的集合带宽和延迟。相同的负载也通过 PyTorch 中的 torch.distributed 运行。此外,我们还使用 RDMA perftest,特别是 ib_write_bw 和 ib_read_bw,测量每条网络轨道上的点对点带宽,以及主机内存回退(通过 PCIe),以识别任何问题。
我们将世界规模(world size)按 2 的倍数递增,直到用完整个集群,并跟踪性能如何扩展。我们还禁用了 NVLink 运行测试,特别是在 GB200 或 GB300 NVL72 集群上,以便隔离扩展网络的性能。在这里需要谨慎处理会计问题,因为世界规模、算法以及与扩展边界相关的作业放置都会实质性影响结果。
存储
我们运行 fio、ior、Elbencho、一个用 Torch 和 Torch DCP 编写的自定义检查点保存/加载基准测试,以及一个由 Skild AI 与我们共享的自定义数据生成基准测试。DataGen 可能是最有趣的,因为它近似于他们在机器人数据管道中的实际工作负载:生成视频(MP4)和 parquet 传感器数据集的聚合写入吞吐量。
不过,发现问题最多的测试仍然是老式的 fio。我们从 c1 一直到 c32,或者如果有超过 4 个节点,则使用集群能承受的最大客户端数量, sweeping 顺序/随机读写,并使用 1MiB 顺序块以及 4 KiB 缓冲 / 64 KiB 直接随机块,配合缓冲/直接 I/O。如果存储配置有任何错误,几乎总能在该 fio 扫描的某个设置中显示出糟糕的性能。我们跟踪吞吐量、IOPS 和延迟,当然,如果测试因客户端过多而失败,我们还会发现元数据的不一致之处。
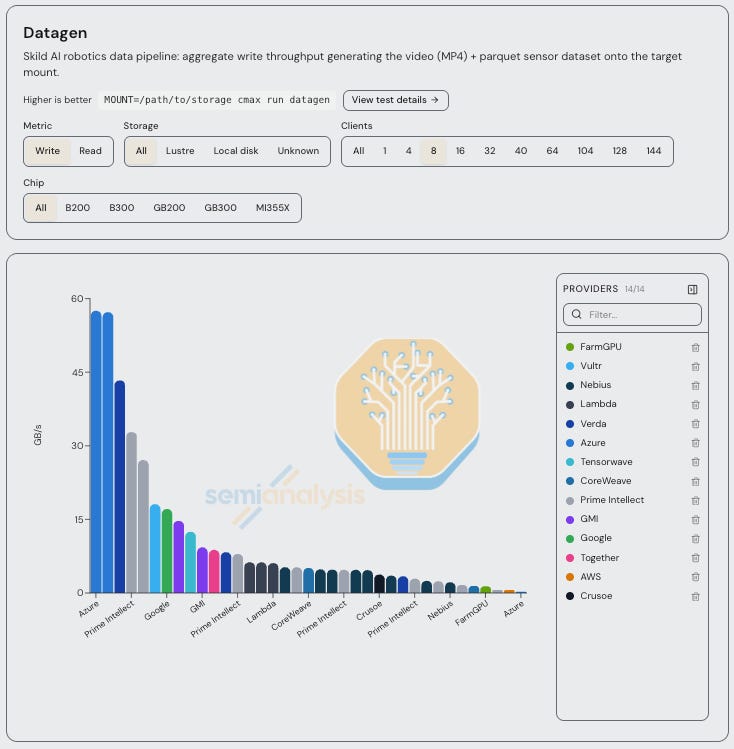
当然,这在很大程度上取决于我们获得的体积大小以及 SLO 的定义方式。请谨慎看待这些结果——上面的图表实际上仅表明 Azure 为我们提供了一个 PB 级的挂载点。这种谨慎态度也说明了为什么拥有大量集群的数据至关重要。例如,正如你可能预期的那样,缓冲测试具有更高的延迟,如果测试运行时间不够长,还会产生非常嘈杂的结果。但延迟高出多少?噪声有多大?要知道什么是“足够好”,什么需要向提供商发出警告,与大型同行组进行比较至关重要。
对于对象存储,我们再次针对 S3 存储桶运行此套件。我们还运行了一个自定义基准测试,用于测量顺序读写的大对象吞吐量、小对象 PUT 和 GET 速率以及读取延迟(p50、p90、p99)。在此测试中,我们保持所有条件一致。不过,一如既往,如果我们注意到某个集群在特定工作负载下表现吃力,我们会停留更久,运行更多测试以更精确地隔离问题。
训练
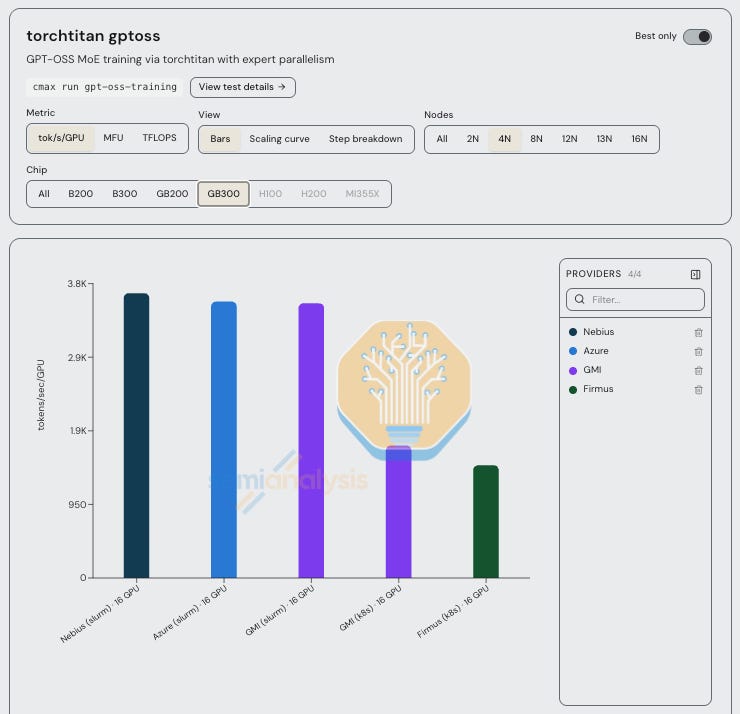
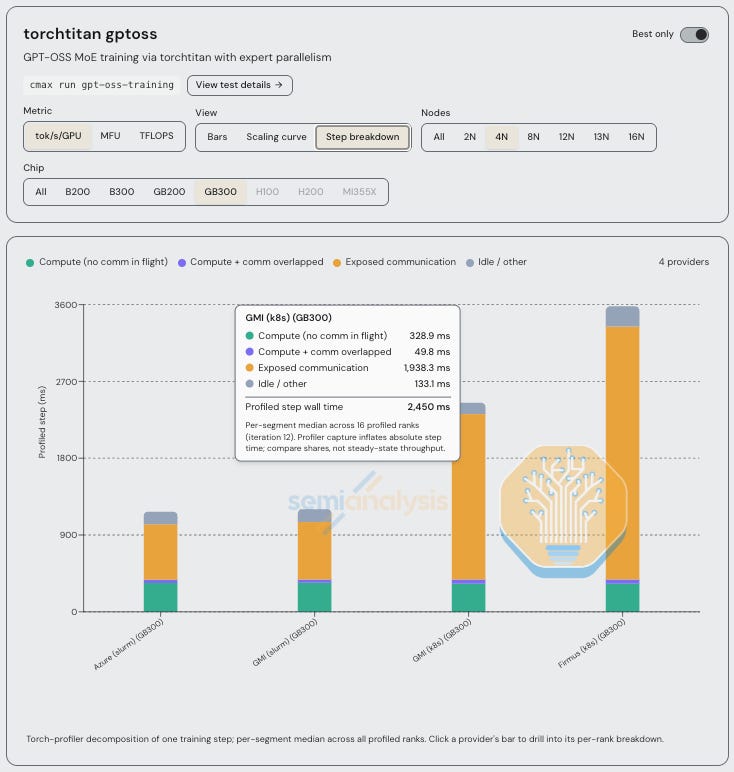
进入真实世界场景,我们开始看到网络或存储中的问题如何在实际测试中显现出来。我们通过 torchtitan 运行两个任务:使用 FSDP 在 C4 数据集上对 llama 3.1 8B 进行预训练,以及通过 torchtitan 使用专家并行性进行 GPT-OSS MoE 训练。前者受浮点运算能力限制,后者受集合通信限制(除非你使用的是 NVL72)。因此,当网络出现问题时,后者能清晰地暴露出来。
推理
我们在单节点和多节点场景中运行 InferenceX AgentX 基准测试,并使用不同的模型,以发现计算密集型、内存密集型和通信密集型阶段,同时开启性能分析追踪,将 InferenceX 的结果作为基准性能结果进行比较。与我们的训练测试一样,这凸显了微基准测试中涵盖的各种集群组件的重要性。如果一个集群无法通过 NCCL 测试,它肯定无法生成大量 token,而我们的 InferenceX 测试则展示了有效吞吐量是如何丢失的。
第三阶段:可靠性
仅仅因为我们在基准测试中看到了稳定的性能,并不意味着提供商能够提供稳定的有效吞吐量,更不意味着他们会提供良好的支持体验。因此,我们通过多种方式测试可靠性、监控和自动修复能力。
老化测试
我们从 GPU 和网络上的 8 小时老化测试开始,同时在张量核心上运行大型 GEMM 操作,并在所有节点间进行全对全通信,同时使用监控脚本跟踪温度、功耗、时钟频率、FLOPs、网络连接性、延迟、带宽,当然还有持续检查内核环形缓冲区是否有任何错误。你会惊讶于仅凭这个简单的测试就能引发多少硬件问题。我们必须强烈强调,同时对 GPU 和网络施加压力是多么重要。老化测试需要这两个组件同时经历热膨胀和收缩,以近似真实工作负载下的真实系统行为。许多提供商仍然使用分别对 GPU 和网络进行老化的脚本。
网络架构
接下来,我们通过循环执行大消息大小的全对全、全收集和归约散射操作,来测试扩展网络和聚合网络架构的持续性能。我们报告平均、最小和最大带宽,以及集合通信错误。在前端网络上,我们还测试了管理网络在每个四个节点的有向节点对之间的丢包率、往返时间(RTT)和 TCP 带宽。虽然这种额外测试并不经常捕捉到老化测试未能发现的错误,但我们喜欢这类数据,并且它揭示了某些以太网网络在负载下的巨大性能差异。
继续测试,我们通过 fio(如前所述)在每个客户端数量下运行 7.5 分钟的顺序混合读写和 7.5 分钟的随机混合读写,以测试文件系统的耐久性。我们增加分配中的客户端数量,并报告随时间变化的带宽、IOPS、尾部延迟以及性能下降情况。有趣的是,与初始基准测试相比,我们发现某些提供商在负载下的带宽下降了近 40%。
当提供对象存储时,我们还运行 15 分钟的混合 PUT、GET、LIST 和 DELETE 工作负载,测量吞吐量下降、p99 GET 首字节时间漂移、节流和错误。我们在这些测试中观察到约 10% 的差异。
编排
在 Kubernetes 上,我们通过反复创建/删除 GPU Pod 并检查 API 中的 GPU 分配来测试“ churn ”(变更率)。我们报告调度和启动延迟,并在 kubectl delete po 卡住时报告故障。我们还增加仅 CPU 的沙箱 Pod 批次,测量有多少个达到 Ready 状态、需要多长时间,以及为什么其余的保持 Pending 状态。
最后,我们通过反复启动挂载卷、写入并 fsync 文件然后被删除的 Pod 来测试 PVC 生命周期。我们在循环之间等待清理,并使用预热循环从测量的运行中移除初始镜像拉取。
破坏性
最后,我们进入有趣的部分:故意破坏东西。
首先,我们重启集群中的所有节点。你希望这不是一个破坏性测试,但它确实是。在 Kubernetes 上,我们对节点进行 cordoning 和 draining,发出重启指令,并要求更改启动 ID,然后等待其返回集群。当我们能够在节点上的新 Pod 中运行 nvidia-smi 时,计时器停止。对于 Slurm,我们只需获取分配或 SSH 并运行 sudo reboot。Slurm-on-Kubernetes 略有不同,因此我们尝试从 Kubernetes 层执行操作以正确测试它。我们的脚本在整个过程中对一切进行计时。
为了注入故障,我们首先使用 DCGM 注入方法。如果它不能正常工作,我们会跟进在内核日志中编写合成的 NVIDIA XID 或 SXID 消息,并观察提供商现有的健康检查和调度程序的响应。我们不打扰他们的健康代理和自动排水自动化,因此检测错误并采取行动取决于他们的工具。大多数健康检查设置为从内核环形缓冲区读取,但有些不是,因此我们与提供商沟通以确保我们的触发器有效并且我们可以访问它。作为一种最终可靠的方法,我们重置 GPU 的上游 PCIe 桥,这会产生真正的 XID 79。
在所有这些情况下,我们记录检测故障所需的时间、节点保持在 DRAIN 状态的时间,以及一旦返回集群后运行基本命令所需的时间。在 AMD 系统上,我们注入 UMC RAS 错误并以相同的方式跟踪所有内容。
这是我们要进行的至关重要的测试。在我们听到大量客户抱怨可靠性的提供商通常没有部署健康检查、监控仪表板和自动修复机制。正如我们在文章《GPU 集群到底要花多少钱?》中详细讨论的那样,可靠性是许多全球最大客户最重要的标准。
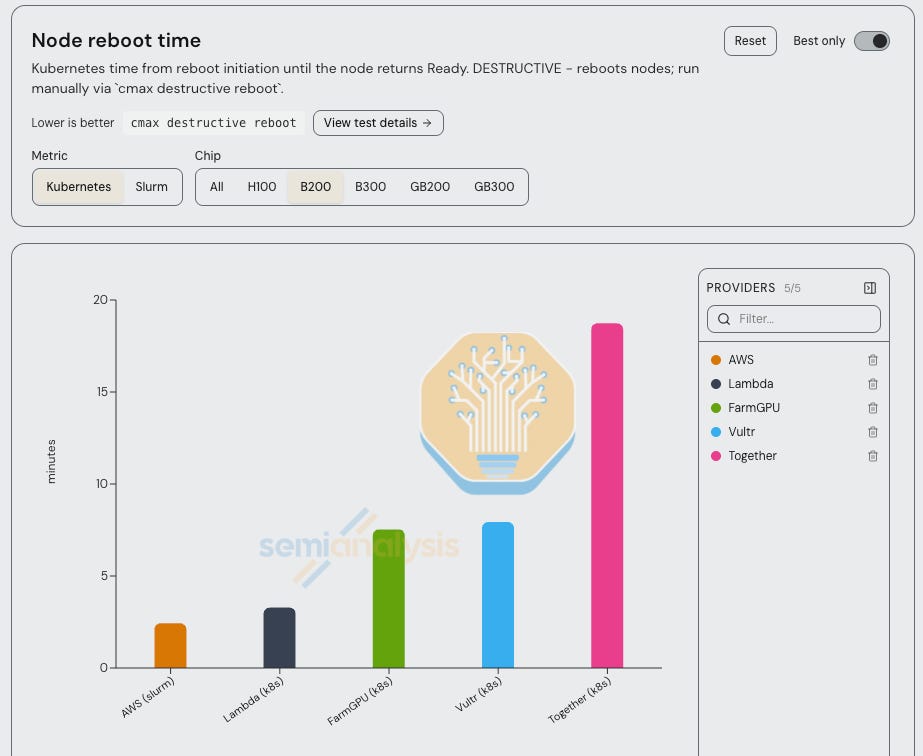
值得注意的是,我们的动手测试只是整体评级的一部分。有许多事情我们无法动手测试,需要使用其他研究方法来详细了解。即大规模性能、长期可靠性、支持体验、定价、GPU 可用性和交付时间表。
即将推出:智能体工作负载和强化学习
我们还有两个测试套件,我们将在未来的工作中对此进行更多介绍。
CPU 计算
CPU 是现代代理工作负载的关键性能考量因素,我们此前已对此进行过讨论。我们开发了一套全面的基准测试,通过常见的 Linux 工具使用以及在即将推出的 SandboX 项目中的更多微基准测试,将 CPU 性能在这些代理工作负载上推向极限。
SandboX 运行一系列具有代表性的 CPU 密集型工作负载,包括代码执行、环形洗牌生产者-消费者队列、Redpanda(测量本地 Kafka 兼容代理及其吞吐量)以及动态负载基准测试。
我们还对 Kubernetes 集群的沙箱生命周期进行了基准测试,以深入了解在 GPU 集群的剩余 CPU/内存资源中为强化学习(RL)共置沙箱的工作方式。我们报告了冷启动延迟、调度吞吐量、每节点密度、容量和基线。
强化学习
一次强化学习运行包含许多移动部件:用于生成轨迹的生成器、在沙箱中执行动作的环境,以及接收轨迹、更新策略并将更新后的权重推送回推理引擎的训练器。扩展强化学习意味着平衡最大化训练器、推理引擎、环境沙箱执行、轨迹传输以及权重同步等方面的利用率;任何一环出现瓶颈都可能导致整个强化学习堆栈停滞。
我们还看到了“训练后服务”(Post-Training-as-a-Service,或称 RLaaS)的兴起,客户自带环境,或由前瞻性部署工程师构建环境,托管训练提供商则搭建基础设施以对开放权重模型进行后训练。其卖点是在保护客户知识产权的同时实现定制化,这显然已成为萨蒂亚·纳德拉(Satya)当前的口号。
在我们即将推出的 PostTrainingX 基准测试中,我们将遍历训练器到推理器的 GPU 分配、批次大小、轨迹并发度以及策略陈旧性限制,以研究它们对性能和训练稳定性的影响。
我们通过每个推理 GPU 每秒输入/输出 token 数、轨迹延迟、KV 缓存占用率和前缀缓存命中率来跟踪生成器性能。通过权重同步延迟、传输带宽和网络遥测数据来衡量通信效率;并通过训练吞吐量、优化器步长时间、MFU、训练/轨迹 KL 散度、观察到的策略陈旧性、裁剪比例、梯度范数和被拒绝的轨迹来评估训练器性能和稳定性。
对于环境,我们测量设置时间、工具执行时间、超时情况和基础设施故障。GPU 利用率、内存使用和功耗提供系统级背景信息,而归档的轨迹、日志和确切的环境定义则确保结果可复现。
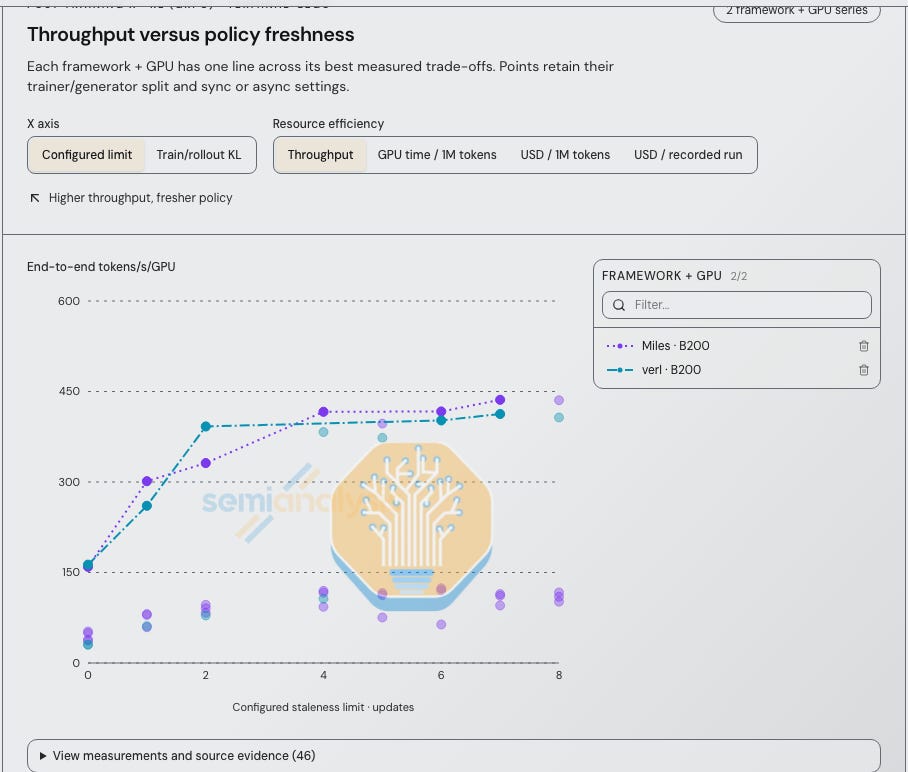
PostTrainingX 的目标是对所有提供商进行基准测试。这包括托管训练平台,如 Applied Compute、Azure Foundry、Fireworks、Thinky、Baseten、Trajectory、Engram、AI21 的平台等,以及开源框架,如 Miles、slime、prime-rl 和 verl。最终结果应为客户提供数据,以便决定是在开源框架上自行运行后训练堆栈,还是将其交给托管 RL 提供商。
我们已经开始在开源框架上运行,包括 Miles、prime-rl 和 verl,并将在下一步扩展到托管提供商。敬请期待……
融资
在过去几个月里,新云领域最热门的话题是融资。每个人都想“追随资金流向”,这正是我们在 AI 计算、资本和市场模型中所做的,该模型在我们最近一篇解析英伟达“兜底宇宙”的文章中推出。下文我们将讨论几个更热门的话题。
债务与获取债务
如今,新兴云服务商已经意识到,一份信用良好的客户合同可以帮助他们以低于自身信用评级所能支持的利率获得债务融资。这意味着,缺乏承诺客户(或“机构级购电方”)的提供商可能需要更昂贵的债务或类股权资本来购买 GPU,从而启动业务或推动增长。与此同时,贷款人也需要证据表明提供商能够按时交付集群,并满足客户合同中的服务等级协议(SLA)。筹集债务的能力既取决于可支配用于偿债的现金流和总合同价值(TCV),也同等程度地依赖于租约终止权。这促使多家保险公司进入市场,推出参数化保险产品,保护新兴云服务商及其贷款人免受合同终止的影响,通常在合同终止时提供为期一个月的过渡期以寻找新的购电方。我们非常推崇这种结构,认为这是贷款人对冲此类交易风险的一种稳健方法。
交易对手风险与英伟达的资产负债表即服务
在大型新兴云项目中,GPU 贷款人和数据中心贷款人可能在同一项目中面对不同的交易对手。例如,在 Anthropic TPU 新兴云结构中,博通(Broadcom)支持设备融资,而谷歌(Google)支持数据中心租金。由于供应链中的多笔贷款可能依赖于同一家 AI 实验室,即使每笔贷款指定了不同的新兴云或数据中心借款人,仍可能存在系统性、相关性的风险。正如我们刚才讨论的,建设延误可能触发取消条款并损害现金流。
此时,英伟达的兜底机制登场。由于英伟达通过收入保底、房东担保以及计划转让给第三方的租赁协议来支撑 GPU 需求,他们能够帮助新兴云服务商和 AI 实验室在不涉及超大规模云厂商的情况下获得投资级融资。英伟达在初始销售中赚取 GPU 利润,但现在还可以获得超过其“AICP 底价”的收入分成。因此,他们的金融支持推动了对其硬件的需求。资产负债表即是护城河。
折旧时间表
自我们在去年 11 月的文章中批评 Burry 博士以来,这个话题的热度已略有下降。也许是因为人们签署了那么多为期 6 年的合同,或者是那些价格就是不肯下跌的 4 年高龄 H100!究竟是谁能确切知道呢。
无论如何,在对折旧进行建模时,我们将设备购买日期与投入使用日期区分开来。6 年的折旧假设需要针对特定提供商的支持,而在英伟达的 AICP 计划中,6 年收入保底实际上并未确立 GPU 的使用寿命。我们的折旧敏感性测试会显著改变模型中的利润率,但内部收益率(IRR)仍是贷款人的首要考量,因此我们在此不予分享。当然,财务分析并不能确定买家未来为 GPU 支付的真实价格。这取决于供需动态,以及最终的问题:残值。由于贷款人无法将贷款还款计划与我们用于设备折旧的会计假设分开设定,我们被困在一个无人愿意承担评估当前 4 年、5 年或 6 年历史的 GB300 残值风险的境地。
Blackwell 与 Grace Blackwell
现在让我们回到本文剩余部分的技术内容。这才是真正有趣的部分。
正如我们在 ClusterMAX 2.0 中详细讨论的那样,运行 8 路 H100 HGX 服务器与 GB300 NVL72 机架级系统之间的差异巨大。那些在 3-4 年前通过安装 H100 积累经验的服务商,如今正面临以下挑战:
- 基于 ARM 架构的 Grace CPU(而非 x86 架构的 Intel 或 AMD)
- 搭载 sm100/sm103 核心的 Blackwell GPU(需 CUDA 13.0+ 支持)
- 强制采用直接液冷技术(DLC)
- 高压供电(每个机柜功率超过 130kW,通过三相 408V 或 480V 电力输送实现)
- 扩展网络配备 800G CX-8 网卡,以及 51.2T 或 102.4T(800GbE RoCE Spectrum-X)或 115.2T 交换机(800Gb XDR InfiniBand)
- 扩展网络配备机架级 NVLink 交换机和背板,支持 72 路互联
- 前端(或融合式前端/存储)网络使用 BF-3 或 BF-4 DPUs
- 多平面网络配备打乱板(shuffle boards)或打乱线缆
所有这些变化都对配置软件、监控系统、技术人员培训、设施级的电气、冷却和机械系统、OEM 支持合同及合作关系等产生了影响。
仅仅因为某提供商在 Hopper 时代取得成功,并不意味着他们在 Blackwell 时代也能成功。
在我们的排名中,我们给予那些向我们提供 Grace Blackwell 的提供商更高的权重,坦率地说,在配置、监控以及可靠性/热备件的困难方面,我们对他们给予了更多的宽容度。
这意味着,如果客户租用仅通过 RoCE 或 InfiniBand 连接的普通 HGX 节点,我们期望看到具备自动修复功能且备件可用:端到端替换时间在一小时以内,检测时间约为两分钟。然而,对于 NVL72 系统来说,在不同的扩展网络拓扑上热插拔托盘是没有意义的。
因此,在我们的测试中,只要健康检查能在两分钟或更短时间内发现不健康的节点,并阻止工作负载在其上调度,它就完成了任务。如上所述,我们就 GB300 NVL72 的服务水平协议(SLA)向许多实验室和云提供商提供建议,我们看到的最常见模式可以称为“NVL64+”。这意味着 SLA 应用于每个节点,但如果一个机柜中的 18 个节点中有 3 个或更多在同一时间点发生故障,整个机柜将被视为宕机。这是由于简单的二进制幂次原因:许多作业可以被 64 整除,并在 64 个 GPU 上运行,而填满 72 个 GPU 的最大配置是 world_size=8 * num_jobs=9。
转向 Vera Rubin
有趣的是,从 Grace Blackwell 过渡到 Vera Rubin 所需的变更比从 Hopper 过渡到 Blackwell 要少得多。提供商仍然管理基于 Arm 的 CPU、液冷机架级架构、72 路 NVLink 扩展网络、多平面扩展网络以及一些 Bluefield DPU。回想当初 GB200 问世时,所有这些技术都是全新的!
主要的变化在于扩展网络上从 800G CX-8 网卡升级到 1.6T CX-9 网卡,以及单机柜功耗从约 130kW 增加到约 200kW,包括 800V 直流选项。
早期需求比 Blackwell 过渡时期更为强劲——部分原因在于将 GB 软件移植到 VR 比从 Hopper 移植到 GB 更容易——我们从许多提供商那里听到消息,称他们有望提前交付 VR。启动过程出乎意料地顺利,物理设计似乎更加成熟。
扩展网络
扩展网络是提供商仍拥有最终设计决策权的最后一个重大环节。Nvidia 和 OEM/ODM 锁定了 NVL72 机柜的大部分结构。在机柜外部,提供商选择拓扑结构、布线方式,以及 Kubernetes 或 Slurm 如何将网络 fabric 分配给作业。我们在每一层都发现了问题。
从物理层开始,800G CX-8 网卡是多平面的:每个网卡将其带宽分配到独立的交换 fabric(称为平面)。每 GPU 的总带宽保持在 800G。更多的平面为每个交换机提供了更多的有效端口,并为每个网卡提供了更多的上行链路路径,这需要打乱(shuffle)机制。每条网卡通道必须连接到正确的平面,因此打乱盒将光纤映射放入配线模块,而打乱线缆则将其构建到组件中。两者均可行,但在可靠性(需要维护设备的频率)和可服务性(维修或更换设备的难易程度)方面存在权衡。
Oracle 是这种物理设计的先驱,当你拿到 GB300 节点时这一点便显而易见。我们获得的每个包含 4 个 GPU 的托盘都有 16 个物理 200G 端口,这意味着每个 GPU 有 4 个平面。Linux 暴露了 4 个可用的 800G RDMA VF(rdma_vf_rail0 到 rdma_vf_rail3),每个 GPU 一个,且各自位于独立的 VRF 中。聚合 PF 因没有可用的 GID 而失败,因此我们不得不依赖其 SPCX NCCL 插件,每个连接使用 16 个队列对,并在平面间进行自适应路由。
为什么要费心这样做?答案是扩展性。Oracle 基于这种物理设计构建 Acceleron。他们的 MRC 拓扑论文展示了每个 NIC 如何拆分为 8x100G,这将 51.2T 交换机转变为 512 个端口,并支持在仅两层、最多 3 次交换机跳数的情况下以全带宽运行 131,072 个 GPU。OpenAI 于 2026 年 5 月通过 OCP 发布了 MRC,而 Oracle 在 Stargate Abilene 运行它。软件层允许 MRC 将单个连接散布到路径和平面中,无序放置数据,使用选择性确认恢复丢包,并利用 SRv6 源路由来绕过故障或拥塞的链路。这种逻辑层在任何规模下都可能变得复杂,这也是作业出现问题的地方。
要分配 RDMA 设备并正确使用它,Kubernetes 必须为每个 Pod 提供正确的设备和接口。换句话说,配置和使用 NVIDIA NetworkOperator 的方法有很多。如果配置错误,那将是每个人的噩梦。
我们的脚本识别以下带有 NetworkOperator 的部署模式(资源名称是我们检查的集群中的示例):
- rdma_shared_device:带有资源支持的 NAD 或主机网络回退的 rdma/rdma_shared_device_*
- sriov_host_device:带有 HostDeviceNetwork NAD 的 nvidia.com/hostdev 或 nvidia.com/rdma_host_dev,用于直接设备访问和 GPUDirect RDMA
- sriov_legacy:通过 NAD 绑定的 nvidia.com/ 的 VF 以及 SriovNetwork NAD,以及在需要时添加 RDMA CNI
- sriov_ib:带有 SriovIBNetwork NAD 的 InfiniBand VF,例如 nvidia.com/mlnxics。分区fabric还需要正确的 PKey 和 UFM 配置。
- ovs_offload:带有 OVSNetwork NAD 的 nvidia.com/switchdev,用于硬件卸载的 Open vSwitch。
- rdma_ib / rdma_roce:带有每个 rail 一个 NAD 或主机网络回退的 rdma/ib、rdma/roce 或 nvidia.com/rdma_*。
- 特定于提供商的:AWS EFA(vpc.amazonaws.com/efa 和 libfabric)、DOKS(rdma/fabricN 与 roce-net-fabricN@fabricN)以及 GKE DRANET(DRA 声明模板和 pod resourceClaims)。
设备设置及其上的 NCCL 插件可以改变作业性能。在 Google 的 GB300 上,内置的 NCCL 库在我们测试时选择了一个不可路由的链路本地 GID 并挂起。设置 NCCL_IB_GID_INDEX=3 解决了这个问题,Google 的 gIB 插件在 16 节点、16 GiB 的全对全通信中达到了 99.5 GB/s,而其他提供商仅为 95.3 GB/s,即达到全性能。
话虽如此,多节点 NVLink 本身就是一个问题。NVIDIA DRA 驱动中的 ComputeDomain CRD 为每个作业提供自己的 IMEX 守护进程和通道声明,独立于 RDMA。Google、GMI 和 Firmus Kubernetes 使用了 ComputeDomain,但 RDMA 路径不同:Google 使用 DRANET,GMI 使用带有主机网络的共享设备,Firmus 使用每 rail VF。与此同时,Oracle、Azure Slurm、GMI Slurm、Firmus Slurm 和 Nebius Soperator 从主机提供 IMEX,没有任何租户声明。Azure AKS 在没有租户可见的 ComputeDomain 的情况下运行多节点 NVLink,尽管有 GPU DRA ResourceSlices,但通道来源和租户隔离边界未记录在案。
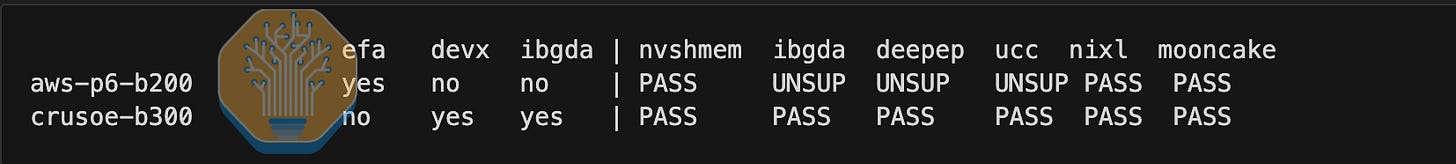
每个 ComputeDomain 必须保留在一个 NVLink 域内,因为跨越域需要 RDMA。换句话说,这是在分层扩展 NVLink + 扩展 RDMA 网络上的拓扑感知网络。当我们不正确地启动作业时,缺乏 ComputeDomain 感知,当放置跨越机架时,它们只是在 clique 设置中挂起。我们将关于 AWS 提供商不支持 DeepEP 和 MoonEP 的抱怨留待附录后面的 AWS 提供商审查部分再谈。
可靠性、健康检查、自动修复和服务等级协议
在我们开始研究“GPU 集群的实际成本究竟是多少”时,我们开始在测试的每个集群中注入故障。不同提供商之间的差异很大。处理故障需要两件事:
- 识别故障的发生
- 正确修复它
为了识别故障,我们建议使用监控仪表板。一个好的仪表板应显示故障组件、受影响的作业、当前的调度器状态以及每次检查最后运行的时间。过时的绿色结果并不能证明系统健康。当然,监控仪表板依赖于某些遥测数据,因此你必须正确(且安全地)配置 DCGM。
为了修复故障,我们期望实现自动补救:重启并使用热备节点进行替换。自动补救无法覆盖所有情况。某些故障需要人工干预、RMA(退货授权)以及其他必须由提供商直接与客户沟通的工作。我们在关于此主题的文章中详细讨论了以 goodput(有效吞吐量)衡量的确切成本。
NVIDIA 最近开源了 NVSentinel,这是一个用于 Kubernetes 的故障检测和补救系统。它读取 DCGM、syslog 和云维护事件,然后可以对节点进行隔离和排空、重置 GPU 或重启。默认安装仅包含监控功能。软件本身是简单的部分,重要的是将每种 XID 映射到提供商采取的行动上。一个受限的 XID 94 需要应用程序重启;一个不受限的 XID 95 则需要 GPU 恢复。显然,如果你盲目地为每个 XID 重启所有节点,你会杀死正常运行的工作负载;而如果你在严重 XID 后仍让 GPU 可调度,则会面临工作负载崩溃的风险。
这也是为什么许多客户只想要裸金属服务器。他们只是希望提供商关闭支持工单。关闭支持工单比听起来要难。一个给定的工单可能来自 100 多种 XID 中的任何一种,每种 XID 都有不同的含义和解决方案。标准操作程序(SOP)涵盖了从更换硬盘或电源、清洁线缆、重新插拔内存、GPU 或网卡,一直到对单个组件或整个服务器托盘进行 RMA 的所有内容。
自动补救有很多不同的选择,而正确的选择取决于具体的系统。此外,对于 GB 和 HGX 而言,补救是一个不同的问题。在 HGX 上,你可以用带有 8 个 GPU 的热备节点进行替换。在 NVL72 上,你无法将另外 8 个 GPU 热插拔到 NVLink 域中。一个失败的托盘会导致 4 个 GPU 下线,选项要么是机架降级运行,要么是整个机架更换。好消息是 GB300 的故障率往往低于 GB200。无论如何,从错误到数据中心采取行动的流程才是关键。
一些提供商告诉我们,他们在采取行动前会等待,以便让客户有时间将数据从节点上转移出去。这是一种借口(cope)。我们正在模拟的是硬故障。节点已经死亡,上面没有任何东西可以转移。(有一个普遍的道理:如果提供商声称他们选择不做某事是为了“给客户更多选择权”,那这就是借口,而且迟早提供商会意识到这一点。)
正是在这里,拥有并运营数据中心与租用 colo(托管空间)产生了区别。运营自己设施的提供商控制着现场的 technicians(技术人员)、备件和 SOP。而在 colo 中的提供商则依赖于房东的远程协助及其时间表。这两者都会影响容量恢复的速度,而这正是 SLA(服务等级协议)必须衡量的指标。
- 两种场景(HGX 8路系统,即 H100 或 B300;以及 MGX 4路系统,即 GB200 或 VR NVL72)中“节点”、“机架”、“集群”和“站点”的技术定义
- 所有系统的“停机时间”技术定义
- 三个层级的相关服务等级协议(SLA)(“青铜”、“白银”和“黄金”,以及与停机时间相关的相应阈值和信用惩罚)
- 用于衡量停机时间和提供信用的双向承诺
- 建议从停机时间测量中排除的项目,例如软件升级、安全补丁和物理维护
- 建议的月度审查频率,以评估提供商对 SLA 的履约情况
- 买方因停机时间低于推荐阈值而享有的合同终止权
- 验收测试的定义,包括描述在 GPU 计算、网络、存储和软件方面需执行的测试类型,以验证集群是否可运行并可被接受,并建议联系 SemiAnalysis 进行 ClusterMAX 技术评估
- 买方因错过约定的验收日期而享有的合同终止权
- “不可抗力”条款的定义
- ……以及更多内容
我们鼓励计算买家(Neolabs)、云提供商(Neoclouds)、债务/融资合作伙伴和保险公司将这些术语作为其合同的基础,并在验收测试和月度 SLA 绩效审查中包含 SemiAnalysis 技术评估。我们使用我们的 cmax 工具和一套全面的专有流程执行此技术评估。
如需更多信息,请通过 clustermax@semianalysis.com 联系我们。
安全性
自我们发布《大多数新云公司在安全方面表现糟糕》以来,我们收到了积极的反馈。我们的朋友已经在他们的集群上运行我们的 CLI,以查找需要替换的陈旧软件包,并且总体上增强了对这一问题给予其应得重视程度的动力。
尽管如此,我们认为它值得更多的审视。随着关于人工智能是否会毁灭全人类的讨论达到白热化,几乎没有人分析过人工智能实际上可能逃脱控制并造成危害的具体手段。OpenAI 和 Anthropic 正在花费数十亿美元进行功能增益研究,其中一些基础设施已被揭露存在严重嫌疑,然而人们大多忽略了这样一个事实:GPU 集群——支撑这些模型的物理主机——通常缺乏你所期望的免疫机制。
无论你对 AI 能力持何种观点,良好的安全实践都是必要的。即使这些集群没有因 AI 工具而变得更加脆弱,事实仍然是我们正在数十亿美元投资于本应更安全却并不安全的设施。我们可以想象许多令人不快的场景,其中仅涉及一个会使用 Vim 且对操作系统有良好理解的人。阅读 Hugging Face 的报告,统计一下那些让火势蔓延的日常网络安全错误数量。
同样值得强调的是,这在某种程度上是一种结构性风险。当行业在应对严厉监管和不加批判的社会反弹所带来的危险时,大型语言模型工厂遭到入侵是最不应该成为头条新闻的事情。这既是出于网络安全原因——每个受感染的节点都会增加恶意行为者探索的邻居数量——也是出于普通的社会政治原因——无论好坏,批评者会将新云行业一棍子打死。
做个好邻居,别被黑客攻击。
智能体编码
代理式编码正在对托管 GPU 集群的利润率造成压力,因为使用 AI 工具的客户更愿意采用裸金属或轻度管理的集群。在我们的测试中,我们一直看到这方面的证据。如果我们需要添加 Linux 用户,但集群上没有现成的脚本,Codex /goal make useradd script and add my whole team saved the legwork(目标:制作 useradd 脚本并添加我的整个团队)就帮我们省去了繁琐的工作。特别是在文档糟糕的集群上,代理帮助我们摸索出所有可能的配置,使我们得以摆脱困境。相应的 Slack 对话通常如下所示:
“嘿大家,我们要怎么使用 XYZ?”
“算了,Codex 告诉我用 ABC。”
“对,没错。我们会把这个加到文档里。”
在具有明确成功标准和良好上下文的场景中,代理对我们的帮助最大;否则,它们对 GPU 系统的处理方式显得天真无知。它们拥有相关的知识,但这些知识相对于那些看似合理却错误的方案来说,权重并不高。例如,Claude 习惯使用循环而不是作业数组,从而压垮 Slurm 控制器。我们的一位代理认为配置 NVLink 网络太麻烦,于是改为通过 InfiniBand 启动作业并宣布胜利;另一位在运行存储测试时犯了类似的错误,在 NVMe 而不是 NFS 上进行操作;还有一位在尝试将 GPU 作业调度到 CPU 节点后,因性能不佳而责怪提供商。我们通常让代理整夜运行,要么使用 /goal fix this part of the cluster so tests can run(目标:修复集群的这一部分以便测试运行),要么使用 /goal try to break this part of the cluster with a realistic workload(目标:用真实负载尝试破坏集群的这一部分)。总体而言,这让我们成倍地提高了产出,但有时验证结果所花的时间比我们自己动手还要长。如果你清楚如何设置集群,代理会让你如虎添翼,甚至让你愿意考虑选择比平时更差的提供商。如果你不知道自己在做什么,你的 AGI 顾问会愉快地告诉你把脚射下来。在这个半透明的行业中,代理放大了技能差异,而不是将其抹平。
一个富有洞察力的例子是 CoreWeave 的系统上线过程,这已经是业内最严谨的流程之一。现在,除了严格的传统流程外,他们还利用大语言模型在其机队上运行统计分析,寻找能更早标记故障的模式并改进其程序。CoreWeave 还有一个 NodeBot,它能在自动化警报之上提供轻量级的推理,总结情况并建议下一步行动,从而简化人工参与者的诊断工作。例如,团队描述了一个事件:热界面材料泵出警报本应将节点移出集群进行调查,但同时出现的 PMU 暂停警报却竞争性地要求重启节点而非对其进行分类处理。NodeBot 在这种冲突中识别出了正确的操作。CoreWeave 拥有丰富的规模化运行 GPU 的经验,掌握着训练数据中缺失的无数经验法则,并且有专家不断闭合反馈回路以改进这些模型的使用;即使 OpenAI 用 AI 生成的内核打造出一款惊艳的芯片,我们也预计 CoreWeave 不会很快受到那些依靠氛围编码数据中心自动化的新兴云服务商的威胁。
尽管事实是——咱们实话实说——行业里的每个人都在至少某些工作流中使用 AI,但我们看到的唯一以 AI 为先的提供物是 AWS 提供的一个不错的 MCP 服务器。否则,所有文档名义上都是为人类编写的。提供商能为代理(agents)做的最好的事情就是提供详尽的文档——理想情况下,比人类能浏览过的内容详尽得多——并在集群上留下黄金配方,作为爬山算法优化的起点。除了那些尚未实现 AI 优先的传统流程外,还有许多系统因为不是为代理构建而变得严格来说更差。例如,虽然让 AI 管理你的作业可能有利于集群利用率,但它并不尊重为辅助研究而建立的旧式系统。CoreWeave 和 Nebius 拥有许多 Slurm 层的优化——真正的作业会计系统,在用户和组上强制执行 RBAC 和优先级,精心管理的分区、作业数组、日志和指标——当一切都以代理方式运行时,这些都被浪费了。CoreWeave 还告诉我们,他们看到头节点内存耗尽,因为远程控制的 Claude 正在编排整个集群。观察提供商如何改善其 AI 代理功能将非常有趣。
正如本文所述,我们历史上一直在测试集群。但市场显然朝两个相反的方向发展。
首先,最大的实验室正在大规模购买裸机,规模以百兆瓦(MWs)计,并且拥有内部人才来管理自己的训练集群、编排软件、监控和可靠性。本质上,他们的新型云提供商(当他们使用且不自建时)只是关闭工单的数据中心技术人员。这是一项复杂的业务,不容理所当然:NVIDIA GPU 有 172 种独特的、记录在案的故障方式(XID)。许多这些故障模式可能会重叠,导致极其广泛的故障场景表面,需要结合简单的故障排除逻辑、人类经验以及越来越多地由 AI 进行的代理研究来从这些故障中恢复。
与此同时,许多初创公司正在筹集数千万甚至上亿美元的资金,并有效地将几乎所有资金都用于计算资源。但由于如此多的研究是由强化学习驱动的,通过对长期代理的真实生产轨迹进行持续学习,对离线、吞吐量优化的推理以及在线、延迟敏感的推理的需求都非常强烈。同时,越来越多的客户希望找到最简单的方式来为其工作流购买原生的开源令牌。
这引出了我们要发布的下一篇文章,即将推出,我们将描述推理端点的解剖结构,并推动在未来版本的 ClusterMAX 中包含推理端点测试。我们认为,所有新型云提供商未来都需要开展端点业务。
我们还将评估推理之外的强化学习基础设施:沙箱、托管训练、评估等。我们继续看到每天都有大量新的提供商进入(和退出)市场。这是 AI 领域令人兴奋的时刻,而新型云提供商正处于这一浪潮的中心。
如果你读到这里,并且仍然渴望了解更多关于我们对每个提供商的个人体验,你应该考虑来 SemiAnalysis 工作!
我们正积极在研究、咨询和技术岗位进行招聘。我们在纽约和旧金山办事处有多个职位空缺。也接受远程工作。
ClusterMAX 工程师:考虑具有 Slurm、Kubernetes 和 GPU 经验的所有级别人员(全职) 代币经济学工程师:考虑具有模型评估、测试框架、推理端点和强化学习基础设施经验的所有级别人员(全职) 研究分析师 - AI 基础设施与经济学:考虑涵盖新云、新实验室和前沿实验室代币经济学的财务方面的所有级别人员(全职或实习) 技术顾问:主导从技术战略到技术尽职调查的项目。考虑来自咨询和技术背景的所有级别人员(全职)
感谢阅读,期待在未来的 ClusterMAX 版本中与您相见。
铂金
CoreWeave
CoreWeave 依然是行业内最敏锐、最坚固、最积极主动的新云服务商。
我们的 CoreWeave 集群在所有关键类别中都堪称典范。健康检查按预期运行,可靠性极佳,几乎所有测试开箱即用即可达到预期值。与 Nebius 一起,CoreWeave 作为行业内的衡量标准——不仅是在“优秀表现者”的抽象意义上,而且是在字面意义上,我们将他们的集群与评级较低的集群进行比较,以精确描述其他厂商的不足。当其他新云服务提供商需要被催促才能更新发霉的 GPU 驱动程序时,CoreWeave 不仅处理好了基础工作,还建立了一个重要的独立堆栈,以实现边际性能和可靠性的提升。
ClusterMAX 2.0 报告详细阐述了 CoreWeave 的设计决策,包括其裸机配置、Slurm 分支、DPU 的使用以及健康检查。此后,CoreWeave 的极客们添加了一个名为“GPU 滞后检测”的智能功能,该功能集成在其一流的仪表盘中。CoreWeave 不再让客户通过查看日志或在整个集群中进行二分搜索来隔离故障节点,而是对手工编写的算法应用于 NCCL 遥测数据,并根据发现结果推荐补救策略。CoreWeave 团队告诉我们,他们几乎每天都在与客户通话时使用此功能。存在各种各样的软故障,它们不会写入 XID 或留下任何其他明显的特征,但会浪费 GPU 时间,因为作业在等待滞后节点。
比发现坏 GPU 更好的是根本不调度它们;CoreWeave 还有系统确保每个节点在被客户的工作负载信任之前都达到高标准。当 CKS 中的节点处于空闲状态时,CoreWeave 每小时运行 20-30 分钟的加压测试,验证扩展和扩缩容网络是否健康、GEMM 数值是否符合规格、D2H 和 H2D 带宽是否高,等等。这些测试会被客户的工作负载中断;对操作员不可见,它们有助于确保不是生产工作负载发现了故障。CoreWeave 肯定不是唯一拥有主动健康检查的服务提供商,但这些检查异常 robust。
这种严谨性也延伸到了 CoreWeave 的上线流程中。CoreWeave 每周部署约 10,000 张 GPU,他们认为自己在判断 Blackwell 机架是否健康方面拥有比上帝还多的数据。在 CoreWeave 看来,Nvidia 的诊断工具擅长捕捉许多故障,但其独特的深层数据集使他们能够推出一套定制的补充测试套件,包括针对 NVLink 的测试。这一流程的核心是舰队生命周期控制器(FLCC),它“自动化了节点配置、测试和监控”,并掌控从通电到移交的全过程。重要的是,正如其他大规模运营机队的公司所证实的那样,存在大量 Nvidia 文档未充分覆盖的晦涩故障模式。CoreWeave 对这些故障保持统计,以更好地预测未来的故障,并将其响应模式整合进 FLCC。这也是为什么我们在评级中将大规模运营经验视为关键标准的原因之一。新手与像 CoreWeave 这样拥有严格操作手册、自动化流程和老化测试的提供商之间存在巨大差异。如上文的“代理式编码”部分所述,CoreWeave 在该系统之上使用大语言模型(LLMs)来获取人类工程师无法发现的见解。此外,CoreWeave 还在交付前与制造商合作。参与程度因 OEM 或 ODM 以及生产阶段而异,但总体而言,目标是通过供应链逆向追溯,尽可能早地发现问题的根源:不要在投产时才发现本可在上线阶段发现的问题,也不要在 L11 诊断中才发现本可在工厂车间发现的问题。
他们在 Blackwell NVL72 上线和验证方面的经验,以及与 Nvidia 和 Dell 的密切关系,使 CoreWeave 成为首家宣布 VR200 NVL72 系统通过 L11 诊断的提供商。CoreWeave 将 VR 描述为“我们引入自有知识产权的一代”。随着计算带来的物理需求不断增加,在 CoreWeave 看来,“建筑的操作方式现在已成为计算机操作方式的一部分——它们不再是两个独立的事物。”因此,CoreWeave 在最近的一篇博客文章中介绍了其定制的 Racky、Valvey 和 RLCC。其中特别有趣的是 Valvey,这是一种可编程的单机架液冷阀门组件。这使 CoreWeave 能够对每个机架的冷却回路进行细粒度控制,并且在发生泄漏或其他紧急情况时,具备触发停机保护的能力。尽管 CoreWeave 在构建自有硬件方面开始采用超大规模云服务商的心态,但它将自己的方法定位为“反超大规模”:传统基础设施强调冗余,旨在防止故障;而 CoreWeave 则致力于优雅地发生故障并快速恢复,限制故障域,从而对不可避免的故障做出更敏捷的反应。
然而,在当前万亿美元的基础设施建设中,CoreWeave 正面临应对容量单位(cu)激增的问题。当然,也有许多好消息值得提及。它与 Meta、Microsoft、OpenAI 和 NVIDIA(其最大客户)的关系看起来非常稳固,并且最近与 Anthropic 达成了一项多年期协议。今年夏天,它还宣布了与 HRT 和 Jane Street 的重磅交易。此外,它正在积极扩大其在亚太地区的产能,表明其“预计国际市场将成为增长的主要驱动力”。然而,它背负着 350 亿美元的债务,并且已经看到投资者对项目启动表示阻力。因此,CoreWeave 转而专注于长期裸金属合同,这类合同更容易获得投资级交易对手的融资支持,而不是利润率更高但市场融资意愿较低的托管集群。此外,我们上一份报告中提到了一系列令人印象深刻的近期收购,但此后其与 Core Scientific 的合并告吹,且没有其他新的公告。
- 我们希望他们的托管 SUNK 身份验证 RBAC 能够按集群基础进行配置
- 我们希望能够在 UX 控制台中通过一键点击来启用本地 GPUDirect Storage
- 对于许多尝试过的用户来说,新用户入职流程以及他们在 UX 控制台中输入 SSH 公钥的位置极其令人困惑
CoreWeave 已开始从裸金属业务向多元化发展,首先是通过提供自助式 SUNK 集群,这使他们在拥有相应容量时能够进入按需市场。他们还推出了一款托管推理平台,该平台最近披露的年度经常性收入(ARR)已达 1 亿美元。我们目前正在积极测试该平台,以便撰写一篇关于无服务器推理端点的最新文章,但遗憾的是发现不支持按 token 计费的公共端点。目前,我们只需说 CoreWeave 在其推理端点方面还有工作要做即可。
Nebius
在 ClusterMAX 2.0 中,Nebius 被评为全球第二好的新云服务商,但仍保持在黄金评级。这一次,Nebius 毫无疑问是行业领导者,在各个类别中都有强大的产品供应,并且有能力要求显著的价格溢价。Nebius 晋升至白金评级。
Nebius 与英伟达的关系依然紧密,包括今年三月的一笔 20 亿美元投资,英伟达在七月披露了其持有 Nebius 9.3% 的整体股份。Nebius 早在 2025 年 12 月就成为了首家部署 HGX B300 的供应商,并且在 VR NVL72 的首次启动中也处于首批新云服务商之列,预计将于今年晚些时候或明年年初开始部署。
Nebius 正在美国和欧洲的多个站点持续扩建,他们最近将 2027 年底的合同电力目标提高到了 5 GW。在客户方面,Nebius 已与超大规模客户 Meta 和微软签署了大型协议,并与 Reflection AI 和 Palantir 等规模较小的客户签署了协议,使其成为少数几家拥有数百兆瓦级超大规模客户协议且仍经常竞争较小初创公司合同的新云服务商之一。他们是短期集群市场上最活跃的所有新云服务商,服务于许多满意的客户。Nebius 用俄罗斯口音吓退潜在客户的时代已经过去。其产能采购策略也反映了这一点:与许多同行不同,Nebius 通过广泛的数据中心和软件合作伙伴网络, opportunistic 地收购了 5-20 MW 范围内的站点。
就集群本身而言,一个好的集群通常是平淡无奇的。在 Nebius 上,压力测试运行无误;Slurm 感知拓扑结构;我们所需的软件包已安装在集群上且通常较新;广域网性能良好;编排层没有陷阱。Nebius 与其他厂商在技术上的一个区别在于,Nebius 构建并开源了他们首选的 SonK 版本 Soperator。(当然,CoreWeave 在内部构建 SUNK,但它不是开源的。)在本轮测试中,Gcore 使用的集群采用了 Soperator,此前几轮中的 Voltage Park 和 FPT 集群也是如此。Nebius 写道:“Soperator 的真正魔力在于我们如何使用‘监狱’持久卷”:Nebius 在 jail 处提供一个 VirtioFS 卷,然后将其绑定挂载到 /,因此你无需担心将缓存指向正确的目录,也不必在 salloc 节点时过多考虑如何携带文件。在我们对其他提供商的报告中,你会看到一些管理 SonK 存储系统的棘手问题:Slurm 和 Kubernetes 对持久性有不同的理念,而在实际上你位于多个层级之上、站在临时 Kubernetes Pod 上时,要提供裸金属的错觉并不总是那么简单。Nebius 的方法使操作员能够轻松应对这一挑战。
特别是,Nebius 在每个工作节点上为我们提供了多种存储层级:/jail VirtioFS、/home NFS、/mnt/data/ VirtioFS、/mnt/local-nvme ext4 以及 /mnt/memory tmpfs,同时提供一等公民级别的 S3 服务。对于 I/O 密集型任务,推荐使用 /mnt/data,而对于共享代码和其他并发访问较低的数据,/home 则已足够。当我们首次测试 /mnt/data 时,发现其 4 KiB 顺序分配写入速度非常慢,而且来自 128 多个节点的并发目录创建有时会因元数据可见性不一致而返回 EEXIST 错误,导致我们的作业失败。针对这些极端负载情况,我们向 Nebius 反馈后,他们对该文件系统进行了重新调优,结果证明其稳定且快速。我们对其进行了压力测试并验证了错误已得到解决;按客户端统计,其性能优于中位数,并且我们可以进一步验证它能够扩展以处理跨越两个机架的高需求负载。
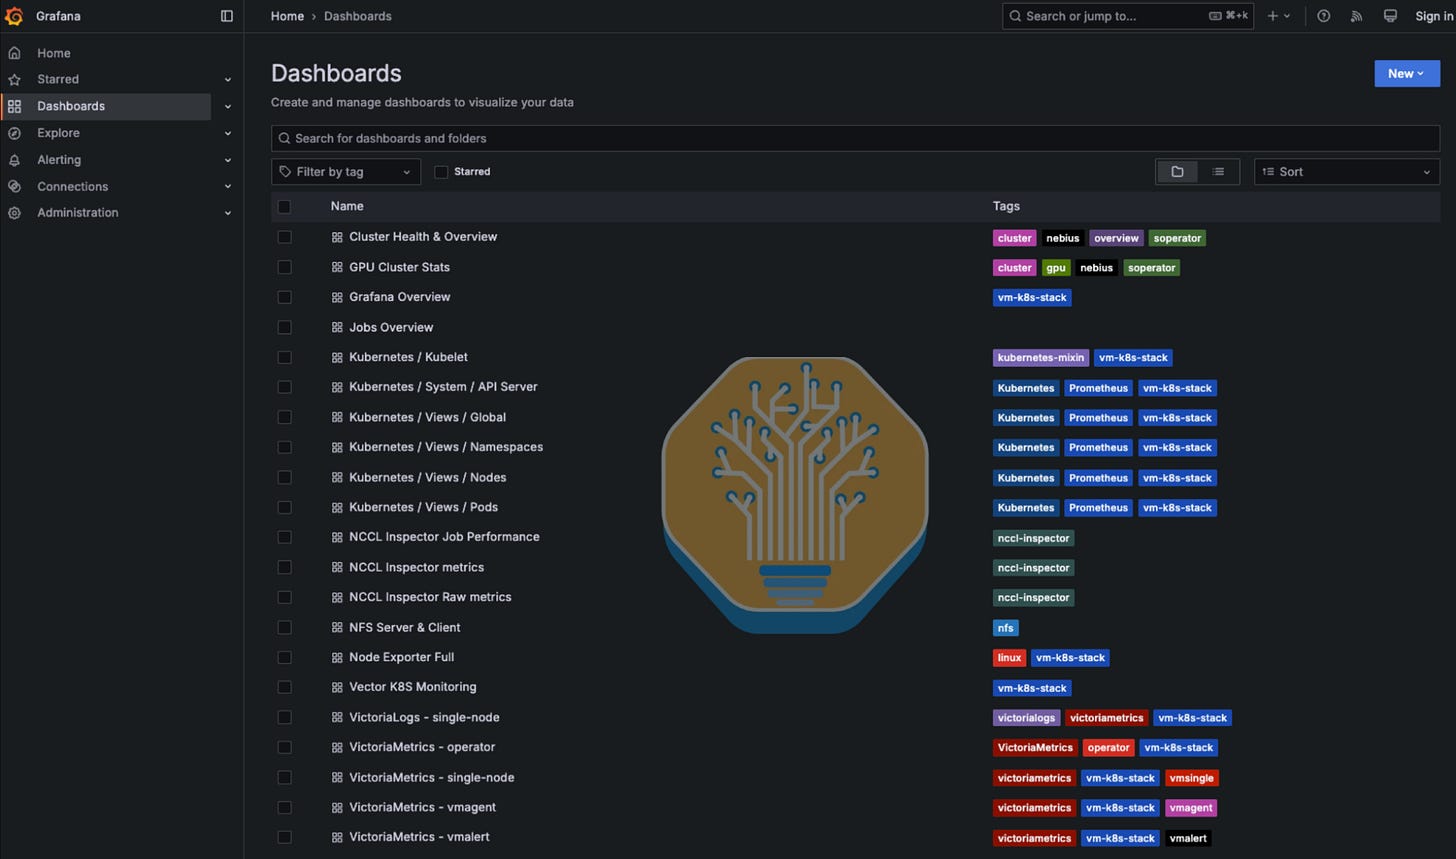
Nebius 在健康检查方面投入了大量精力,在我们的测试中,其表现良好。在 GB300 机架上注入合成错误后,Nebius 会自动将节点恢复至服务状态;该流程的速度尚未优化,从开始到结束耗时 8 小时 40 分钟,但检测是即时的,且最终流程能够正常运行。此外,我们测试的其他 GB300 机架并未自动重启并回收故障节点,因此这一自动化修复流程对 Nebius 而言是一个加分项。(正如我们在“Blackwell 和 Grace Blackwell”部分所述,完全不自动修复 GB300 节点是很常见的,因为实际上无法将节点热插拔到 NVL72 机架中,而且故障排除通常比 HGX 服务器复杂得多。)Nebius 还为我们提供了一套出色的仪表板套件,其中展示了包括集群健康状况在内的多项信息。
这一切都促使 Nebius 的每兆瓦收入相比 CoreWeave 持续攀升(其市值也随之增长)。鉴于他们在当前价格下拥有更多的可销售容量,我们预计这一趋势将持续下去。据非正式观察,我们在最近的谈判中看到 Nebius 表现得非常激进,其中包括一个案例,他们将一部分容量作为直接拍卖提供。总体而言,索取高价并要求大额预付款——在一年期承诺中甚至达到 100%——似乎是一门相当不错的生意,尤其是当这些预付款足以覆盖当前总成本(TCV)下的服务器全部资本支出时。谁想要无限的内部收益率(IRR)呢?
在其最大的裸金属站点,Nebius 继续面临建设和许可方面的延误,包括 Béthune 和 Vineland 项目,我们在面向行业领先的数据中心模型客户的报告中对此进行了广泛报道。但随着各种类型芯片的不断上线,Nebius 的记录使其处于有利位置,能够继续增长。
总体而言,我们对 Nebius 始终印象深刻。虽然我们确实认为他们在许多技术方面以及与 NVIDIA 和前沿实验室的关系上仍落后于 CoreWeave,但稳健的商业决策已使他们成为服务于新兴实验室的首选新云服务商。
黄金
Google Cloud
在 Google Brain 和 DeepMind 从前沿领域奇怪撤退的背景下,GCP 一直在进行鲜有匹敌的交易活动。 notable 合作伙伴包括为 Palo Alto Networks 达成的 100 亿美元交易,以及为 Thinking Machines Lab 达成的“数十亿美元交易”,同时还扩大了其与 AI 安全组织 Anthropic 的盈利关系。通过以 320 亿美元收购网络安全初创公司 Wiz 和以 47.5 亿美元现金收购能源初创公司 Intersect,Google 积极扩展其技术能力。它还通过增加 TPU 的销售而非仅在 GCP 中租赁它们,从而开辟新的收入来源,这是一个我们非常密切关注的发展。不过,由于与黑石集团达成的一项价值 50 亿美元的交易旨在实现 500 MW 的容量,其自身的 TPUaaS 仍在增长中。Google 拥有吉瓦级的产能储备,我们期待继续跟踪其与其他超大规模厂商和实验室在获取电力和许可方面的持续竞争。
凭借在技术栈众多层级中占据的独特地位,Google 可能拥有比世界上任何公司都更多的总体工程人才,但其在支持创新方面的历史却明显存在不足。在 ClusterMAX 1.0 中,我们指出了其平台存在的诸多问题,但我们预测 GCP 将很快达到金牌或白金评级。直到 ClusterMAX 3.0 这一预测才成为现实,而 Google 现在终于舒适地跻身于管理最完善的集群提供商之列。
GCP 的 GPU 体验不如我们的白金提供商 CoreWeave 和 Nebius 那样成熟。与那些更年轻、更专注的新兴云厂商(neoclouds)简洁流畅的用户界面相比,GCP 的控制台感觉就像车管所(DMV)。访问过程需要用到偶尔不配合的 Google Cloud CLI,迫使我们有时切换到控制台基于浏览器的连接方式,但该方式也不可靠。我们在 GB200 GKE 集群上遇到了一个小配置错误,默认 StorageClass 拒绝挂载到 a4x-highgpu-4g 节点,迫使我们尝试使用非默认类来获取块存储。抛开这些细枝末节,GKE 的设置非常出色,我们很喜欢使用它。Google 的托管 Slurm 现已正式全面可用(GA),表现相当稳健,默认设置和健康检查均已配置妥当。我们在 ClusterMAX 2.0 期间针对其托管 Slurm 服务进行的许多测试现在依然有效,因为 GCP 产品管理部门的官僚们允许真实客户使用该服务,不再将其贴上“Beta”、“预发布”或“尚未 GA”等标签。(顺便说一句,我们在讨论完 Google 之后将要探讨的许多新兴云厂商应该考虑更频繁地使用这些标签——平衡点就在这里。)
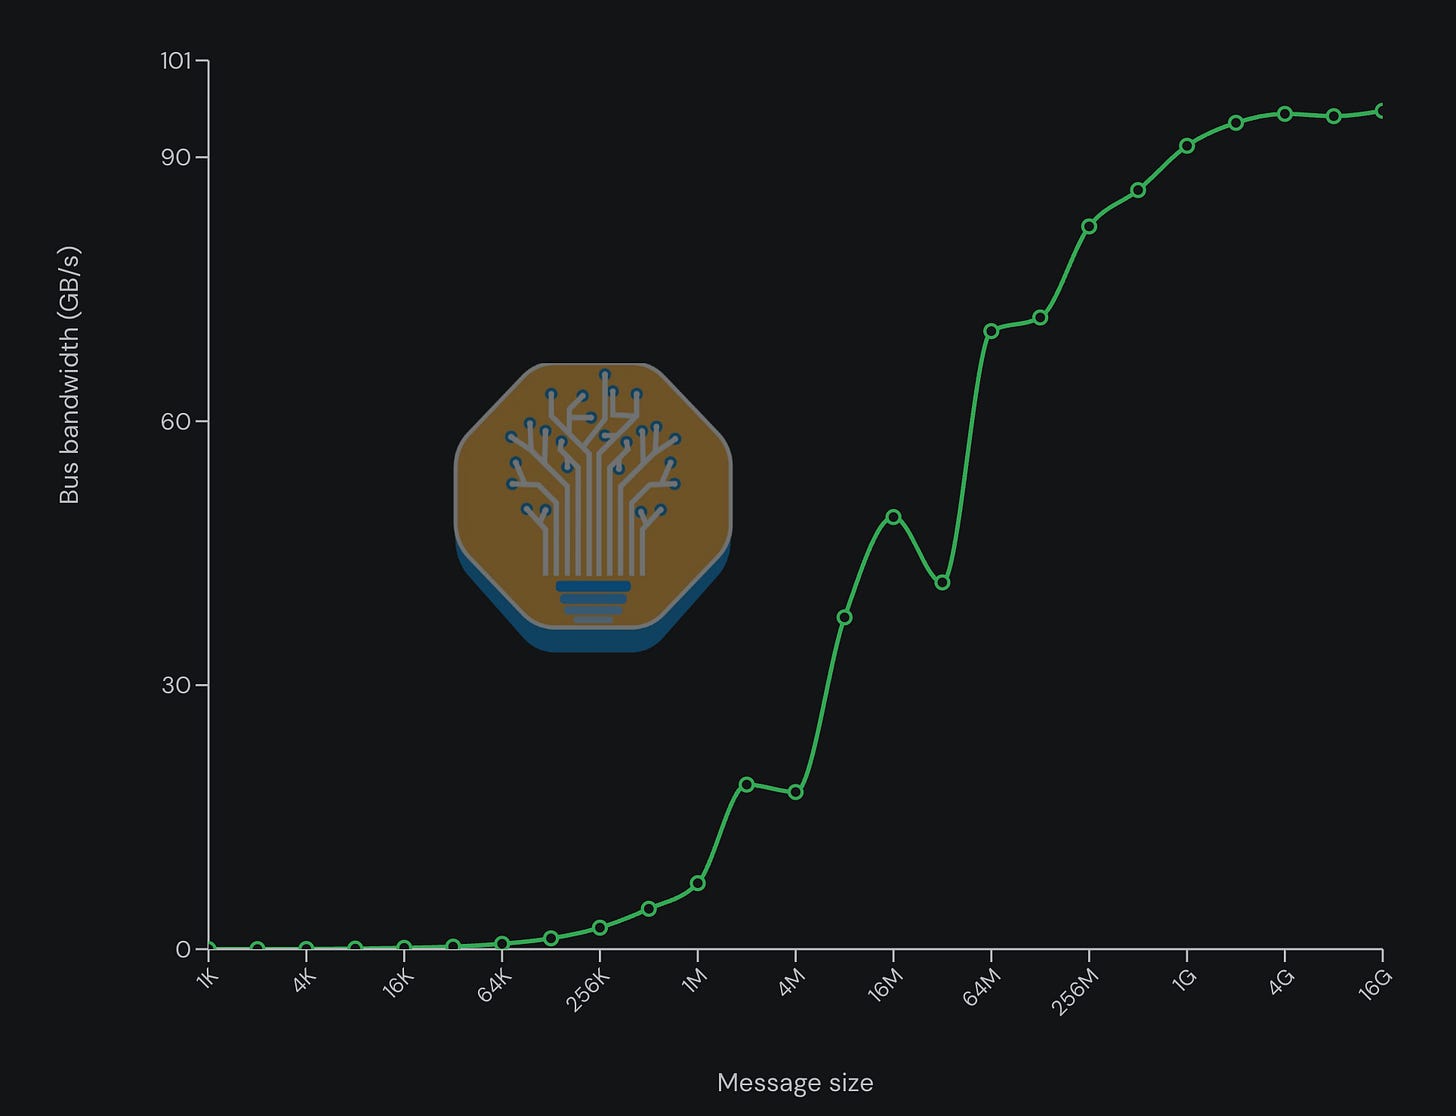
我们测试的 GCP 集群与其他集群之间最大的区别在于网络。我们的第一个 NCCL 测试挂起,因为自动 GID 选择选择了错误的地址,但固定 NCCL_IB_GID_INDEX=3 后完成了运行。即便如此,我们的 NCCL 测试结果仍不尽如人意:随着消息大小的单调增加,性能应呈现大致呈逻辑曲线的上升趋势,但我们得到的却是以下锯齿状图形:
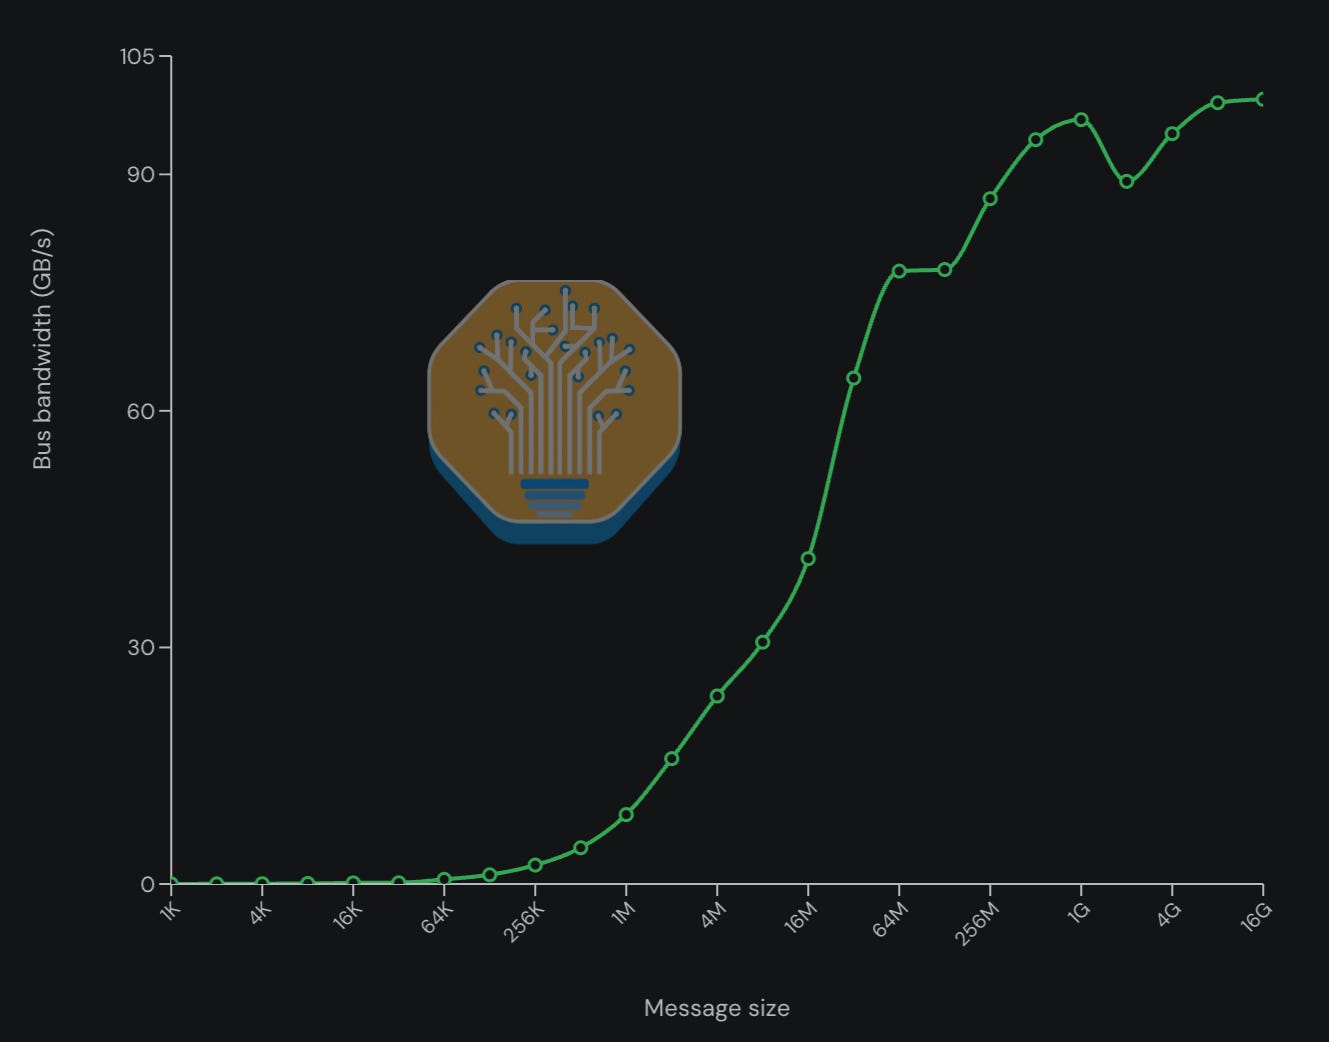
这有可能是 NCCL 本身的问题,而非我们 GCP 配置的问题。NCCL 的启发式算法并不总是能为特定的消息大小和网络拓扑选择正确的协议和算法,因此通常需要进行一些手动调整。然而,此时我们已经收集了千兆字节的网络数据,并且我们知道预期会有更好的性能。问题最终归结为我们未启用 gIB 插件。这是 Google 提供的一组 NCCL 插件,旨在提升 Google RoCE 网络的性能。截至 26.07 版本,gIB 已内置于 NGC PyTorch 镜像中,因此 Google 的客户默认即可获得定制堆栈。安装 gIB 后,我们得到了更好的图表,16 节点全对全(all-to-all)测试的峰值吞吐量提高了 4.4%。(请注意,这些测试均关闭了多节点 NVLink 架构,以隔离扩展网络的性能,此处即为 RoCE。)
虽然并非完美,但这看起来好得多,且整体指标扎实。至此,很明显网络架构健康,配置足够良好,寻求从系统中榨取更多性能的工程师可以拥有一个坚实的基线作为起点。
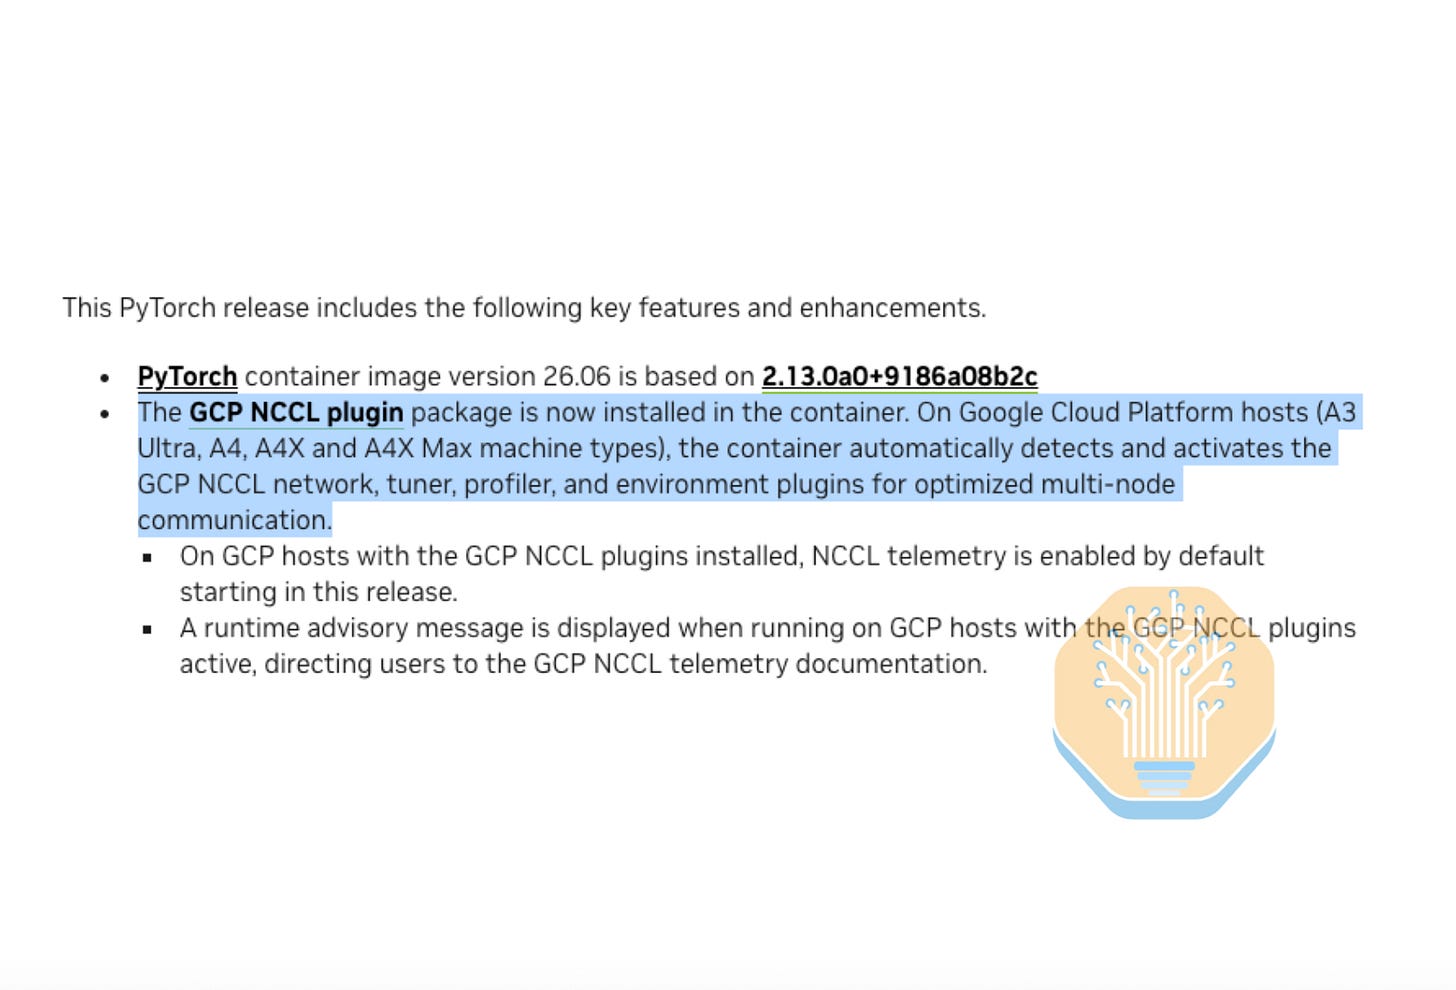
Nvidia 和 Google 为 Google 的 ConnectX-7/8 NCCL 插件设置自动激活功能,这是一项令人惊叹的工作。此前,用户需要折腾正确的库加载路径和环境变量才能正确设置并在 GCP Nvidia GPU 机器上的 ConnectX 网卡上优化性能。我们在几个季度前提供了反馈,而现在,这一切已完全自动化!
GKE 的健康检查运行良好。与那些拥有 NVL72 系统经验的其他提供商一样,Google 的健康检查进行了干预,但将恢复故障节点至集群的任务留给了操作员。具体而言,在注入 XID 后,健康检查标记了 GPUUnhealthy=True 和 cloud.google.com/health-check-status=warning,但仍将该节点保留为可调度状态。这种配置易于使用,它是 GCP 客户偏好的默认设置,并且可以根据用户喜好进行配置,以响应不同严重程度的错误。
为了继续改进,GCP 可以借鉴 Nebius 和 CoreWeave 近期所做的所有提升生活质量的变更。它应该提供一个更易导航的控制台,简化 IAM 和 RBAC,并确保通过标准 SSH 或 kubectl 访问集群的过程毫无痛苦,或者使其现有的 CLI 坚不可摧。特别是现在 gIB 已包含在默认的 Nvidia 镜像中,我们希望 GCP 的操作员能够顺利从其 GCP 扩展架构中获得良好的性能。他们还可以继续在中端市场追求 neolabs,改善现场支持体验,并加强与 Nvidia 的关系。GCP 经常因较小的、能力较弱的新型云服务商而失去大量业务,因为这些服务商要么缺乏 GPU 容量,要么拒绝在特定价格点服务市场。
我们期待在 GCP 的 VR NVL72 系统可用时对其进行测试,并见证 GCP 在可用性和性能方面的持续改进。
Oracle
正如我们在 ClusterMAX 2.0 中提到的那样,Oracle 在超大规模云服务商中处于独特地位,因为其增长必须来自大型合同。与 AWS、Google 和 Azure 不同,Oracle 没有任何销售前沿令牌的协议;与 Meta 和 Google 不同,它也没有一个可以依托的非前沿实验室。相反,它继续签订涉及 OpenAI、Meta 和 Nvidia 的大额交易,报告称从六月到八月“交付了额外的 850MW 数据中心容量”,这是一个令人咋舌的数字。我们预计其在 2027 年的相对增长率将是所有超大规模云服务商中最大的,尽管其基数最小。
我们测试了两个 Oracle 集群,我们将按顺序描述它们。第一个是部署在多平面网络上的 Slurm GB300 NVL72 集群。这是标准的 Slurm,但由于客户需求,Oracle 已将 Slurm-on-OKE 纳入其路线图。一旦我们的分配开始,我们试图通过控制台找到入口,但它证明像所有超大规模云服务商的控制台一样,是一个令人望而生畏的地方。
重要的是,Oracle 的控制台不支持 RBAC——控制台上没有任何内容与 SSH 用户关联——因此我们必须直接在机器上管理所有 SSH 密钥。有一次,尝试向 authorized_keys 追加内容时,我们的实习生忘记加 -a 标志,从而删除了我们之前所有的密钥。这显然是典型的用户错误,但这恰恰说明了为什么我们更喜欢在控制台上有一条加固的路径。我们宁愿不信任我们的实习生——尤其是那位,绝无冒犯之意——在命令行中输入魔法咒语,因为一个错误就可能让我们被锁定在集群之外。幸运的是,Oracle 的工程师立即发现了这个错误并为我们修复了它。
我们希望他们会修复此问题并添加企业级 RBAC。
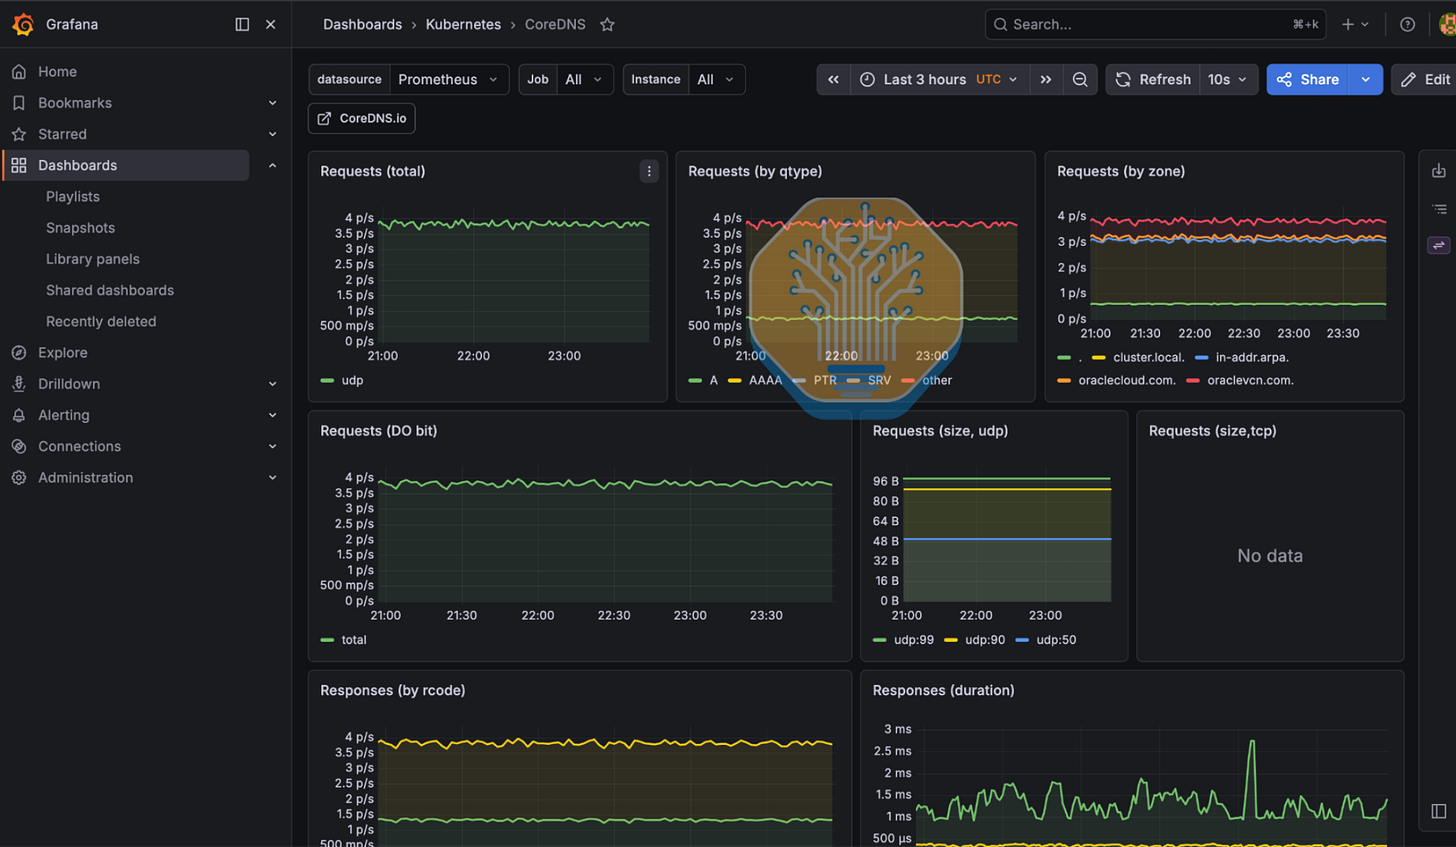
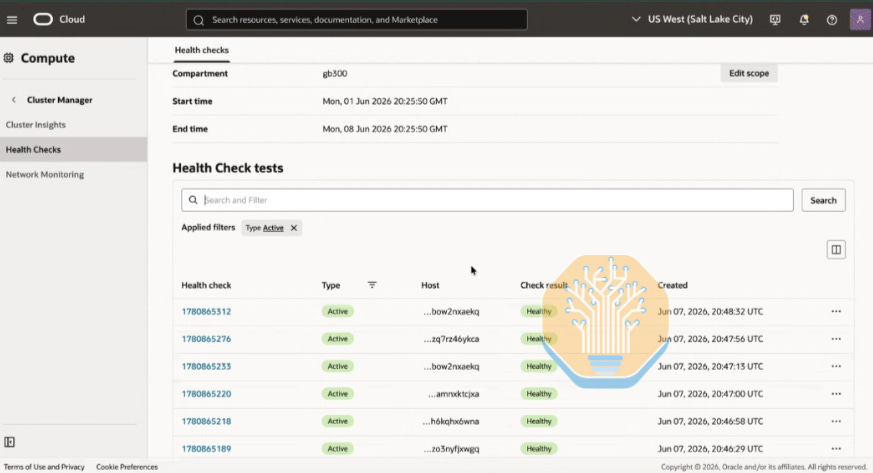
不出所料,Oracle 的集群从第一天起就表现良好。他们为我们提供了 InfiniBand 和 NCCL 测试脚本,这很有帮助,因为标准脚本无法正确利用所有 4 条轨道。压力测试完美无缺,Oracle 托管的 Lustre 实现了强劲的吞吐量。Oracle 的健康检查按预期工作,在我们的合成错误发生时排空了节点,但是否终止并替换 GB300 节点则由用户自行决定。Oracle 托管的 Prometheus 和 Grafana 表现不错,尽管并非完美。例如,它们未与作业计费的最终用户体验集成。然而,积极的一面是,健康指标现已集成到控制台中的 Cluster Manager 中,使得一目了然地查看关键状态变得更加容易。
接下来,我们使用 MI355X 对 OKE 进行了测试。这是除 TensorWave 之外唯一允许我们试用 AMD GPU 的提供商。体验颇为坎坷。
正如上次抱怨的那样,起初我们需要 SSH 登录到操作节点才能控制 Kubernetes。这次,团队迅速解决了我们的 Oracle CLI 问题,我们能够立即在本地下载凭据。然而,在这个集群上更大的问题出在网卡(NIC)上。峰值性能接近线速,因此我们无法检测到硬件问题。相反,问题出在 ionic 驱动程序上。我们对所有八张网卡进行的每条轨道 ib_write/ib_read 扫描在每个轨道上都达到了 391 Gb/s,但在完成后导致节点卡死:当 Pod 被删除时,perftest 进程从未完成其 rdma_cm 拆除;强制 kill 命令导致网卡的 destroy-CQ 命令超时,且 ionic_0 和 ionic_4 上的 RDMA 管理队列停止响应。更糟糕的是,两个端口仍显示为 400 Gb/s 的 ACTIVE 状态,且节点保持 Ready。被动检查未验证 RDMA 控制路径,且已有八天未运行主动检查。我们在 RCCL 持续失败后通过 grep dmesg 发现了该问题。Oracle 在周末迅速诊断出该问题并重启了集群:几天前,他们自己的 ibwrite 健康检查也在此集群上以相同方式失败。在一次通话中,我们解释了这些病态工作负载后,他们与 AMD 沟通并向集群推送了不同的驱动程序和固件,从而解决了问题。
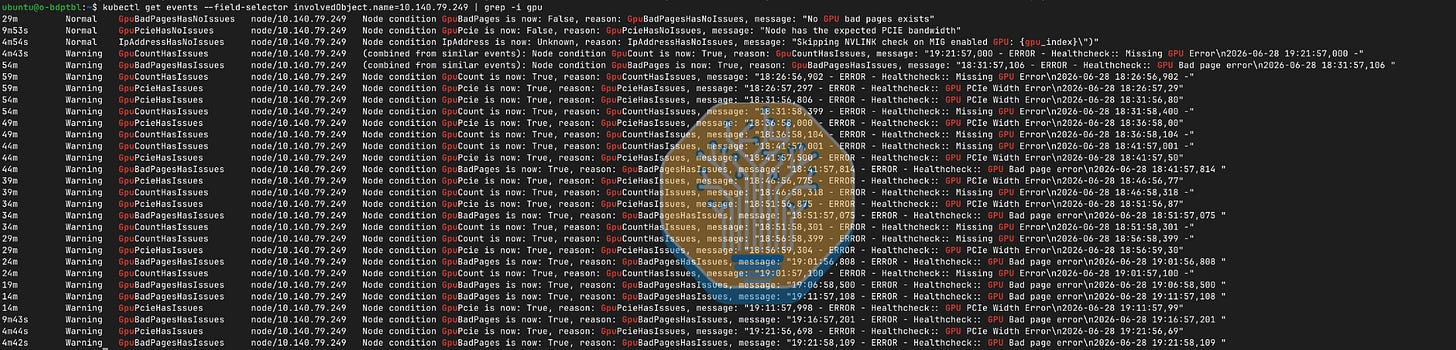
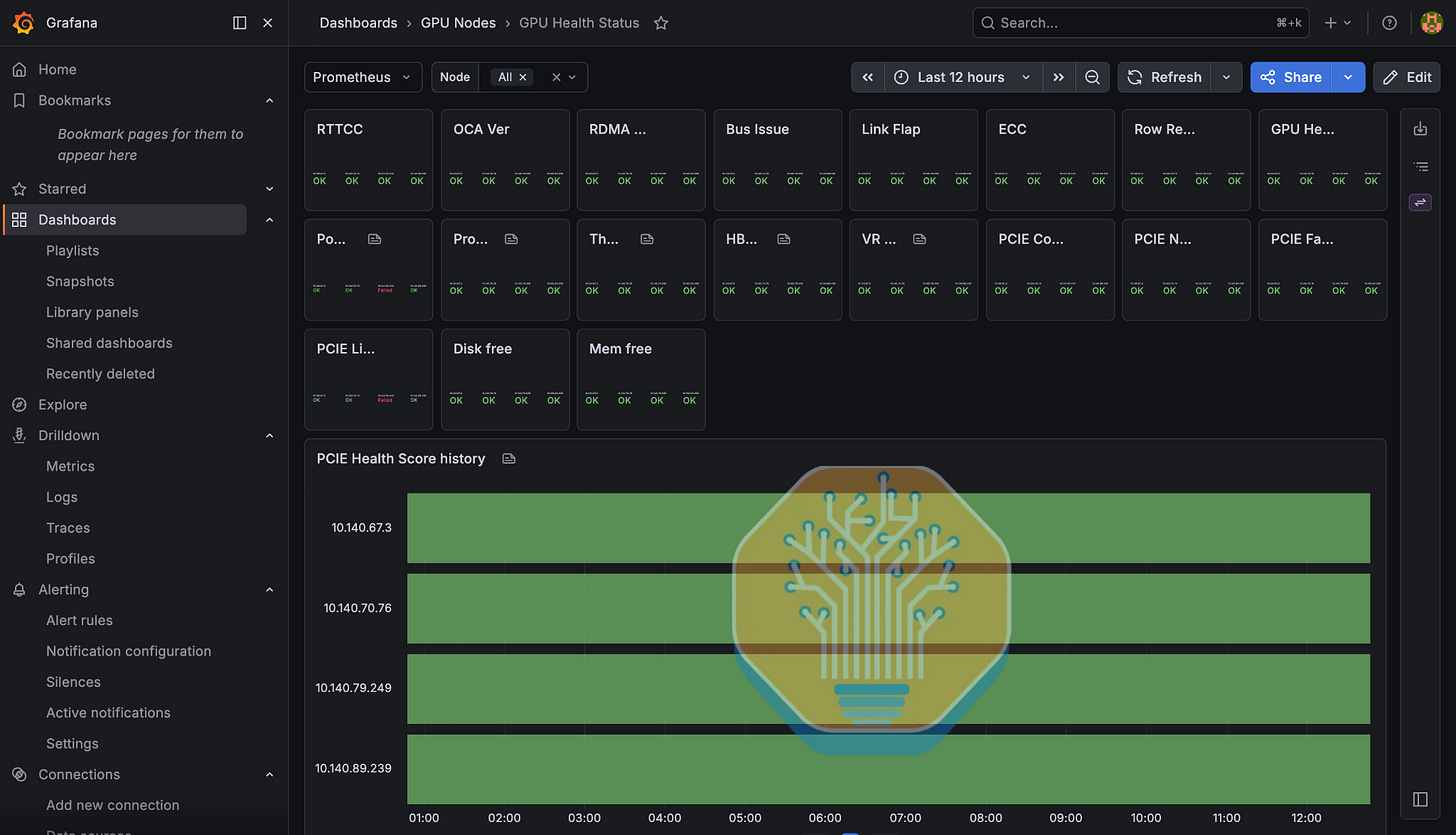
此外,我们还遇到 GPU 间歇性从 PCIe 总线掉线的情况,既未被健康检查捕获,也未在仪表盘中正确显示。Oracle 迅速更换了节点,并对我们在仪表盘方面的反馈做出了回应。
这是一次喜忧参半的经历,但 Oracle 的响应速度不错。令人特别不满的是,尽管已知这些驱动程序存在不稳定问题,却没有任何健康检查发出警报。尽管如此,Oracle 与 AMD 的紧密关系显然是一个优势。他们能够联系相关团队,诊断问题并快速部署补丁。这种支持在 Oracle 这样规模的组织中并不总是有保证。有趣的是,Oracle 是唯一被评为银牌或以上的提供商,也是仅有的两家被评为铜牌或以上的提供商之一,且已安装的库中没有适用 CVE 漏洞的软件。这更多是我们的一种期望而非优势,但它清楚地证明了他们的自动化系统能够有效地部署和升级集群。
如果我们是一家新创实验室,我们会对与 Oracle 合作充满信心。然而,鉴于 Oracle 越来越致力于为 OpenAI 等前沿实验室提供 Project Stargate 中的裸金属部署,这一点已无实际意义。在该业务领域的成功更多地取决于获得天然气管道建设的政府批准,而不是 RCCL 测试结果。
尽管如此,自上次测试以来,Oracle 取得了进步,整体体验非常好。我们期待今后继续密切关注他们的发展。
Silver
Lambda
Lambda 最近因参与 Anthropic 在纽西斯县 350 MW 的 350 亿美元交易而登上新闻头条,合作方包括 Hut8 和 Nvidia。在此之前,传闻他们正在准备 2027 年的 IPO,并分别为其扩建项目筹集了 10 亿美元、9.26 亿美元和 10 亿美元的债务。在所有增长之中,既然我们在 ClusterMAX 2.0 中将其评为银牌,这次我们很有兴趣评估 Lambda 的集群。
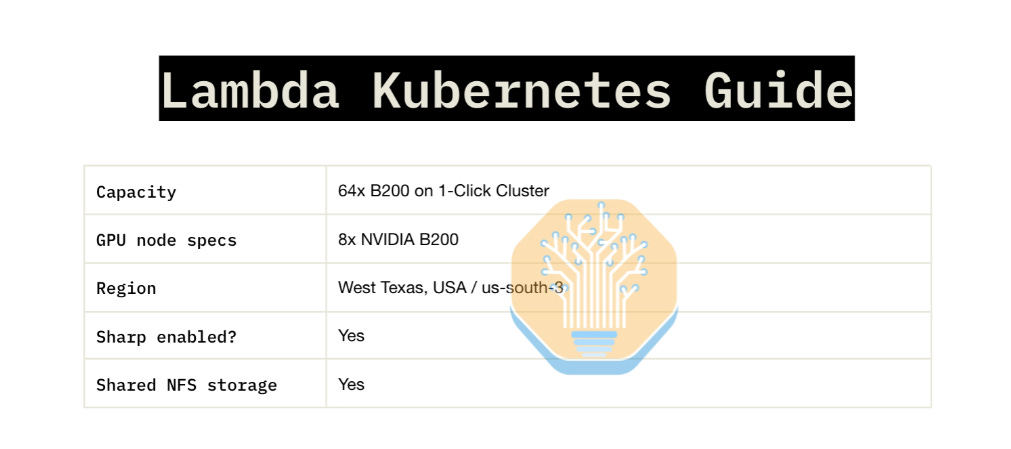
入职流程始于一个精美的演示文稿和 PDF,解释了在集群上会遇到的情况,访问权限也很快解决。
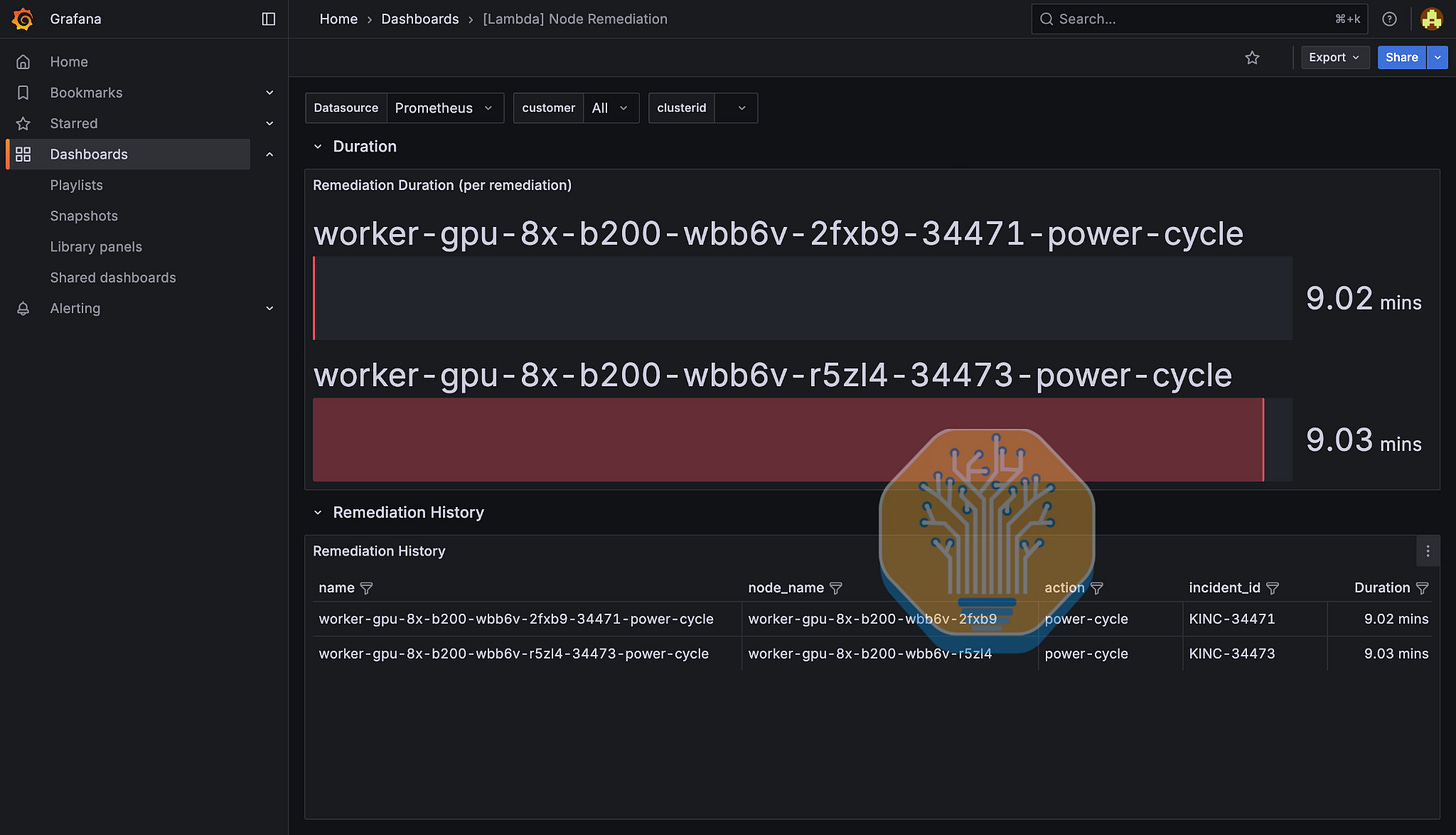
在 ClusterMAX 2.0 中,我们批评了 Lambda 的可靠性;而在这一轮测试中,可靠性成为了 Lambda 的重点关注领域。他们的被动健康检查覆盖了相关条件,并最终自动修复了我们在测试期间模拟的三个错误。两个合成 XID 在不到 15 分钟内被自动修复,并且有连接的控制台来监控节点健康状况。我们的测试通过重置 PCIe 次要总线复位触发了真正的 XID 79,导致节点进入 NotReady 状态,没有 GpuXid,没有设置 cordon(隔离),且在 Kubernetes 层没有任何监控可见性,但最终在 2 小时后重新加入了集群。我们在 Kubernetes 层的节点重启测试也顺利完成,未发生任何事故。
编排层有了显著改善,但仍存在少量问题。Slurm 配置中未设置每个任务的 CPU 数量,因此除非启动请求更多资源,否则 Slurm 的默认分配仅提供一个逻辑核心。Slurm 上未启用免密 sudo,因为我们使用的是托管式 Slurm 而非非托管式 Slurm。Lambda 是我们遇到的唯一做出这种区分的提供商,但显然他们的一些客户希望拥有自己集群的 root 访问权限,而另一些则不希望如此(?)。我们很享受在自己的集群上拥有 root 权限。
此外,还缺少无需分配即可 SSH 到计算节点的功能。如果其他人在运行作业且您无法附加到其分配的资源,或者某个作业卡住时,这会给调试带来麻烦。这也是我们喜欢集群上的“yolo 模式”的另一个原因。
更重要的是,Slurm 的软件版本过旧,包括位于默认路径 /usr/bin/nvcc 的 CUDA Toolkit 12.0(该版本过于陈旧,与 B300 SM100 架构不兼容)以及不可接受的过时驱动程序。值得庆幸的是,Slurm 确实配置了拓扑设置,他们提供的 NCCL 配方运行良好。我们在测试过程中没有遇到任何真实错误,所有测试(包括压力测试和存储测试)均表现出良好的性能。
在当今容量预订积压数月的背景下,我们对 Lambda 一键式集群的关注似乎显得有些过时。事实上,正如开篇所述,Lambda 正越来越多地通过裸机构建来推动其底线,完全脱离了托管集群。尽管如此,Lambda 的编排能力仍在持续改进,客户满意度高,这使得他们在 ClusterMAX 3.0 中跻身前列。
微软
由于微软的官僚主义,使用 Azure 集群可能会非常困难。他们的工程师已尽力而为,但这并非一个旨在灵活适应客户的组织架构。在品味相关的事务上,微软的客户并不优先。
在测试期间,我们不允许拥有自己的 Azure 账户,因此必须使用 Azure 某位工程师的用户名下的集群,这阻止了我们探索控制台并体验真实的入职流程。我们的 GPU 原本设置在弗吉尼亚州,但由于某些晦涩的内部法令,我们不允许在那里拥有控制平面。相反,我们的控制平面运行在德克萨斯州的圣安东尼奥。访问需要设置 VPN,经过一番来回折腾(见:整整 3 周)后才生效。堡垒机上禁用了粘贴功能,因此为了运行测试,我们必须手动输入 GitHub 和 HuggingFace 令牌。真的,是一个字符一个字符地手动输入。不过我们第一次就输对了,没什么大不了的 😮💨。
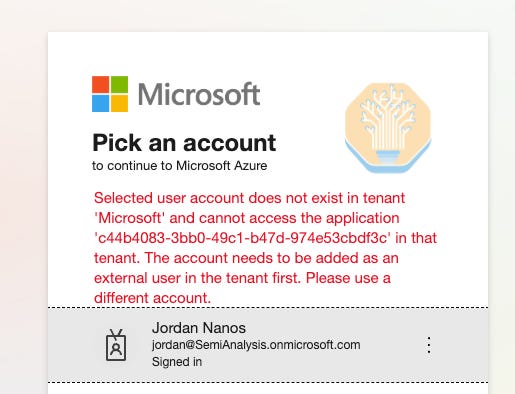
一旦一切终于运行起来,我们发现少数软件包版本过旧,且错误的默认 NCCL 配置导致首次运行失败。在 AKS 上,managed-csi-premium-v2 StorageClass 无法挂载,并且在 Azure Files Premium 上使用超过 4 个客户端运行 fio 时出现 EAGAIN 错误。没有并行系统连接到我们的 Slurm 集群,导致其中一个从 NFS 加载 DeepSeek-V4 的测试超时。
在进行压力测试时,我们的 Slurm 机架中有 10 个节点发生了真正的故障,导致任务中断。微软捕获了这些错误,将其追溯至一个状态不佳的主机,并打开了“客户健康报告”以进行修复。一条 scontrol resume 命令将它们恢复过来,此后,我们的 Kubernetes 和 Slurm 机架均顺利完成压力测试且未出现任何错误。
在通过注入合成 XID 来测试 Azure 的健康检查后,CycleCloud 立即排出了该节点,但并未恢复或替换它。由于我们拥有整个 GB300 机架,这令人满意,正如上文“Blackwell 和 Grace Blackwell”部分所述。
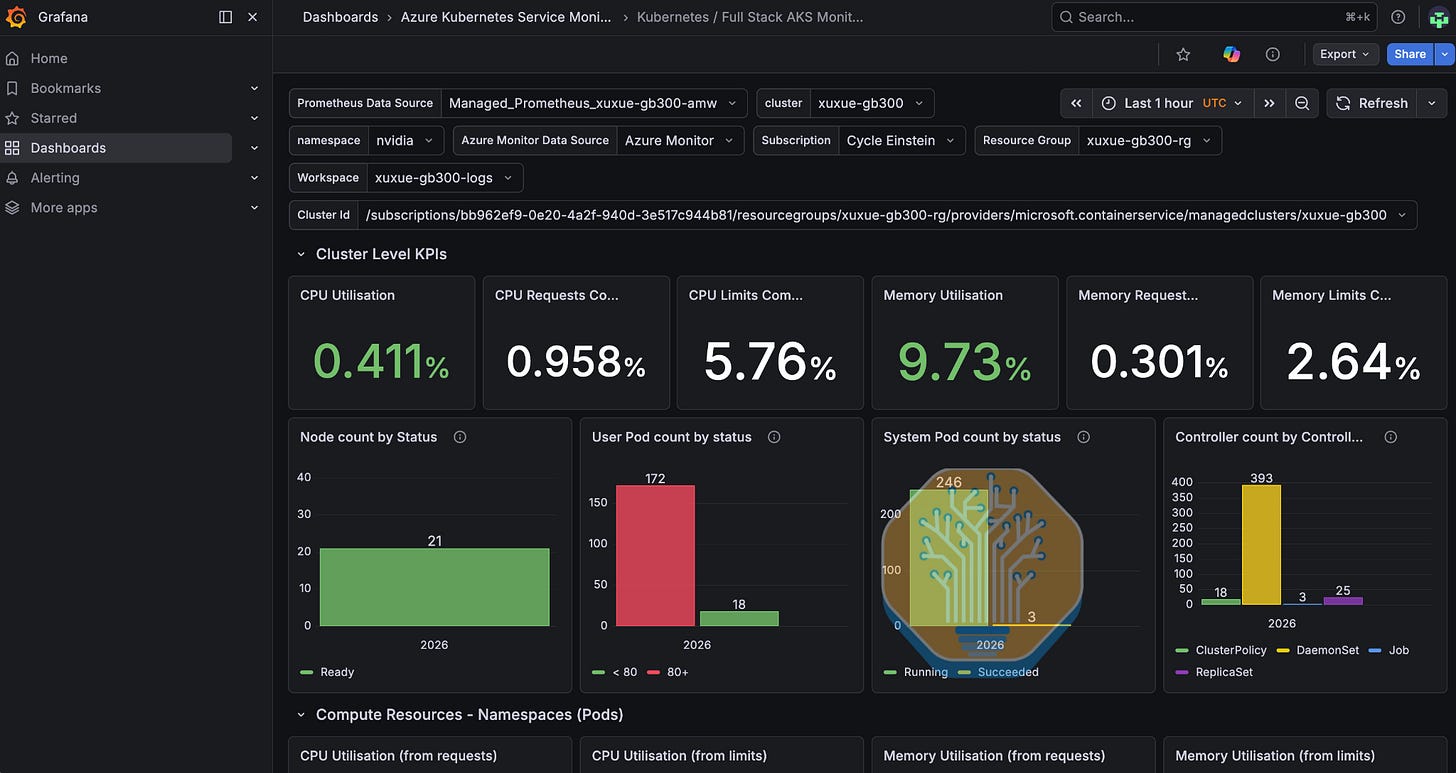
由于账户问题,我们无法默认看到 Kubernetes 仪表板。相反,Azure 的工程团队为我们定制了一套仪表板设置,其细节程度极高——这是对官僚主义束缚的一次坚实胜利。我们要特别感谢我们的朋友 Xu Xue,因为我们非常确定他为构建这套系统付出了远超职责范围的努力,但他不愿承认。他的精选仪表板已在此开源,对于任何人从头开始构建用于监控 Nvidia GPU 集群的 Grafana 仪表板来说,这是一个极好的资源。
Satya 曾称,“我们希望将 Azure 打造为能够完美支持长尾工作负载的平台”,并表示微软“并非只做五笔合同、服务五个客户的裸金属服务业务”。然而,要找到一家使用 Azure 进行训练和推理的风险投资支持的实验室却极为罕见。“为裸金属服务提供五个客户”的说法有些夸大。实际上只有两家:OpenAI 和 MAI。不久后将有三家,Anthropic 也将加入其中。
Azure 最有趣的资产在于,它可以托管 OpenAI 的模型并保留 100% 的收入。他们仍然完全访问 OpenAI 的所有知识产权。与此同时,Azure 还可以单独宣称与 OpenAI 达成了大型裸金属交易,以及与 Anthropic 日益丰厚的合作关系。这是一个极其强大的地位。仅就这一点而言也是如此。
由于 Azure 主要凭借巨大的部署规模和数千亿美元的资本支出在不同层面上竞争,其管理集群的能力使其更加灵活。与 Google 和 Oracle 一样,Azure 从无需帮助设置 ComputeDomain 的承购商那里获得现金流。但基于测试质量,这三家公司仍可能与那些希望获得更高接触度体验的实验室达成规模较小、利润率更高的交易。
尽管情况如此,但这似乎短期内不会发生。支持和控制台令人头疼,即使 Azure 是唯一可能在其扩展网络中获得 Nvidia 参考架构的超大规模云服务商。无论其他方面如何,我们都喜欢验证这些超大规模云服务商是否轻装上阵。
Firmus
Nvidia 最喜欢的冉冉升起的新星之一,也是我们在亚太地区的最爱,Firmus 于 8 月宣布完成一轮 20 亿美元融资,投后估值达 105 亿美元,用于在澳大利亚、马来西亚和印度尼西亚扩张,此前仅在 4 个月前完成了一轮 5.05 亿美元融资,估值为 55 亿美元。Firmus 还在 3 月筹集了 100 亿美元的债务融资,用于其在墨尔本和塔斯马尼亚的 Project Southgate 建设。就在上周,它披露了总计 900 MW 的合同容量,并宣布 OpenAI 成为其马来西亚扩建项目的锚定租户。总体而言,Firmus 今日已披露正在部署 18,400 块 GB300 GPU,今年晚些时候将在塔斯马尼亚部署 36,800 块,此外还有多个 GW 容量和数万 VR 在建。
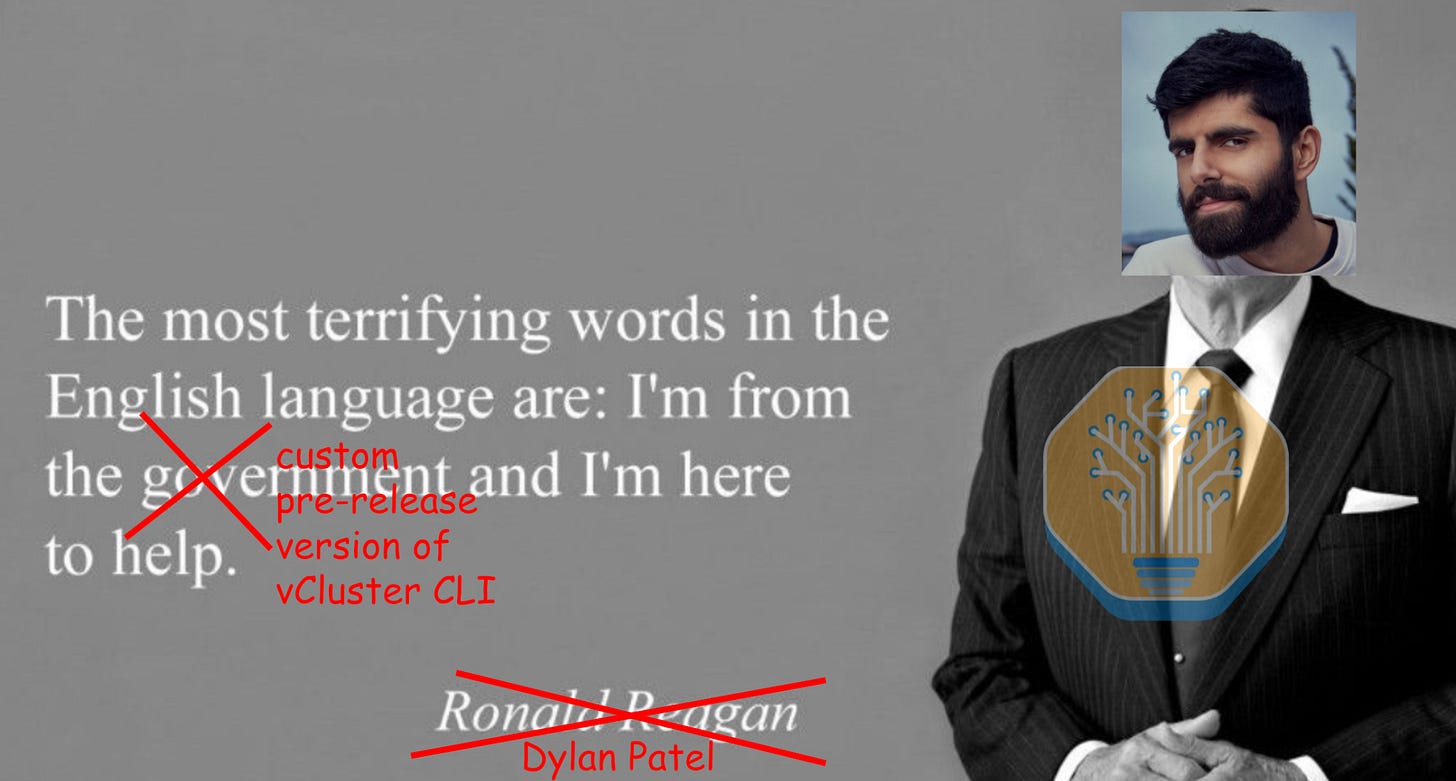
在测试 Firmus 的一个开发集群时,我们的起飞过程略显坎坷,但着陆相当平稳。访问我们的芯片需要使用 Microsoft Entra 账户、Microsoft SSO,然后下载并配置 vCluster CLI 的自定义预发布版本。我们是新技术的爱好者,但在集群访问方面,我们更倾向于直接使用 SSH。经过几轮来回沟通,并在 Firmus 团队的帮助下,我们终于成功连接。
……在集群上运行,但尚未完全就绪。Kubernetes 和 Slinky 的默认设置都存在不少问题。Slurm 登录节点没有 sudo 权限,也没有安装 vim 或 nano;虽然安装了 HPC-X,但未加入 PATH 环境变量,且缺少 NVCC。更重要的是,我们本应在一台机架获得 4 个 Slurm 节点、在另一台机架获得 4 个 Kubernetes 节点,结果却是每个机架上各有 2 个 Slurm 节点和 2 个 Kubernetes 节点。这未必是问题所在,但 Kubernetes 配置了 nvidia.com/gpu.clique 却没有任何任务使用它,而 Slurm 使用的是 topology/flat。因此,每个编排器可见的节点跨越了多个机架,没有任何机制来避免多节点作业不必要地跨越机架边界。我们必须推断节点的命名规则,以确保我们的测试部署得当。
此外,在测试期间,Kubernetes 控制平面的 etcd 可见性多次闪烁,导致我们的作业被终止,并引发 Slurm 和 Kubernetes 两层服务重启。这最终归因于交换机固件升级时出现的问题,且在最后 10 天内未再发生。我们在重启过程中还丢失了一个连接到分线器的 NIC(网络接口卡),由于 Firmus 的健康检查在我们测试的开发集群上并未激活,因此未能发现此故障。Firmus 是我们唯一能够暴露 GPU HBM 作为 NUMA 节点的 GB300 集群,这是一种有趣的配置,但我们将其标记为失败,因为如果主机端溢出,它会让你意外地淹没设备的 HBM。WAN(广域网)连接不稳定,但通常表现很差,到 NGC 的速度仅为 0.25 Gb/s。我们要解决的最后一个问题是,其中一个机架的 NVLink fabric 性能显著下降,这被解释为 Firmus 在其开发集群上进行实验的一种电源设置所致;修复该设置后,我们的性能数据恢复到了健康范围。
因此,到测试结束时,我们拥有了虽简陋但尚可接受的 Slinky 和 Kubernetes 层,知道了如何访问它们,并且能够在整个测试套件中获得强劲的性能。我们了解到托管集群目前并非 Firmus 的重点,但我们认为他们的技术团队在此方面仍有大量低垂果实可摘。随着 Firmus 努力将巨大容量上线,我们期待看到他们继续为用户使用其 GPU 软件栈带来便利。
TensorWave
TensorWave 是一家仅支持 AMD 的新兴云服务商,我们通过 K8s 和 Slinky 对其 MI355X 产品进行了测试。在上一次报告中,我们强调了 TensorWave 入职流程的困难,仅为了接入集群就经历了反复沟通,即使如此仍存在大量障碍。这次的情况有了显著改善。入职过程顺畅,直接发送给我们的 kubeconfig 完美运行,控制台允许我们轻松添加具有 SSH 访问权限的团队人员,且 TensorWave 的支持团队在整个测试过程中始终保持关注。
作为一家仅支持 AMD 的云服务商,TensorWave 在与 AMD 软件栈打交道时面临着艰难的挑战。尽管 AMD 近期取得了显著进展,但其软件栈仍远远落后于 Nvidia。我们在 TensorWave 集群上的 RCCL 微基准测试中看到了这一点,即使使用 TensorWave 的二进制文件和配方,all-gather 和 all-to-all 操作在 32 KiB 消息大小下也会挂起。其他集合操作表现出缩放不均匀,在某些消息大小下吞吐量较差。[编辑评论:RCCL?不如叫 Rick L!] 一般来说,可以说 AMD 的网络栈缺乏 Nvidia 工具所提供的社区支持。硬件方面亦然。比起微基准测试,更值得注意的是,GB300 NVL72 系统在行业内实验室中需求最大:其性能如此卓越,以至于即使考虑到其较高的价格,它们往往也提供最佳的每美元性能比。AMD 的机架级解决方案 MI455X Helios 仍在 ramp up 生产阶段,TensorWave 目前肯定尚未提供该产品。因此,TensorWave 在排名中的位置不仅取决于其自身的改进,还取决于 AMD 持续缩小与 Nvidia 差距的努力。
就其宣传而言,我们的 TensorWave 集群整体表现优异。南北向带宽强劲,存储性能卓越,老化测试顺利完成。在 Kubernetes 层进行压力测试时,其可靠性良好,且 Slinky 层易于使用。
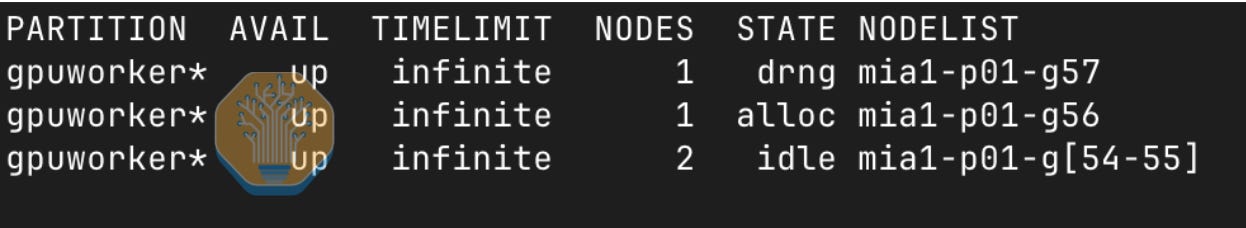
健康检查立即识别出我们模拟的故障,并将节点置于 drng 状态。
仪表盘奇怪地将该节点标记为“已分配”,而非将其单独归类。然而,不久之后,系统提供了一个诱人且醒目的按钮,供我们点击以批准用新节点替换这台“生病”的节点。
![](https://substackcdn.com/image/fetch/$s_!dP5B!,w_1456,c_limit,f_auto,q_auto:good,fl_progressive:steep/https%3A%2F%2Fsubsta
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。