精选
用开源智能体技能提升医疗与生命科学领域的 AI 推理能力
针对基础模型智能体在医疗与生命科学(HCLS)决策中常引用正确指南却错误应用的问题,作者开源了覆盖 11 个 HCLS 领域的 38 个智能体技能,并给出安装步骤、三个实际用例,以及基于 410 条提示词的评测,显示胜率达 70%–86%。
基于基础模型(FM)构建的 AI 智能体常常会错误应用医疗健康与生命科学(HCLS)决策框架,即使它们在训练和系统提示中已经见过相关指南。让一个智能体使用 ACMG/AMP 标准对 TP53 错义变异进行分类,它会引用正确的框架,却错误应用证据类别、跳过人群频率阈值,或幻觉出计算预测器评分。模型知道事实,但缺乏领域从业者经过多年训练内化的结构化推理流程。这一差距会在变异解读、理赔裁定、临床试验设计和影像分析中产生无声失败。输出看起来正确,却应用了错误标准,并带来监管和患者安全后果。
在这篇文章中,我们分享了一套包含 38 个开源智能体技能的集合,覆盖 11 个 HCLS 领域,帮助弥合这一方法论差距。我们将介绍安装过程,并展示如何在各类智能体 AI 服务中使用它们。我们分享评估结果,以证明在药物发现、医疗运营和医学影像工作流中取得了可衡量的改进。配备这些技能的智能体,在相同智能体但未配备技能的对比中,于 70%–86% 的一对一比较中获胜,具体取决于智能体运行框架设置。效果最强的是批判性思维(78%–85% 胜率,d = 0.65–1.03)。我们还会展示如何针对你的具体用例自定义、扩展并创建你自己的智能体技能。
解决方案概述
HCLS Agent Skills 集合中的智能体技能是结构化 markdown 文档(SKILL.md),它们将领域决策流程编码为 AI 智能体可在推理时通过渐进式披露消费的格式。遵循 Agent Skills 开放标准,每个技能都在 YAML frontmatter 中声明触发器、依赖项和元数据。其后的内容包含决策框架、参数表、代码模式和验证标准。该集合涵盖 11 个 HCLS 领域中的 38 个技能,包括基因组学、药物发现、理赔运营和医学影像。请参阅完整技能目录,以获取按领域组织的完整列表。所有内容均在 MIT-0 许可证下发布。
此仓库中的技能被归类为推理技能或流水线技能。推理技能编码指导智能体如何思考的方法论和决策框架。例如,genomic-variant-interpretation 技能编码了完整的 ACMG/AMP 分类框架,如证据类别、人群频率阈值和计算预测器截断值。流水线技能编码工具特定命令、经验证的参数和可生成可运行产物的代码模板。variant-calling 技能提供带有正确注释组的 GATK4 HaplotypeCaller 命令、VQSR tranche 灵敏度目标以及 Mutect2 肿瘤-正常配置。
这种双重分类法使智能体既具备做出正确决策的判断力,也具备执行这些决策的技术精确性。与检索增强生成(RAG)不同,后者从索引文档中检索有限段落来增强响应生成,技能编码的是决策流程和错误条件本身。技能也不是微调。它们是结构化提示,会根据用户查询中的触发模式在上下文中激活。
有三个特性使技能区别于其他领域专业化方法。技能可审计、可移植,并且易于维护。每一条决策标准都以 markdown 格式供人阅读,而不是隐藏在模型权重中。一个技能可跨 20 多种服务使用(Amazon Bedrock AgentCore、AWS Strands Agents SDK、Kiro、Amazon Quick Desktop、Claude Code、OpenAI Codex 等),无需针对每项服务进行定制。年度医疗政策变化或新的实验标准可以通过编辑文本文件快速反映,而不是重新训练模型。
现在你已经了解技能包含什么,接下来让我们进行设置。
先决条件
要跟着本文中的示例操作,你需要使用 AWS 提供的以下受支持服务之一:用于交互式技能使用和多智能体编排的 Kiro 或 Kiro CLI、带有 Amazon Bedrock 基础模型访问权限的 AWS Strands Agents SDK、AgentCore harness(Amazon Bedrock AgentCore 的一项能力,需已有智能体实现),或用于基于 GUI 的技能管理的 Quick Desktop。你也可以使用自己选择的编码智能体 harness,例如 Claude Code 或 OpenAI Codex。你还需要 Python 3.10+ 及 uv,以及用于克隆仓库的 Git。
git clone https://github.com/awslabs/hcls-agent-skills.git
cd hcls-agent-skills
npx skills add awslabs/hcls-agent-skills对于 Kiro,install.sh 脚本会同时安装技能和一个预配置的智能体,该智能体已配备这些技能。该智能体会自动处理技能路由,因此你无需按名称调用单个技能。运行 ./install.sh --target kiro,然后在 Kiro CLI 中使用 /agent hcls 切换到该智能体。对于多智能体模式,运行 ./install.sh --target kiro --mode multiagent 并使用 /agent hcls-multiagent。
from strands import Agent
from strands.skills import AgentSkills

agent = Agent(
    model=model_id,
    skills=AgentSkills(skills="./skills/"),
)
对于 AgentCore,请按照 Skills 的说明将智能体技能添加到由 AgentCore 托管的智能体中。AgentCore 提供托管式托管、自动扩缩容、安全边界和可观测性能力。
对于 Amazon Quick Desktop,运行 ./install.sh --target quick-desktop 以查看在图形界面中添加技能的完整说明。或者,按照 Amazon Quick 文档中 Skills 的说明操作。
解决方案演练
安装技能后,我们演示三种部署模式:Quick Desktop 中最简单的单智能体方法、Kiro CLI 中解决上下文工程挑战的多智能体编排,以及在 Amazon Bedrock AgentCore 上使用 Strands SDK 的生产部署。然后我们展示三个示例用例,突出技能在真实 HCLS 工作流中带来的可衡量差异。
Quick Desktop 中的智能体技能实战
安装技能后,Quick Desktop 的智能体无需额外配置即可获得结构化的 HCLS 领域推理能力。当你提出领域问题时,智能体会根据查询中的触发模式自动激活相关技能。例如,询问“编码 E11.9 而非 E11.42 的 RAF 影响是什么?”会触发风险调整技能,智能体会给出具体的 HCC 映射、层级解析和量化的 RAF 差值,而不是泛泛地建议“审查文档”。技能是选择性激活的。响应中只会触发相关技能,有助于保持输出聚焦且准确。以下视频展示了在 Amazon Quick Desktop 中为问题动态加载技能的过程。
Kiro 的多智能体架构
将所有 38 个技能加载到单个智能体上下文中会消耗约 80K token。对于大上下文模型来说这是可行的,但它带来了上下文工程挑战。智能体必须在每次查询时从 38 个可用技能中选择正确的子集,而不相关的技能内容会争夺注意力。另一种方式是显式调用技能(例如 /risk-adjustment),但这要求你在提问之前就知道该调用哪个技能,而这正是技能旨在弥合的专业知识差距。
Kiro CLI 的多智能体架构解决了这两个问题。一个轻量级协调器智能体(不加载技能)将查询路由到八个领域专家,每个专家只加载其相关技能(每个专家约 15K token)。协调器处理意图分类,而专家处理领域推理。专业化可按下表所述进行定义。
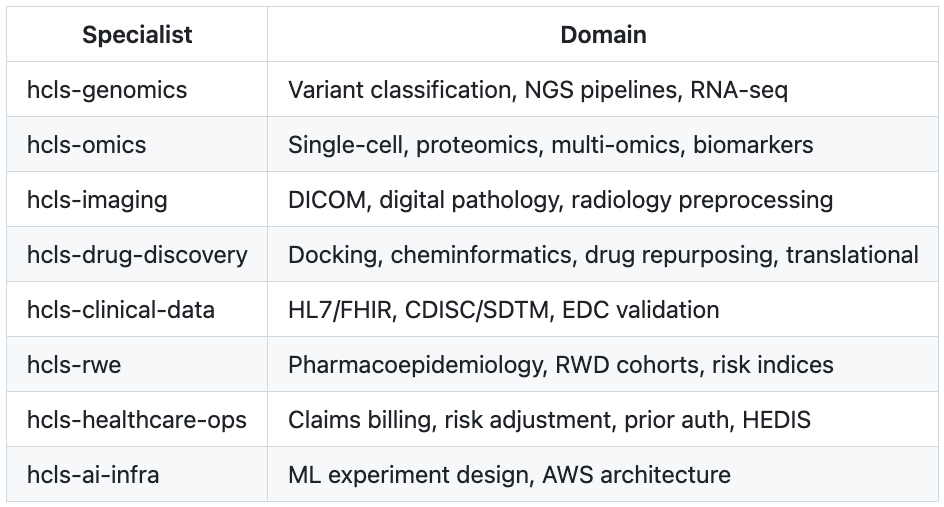
多智能体配置在 JSON 智能体文件中定义。有关路由逻辑,请参阅协调器智能体配置;有关领域技能如何附加到专家智能体的示例,请参阅专家智能体配置。以下视频展示了多智能体和动态技能激活如何在 Kiro CLI 中处理代码库的同时,回答一个复杂的药物重定位问题。
Strands SDK 集成
from strands import Agent
from strands.skills import AgentSkills
from strands.multiagent import MultiAgentOrchestrator

# Define domain specialists with their skill sets
genomics_agent = Agent(
    name="hcls-genomics",
    model=model_id,
    skills=AgentSkills(skills="./skills/genomics/"),
)

imaging_agent = Agent(
    name="hcls-imaging",
    model=model_id,
    skills=AgentSkills(skills="./skills/imaging/"),
)

# Coordinator routes to specialists
coordinator = MultiAgentOrchestrator(
    agents=[genomics_agent, imaging_agent, ...],
    model=model_id,
)

response = coordinator("Classify NM_000546.6:c.743G>A in TP53 using ACMG criteria")
部署到 Amazon Bedrock AgentCore
当你的配备技能的智能体在本地运行正常后,你可以将其投入生产环境。Amazon Bedrock AgentCore 提供了一条替代路径,可将技能注入托管智能体。除了将它们嵌入 Strands 智能体代码之外,你还可以在环境级别配置技能,使其可供在该运行框架中运行的智能体使用。AgentCore 运行框架提供托管托管、自动扩缩容、安全边界和可观测性能力,而无需管理基础设施。请遵循 AgentCore 文档中的 Skills 部分。
部署部分已经介绍完毕,接下来让我们看看配备技能的智能体在实践中会产生什么结果。以下示例用例取自我们的评估提示集。
用例 1:在药物发现中评估罕见纤维化疾病的重定位候选药物
一家生物技术公司的团队正在研究特发性肺纤维化(IPF)的药物重定位,希望评估已获批药物中通过受体激酶 TGFBR1(ALK5)调节 TGF-β1 信号通路的药物。在实践中,研究人员需要查询药物-基因相互作用数据库,按证据强度对候选药物进行排序,评估作用机制与 IPF 病理生理学的重叠程度,并根据现有安全性数据判断可转化性。然而,研究人员可能会很快地向智能体提出一个模糊的提示:“我正在研究 TGFBR1 作为 IPF 治疗靶点。有没有值得重定位的已获批药物?最强的候选药物是什么,临床转化有多现实?”
在添加技能之前,智能体会提供一份笼统的文献综述,列出已知的 TGFBR1 抑制剂,但没有结构化排序标准、证据层级或可转化性评估框架。为智能体配备技能后,智能体会触发药物重定位和转化研究技能,并执行以下操作:
- 智能体应用 DGIdb 查询框架,优先考虑相互作用类型(抑制剂 > 调节剂 > 结合剂)和来源数据库(ChEMBL、DrugBank),而不是置信度较低的来源。
- 它使用结构化证据层级对候选药物进行排序,其中直接靶点结合优先于通路级证据,通路级证据又优先于表型关联,并将现有适应症相关性作为修正因素。
- 它通过将 TGFBR1 抑制映射到 IPF 的关键病理过程来评估作用机制重叠:成纤维细胞向肌成纤维细胞转化、上皮-间充质转化和细胞外基质沉积。
- 它使用 T0→T1 标准评估临床可转化性,检查来自原始适应症的现有安全性数据、治疗窗口兼容性,以及可用临床前纤维化模型与人类疾病之间的一致性。
该技能链将表面化的回答转变为结构化的、考虑监管要求的评估,并带有量化的证据排序。
用例 2:在医疗索赔运营中构建 CMS-HCC 风险调整流水线
一个拥有12,000名成员的Medicare Advantage计划需要利用CMS-HCC Model V28系数,从ICD-10诊断索赔数据中计算风险调整因子(RAF)评分。该流水线必须应用ICD-10到HCC的交叉映射,正确解析疾病层级,并在纳入人口统计学调整后计算最终的成员级风险评分。然而,一名初级分析师可能会这样提示智能体:“我们是一个拥有12,000名成员的Medicare Advantage计划。我们在PostgreSQL数据库中有ICD-10诊断索赔数据(member_diagnoses和member_demographics表)。帮我构建一个流水线,用于计算当前支付年度的成员级RAF评分。”
在添加技能之前,智能体会生成一个看似合理但不完整的流水线,通常完全遗漏层级解析,使用过时的V24系数,或在求和之后才应用层级关系(这会抬高评分)。在为智能体配备技能之后,智能体会触发risk-adjustment和claims-billing-rules技能,并执行以下操作:
- 智能体生成正确的SQL,将诊断代码与ICD-10到HCC交叉映射表连接,并在测量年度内去重,确保每位成员的每个HCC只计数一次。
- 它正确实现V28层级解析,其中HCC 18(伴慢性并发症的糖尿病)优先于HCC 19(不伴并发症的糖尿病),HCC 326(CKD 5期)优先于HCC 327(CKD 4期),有助于防止在多个特异度层级上重复计数。
- 它在汇总HCC系数之前,通过将成员分类为社区、机构或双重资格人群,并应用年龄/性别调整,来实现正确的人口统计学分层。
- 它主动解释,跳过层级解析会在多个特异度层级上重复计算病症,系统性地抬高RAF评分,并在CMS RADV审查下造成审计责任。
该技能支持生成可经审计辩护的RAF评分,而不是会触发CMS RADV审计发现的高估结果。
用例3:医学影像研究中用于基于体素的形态学分析的T1加权MRI预处理
一项纳入45名健康成年人的神经影像研究,需要一套标准的T1w预处理流水线,用于基于体素的形态学(VBM)分析。原始DICOM数据已转换为NIfTI。该流水线必须在FSL/ANTs混合环境中,按照正确顺序并使用适合健康成人大脑的参数,进行重定向、偏置场校正、颅骨剥离,并配准到MNI152空间。一名研究人员可能会这样提示智能体:“我有45份健康成人T1w扫描,需要进行预处理以用于VBM分析。请使用FSL和ANTs构建一个流水线。”
在添加技能之前,智能体会建议一个合理的流水线,但可能将偏置校正排在颅骨剥离之后(这会使脑掩膜产生偏差),使用不合适的阈值,或遗漏故障模式检测策略。在为智能体配备技能之后,智能体会触发radiology-preprocessing和imaging-study-design技能,并执行以下操作:
- 智能体明确正确的处理顺序并给出理由:先重定向到标准空间,然后在颅骨剥离之前进行偏置场校正,接着使用针对健康成年人调优的参数进行脑提取,最后配准到MNI152模板。
- 它解释了关键的顺序依赖关系。如果未先进行偏置校正,脑边界处的强度不均匀会使颅骨剥离算法移除过多或过少的组织,尤其是在颞区和额区。
- 它提供了一个完整的bash脚本,在每个阶段都有错误检查,并提供质量控制输出,用于对中间结果进行可视化检查。
- 它记录了每个步骤的故障模式:方向元数据不正确、表面线圈附近残留信号阴影、提取阈值过于宽松时包含颈部组织,以及老年受试者心室边界处的配准失败。
该技能能捕捉到会给VBM分析引入系统性偏差的顺序依赖关系。
这些用例说明了HCLS技能如何从质上重塑智能体的行为,从而产生更贴合领域的响应,但对于研究人员和开发者来说,究竟能好多少始终是个问题。
评估结果
我们进行了一项成对评估,使用两种harness配置,在410个领域提示(380个单技能提示和30个跨技能提示)上衡量技能的影响。两种智能体harness配置中的一种是Kiro CLI,其中使用Auto模型让Kiro为任务选择最优模型。Kiro中的智能体可以访问思考工具和文件读取操作。另一种智能体配置是使用AWS Strands Agents SDK构建的智能体,采用Agent(model=BedrockModel(...), callback_handler=None),并将模型显式固定为Claude Sonnet 4.6。技能条件还额外加载了AgentSkills(skills="./skills/")插件。两种条件对称地提供了思考工具。配置可在eval/execute.py中找到。在两种配置中,都比较了两种条件。一种是不访问任何技能的基线智能体。另一种是通过渐进式加载调用全部38项技能的技能智能体。
我们采用五个评分维度,让大语言模型(LLM)评判员衡量技能如何影响智能体的响应。科学准确性评估事实、机制、引用和领域知识的正确性。连贯性评估响应是否遵循逻辑结构,具有清晰的推理链和内部一致性。相关性衡量智能体在保持切题的同时,以适当深度处理提示所有部分的程度。批判性思维捕捉智能体挑战假设、识别局限并考虑替代方案的能力,而不是给出单一未经审视的响应。可操作性评估智能体提供具体后续步骤、特定参数和可运行命令的能力,使从业者可以立即采取行动。我们使用Amazon Bedrock的Claude Opus 4.7作为评判员。完整评分提示在eval/judge.py中。
评判员以0–100分制对每个维度评分。然而,LLM评判员会出现分数压缩现象,即分数聚集在某个范围内,使原始差值(例如+1.5)难以解释。因此我们报告两个主要指标。首先报告胜率(WR),即技能条件得分高于基线的提示百分比。这是一个直观的指标,并且对分数压缩具有稳健性。其次报告Cohen’s d效应量(简称d)。这是用来衡量两组均值之间的标准化差异。它通过平均差值除以合并标准差计算得出。这衡量了相对于自然方差的改进幅度。Cohen’s d的一般解释为0.2(小)、0.5(中)和0.8(大)。
总体而言,在两种智能体harness配置中,技能在正面比较中赢得69.5–85.9%的胜率。技能在两种配置中都提升了批判性思维、可操作性和科学准确性。最强信号出现在批判性思维上,这证实了技能的主要贡献是方法论层面的:教会智能体应用哪些框架、挑战哪些假设、标记哪些局限,而不是添加基础模型可能已经拥有的事实内容。下表总结了高层结果。
| 指标 | Kiro CLI | Strands Agent |
|---|---|---|
| 评估提示数 | 410 | 410 |
| 技能总体WR(d) | 69.5% (0.39) | 85.9% (0.97) |
| 批判性思维WR(d) | 78.0% (0.65) | 85.1% (1.03) |
| 科学准确性WR(d) | 69.3% (0.34) | 86.2% (0.85) |
| 可操作性WR(d) | 68.0% (0.37) | 77.3% (0.56) |
| 基线-收益相关性(r) | -0.59 | -0.61 |
| 最大方差降低 | -61.9% | -52.1% |
基线强度带来的影响
有强有力的证据表明,当基础智能体表现最吃力时,智能体技能带来的帮助最大。基线响应质量与技能收益之间的皮尔逊相关系数在 Kiro CLI 中为 −0.59,在 Strands agent 中为 −0.61。我们根据基线智能体的总体得分将提示分为三个层级:弱、中、强。大多数提示属于中等层级,技能在此提供了明显收益。属于强层级的提示——即模型已经表现良好——从智能体技能中获得的提升微乎其微。弱层级代表基础智能体吃力的情形。这些情形跨越多个领域(临床数据、医疗运营、基因组学),通常涉及多步骤监管流程或模型只能近似而非精确应用的细分方法论。
然而,强层级的发现并非绝对。跨领域推理技能即使在 90.2 的强基线下也达到了 80% 的胜率,这表明精心设计的方法论框架在整个质量谱系上都能增加价值——当它们教会模型一种模型自身不会应用的决策程序时。
按基线强度划分的基线和技能智能体总体得分如下表所示。
| 基线层级 | N | 基线(均值±标准差) | 技能(均值±标准差) | 差值 | 胜率 |
|---|---|---|---|---|---|
| 弱 (<80) | 15 | 75.8±4.0 | 84.4±6.3 | +8.7 | 87% |
| 中 (80-90) | 227 | 86.8±2.5 | 89.1±3.3 | +2.3 | 79% |
| 强 (>90) | 168 | 91.3±1.0 | 91.0±2.5 | -0.3 | 55% |
方差缩减
技能还降低了某一领域内所有样本提示的响应得分标准差。例如,在 Kiro CLI 中加载技能后,评审对临床数据响应的评分标准差从 6.8 降至 3.3,降低了 51%。这意味着技能使输出更加一致,遵循技能中编码的知识和框架。在一致性对平均质量同样重要的受监管 HCLS 工作流中,这种方差缩减是有意义的收益。
完整的评估方法、提示和原始结果可在评估技术报告中获取。
扩展技能和构建新技能
这些结果是针对仓库中附带的 38 项技能。您团队的工作流可能需要不同的阈值、额外的协议或全新的领域覆盖。仓库包含三份技能定制指南:
- CUSTOMIZING.md 涵盖了修改、扩展和从零创建技能的实用工作流,包括向现有技能添加组织特定规则(LCD 代码、处方集阶梯治疗、内部协议)。
- SKILL_DESIGN_GUIDE.md 记录了编写有效技能的循证模式:决策树、阈值表、易错点列表、响应格式部分,以及与高评估胜率相关的结构特征。
- QUALITY_CHECKLIST.md 提供了合并前的质量检查清单,涵盖 frontmatter、结构、内容质量和测试要求。
要为您的组织定制技能,首先复制相关的 SKILL.md 并修改决策阈值、添加组织特定协议或删除不相关的部分。使用设计指南来组织新内容以获得最佳结果。例如,推理技能受益于决策树和编号流程,而流水线技能通过参数表和版本特定的易错点提供强大价值。
uv venv --python 3.12 && source .venv/bin/activate
uv pip install -e ".[dev]"
# Generate 30 evaluation prompts for each of the skills
python eval/generate_prompts.py --count 30
# Run pairwise evaluation against your modified skills
python -m eval.run --skills ./my-custom-skills/ --parallel 2
python eval/build_review.py
open eval/results/review.html
以下视频展示了 review.html 评估仪表板,其中包括每次评估的评分、领域细分、提示和响应。
显示分数、领域细分、提示词和响应的 review.html 评估仪表板
该评估会生成成对比较,显示你修改后的技能相对于基线是否改进了响应,并按维度提供细分,与前面报告的结果完全一致。按照贡献指南,将新的领域技能回馈到开源集合中。
清理
技能是本地文件,不会创建 AWS 资源。本文中的示例无需拆除。如果你将 Strands agent 部署到了 Amazon Bedrock AgentCore harness,请按照“清理”步骤删除已部署的 agent 资源。
结论
Agent skills 为你的 HCLS agents 提供结构化的领域方法论。agent skill 中的决策框架、监管阈值和常见错误检查清单,可以将近似答案转化为精确答案。凭借覆盖基因组学、药物发现、理赔运营、医学影像等的 38 项技能,你可以在 Quick Desktop、Kiro 或运行于 Amazon Bedrock AgentCore 的基于 Strands SDK 的架构上部署领域专家 agents。
可衡量的影响不言自明。我们的评估显示,使用技能的 agent 胜率为 70–86%,在批判性思维方面提升最强(d = 0.65),并且在无引导 agents 最容易失败的最难查询上提升最大。技能是可审计的文本文件,你可以根据组织的协议进行自定义,并使用随附的评估框架进行测试。
- 克隆仓库
- 使用 Kiro 或 Amazon Quick Desktop 以交互方式使用技能
- 使用 AWS Strands Agents SDK 构建自定义 agents
- 使用 Amazon Bedrock AgentCore 将 agents 部署到生产环境
- 在 Amazon Bedrock 上探索基础模型
关于作者
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。