精选
为 Amazon Bedrock 知识库选择向量存储
AWS 发文对比 Amazon OpenSearch Service、Aurora PostgreSQL(pgvector)与 S3 Vectors 三种向量存储在 Amazon Bedrock 知识库 RAG 应用中的表现,覆盖三类 RAG 场景,给出基准测试结果与选型框架,帮助开发者在性能与成本之间做取舍。
标题:为 Amazon Bedrock Knowledge Bases 选择向量存储
正文: 在使用 Amazon Bedrock Knowledge Bases 构建检索增强生成(RAG)解决方案时,选择合适的向量存储会影响性能和成本。Amazon Bedrock Knowledge Bases 提供全托管选项和客户托管选项,后者允许您选择自己的向量存储。本文聚焦于客户托管路径,针对不同的 RAG 使用场景,比较三种受支持的后端:Amazon OpenSearch Service、带 pgvector 的 Amazon Aurora PostgreSQL,以及 Amazon S3 Vectors(Amazon Simple Storage Service(Amazon S3)的一项功能)。
有关所有 AWS 向量解决方案的更广泛指导,请参阅 AWS vector solutions: Build agentic AI where your data lives。有关向量数据存储在生成式 AI 应用中的作用,请参阅 The role of vector datastores in generative AI applications。有关 RAG 向量数据库的规范性指导,请参阅 Choosing an AWS vector database for RAG use cases。
向量数据库如何融入 RAG 解决方案
RAG 架构将大型语言模型(LLM)的能力与信息检索系统相结合,以生成更准确、更新且与上下文更相关的响应。它基于向量的数学概念,其中文本被转换为与文本含义对齐的向量。对向量执行的搜索将找到与问题含义相似的结果,这比关键词匹配更能有效捕捉语义相似性。
当用户提交查询时,会使用嵌入模型将其转换为向量嵌入。向量数据库中的文档内容已经过预处理、分块,并存储为向量嵌入;向量数据库执行相似性搜索,以找到嵌入与查询最相似的分块。通常,系统会检索前 n 个分块(例如最相似的前五个)来丰富原始查询。这些检索到的分块会作为附加上下文提供给 LLM,以便其生成更有依据、更准确的响应。
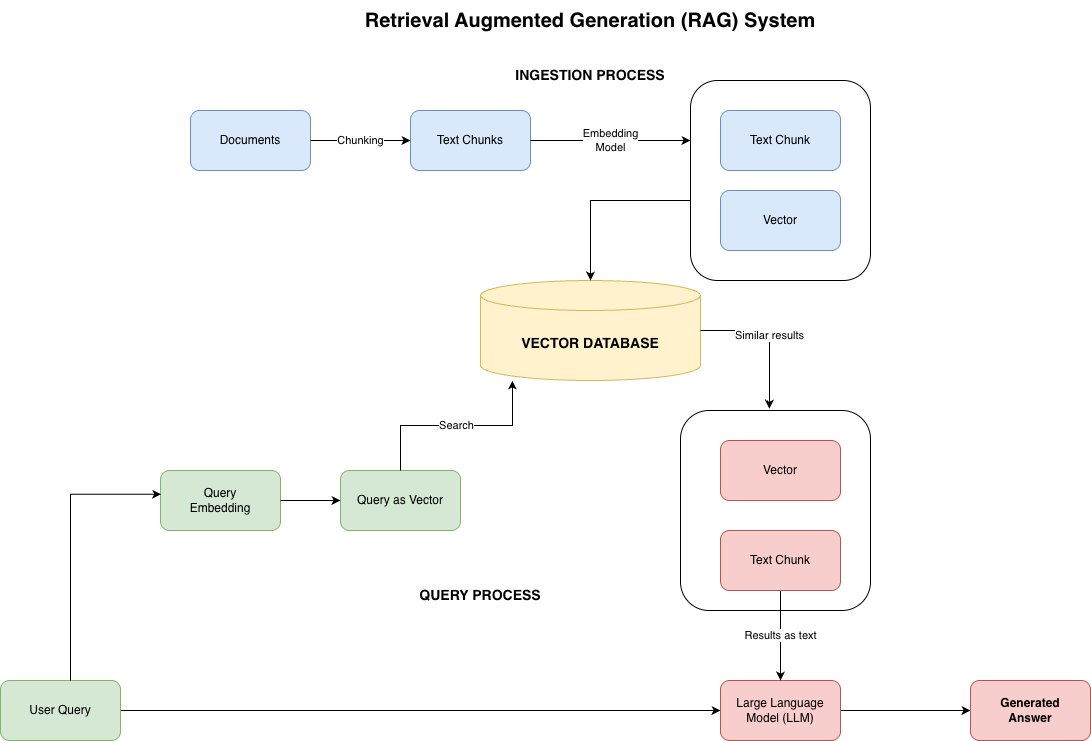
向量数据库是原始信息与上下文理解之间的关键桥梁。它将非结构化数据转换为可搜索、具有语义意义的知识空间,帮助大型语言模型提供更精确、更相关的响应。向量数据库通过将嵌入向量存储在一种称为向量索引的高效数据结构中来实现这一点,该结构支持快速的高维语义搜索以及对语义相似信息的近乎即时检索。
图 1:检索增强生成(RAG)架构,其中文档在摄取期间被分块、嵌入并存储在向量数据库中;在查询时,查询被嵌入,检索相似分块,并将其作为上下文传递给 LLM 以生成响应
Amazon Bedrock Knowledge Bases 的向量存储后端
采用客户托管(非托管)配置的 Amazon Bedrock Knowledge Bases 支持三种向量存储后端。有关涵盖六项服务的完整 AWS 向量产品组合,请参阅 AWS vector solutions: Build agentic AI where your data lives。
Amazon OpenSearch Service 可从保存在内存中的数据提供高速结果。它支持高维向量嵌入,并提供托管集群和无服务器部署选项,以及 k-NN 搜索和结合词法与向量方法的混合搜索等功能。Amazon Bedrock Knowledge Bases 同时支持 Amazon OpenSearch Managed Clusters 和 Amazon OpenSearch Serverless 作为向量存储后端。
带 pgvector 的 Amazon Aurora PostgreSQL 将 Amazon Aurora 的高性能关系数据库能力与 pgvector 的向量相似性搜索功能相结合。它支持多种索引方法(IVFFlat 和 HNSW)、多种距离度量(L2、余弦、内积),并且可以处理最高 2,000 维的单精度向量。
Amazon S3 Vectors 是 AWS 云对象存储服务,原生支持向量功能,专为大规模向量嵌入的经济高效存储和查询而设计。它为相似性搜索提供亚秒级查询性能,同时与传统向量数据库相比,将向量存储成本降低高达 90%。
为了解这些选项在实际中的表现,让我们考察三个不同的 RAG 用例,每个用例具有不同的延迟、成本和搜索需求,并看看哪种向量数据库最适合每一个。
用例 1:产品目录搜索
电商平台面临的挑战是帮助客户在数千种产品中准确找到他们想要的东西。有效的产品搜索工具必须理解自然语言查询,并能够扩展到在购物高峰期处理数千个并发查询,同时保持低延迟。
为什么 Amazon OpenSearch 是该用例的最佳选择
Amazon OpenSearch Serverless 非常适合产品目录搜索,因为它通过混合搜索能力支持将语义理解与传统关键词匹配相结合。在处理大型产品目录时,性能至关重要。Amazon OpenSearch Serverless 处理向量搜索的查询延迟在低毫秒范围内。
它对电商特别有价值的原因在于内置支持复杂过滤和聚合,从而驱动分面导航(例如按价格、品牌或颜色筛选)。你还可以从多种距离度量中选择,如余弦相似度或欧几里得距离,以根据你的具体需求微调产品相似度的计算方式。
Amazon OpenSearch Serverless Classic 集合提供多种优化选项,以平衡成本和搜索质量,详见下一节。
注意:Amazon Bedrock Knowledge Bases 同时支持 Amazon OpenSearch Serverless 和 Managed Clusters。以下基准测试是在 Serverless Classic 集合上运行的。Amazon OpenSearch Serverless NextGen 集合(2026 年 5 月正式可用)尚不兼容 Amazon Bedrock Knowledge Bases Retrieve API。NextGen 通过从索引映射中移除 engine 和 mode 参数来简化索引创建,默认采用 32 倍压缩并支持 GPU 加速索引构建,同时支持缩容至零。本文中的基准测试使用 Classic 集合,其中 engine、mode 和 HNSW 参数是显式配置的。Managed Clusters 提供额外的调优选项(自动优化、GPU 加速索引、可配置实例规格),可能会产生不同的结果。
Amazon OpenSearch Serverless 向量搜索的性能分析与优化
Amazon OpenSearch 高度可配置,并提供多种配置选项。在选择这些选项时要小心,因为它们可能显著影响向量索引的性能。我们考虑其中一些旨在优化成本和数据库大小的选项,并定量展示它们对向量索引性能的影响。
- 向量嵌入的规模:更大的向量通常可以包含更多关于被嵌入文本的语义信息。然而,这也会导致更高的内存消耗,从而增加向量索引大小和成本。现代嵌入模型(如 Amazon Titan Text Embedding v2)能够以不同大小的向量嵌入文本(Amazon Titan 为 1024、512 或 256)。对不同大小的嵌入进行基准测试很有用,可以定量衡量性能与成本对特定用例的影响。有关按 AWS 区域划分的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。
- 嵌入的数据类型:我们还可以通过以较低精度的数据类型存储嵌入来减小向量索引大小(从而降低成本),例如二进制嵌入。这可以显著减小向量索引的大小。
- 磁盘优化存储:Amazon OpenSearch Serverless Classic collections 提供基于磁盘的向量搜索(on_disk 模式),该模式在内部应用 32× 二进制量化,同时针对磁盘中的全精度向量进行重新评分。这会在以更高延迟为代价的情况下,在减少内存占用的同时保持质量。请注意,on_disk 需要 float 数据类型,并且不能与二进制嵌入结合使用。
根据所使用的索引算法,用户还可以配置 HNSW 参数(ef_construction、m),以调整索引构建时间、内存使用和搜索准确性之间的权衡(有关实用指导,请参阅 A practical guide to selecting HNSW hyperparameters)。此外,Classic collections 上还提供 Faiss 16 位标量量化,以减少内存使用。选择嵌入维度和数据类型需要基于你自己的相关性数据进行评估,因为这些会改变嵌入空间本身。选择之后,auto-optimize 功能可以通过根据召回率和延迟阈值评估索引配置,在一小时内完成剩余的 HNSW 和量化调优(适用于 Amazon OpenSearch Serverless 和带 Faiss 引擎的 Managed Clusters)。
数据集
我们使用“Shopping Queries Data Set”(ESCI),这是 Amazon 提供的一个包含困难搜索查询的大型数据集。该数据集包含 1,215,851 个唯一的美国产品(标题、描述、要点和品牌;中位数约为 1,140 个字符)以及 97,345 个已判定查询。对于每个查询,该数据集提供分级相关性标签:Exact (3)、Substitute (2)、Complement (1) 和 Irrelevant (0)。下面示例中展示了一个示例查询以及一个相关产品和一个不相关产品。
相关产品标题:
BAZIC Security Self Seal Envelope 4 1/8" x 9 1/2" #10, No Window Tint Pattern Mailing Envelopes, Peel & Seal, Office Checks Invoices (30/Pack), 1-Pack
ValBox 200 Count #8 Double Window Envelopes 3 5/8" x 8 11/16" Flip and Seal Double Window Security Check Envelopes- Security Tint Pattern Designed for Home Office Secure Mailing
我们抽样 5,000 个查询(每个查询约 19 个已判定产品,约 17 个相关产品),并为基准测试索引全部 1,215,851 个产品描述。我们衡量检索质量(NDCG@10)、延迟(并发为 1 和 10 时的 p50/p95/p99)以及索引大小(ANN 内存占用)。
向量索引构建
我们测试了嵌入维度(1024、512、256)与数据类型(float、binary)的所有组合,共六种配置,外加 on_disk 模式下采用默认 compression_level: 32x 的 1024-float 配置,并与 1024-float 内存基线进行对比(共七种配置)。所有索引均使用 FAISS 配合 HNSW(ef_construction=128,m=24),float 嵌入使用 l2 距离,binary 使用 hamming 距离。请注意,on_disk 模式要求 data_type: float,并在内部以 32× 应用自身的二值量化,再对从磁盘读取的全精度向量进行重打分。因此,“1024 维 binary on_disk”不是有效的索引配置。每个索引在集合中单独创建,摄入全部 122 万篇文档,预热至延迟稳定,进行测量,然后删除并冷却 15 分钟后再进行下一配置。
| 配置 | 嵌入大小 | 嵌入类型 |
|---|---|---|
| 内存 | 1024 | float(基线) |
| 内存 | 512 | float |
| 内存 | 256 | float |
| 内存 | 1024 | binary |
| 内存 | 512 | binary |
| 内存 | 256 | binary |
| 磁盘(32×) | 1024 | float |
评估方法
对于每种配置,我们在 Amazon OpenSearch Serverless(Classic 集合)中创建向量索引,摄入全部 1,215,851 个产品,等待合并稳定,然后运行自适应预热直至延迟稳定后再进行测量。我们在并发度为 1 和并发度为 10 的情况下测量 1,000 次查询 × 3 次重复。配置顺序经过交错安排,使数据类型和维度与时间解相关。主基准测试(表 1)使用语义搜索(仅 k-NN)。我们在表 2 中单独评估混合搜索(语义 + 使用 BM25 的关键词搜索)。我们评估:
- 检索延迟:延迟按 Amazon OpenSearch 结果所报告的从向量索引中检索相关匹配所需的时间来衡量。这不包括将文本转换为嵌入的时间。
- 检索性能:我们使用归一化折损累计增益(NDCG)指标对每个查询的检索结果进行评分。该指标通过同时考虑检索文档的相关性及其在排名中的位置来衡量排序检索结果的质量。排名较高的相关文档对总分的贡献大于排名较低的文档。该分数相对于理想可能排名进行归一化,使其落在 0–1 之间,这在产品搜索中尤为重要,因为用户更可能查看顶部结果。
- 索引大小:我们报告 ANN(近似最近邻)索引大小,这是驱动搜索计算成本并决定容量需求的内存结构。这不同于总存储大小,后者包括每个文档的 _source JSON 副本,并随文档文本量而变化。
结果
表 1:七种 Amazon OpenSearch Serverless 配置(1,215,851 个已索引向量,5,000 次查询,k=10)下的语义搜索(仅 k-NN)性能。除非另有说明,延迟为并发度 1 时的服务器端延迟。增量是相对于 1024-float 内存基线进行的配对 bootstrap。混合搜索结果见表 2。
- 降维并不总是会降低质量。在这个数据集上,512 维浮点数与 1024 维浮点数基线在统计上几乎无法区分(NDCG 0.3628 对 0.3627,p = 0.87),但索引大小减半(2.79 对 5.34 GiB),延迟更低(p50 25 对 31 ms)。降到 256 维时,出现了可测量的 4.4% 质量损失。“无损”和“有损”降维之间的分界取决于嵌入模型和数据集。
- 二值化可以大幅减小索引大小,但质量代价取决于维度数量。在 1024 维时,二值嵌入将索引大小减少 13.4 倍(0.40 对 5.34 GiB),NDCG 损失 5.2%,延迟相当(p50 22 对 31 ms)。在 256 维时,质量代价升至 28.3%,而增量大小节省要小得多(5.0 倍)。在这个数据集上,趋势很明确:二值化的惩罚会随着维度缩小而增大,这表明在较高维度下降低精度,比同时降低精度和维度更高效。
- 磁盘模式(on_disk 32×)以延迟为代价保持质量。在 1024 维时,磁盘模式达到 NDCG 0.3610(相对基线 −0.5%),索引大小与 1024 二值化相同,均为 0.40 GiB,但延迟约高 3 倍(p50 99 ms 对内存内 31 ms)。1024 二值化和 on_disk 都将索引减少 13.4 倍,但磁盘模式保留的质量显著更多(−0.5% 对 −5.2%)。约 3 倍的延迟比在 p50、p95 和 p99 上保持一致。在小型语料库规模下,这种惩罚可能不会出现,因为索引能放入页缓存。它会在生产规模下显现。
| 配置 | NDCG@10 | 相对基线 Δ | p50 (ms) | p95 (ms) | p99 (ms) | 索引大小(ANN) | p50 @ 并发 10 |
|---|---|---|---|---|---|---|---|
| 1024 浮点 | 0.3627 | 基线 | 31 | 44 | 52 | 5.34 GiB | 161 ms |
| 512 浮点 | 0.3628 | +0.0002 | 25 | 37 | 62 | 2.79 GiB | 149 ms |
| 256 浮点 | 0.3468 | −4.4% | 22 | 35 | 47 | 1.51 GiB | 85 ms |
| 1024 二值 | 0.3438 | −5.2% | 22 | 37 | 55 | 0.40 GiB | 70 ms |
| 512 二值 | 0.3200 | −11.8% | 19 | 30 | 47 | 0.32 GiB | 57 ms |
| 256 二值 | 0.2600 | −28.3% | 17 | 24 | 32 | 0.28 GiB | 52 ms |
| 1024 浮点,on_disk 32× | 0.3610 | −0.5% | 99 | 139 | 176 | 0.40 GiB | 255 ms |
混合搜索结果
表 2:1024 维下的混合搜索比较(1,215,851 个向量,5,000 条查询,k=10)。混合使用 normalization-processor,语义/词法权重为 0.7/0.3。
| 方法 | 1024 浮点 NDCG | 浮点 p50 | 1024 二值 NDCG | 二值 p50 |
|---|---|---|---|---|
| 关键词(BM25) | 0.3141 | 11 ms | 0.3177 | 17 ms |
| 语义(k-NN) | 0.3633 | 30 ms | 0.3451 | 17 ms |
| 混合 | 0.3850 | 38 ms | 0.3658 | 35 ms |
混合搜索相较仅语义搜索提供了一致的质量提升。在这个数据集上,混合搜索对浮点(0.3633 → 0.3850)和二值(0.3451 → 0.3658)都将 NDCG 提高了 +6.0%。特别是,1024 二值配合混合搜索(0.3658)超过了 1024 浮点仅语义搜索(0.3633),而内存占用少 13 倍(0.40 对 5.34 GiB)。这表明开启混合搜索可以抵消二值化的质量代价。
混合搜索会增加延迟。融合步骤大致使顺序延迟翻倍(浮点 30 → 38 ms,二值 17 → 35 ms),并且在并发下差距会扩大。
注意:这个数据集(产品搜索)偏向关键词匹配:仅 BM25 就达到 NDCG 0.314,仅比语义低 13%。在自然语言 RAG 查询上,混合搜索的绝对提升可能不同。融合权重(0.7/0.3)是为演示设置的,并未调优。
用例 2:深度研究代理
深度研究智能体代表着对传统 RAG 系统的重大演进。标准 RAG 执行单次检索-生成循环,而深度研究智能体则通过动态推理、自适应规划和迭代信息检索来应对复杂的多轮研究任务。这些智能体能够搜索信息、分析发现、根据中间结果调整方法,并在较长时间内综合生成全面报告。
深度研究智能体的一个关键特征是其对较高延迟的容忍度,以换取彻底性。与用户期望亚秒级响应的实时搜索应用不同,深度研究工作流可能运行数分钟甚至数小时,因此成本效益和可扩展性远比原始查询速度更为重要。
该用例的向量存储层必须以最低成本高效处理数千万个嵌入向量,同时支持用于定期重建索引的批量操作、灵活的元数据过滤,以及弹性扩展至数百万个向量。
为什么 S3 Vectors 最适合该用例
对于在超大规模嵌入向量集合上运行的深度研究智能体而言,Amazon S3 Vectors 是一种实用且高效的向量存储选择。与传统向量数据库相比,它显著降低了存储和查询向量的成本,使得处理来自大型文档集合的数十亿个嵌入向量变得可行。Amazon S3 Vectors 无需基础设施预置即可弹性扩展,每个索引支持数千万个向量,每个存储桶支持数千个索引,适合数据集不断增长的长时运行研究系统。它支持多种嵌入维度,并针对批量摄取和检索进行了优化,能够高效地对大型集合进行后台处理。它与其他 AWS 服务集成,例如 Amazon Bedrock Knowledge Bases(全托管 RAG 能力)和 Amazon OpenSearch,因此团队可以在需要时将低成本存储与更专业的检索或 RAG 工作流相结合。其按需付费的定价模式进一步支持了使用模式多变或不可预测的研究工作负载。
我们使用英文维基百科的一个子集,包含超过 600 万篇文章。在基准测试中,我们创建了多个规模的向量索引,以评估 Amazon S3 Vectors 随着数据集增长的表现:
| 配置 | 目标向量数 |
|---|---|
| XSmall | 5,000 |
| Small | 250,000 |
| Medium | 500,000 |
| Large | 1,000,000 |
每篇维基百科文章使用基于 token 的分割器被切分为 300 个 token 的片段。
我们使用 Amazon Titan Text Embedding v2 构建向量索引,该模型生成 1024 维 float32 嵌入向量。我们的摄取管道使用以下配置:
| 参数 | 值 |
|---|---|
| 嵌入模型 | Amazon Titan Text Embedding v2 |
| 嵌入维度 | 1024 |
| 距离度量 | 余弦相似度 |
| 分块大小 | 约 300 个 token |
我们使用从维基百科内容生成的 100 个研究风格问题,测量了四种索引规模下的查询延迟。每个查询检索最相似的前 50 个向量。延迟测量排除了嵌入生成时间,以隔离 Amazon S3 Vectors 的性能。
哪些因素影响政府官员和政策制定者的职业轨迹?
| 索引规模 | 向量数量 | p50 (ms) | p95 (ms) | p99 (ms) |
|---|---|---|---|---|
| XSmall | 5,314 | 82 | 180 | 220 |
| Small | 250,514 | 205 | 416 | 527 |
| Medium | 500,401 | 266 | 386 | 479 |
| Large | 1,000,413 | 294 | 395 | 506 |
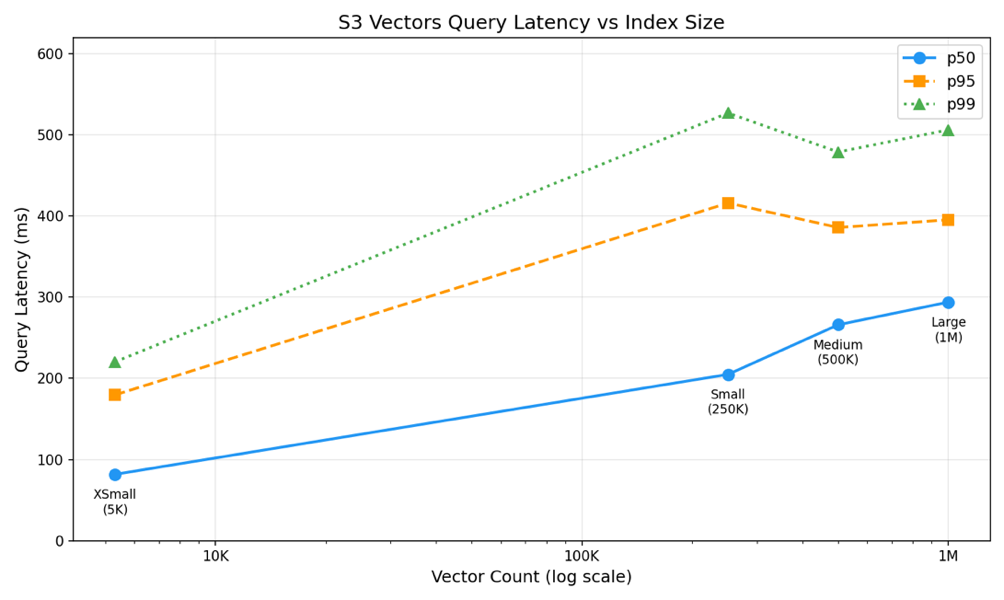
- 亚线性扩展:查询延迟的增长远慢于索引规模。从 5K 向量增加到 1M 向量(增长 200 倍),p50 延迟仅增加约 3.5 倍(82ms → 294ms)。这体现了 Amazon S3 Vectors 高效的索引结构。
- 大规模下尾部延迟趋于稳定:p50 → p95 的差距从 5K 向量时的约 100ms 扩大到 250K 时的约 210ms,但随后收窄,并在 500K 到 1M 向量期间稳定保持在约 100-120ms。这表明一旦索引达到中等规模,最坏情况下的性能就变得可预测,增加更多向量不会按比例增加尾部延迟。
- 大规模下亚秒级查询:即使在 100 万向量时,p99 延迟仍低于 510ms。对于需要花费数秒对检索上下文进行推理的深度研究代理而言,这一检索开销是可以接受的。
图 2:Amazon S3 Vectors 查询延迟(p50、p95、p99)随索引规模(从 5K 到 1M 向量)的变化,显示出亚线性扩展,即使达到 1M 向量时中位查询仍低于 300 ms
与 Amazon OpenSearch 集成以实现混合搜索工作流
对于需要超越纯向量相似度的高级搜索能力的研究工作负载,Amazon S3 Vectors 通过两种互补模式与 Amazon OpenSearch Service 集成。
第一种模式将 Amazon S3 Vectors 作为经济高效的存储引擎直接用于 Amazon OpenSearch 托管集群中,使团队能够使用 Amazon OpenSearch 的混合搜索、聚合和复杂过滤功能,同时保持 Amazon S3 Vectors 的低存储成本。
第二种模式支持将 S3 向量索引一次性导出到 Amazon OpenSearch Serverless 集合,适用于特定数据子集需要高查询吞吐量或低于 100ms 延迟的实时应用场景。通过这种分层方法,研究团队可以经济高效地将完整语料库存储在 Amazon S3 Vectors 中,同时选择性地将高优先级向量提升到 Amazon OpenSearch 以应对性能关键的查询。两种集成都保留了向量维度和元数据,支持随着研究需求变化在存储层之间平滑过渡。
用例 3:面向客户的 RAG 聊天机器人
面向客户的聊天机器人已成为企业为用户提供即时、个性化支持的重要工具。当由 RAG 驱动时,这些聊天机器人可以通过将答案建立在可信知识源上来提供准确、具有上下文关联的回复。然而,源数据类型的多样性以及用户表述问题方式的差异,意味着能够调整 RAG 查询以找到符合客户期望的结果非常重要。
面向客户的聊天机器人的一个典型用例是根据内部知识库的内容回答客户问题。知识库会随着客户查询以及构建或变更内部系统的项目而逐步积累。它们很可能包含客户问题的答案,但并不总是包含匹配的关键词或对问题中术语的直接引用。知识库检索系统的要求是:
- 能够从间接问题中找到源材料。
- 快速提供答案。
- 可扩展以容纳大型知识库。
为什么 Aurora 是大型知识库下此用例的最佳选择
对于拥有大型知识库的面向客户的 RAG 聊天机器人,Amazon Aurora PostgreSQL 配合 pgvector 在 S3 和 Amazon OpenSearch 的容量与性能之间取得平衡,并提供了更改索引方法以针对任何给定数据集优化检索的能力。
Amazon Aurora Serverless 也可用于开发环境等用例,在这些场景中自动数据库扩展具有成本或性能优势。
Aurora PostgreSQL 的性能分析与优化
PostgreSQL 为向量搜索提供了多种索引算法,包括 HNSW 和 IVFFlat。HNSW(Hierarchical Navigable Small World,分层可导航小世界)构建多层图以实现快速近似最近邻搜索,查询速度更快,但代价是更高的内存占用和更慢的索引构建。IVFFlat(Inverted File with Flat compression,带平坦压缩的倒排文件)将向量划分到聚类中以实现高效搜索,内存占用更低,但随着数据变化需要定期重建索引。关于这些算法的详细对比,请参阅 Optimize generative AI applications with pgvector indexing: A deep dive into IVFFlat and HNSW techniques。能够在同一数据集上对不同索引进行 A/B 测试,有助于团队针对其特定用例优化检索性能。关键优化因素包括:
- 数据库预置:实例规格选择与预热考量。
- 索引选择:针对不同查询模式的 HNSW 与 IVFFlat 权衡。
- 索引参数:每种算法类型的配置选项。
Amazon Relational Database Service (RDS) 提供多种实例规格和部署选项,例如多可用区和无服务器运行。这有助于您利用云开发与运维团队熟悉的技能来调整数据库的成本和性能。能够在索引类型之间快速切换,支持针对真实客户查询进行测试,以确定哪种方案能带来更好的结果。
- 向量数据库中有 500,000 个分块。
- 5,000 个随机查询,使用 1024 维嵌入。
- Amazon Aurora v15.15。
- 查询通过 RDS API 接口执行,以实现标准化的性能测量。
- 已预置并运行至少 15 分钟的数据库实例,以消除启动延迟。
构建了两种向量索引类型进行比较:HNSW 和 IVFFlat。两种索引均使用 1024 维嵌入,并配置了 pgvector 扩展。两种索引类型之间的所有其他参数均保持一致,以确保比较公平。
| 索引类型 | p50 (ms) | p95 (ms) | p99 (ms) |
|---|---|---|---|
| HNSW | 31.91 | 38.20 | 89.00 |
| IVFFLAT | 35.94 | 42.38 | 94.08 |
主要发现如下:
- 性能相当:对于该数据集,HNSW 和 IVFFlat 在中位性能上存在一致差异,两者均实现了低于 50ms 的中位查询时间,但 HNSW 快了 4ms。
- 低延迟:两种索引类型都提供了适合实时聊天机器人响应的延迟,中位时间低于 50ms。
- 尾部延迟稳定:两种索引类型的 p95 延迟均保持在 60ms 以下,表明大多数查询的性能可预测。
这些结果表明,Amazon Aurora PostgreSQL 为面向客户的 RAG 聊天机器人提供了一种均衡方案,其延迟介于高性能的 Amazon OpenSearch 和成本优化的 Amazon S3 Vectors 之间,同时保持根据实际使用模式优化索引策略的灵活性。
Amazon Bedrock Knowledge Bases 的选择指南
以下指南专门适用于在 Amazon Bedrock Knowledge Bases 中可用的三种向量存储后端之间进行选择。关于涵盖全部六项服务的完整 AWS 向量解决方案选择框架,请参阅 AWS vector solutions: Build agentic AI where your data lives 中的决策模型。如果您的数据已经存储在支持向量的 AWS 数据存储中,推荐做法是为该现有服务添加向量搜索,而不是引入新的服务。
第 1 步:分析您的应用程序
| . | 实时搜索 | 对话式 AI | 后台处理 |
|---|---|---|---|
| 示例 | 产品目录、自动补全、分面搜索 | 客户支持聊天机器人、内部知识助手 | 研究代理、批量分析、文档处理 |
| 延迟容忍度 | <50ms | <100ms | <1 秒 |
| 查询模式 | 高并发、大流量 | 中等频率、基于会话 | 低频、复杂 |
| 是否需要混合搜索? | 通常至关重要 | 有时有用 | 很少需要 |
| 成本敏感度 | 较低(性能优先) | 中等 | 较高(成本效率优先) |
大多数应用都明确属于其中某一类。如果你的应用跨越多个类别(例如,一个研究代理同时还要为用户提供摘要视图),可以考虑分层架构,让不同的向量存储服务于工作流的不同部分。
第 2 步:将你的需求画像与向量数据库匹配
| 如果你的主要需求是…… | 那么从……开始 | 因为…… |
|---|---|---|
| 低延迟(<50ms)加混合搜索 | Amazon OpenSearch Service | 通过内存中的 HNSW 索引提供个位数毫秒级延迟,并原生支持将词法搜索与向量搜索相结合 |
| 平衡延迟(约 100ms)且有关系型数据需求 | 带 pgvector 的 Aurora PostgreSQL | 提供低于 50ms 的查询时间,支持对索引类型进行 A/B 测试(HNSW 与 IVFFlat),并与现有 PostgreSQL 工作流自然集成 |
| 大规模下具有成本效益的存储 | Amazon S3 Vectors | 与传统向量数据库相比,将向量存储成本降低最多 90%,可弹性扩展到数百万个向量,且无需管理基础设施 |
| 最小化运维开销 | Amazon S3 Vectors | 完全托管,采用按需付费定价——无需预置、打补丁或容量规划 |
第 3 步:考虑你的增长路径
你今天的选择不必是永久性的。随着需求演变,这些服务可以相互补充:
- 如果你正在构建原型或成本敏感的研究工作负载,可以先从 Amazon S3 Vectors 开始。如果之后你需要为部分数据实现更快的查询,可以将向量导出到 Amazon OpenSearch 或 Amazon Aurora,而无需重新生成嵌入。
- 如果你需要在单个查询中将向量结果与关系型数据连接起来,可以先从 Amazon Aurora PostgreSQL 开始。这是这里唯一可以做到这一点的选项。如果你的团队已经在运行 PostgreSQL,它也是自然之选,因为熟悉的运维模式可以降低学习曲线。
- 如果低于 20ms 的延迟或混合搜索是第一天就必须具备的要求,可以先从 Amazon OpenSearch 开始。你可以使用 Amazon S3 Vectors 作为整个语料库的高性价比后备存储,同时由 Amazon OpenSearch 提供实时查询。
分层存储模式对于超出单一用例范围而增长的应用尤其强大。使用 Amazon S3 Vectors 存储完整语料库,并使用 Amazon OpenSearch Service 或 Amazon Aurora 服务性能关键的子集。
结论
使用 Amazon Bedrock Knowledge Bases 构建有效的 RAG 解决方案,需要选择一个能够在应用性能需求与运维和成本约束之间取得平衡的向量存储。
通过对三个不同用例的分析,可以清晰地看出每个 Amazon Bedrock Knowledge Bases 向量存储后端如何适配不同需求。Amazon OpenSearch Serverless 非常适合需要实时性能和混合搜索的场景,能够提供低延迟结果,并灵活结合语义搜索与关键词搜索。带 pgvector 的 Amazon Aurora PostgreSQL 为对话式应用提供了平衡的中间方案,以低于 100ms 的延迟、PostgreSQL 熟悉的运维方式以及迭代索引策略的能力满足需求。Amazon S3 Vectors 面向成本敏感的大规模工作负载,使团队能够存储和查询数百万个嵌入,而无需专用基础设施开销。
本文中的示例和图表来自针对各数据库分别定制的独立工作负载,而非在共享数据集上进行的直接对比基准测试,因此这些数字展示的是各选项权衡取舍的形态,而非直接的同类比较。理解这些权衡取舍,并针对你的具体工作负载进行衡量,是做出正确选择的关键。
随着你的 RAG 应用逐渐成熟,你可能会发现分层架构能让你兼得各方优势:规模、性能和成本效益协同发挥作用。这种方法使用 Amazon S3 Vectors 以经济高效的方式存储完整的嵌入语料库,同时有选择地将高流量向量提升到 Amazon OpenSearch Service 或 Amazon Aurora。
我们鼓励你使用本文中概述的基准测试方法,针对你自己的数据和查询模式来评估这些选项。最终,合适的向量存储是那个最符合你的工作负载在延迟、成本和检索质量方面要求的选择。
关于作者
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。