精选Together AI新闻
GLM-5.3 与 GLM-5.3 Flash 在 DeepSWE 上的对比:成本、编码与路由
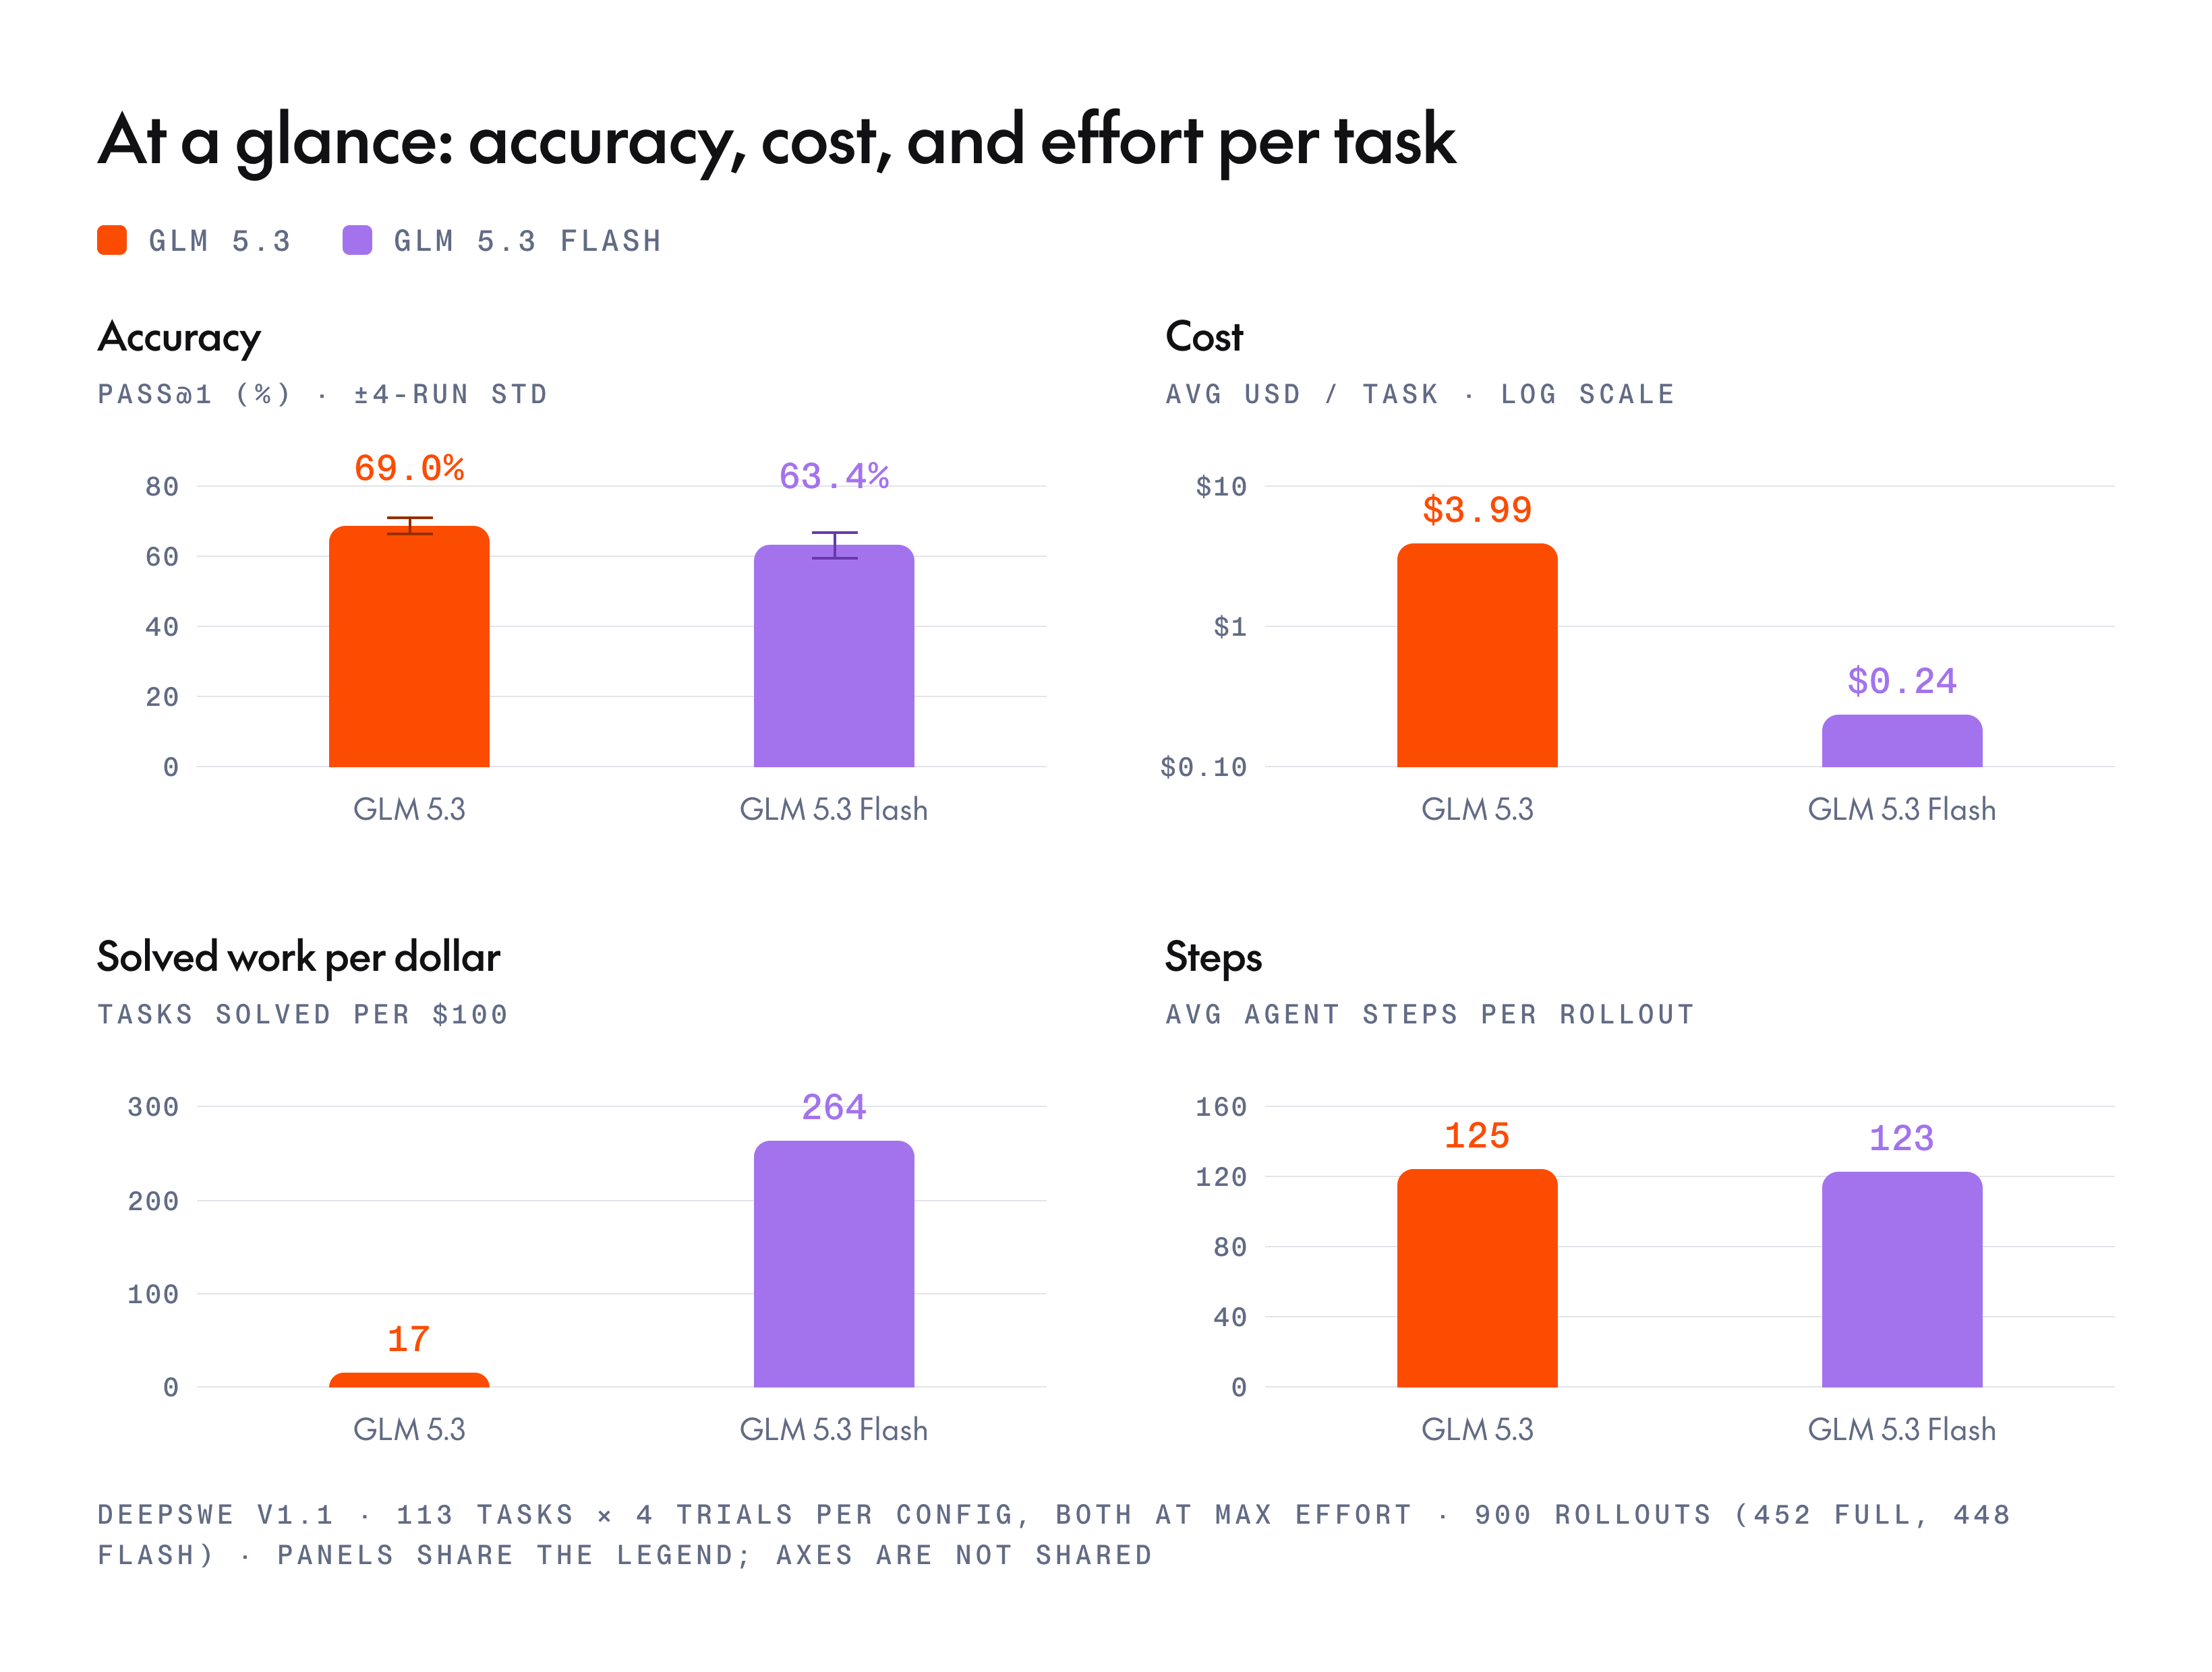
研究团队在 DeepSWE 基准上对 GLM-5.3 和 GLM-5.3 Flash 进行了 900 次测试。结果显示,Flash 在 pass@1 上仅低 5.6 分,但成本降低 17 倍;在 pass@4 上差距缩小至 2.6 分,表明 Flash 在成本效益上具有显著优势。
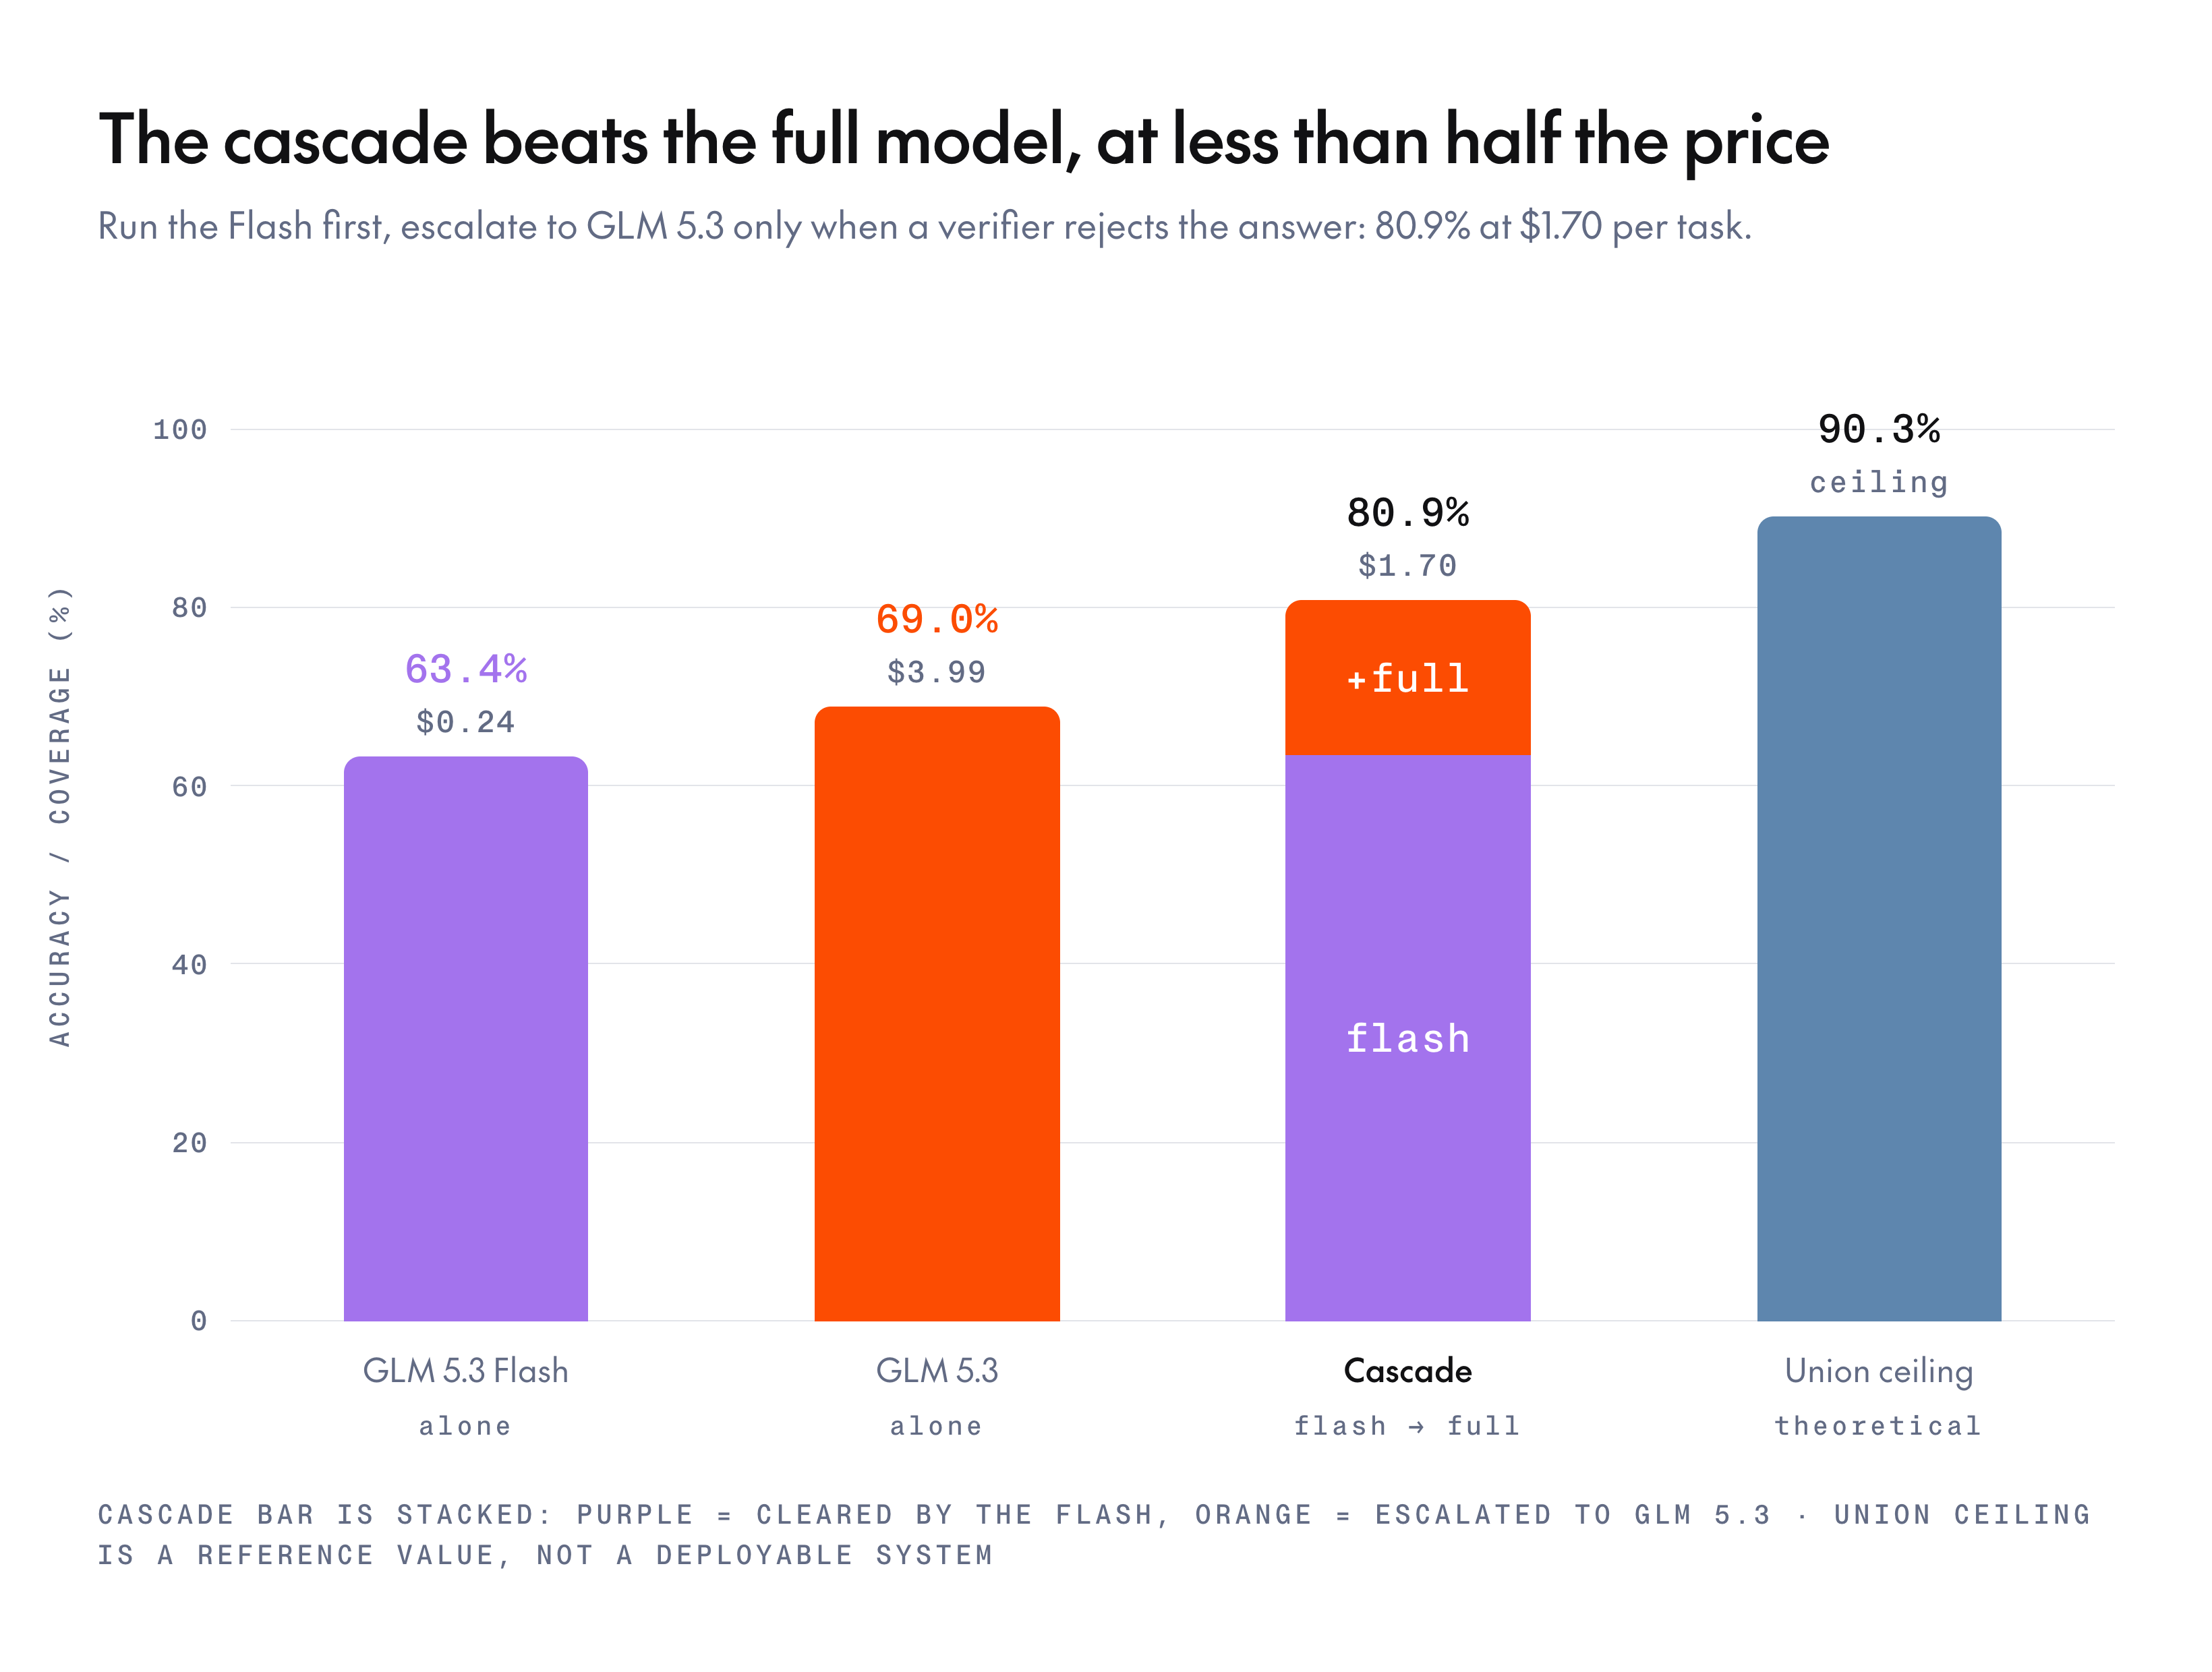
先运行 GLM-5.3 Flash,只有当你的测试拒绝了它的答案时,再升级到完整的 GLM-5.3。这种级联方式能以每次 1.70 美元的成本解决 80.9% 的 DeepSWE 任务。单独使用 GLM-5.3 能以 3.99 美元的成本解决 69.0% 的任务。准确率高出 12 个百分点,成本却降低 57%。如果你只打算选一个模型,那就选 Flash:它在首次尝试时落后 5.6 个百分点,但到第四次尝试时仅落后 2.6 个百分点,因为蒸馏所移除的是可靠性,而重试恰恰能买回可靠性。
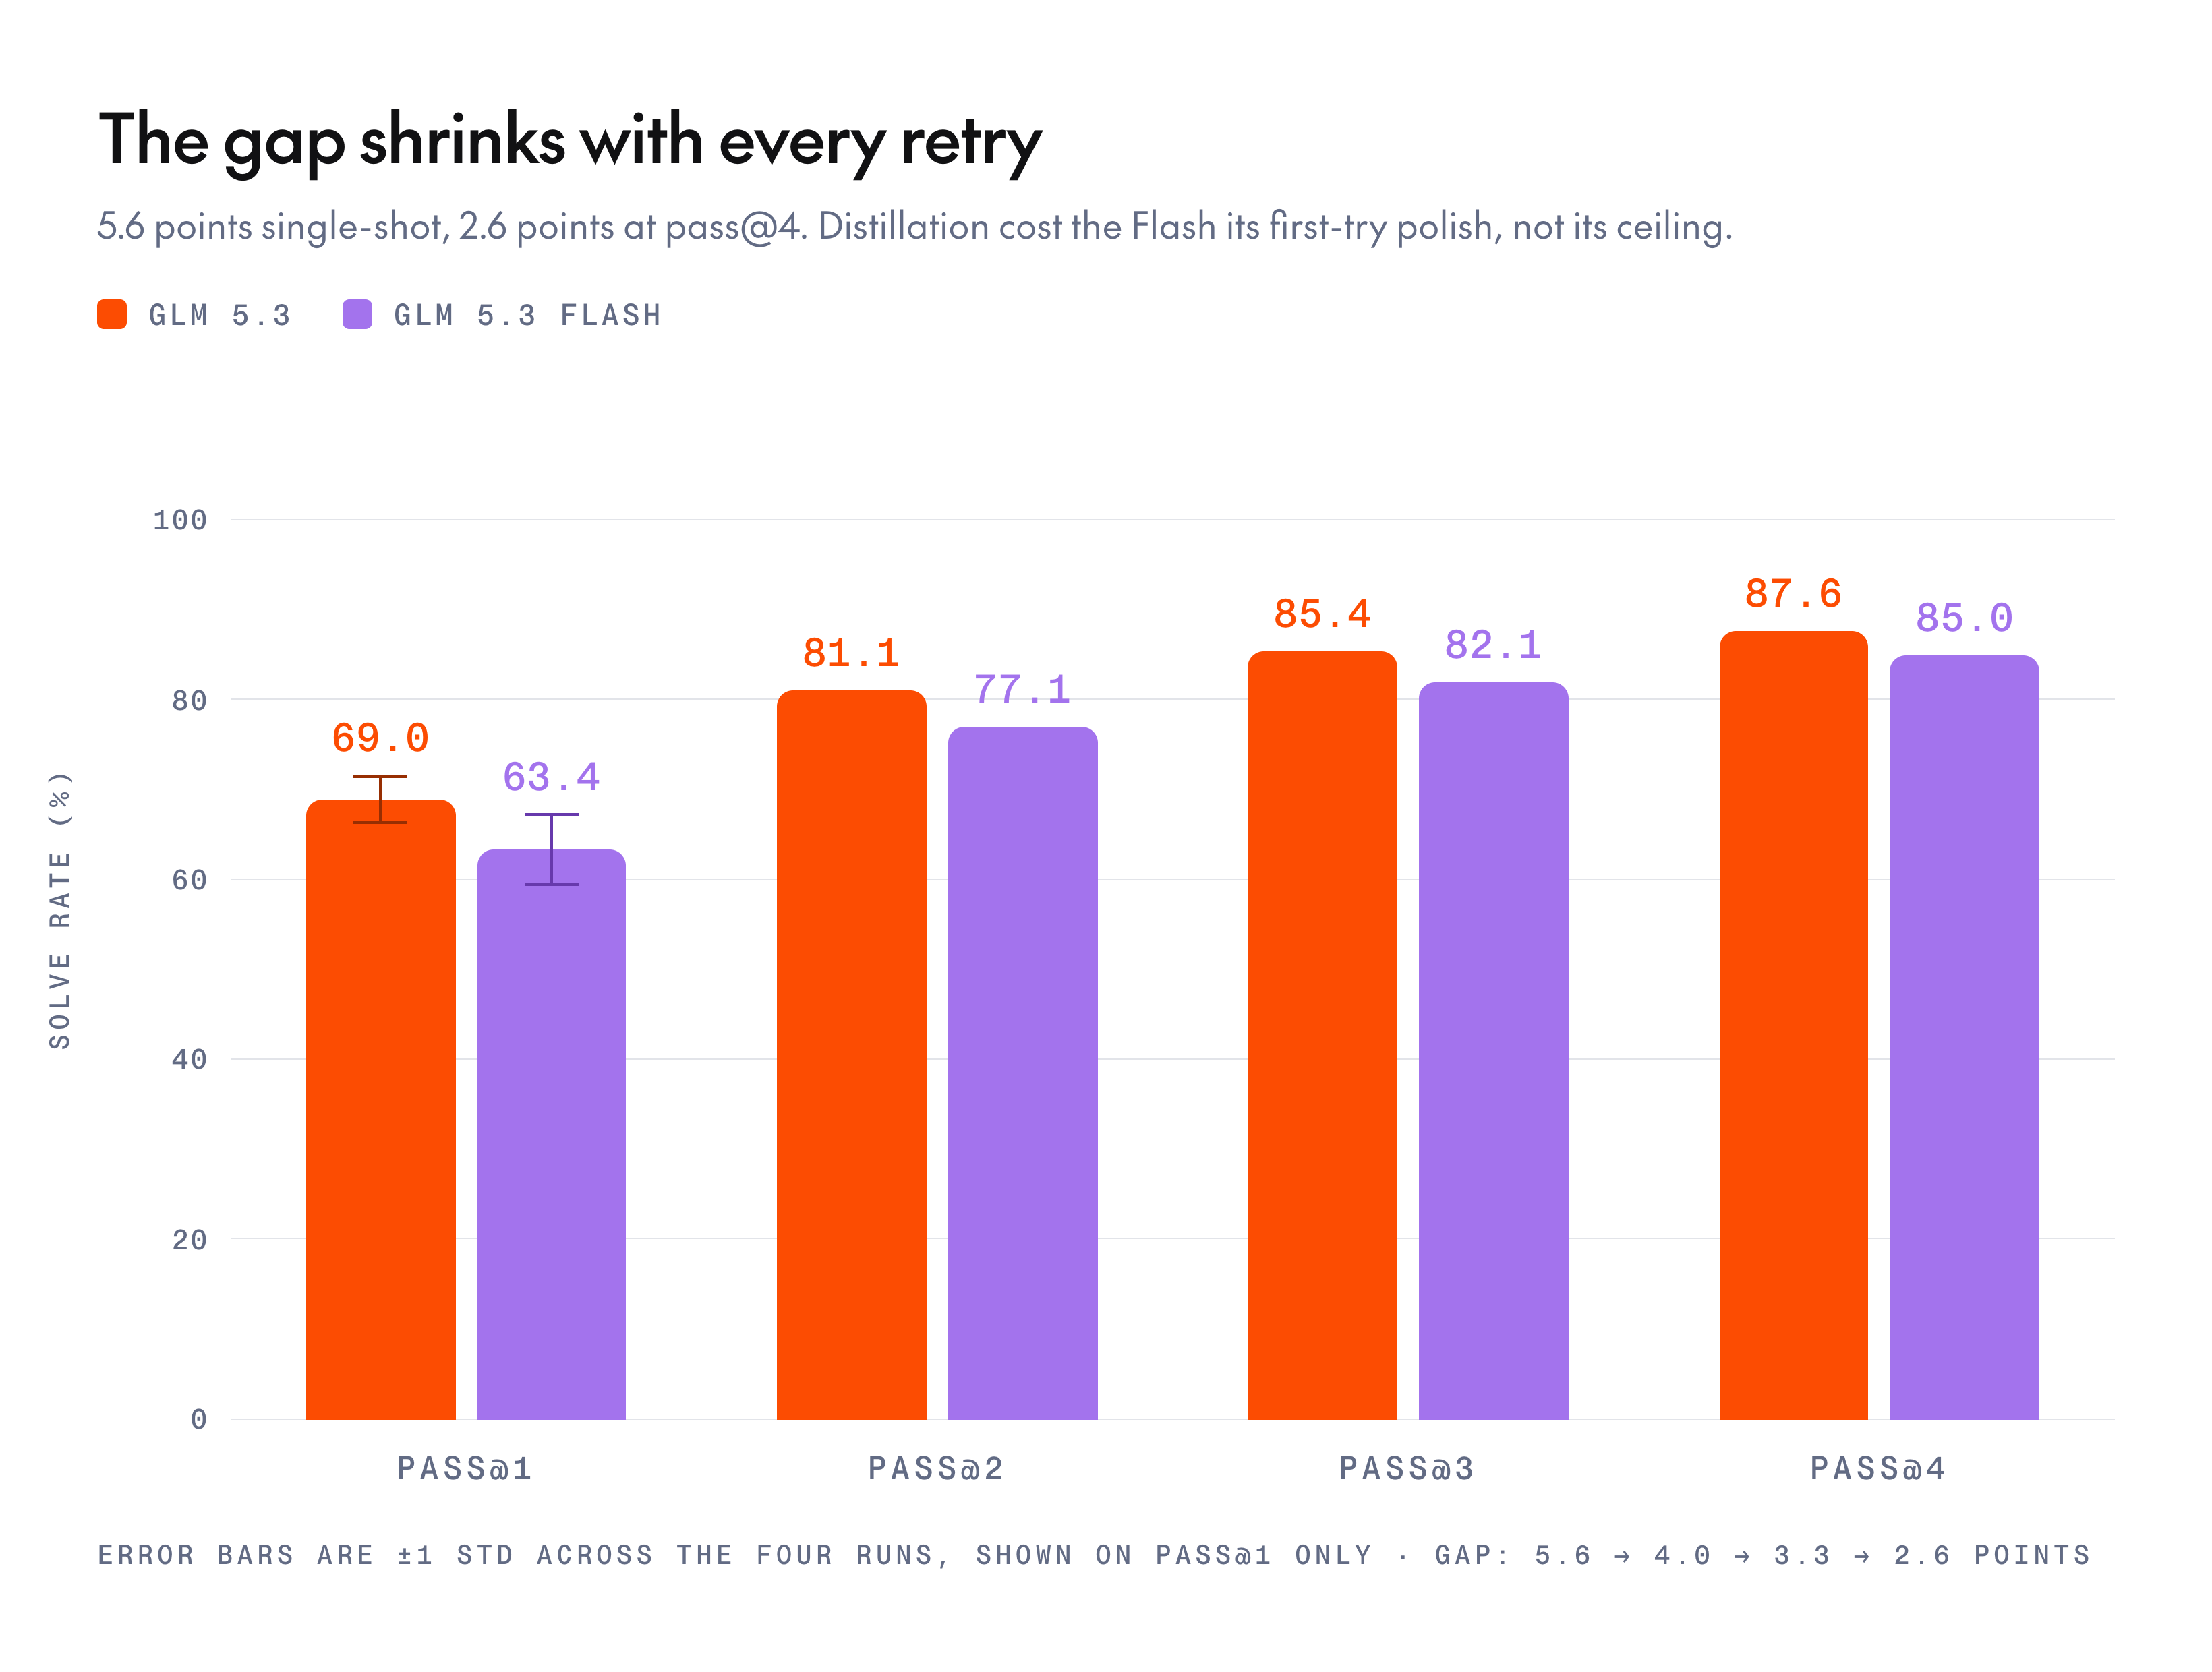
- 差距是首次尝试效应。pass@1 为 69.0% 对 63.4%,pass@2 时差距缩小到 4 个百分点,pass@4 时差距为 2.6 个百分点(87.6% 对 85.0%)。
- 价格差距是 17 倍。每次 rollout 为 3.99 美元对 0.24 美元。每花费 100 美元,Flash 能解决 264 个任务,而完整模型只能解决 17 个。
- 能力保留了下来,一致性却没有。在完整模型解决的 99 个任务中,Flash 仍然能解决 93 个。它稳定了父模型表现不稳定的 15 个任务,并攻克了父模型完全无法解决的 3 个任务。
- Flash 无法将投入转化为胜果。在不稳定的任务上,完整模型有 61% 的情况下更长的运行是成功运行,而 Flash 只有 46%,低于抛硬币的概率线。
- 一个真正的退化:谨慎性。Flash 在 6.9% 的 rollout 中会破坏一个已经通过的基线测试,而完整模型只有 4.4%,因此需要用回归测试来把关。
GLM-5.3 和 GLM-5.3 Flash 是同一家族的两个尺寸。GLM-5.3 是完整的开放权重模型;GLM-5.3 Flash 是它的蒸馏版本,rollout 价格仅为前者的十七分之一。每个团队关于 flash 变体都会问的问题是:它在质量上牺牲了多少。在 DeepSWE(一个跨多种任务类型和编程语言测试模型软件工程能力的基准)上,答案比 headline 的 pass@1 差距所暗示的要小,因为 Flash 并不是完整模型的缩小版克隆。它是其能力的重新分配,而它真正失去的东西并不是 headline 数字所指出的那个。
DeepSWE · 概览
GLM 5.3 对比 GLM 5.3 Flash,headline 数据
| 模型 | pass@1 | 平均成本 | 每 100 美元解决数 | 平均输出 token | 平均步数 |
|---|---|---|---|---|---|
| GLM 5.3 [max] | 69.0% ± 2.7 | $3.99 | 17 | 80k | 125 |
| GLM 5.3 Flash [max] | 63.4% ± 4.1 | $0.24 | 264 | 73k | 123 |
我们在全部 113 个 DeepSWE 任务上运行了 GLM-5.3(max)与 GLM-5.3 Flash(max)的对比,每个任务四次试验,数据来自已发布的逐次试验记录:总共 900 次 rollout,其中 452 次为完整模型,448 次为 Flash。以下内容将完整对比和蒸馏剖析汇集于一处。下面的每个数字都来自这次运行,因此可能与其他公开的 GLM-5.3 对比 GLM-5.3 Flash 记分卡有所不同。
DeepSWE 记分板:pass@1 和 pass@k
单次尝试时,完整模型领先 5.6 个百分点,69.0% 对 63.4%。这个领先是首次尝试的假象。它在 pass@2 时缩小到 4 个百分点,在 pass@4 时缩小到 2.6 个百分点,87.6% 对 85.0%。蒸馏让 Flash 失去更多的是单次尝试的光鲜度,而不是它的上限。对于任何 best-of-k 工作负载,实际的质量损失不到 3 个百分点,而价格仅为十七分之一。从 5.6 到 2.6 的骤降是理解发生了什么变化的第一条线索,下一节将对此进行解释。
蒸馏真正付出的代价:一致性,而非能力
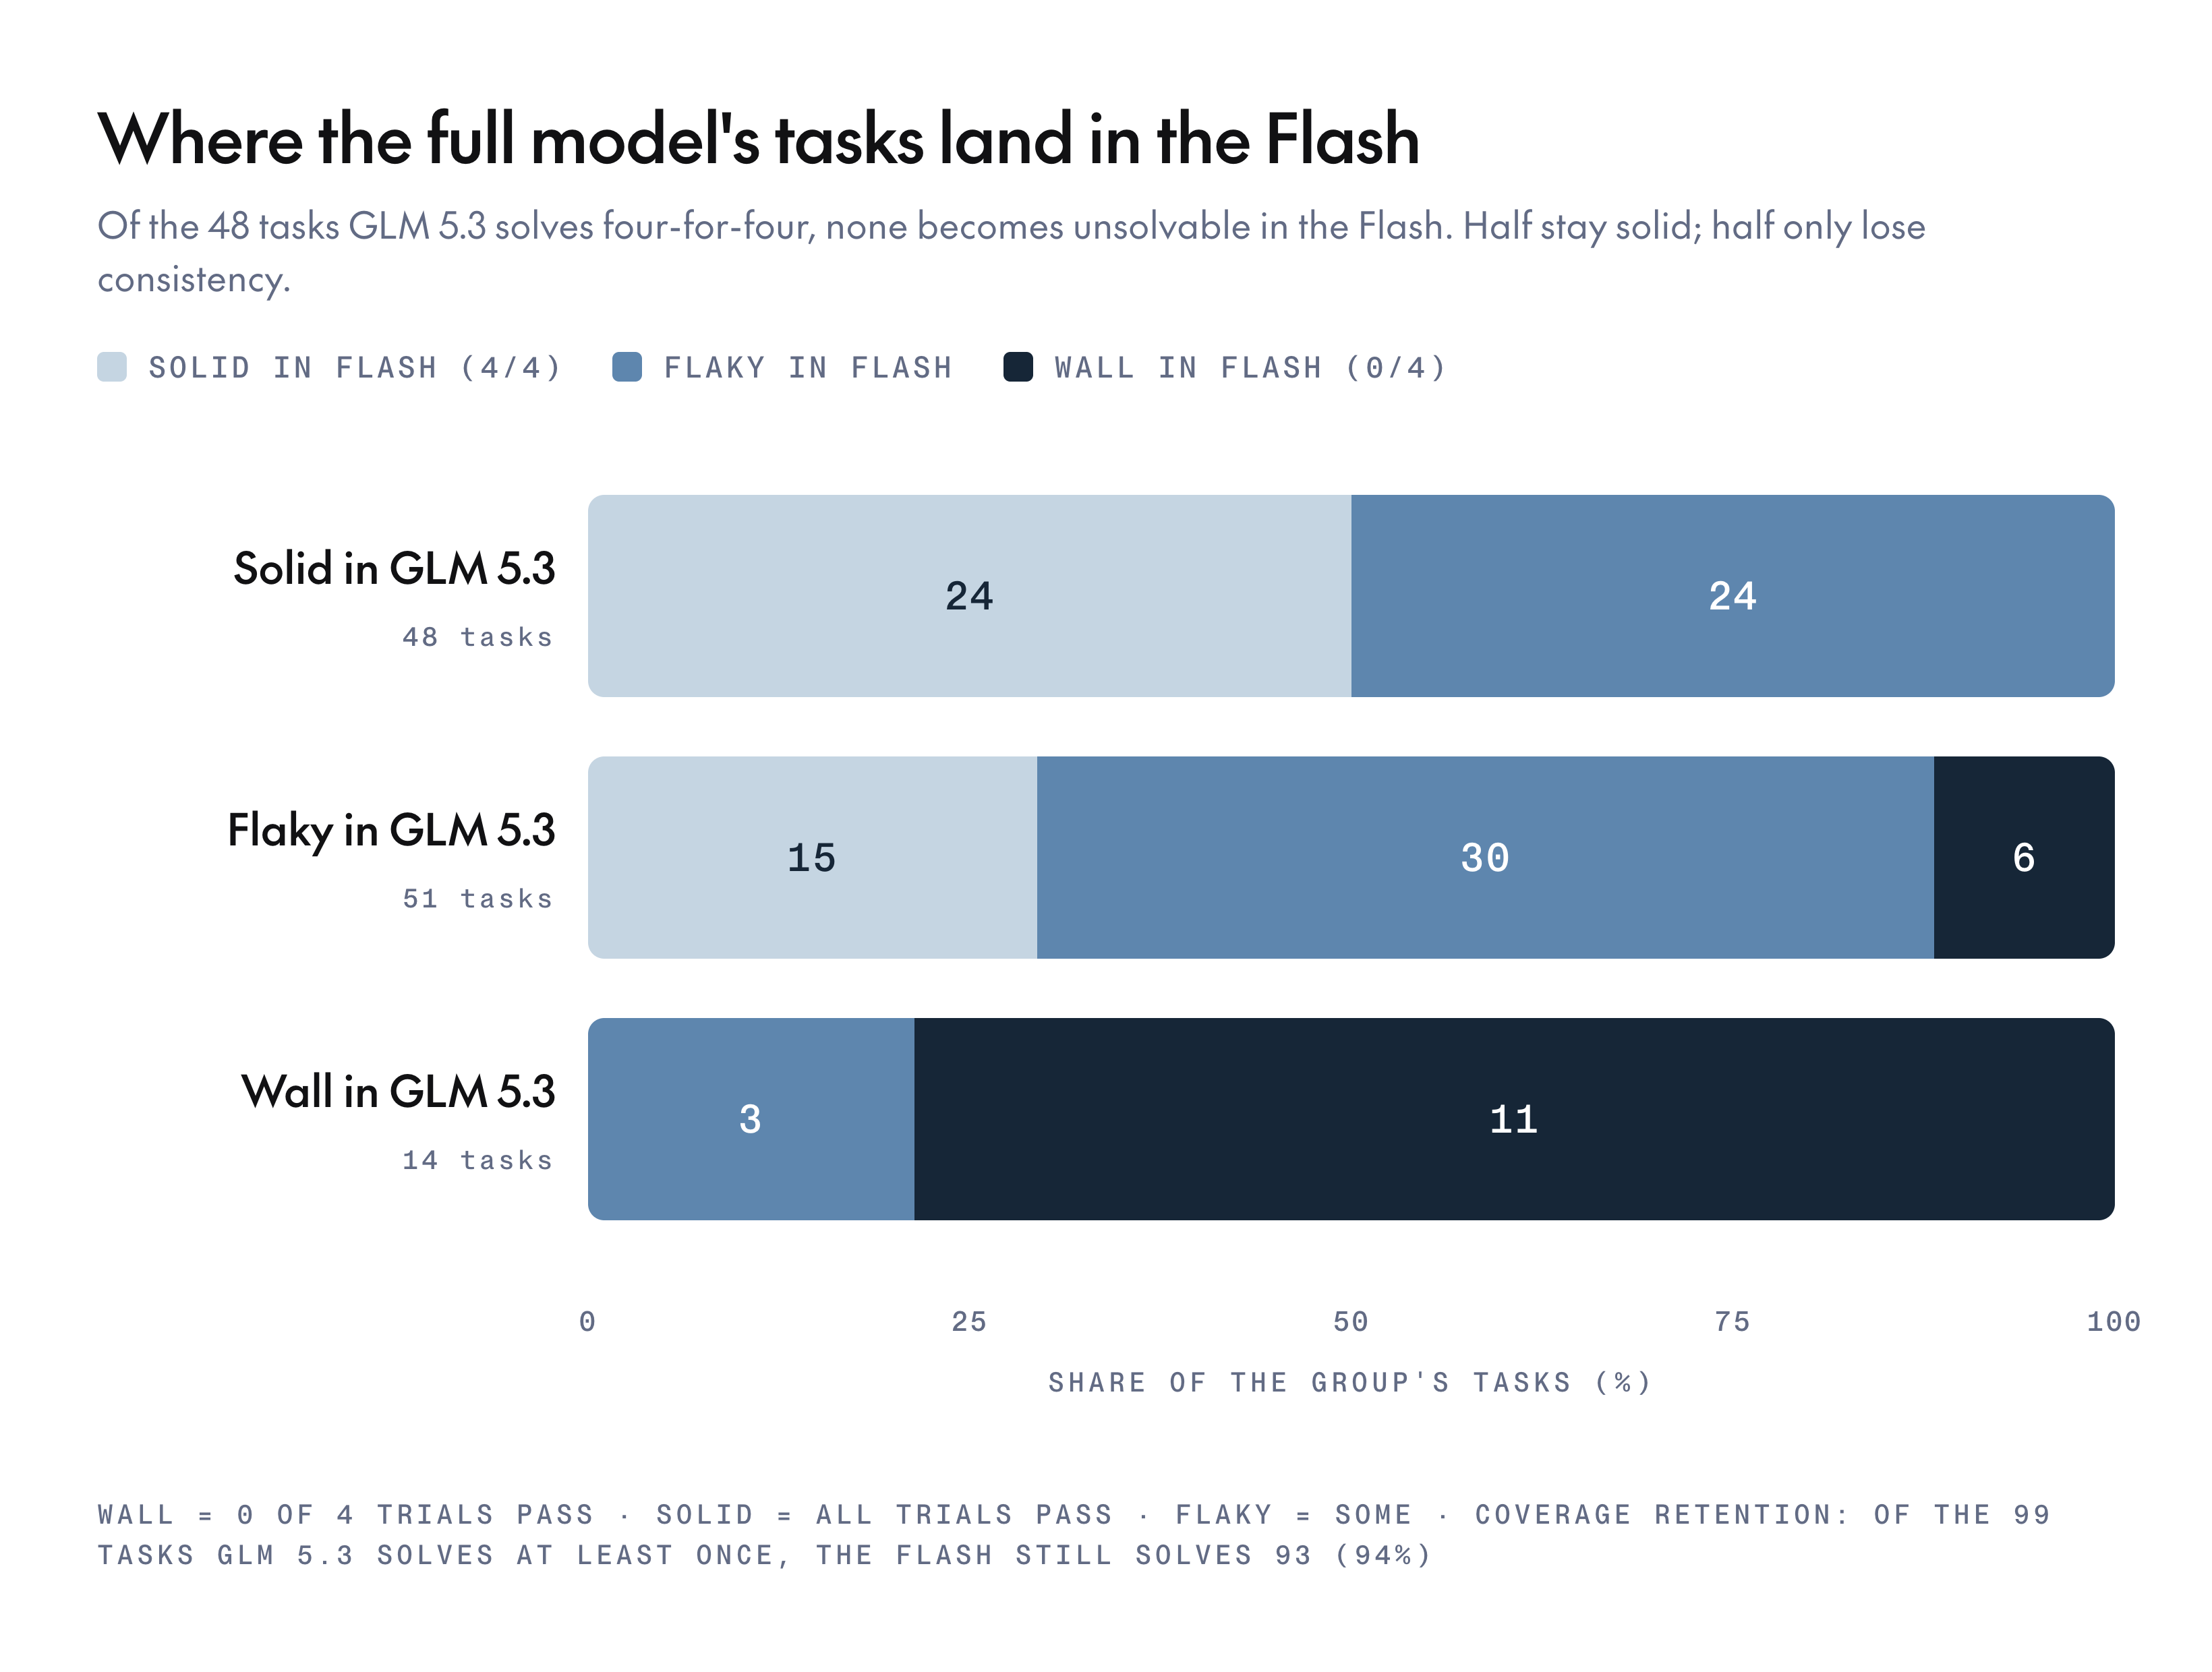
对每个模型,将每个任务分类为“墙”(4 次中 0 次通过)、“不稳定”(部分通过)或“稳固”(全部通过),然后追踪完整模型的任务在 Flash 中落在哪里。
右上角的零承载着这一节的核心:在完整模型四次全过的 48 个任务中,没有一个在 Flash 中变得无法解决。一半保持完全稳固;另一半只是失去了一致性。覆盖率保留也说明了同样的问题:在完整模型至少解决过一次的 99 个任务中,Flash 仍然能解决 93 个,即 94%。蒸馏并没有移除解决这些任务的能力。它移除的是可靠性。与能力损失不同,一致性损失恰恰是重试可以恢复的,这就是为什么 pass@4 的差距远小于 pass@1 的差距。
成本对比:GLM-5.3 对比 GLM-5.3 Flash 的定价与速度
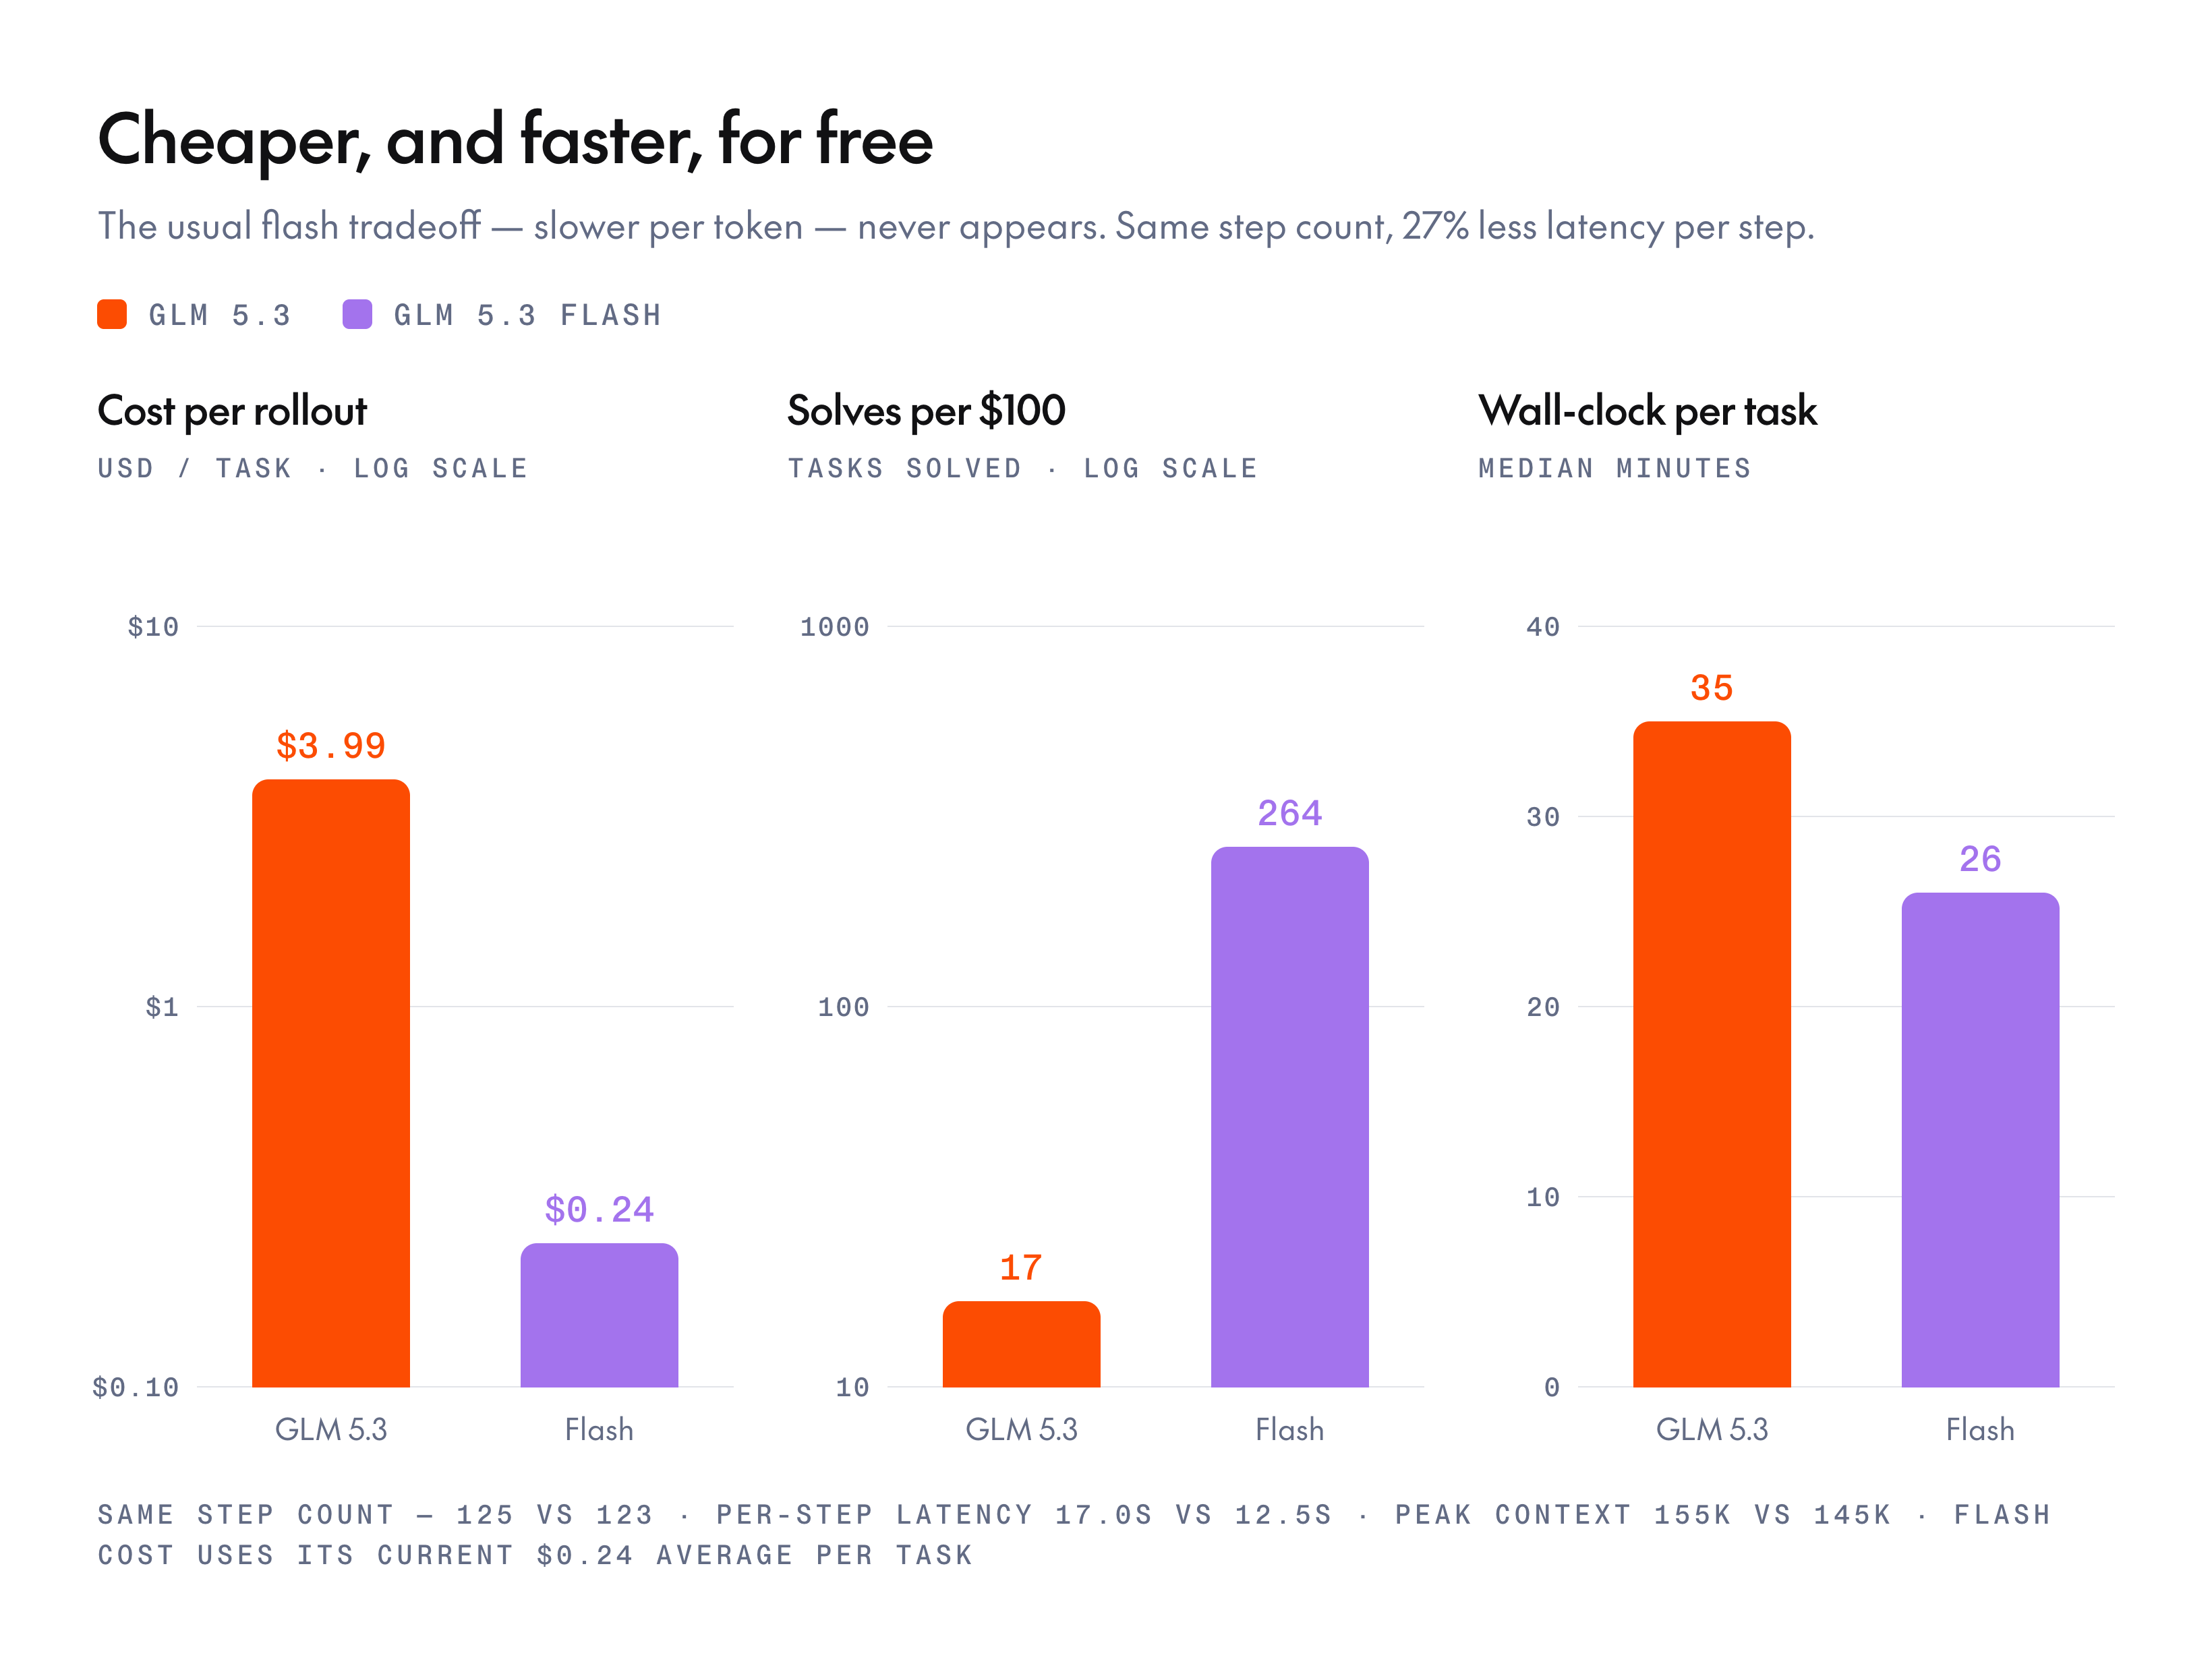
以0.24美元对3.99美元的价格计算,Flash每次运行的成本低17倍:每100美元可完成264次解题,而完整模型仅为17次。常见的Flash折衷——每token速度更慢——并未出现。Flash反而更快,平均26分钟,而完整模型为35分钟,且并非通过偷工减料实现:两者运行步数几乎相同,123步对125步。全部速度差异来自每步延迟——Flash每步12.5秒,完整模型为17.0秒——更小的模型在更小的工作窗口中(平均峰值上下文145k,完整模型为155k)每步执行速度快约27%。成本更低、速度更快、思考长度相同。
一致性流失在哪里:蒸馏从边缘侵蚀
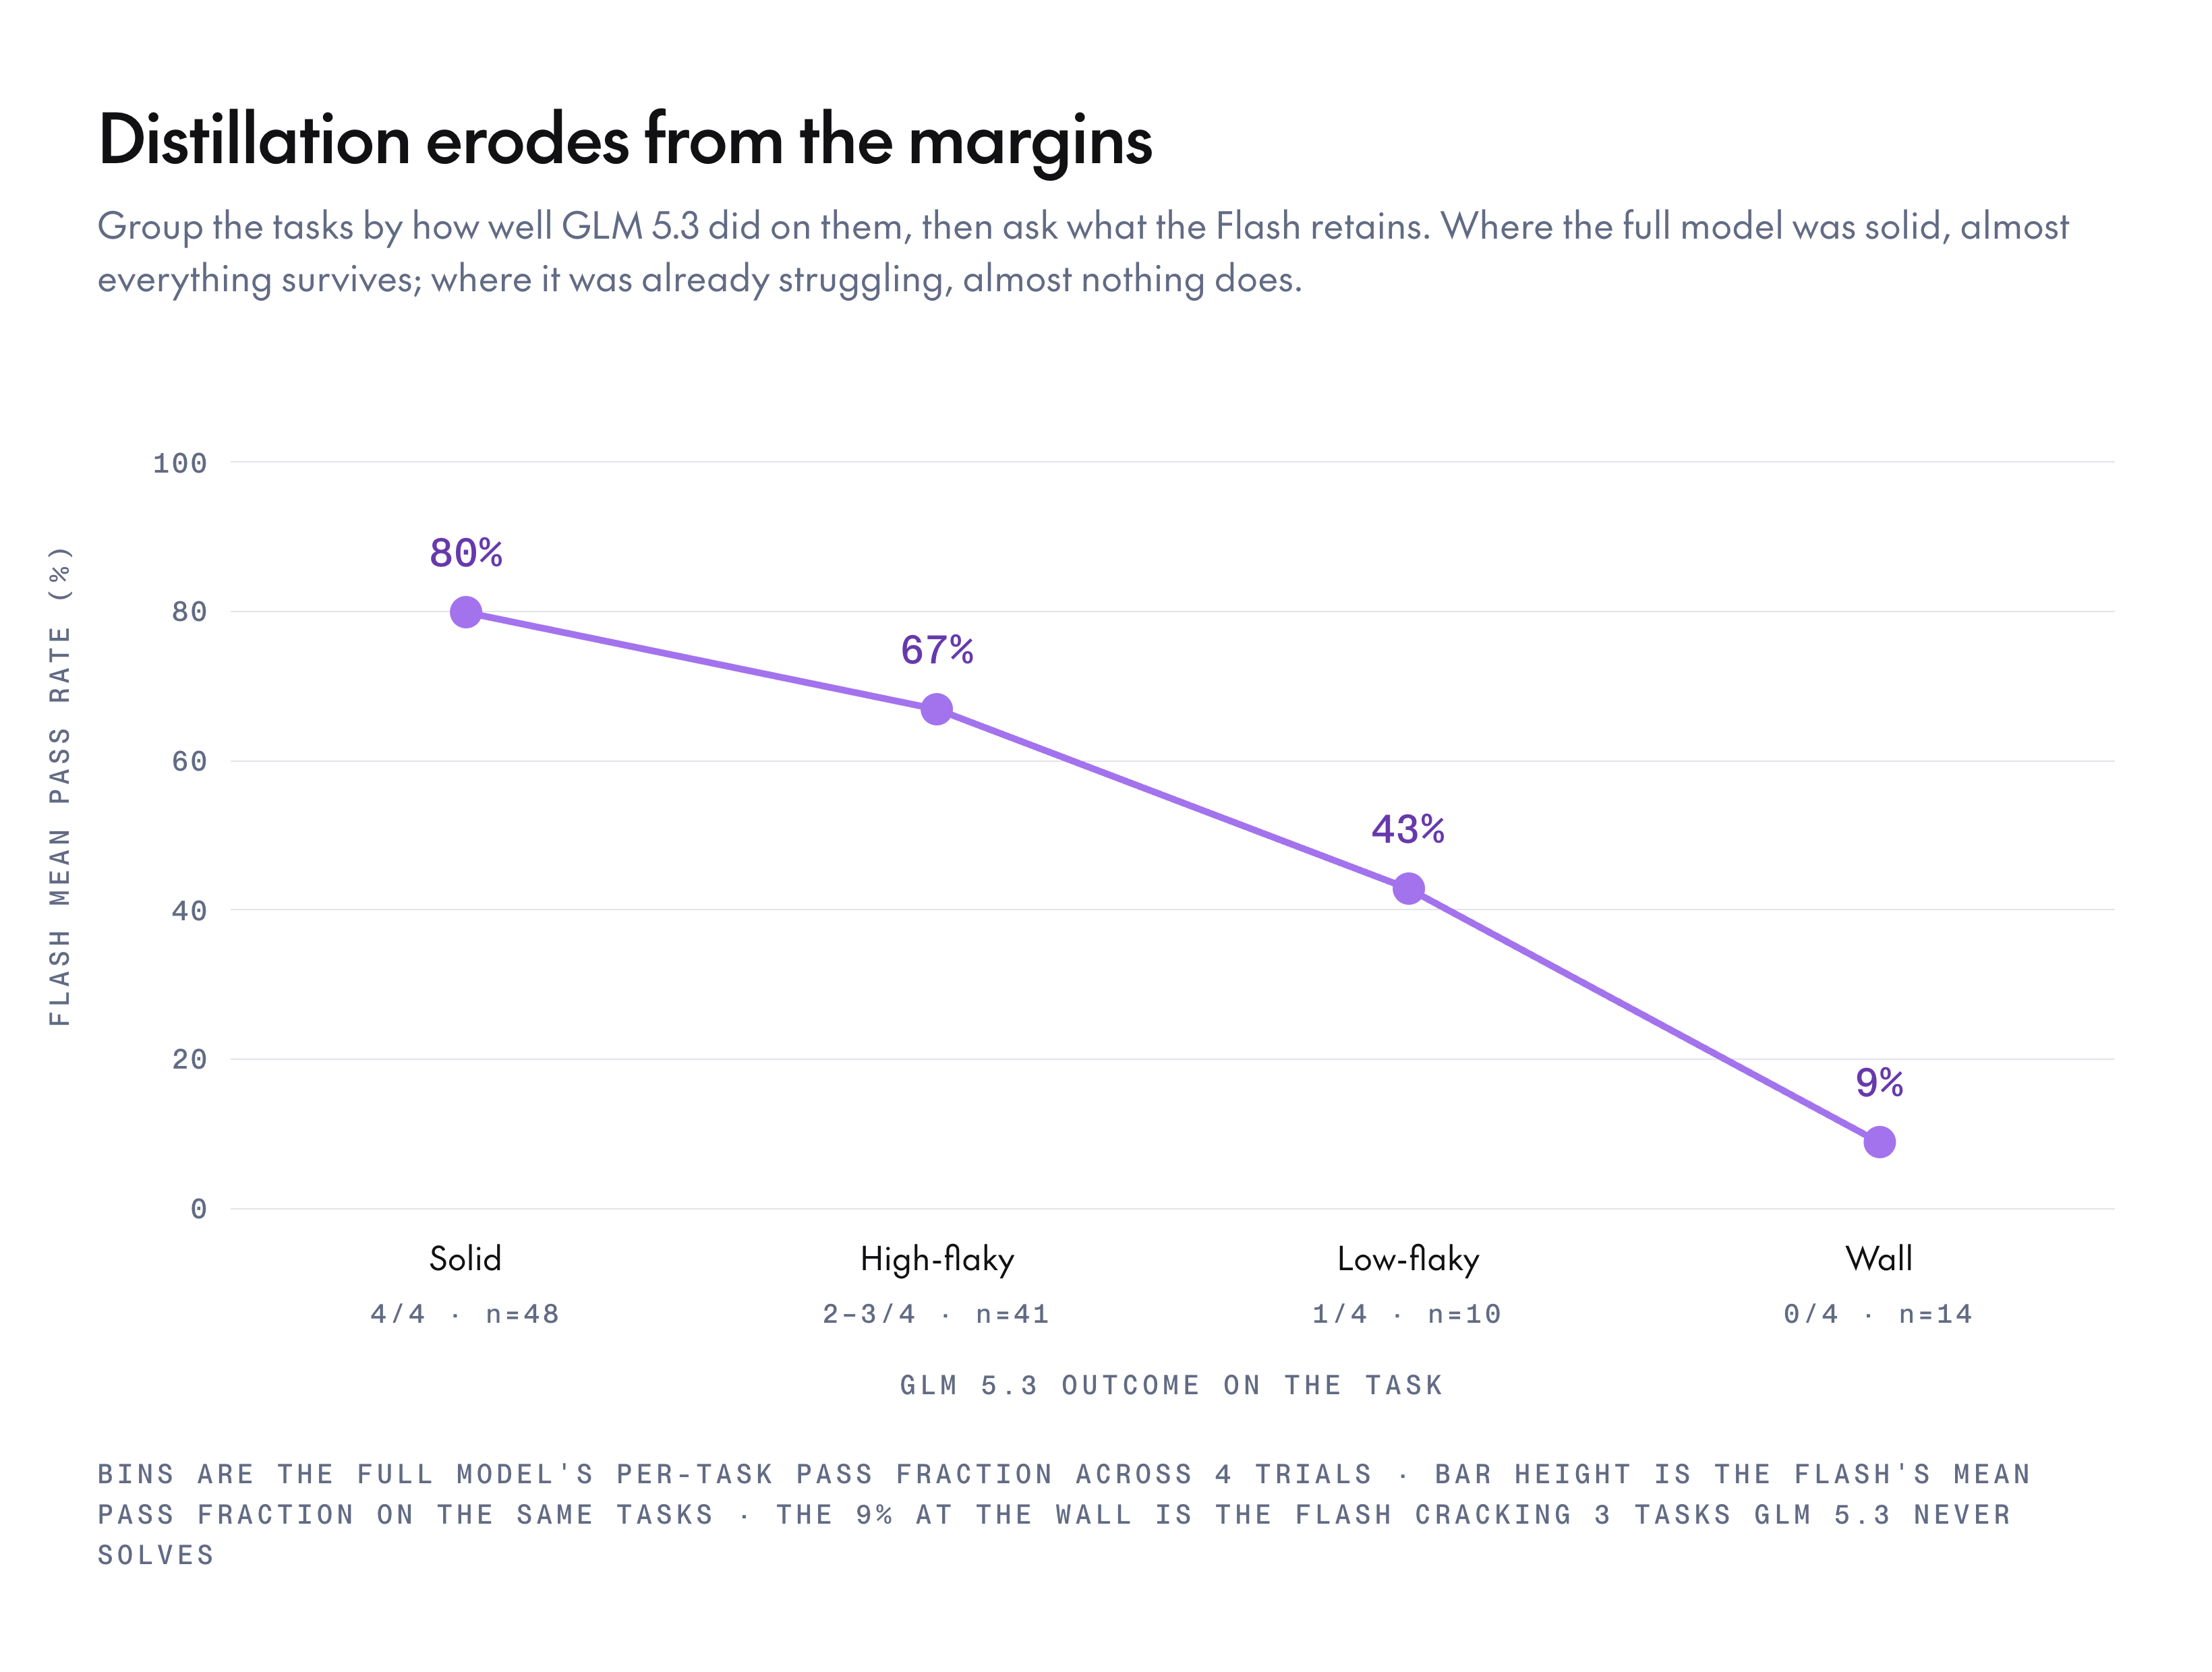
按完整模型解题的可靠程度对任务分组,然后测量Flash在各组中的平均通过率。
结果是一条清晰的单调梯度:完整模型对某任务把握越大,Flash保留的能力就越多。蒸馏从能力分布的边缘啃食,而将核心完整保留。它锐化了模型能与不能之间的边界,而非将整体能力曲线整体下移。
GLM-5.3 Flash丧失了将艰难尝试转化为成功的能力
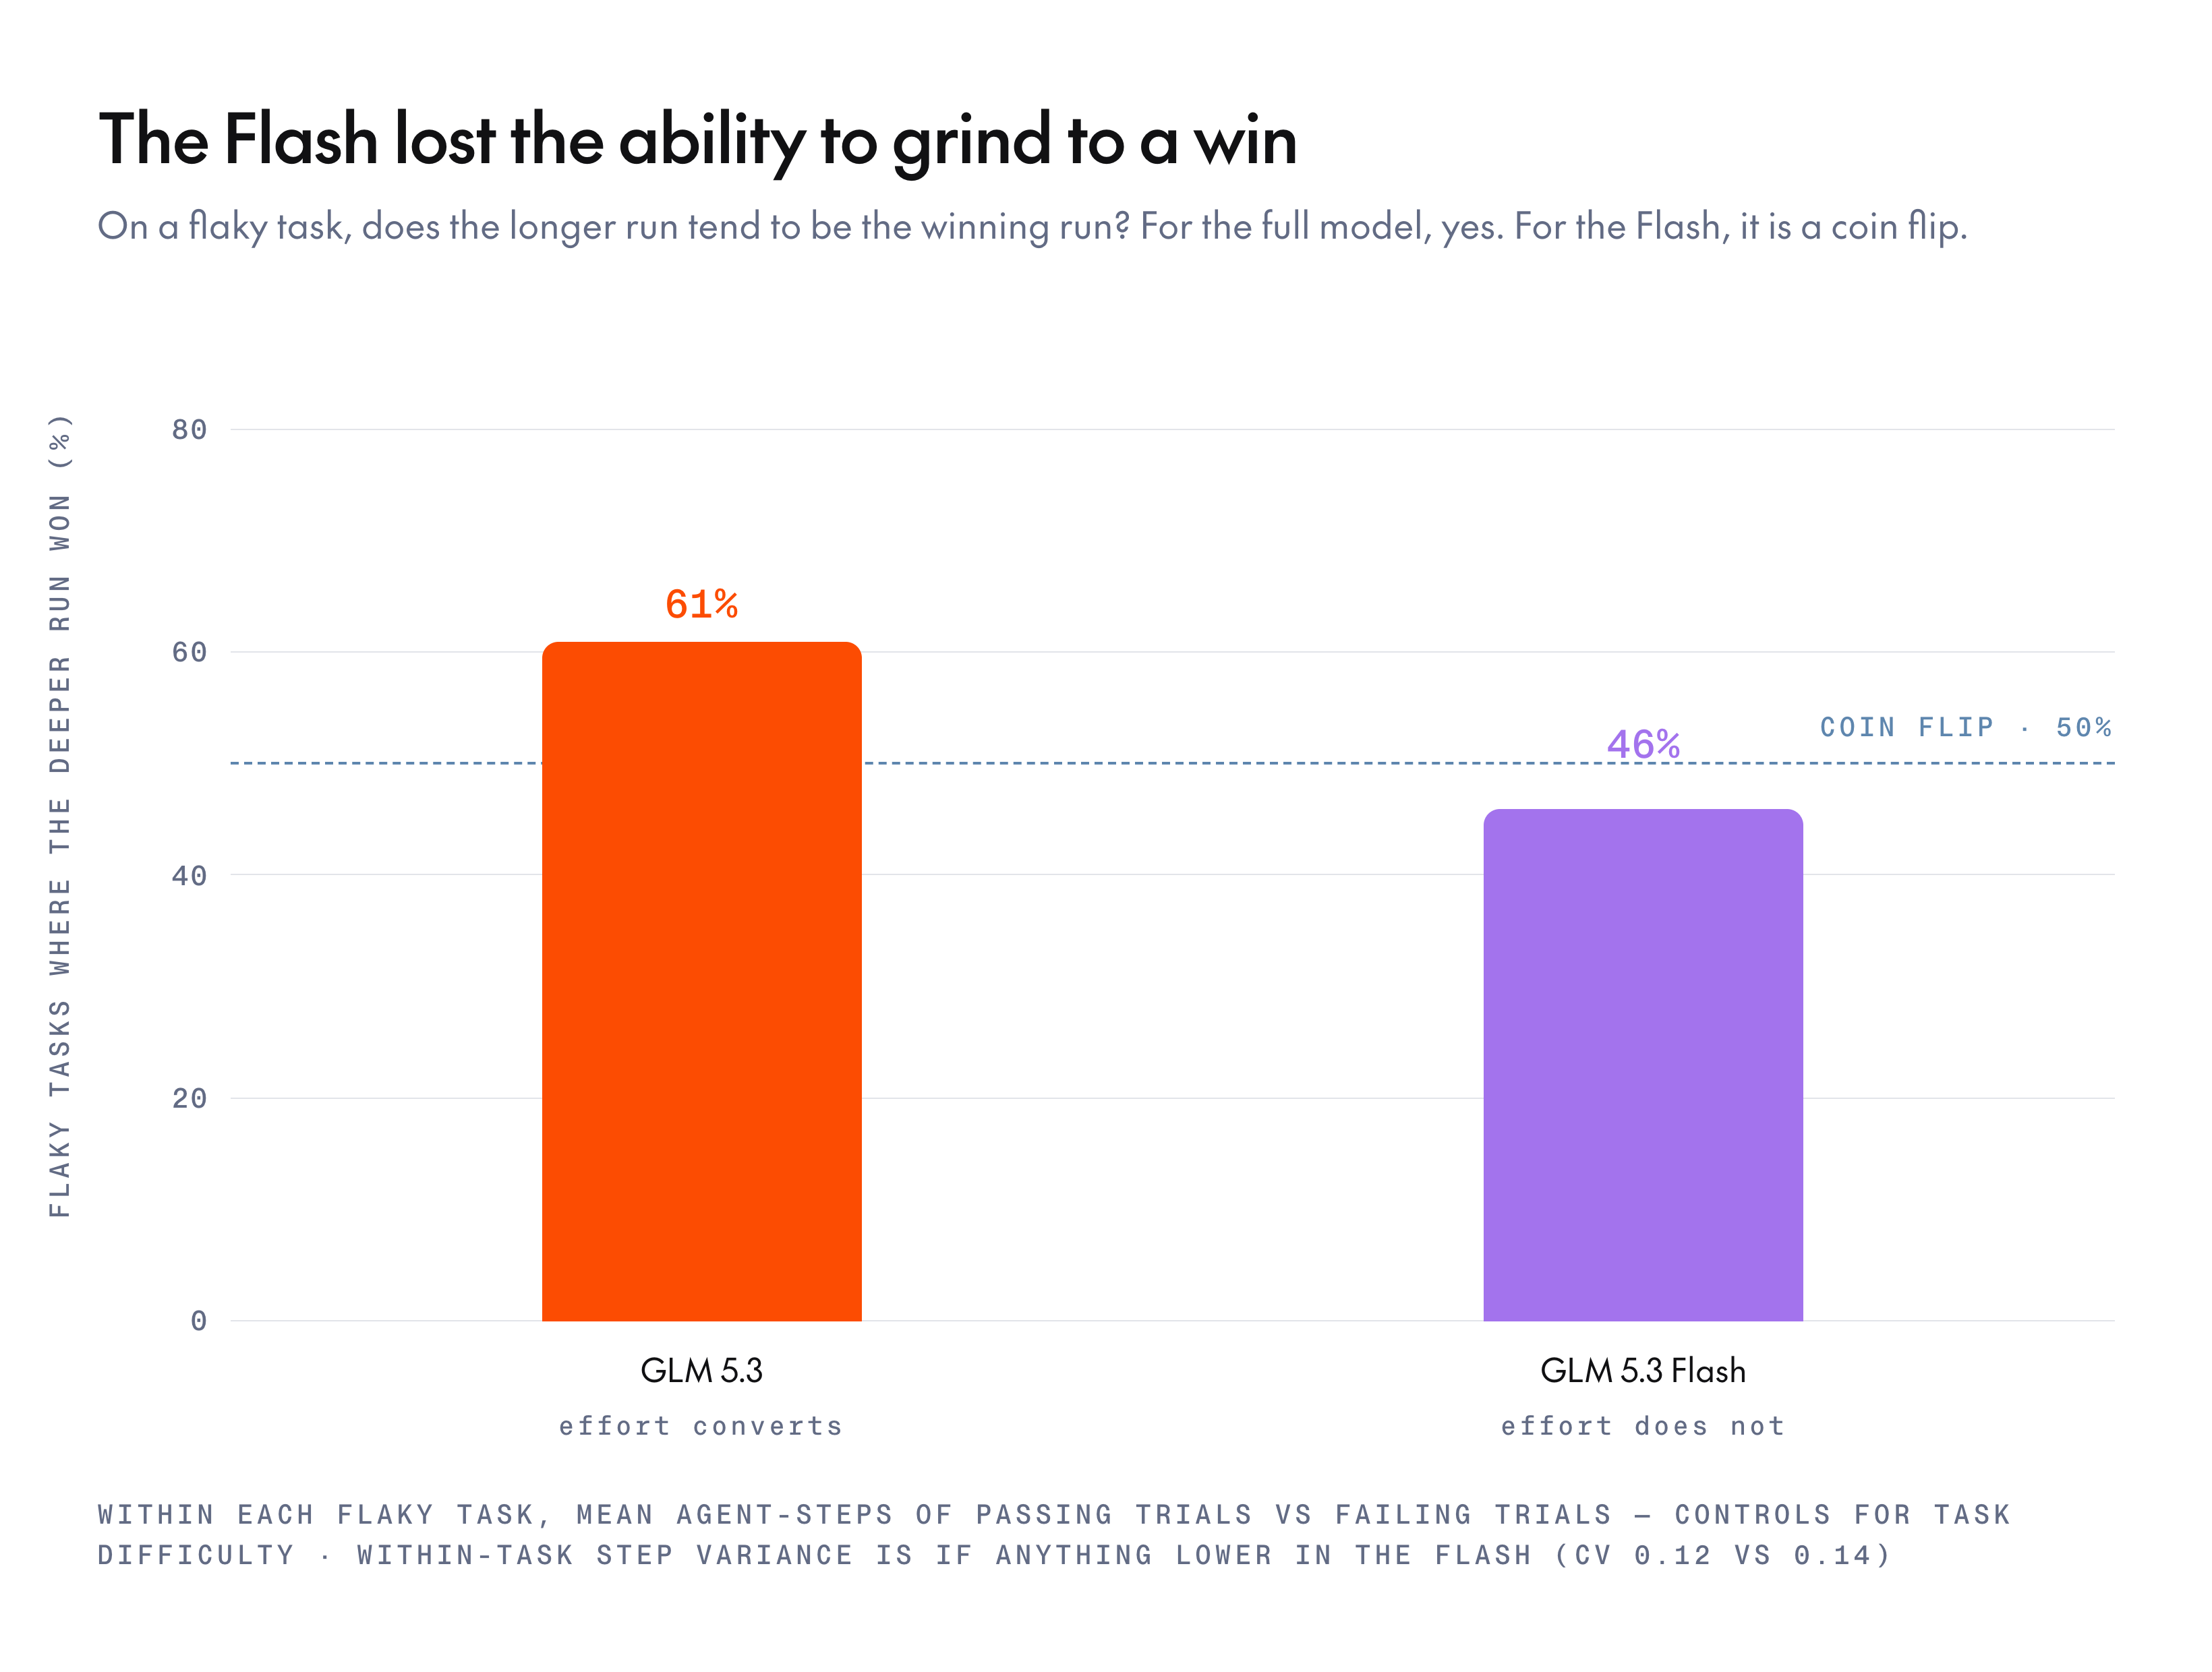
这是不稳定表现背后的机制,也是本研究中最为惊人的结果。在不稳定任务上,关键在于较长的运行是否更倾向于成为成功的运行。相同任务、相同难度,只有运行过程不同。
- 完整版GLM-5.3:在其61%的不稳定任务中,通过的那次运行比失败的那次运行步数更多。完整模型能够通过思考找到解决方案,努力能转化为成功。
- GLM-5.3 Flash:46%,低于抛硬币的随机线。不稳定任务是否成功基本上与Flash运行时长无关。
因此,蒸馏不仅让模型每一步都稍差一些,还剥夺了模型利用额外努力的能力。这也不是无规律的探索:Flash的任务内步数方差略低于完整模型,变异系数为0.12对0.14。它每次运行长度大致相同,有时成功,有时失败。它失去的是那种让完整模型能将艰难尝试转化为已解问题的搜索能力。
各自胜出的领域:按领域和编程语言划分
损失只是账本的一半。Flash在特定领域将能力还了回来:
- 完整模型15个不稳定任务在Flash中变得稳固,稳定了父模型摇摆不定的工作。
- Flash攻克了3个完整模型完全无法解决的任务。
- 按领域看并非全面落后:并发与持久性+8(62至70),Python +5(66至71),数据建模+4(79至83),协议+3(44至48)。它让出了JavaScript、查询与配置、有状态响应式、Rust和语言内部机制。
在八个领域中,完整模型拿下5个,Flash拿下3个;在编程语言方面,完整模型拿下四个(Go、TypeScript、JavaScript、Rust),Flash仅拿下Python一个。完整模型在推理密集型和JavaScript密集型工作中胜出;Flash在系统和Python工作中胜出。Flash的JavaScript数据单独看令人担忧,但它基于仅五个任务的样本,且由一个单一任务驱动,因此应视为方向性参考而非定论。更宏观的解读是,蒸馏重塑了能力轮廓,而非简单地将整体拉低。
精度对覆盖范围
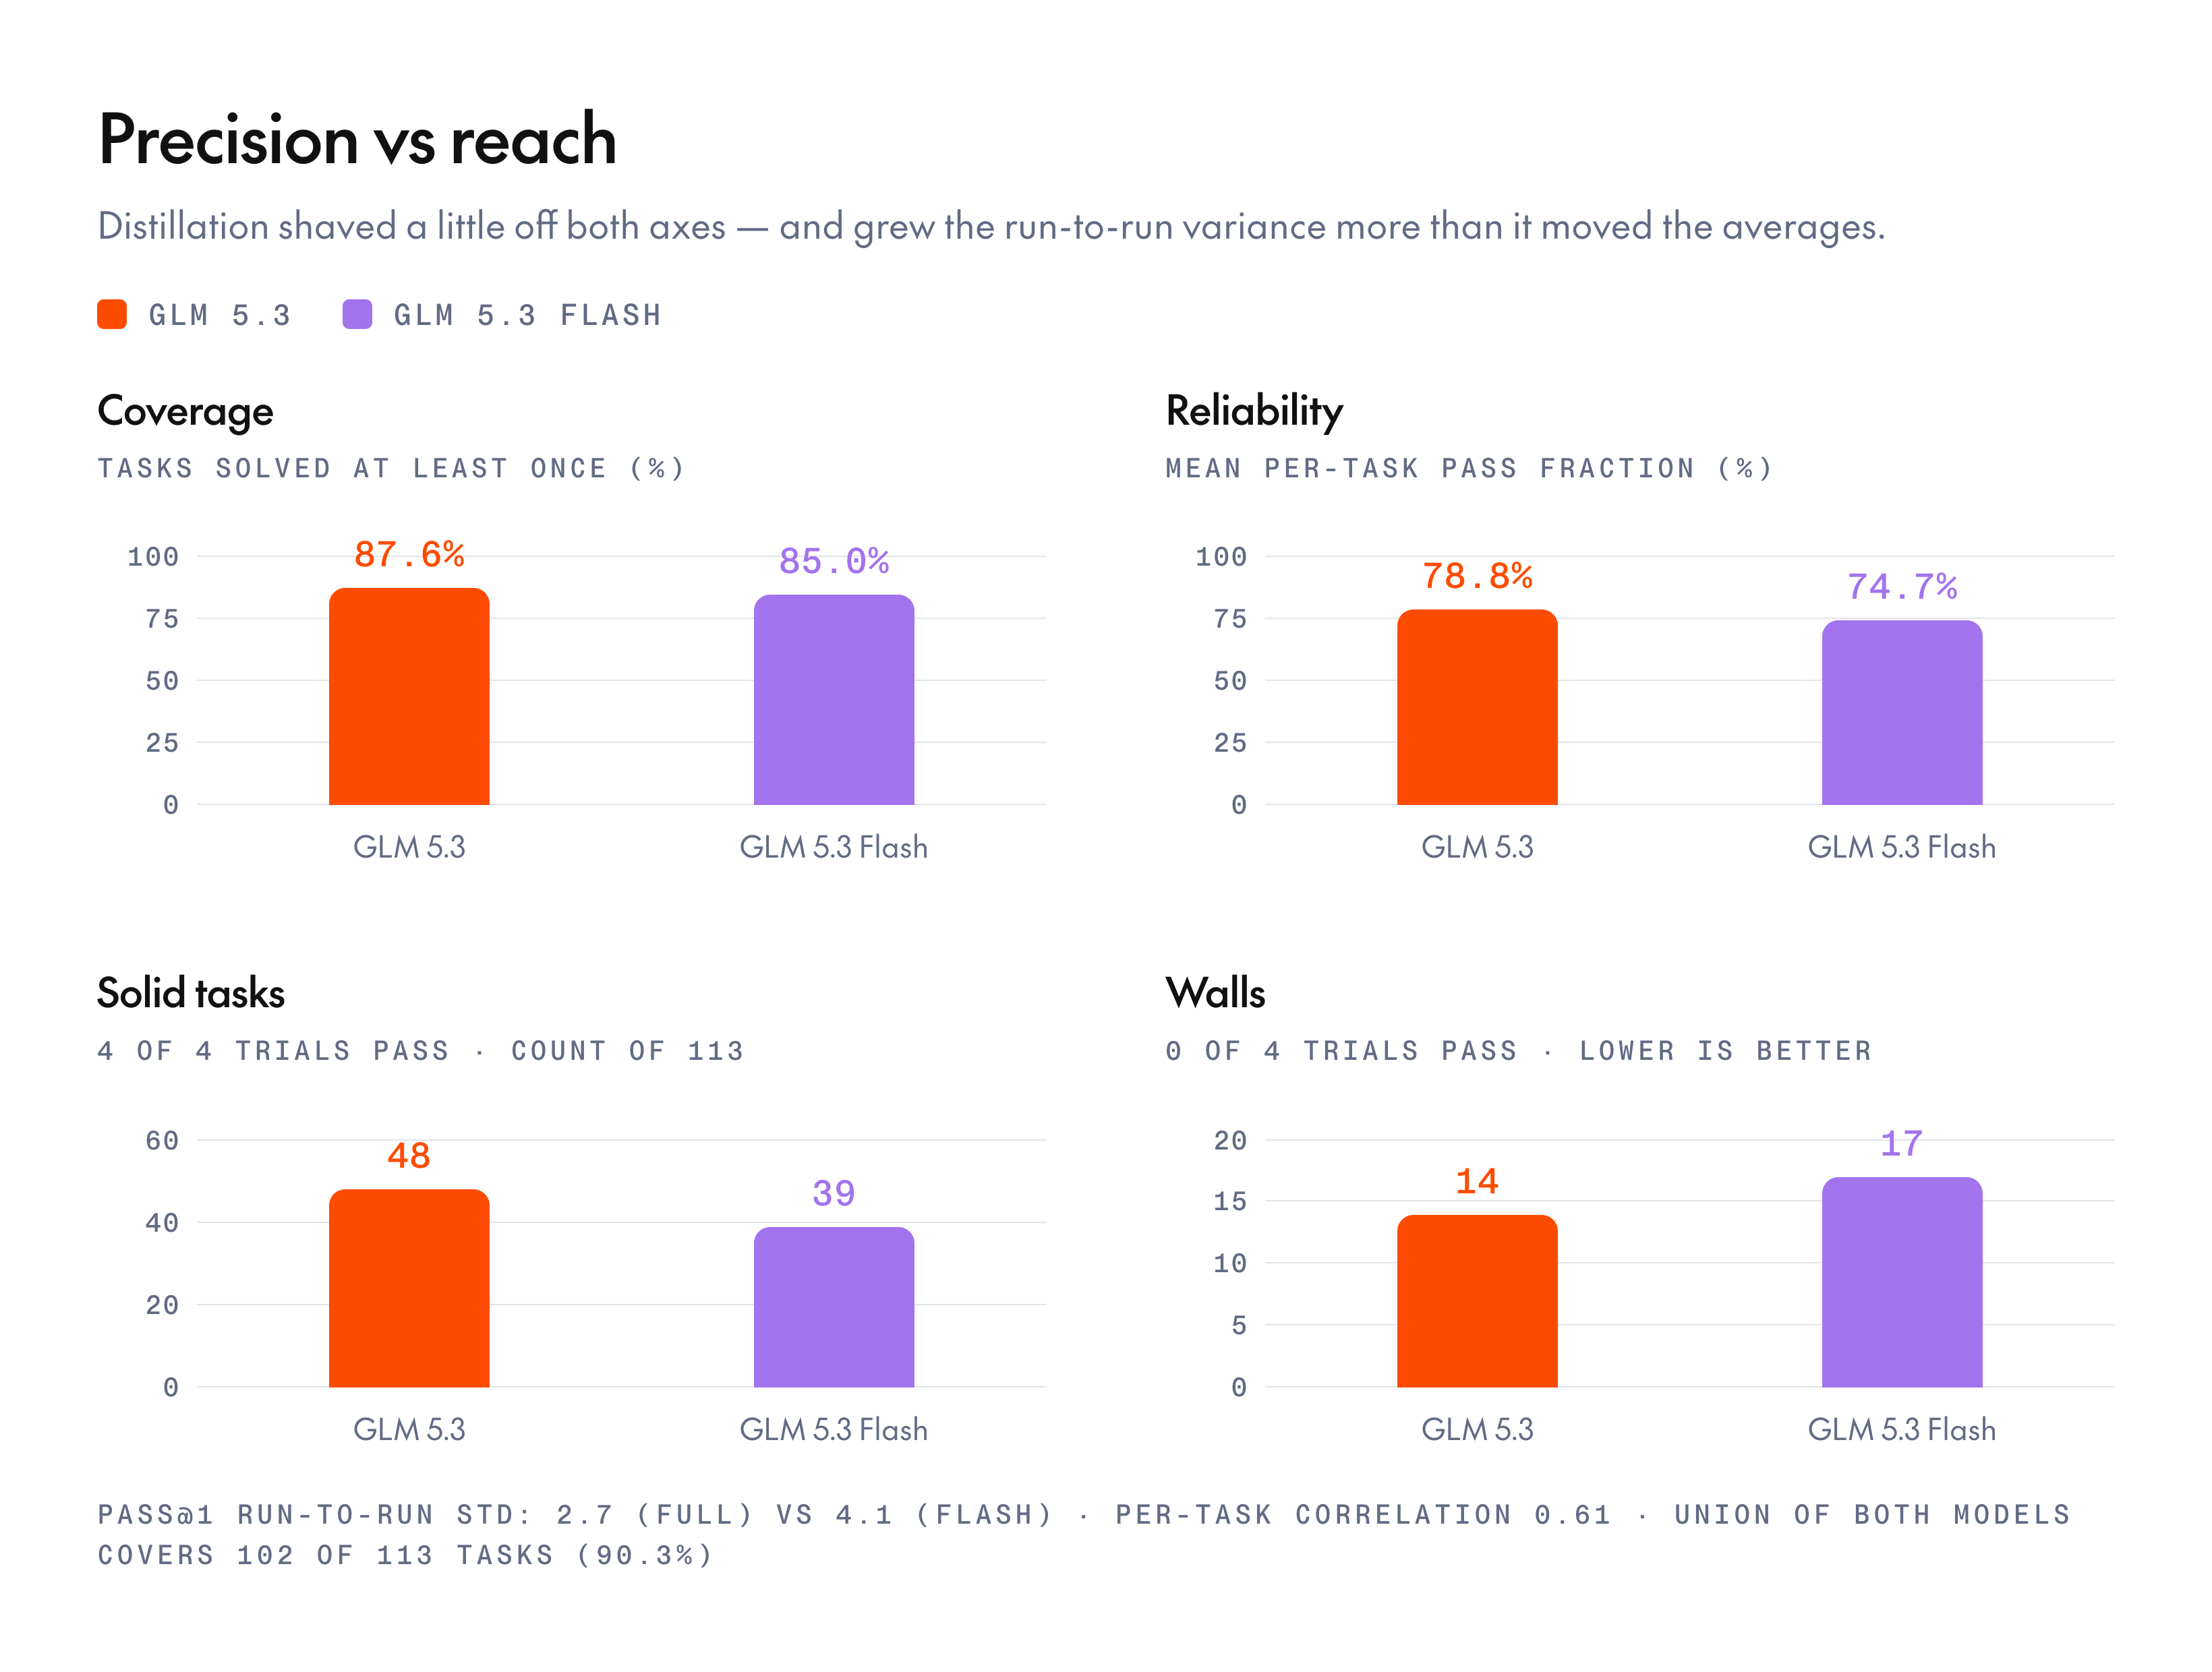
完整模型在覆盖-可靠性平面上位于右上方:覆盖率87.6%,可靠性78.8%,而Flash分别为85.0%和74.7%。完整模型有48个任务四次全对,Flash为39个;完整模型完全无法解决14个任务,Flash为17个。蒸馏在两个维度上都削去了一点,但Flash在计分板上的运行间波动增长幅度超过了其平均值下降的幅度(pass@1标准差4.1对2.7),这正是从总体视角看到的同一一致性故事。
唯一真正的回退:附带损伤
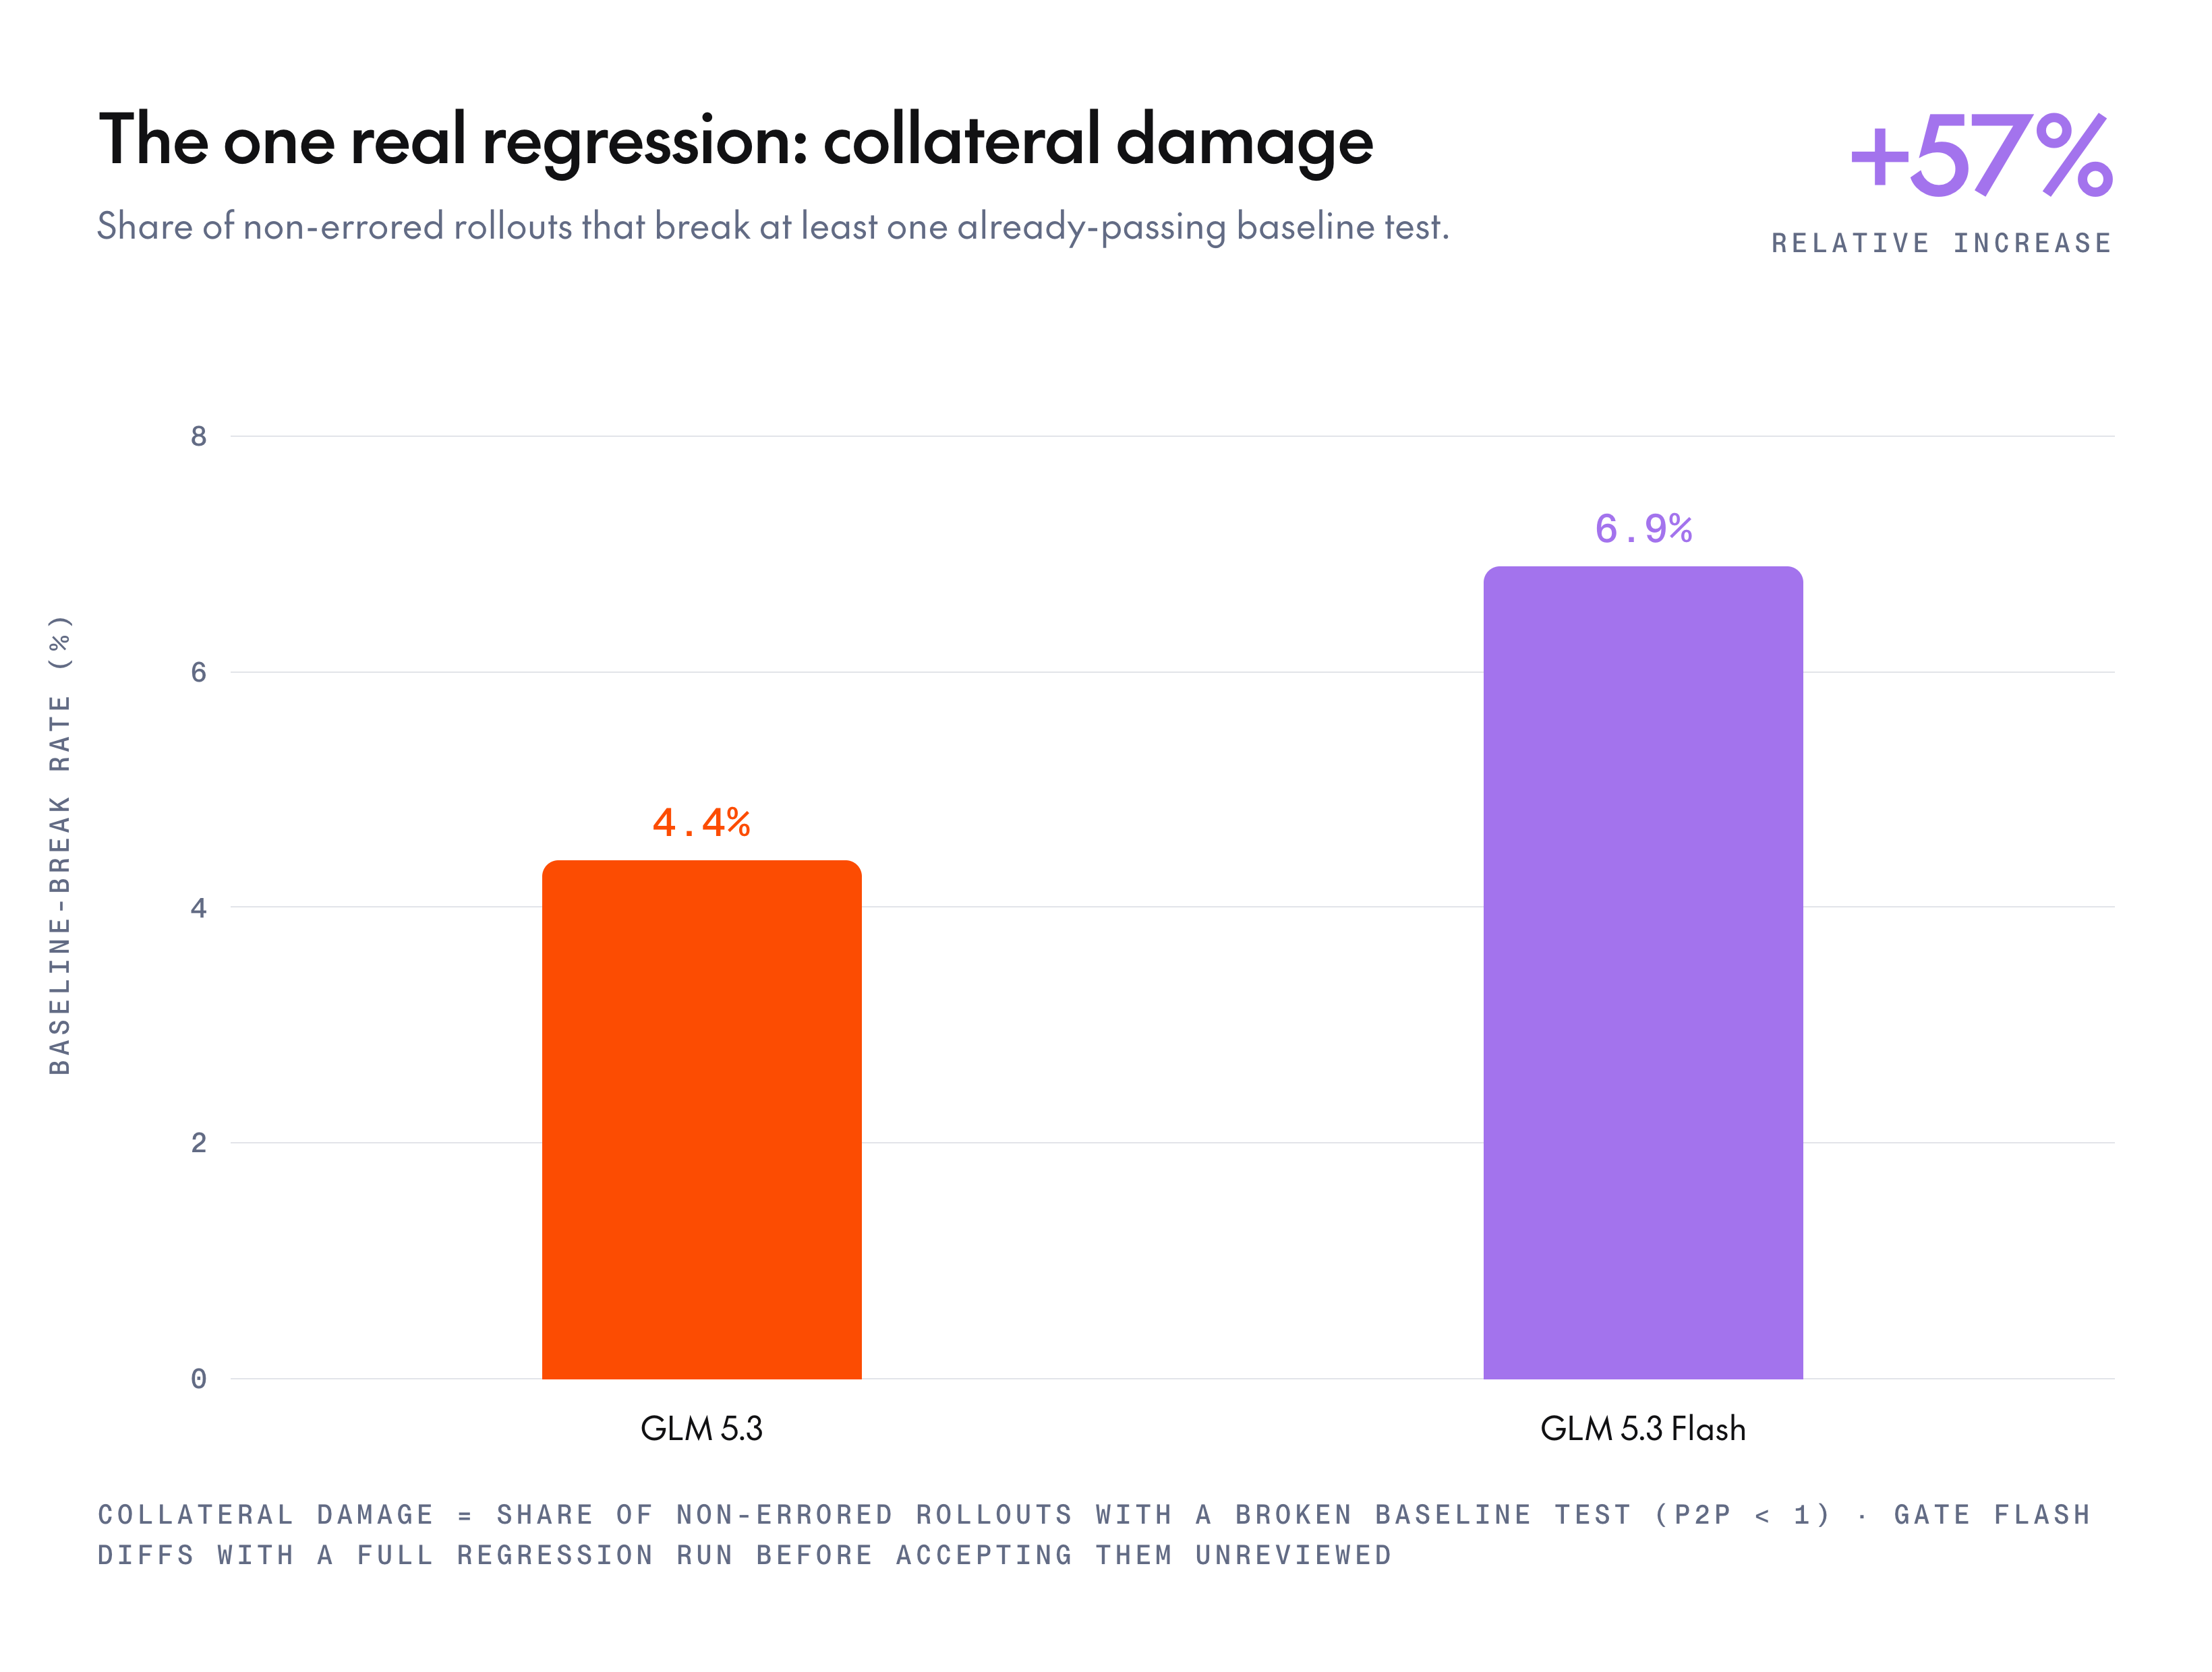
并非所有指标都对 Flash 有利。除了准确性和一致性之外,蒸馏还使模型在“附带损害”方面明显不那么谨慎了。以在未出错的任务中,至少破坏了一个已通过基线测试的任务所占比例来衡量:
- GLM-5.3:4.4%
- GLM-5.3 Flash:6.9%
Flash 在行动时干扰正常代码的可能性高出 50% 以上。这是它表现更差而非仅仅成本更低的唯一维度,也是唯一需要添加防护措施的地方:在接受未经审查的 Flash 差异(diff)之前,先运行完整的回归测试套件。
两者之间的路由:同系级联
由于 Flash 牺牲的质量很小且大部分可恢复,而节省的成本却很大,因此同系级联是一种直接的成本削减方案。先运行 Flash,仅在验证器拒绝答案时才升级到完整模型:80.9% 的准确率,每任务成本 1.70 美元,高于完整模型自身的单次 pass@1 的 69.0%,而成本却不到其一半。两者之间的每任务相关性为 0.61,它们的并集覆盖了 113 个任务中的 102 个(90.3%),因此低成本的第一阶段清除了大部分队列,完整模型只处理剩余的难题,这些难题随后会获得第二次独立尝试。
这意味着什么
将 GLM-5.3 蒸馏为 GLM-5.3 Flash 是手术刀,而非大锤。它保留了能力,但牺牲了稳定性:完整模型的稳固任务中,没有一个变得无法解决,pass@4 的差距是 2.6 个百分点,而非 5.6 个百分点。它移除了让模型将艰难尝试转化为胜利的搜索能力,努力回报率从 61% 降至 46%,这才是其不稳定的真正根源。它重塑了能力画像而非缩小了它,在并发、Python、数据建模和协议方面有所增益,同时让渡了 JavaScript 和查询类工作;而该集合中最令人震惊的头条——JavaScript 的下降——只是五个任务样本中一个任务的影响。它唯一真正的退步是谨慎性,基线破坏率为 6.9%,而完整模型为 4.4%。
经济性压倒其余一切:每次运行成本降低 17 倍,每 100 美元可解决 264 个任务,墙钟时间更快,而 best-of-k 质量仅下降不到 3 个百分点。对于成本受限和吞吐量受限的工作以及任何 best-of-k 流水线,默认使用 GLM-5.3 Flash。当任务以 JavaScript 或查询为主,或需要首次尝试即可可靠完成时,请使用完整的 GLM-5.3。用回归测试来把关 Flash。如果你运行完整模型,请在前面加上 Flash,可将账单削减一半以上。
数据表:GLM-5.3 与 GLM-5.3 Flash 完整结果
DeepSWE · 数据表
逐项指标的完整对比
| 指标 | GLM 5.3 (max) | GLM 5.3 Flash (max) |
|---|---|---|
| pass@1(官方) | 69.0% | 63.4% |
| pass@2 / pass@3 / pass@4 | 81.1 / 85.4 / 87.6% | 77.1 / 82.1 / 85.0% |
| 覆盖率 / 可靠性 | 87.6 / 78.8% | 85.0 / 74.7% |
| 稳固(4/4)/ 失败(0/4) | 48 / 14 | 39 / 17 |
| 每次运行成本 | 3.99 美元 | 0.24 美元 |
| 每 100 美元解决数 | 17 | 264 |
| 平均分钟数 / 步骤数 / 每秒步骤数 | 35 / 125 / 17.0 秒 | 26 / 123 / 12.5 秒 |
| 平均输出 token / 峰值上下文 | 80k / 155k | 73k / 145k |
| 失败回归占比 / 基线破坏率 | 61% 接近,11% / 4.4% | 61% 接近,13% / 6.9% |
| 完整模型稳固任务在 Flash 中变得无法解决的数量 | 48 个中的 0 个 | |
| 不稳定任务上的努力回报率(更深运行获胜) | 61% | 46% |
| 覆盖率保持(完整模型解决的 99 个中) | 93(94%) | |
| 获胜领域(共 8 个) | 5 | 3 |
| 获胜语言 | 4(Go、TS、JS、Rust) | 1(Python) |
| Flash 增益(Flash > 完整模型) | 并发 +8、Python +5、数据 +4、协议 +3 | |
| 每任务相关性 / 并集 | 0.61 / 113 个中的 102 个(90.3%) | |
| 级联 Flash → 完整模型(准确率 / 成本) | 80.9% / 1.70 美元(对比单独完整模型 69.0% / 3.99 美元) | |
| 基础设施错误 | 1 | 0 |
DeepSWE v1.1 · 113 个任务 × 每种配置 4 次试验 · 两者均为最大努力 · Flash 成本使用其当前每任务 0.24 美元的平均值
方法与注意事项
数据:DeepSWE v1.1导出,每种配置4次尝试共113个任务,均采用最大努力模式。GLM-5.3有452次尝试,其中1次基础设施错误;GLM-5.3 Flash在452次中有448次成功,0次基础设施错误,因此少数任务只有3次Flash尝试,类别和通过率按各任务的实际尝试次数计算。
类别:wall = 0次通过,solid = 所有尝试均通过,flaky = 部分通过。覆盖率 = 至少成功解决一次。保留分箱按完整模型的逐任务结果对任务进行分组。
努力回报:在每个flaky任务中,通过尝试与失败尝试的平均智能体步数之比,以通过尝试超过失败尝试的flaky任务占比表示。这控制了任务难度。行为方差是任务内步数的变异系数。
附带损害:未出错回放中基线测试损坏(p2p < 1)的占比。每步耗时是平均时长除以平均步数。步数、token数、分钟数和峰值上下文均为平均值,与DeepSWE网站一致。
Flash成本使用其当前每任务平均0.24美元。领域使用基于工件的分类法。逐轮轨迹JSON在公共CDN上对GLM-5.3两个批次均不可用,因此所有结果均为索引级。
语言分拆样本较小。尤其是JavaScript仅基于五个任务,因此单个任务的变动就会显著影响该单元格。
常见问题
GLM-5.3 Flash和GLM-5.3一样好吗?
接近,而且允许的尝试次数越多越接近。GLM-5.3在pass@1上领先5.6个百分点(69.0%对63.4%),但在pass@4上差距缩小至2.6个百分点(87.6%对85.0%)。GLM-5.3四次全对的48个任务中,没有一个对Flash来说变得不可解,因此损失在于可靠性而非能力。
GLM-5.3 Flash比GLM-5.3便宜多少?
在我们的运行中,GLM-5.3 Flash每次回放成本为0.24美元,而GLM-5.3在最大努力模式下为3.99美元,约便宜17倍。按每个已解决任务计算,Flash每100美元可解决264个任务,而完整模型为17个,即每美元完成的工作量约为后者的16倍。
GLM-5.3和GLM-5.3 Flash哪个更适合编码?
取决于工作内容。GLM-5.3在五种语言中拿下四种(Go、TypeScript、JavaScript、Rust),在八个领域中拿下五个,并且是首次尝试可靠性和推理密集型任务的更强选择。GLM-5.3 Flash在并发性和持久性(70对62)、Python(71对66)、数据建模(83对79)和协议工作(48对44)方面领先。
我应该在GLM-5.3 Flash和GLM-5.3之间进行路由吗?
是的,前提是你能验证结果。先运行GLM-5.3 Flash,当测试套件拒绝输出时升级到GLM-5.3,可达到80.9%的通过率,每任务成本1.70美元,优于单独使用GLM-5.3(69.0%,3.99美元),且价格不到一半。逐任务相关性为0.61,两者合计覆盖113个任务中的102个。
GLM-5.3 Flash可以不经过审查直接接受吗?
请添加回归门禁。GLM-5.3 Flash在6.9%的未出错回放中破坏了至少一个已通过的基线测试,而GLM-5.3为4.4%,因此其干扰现有正常代码的可能性高出50%以上。在接受diff之前运行完整的回归测试可以弥合大部分差距。
DeepSWE上的pass@k是什么?
pass@k衡量一个任务的k次尝试中是否至少有一次通过隐藏测试套件。pass@1奖励首次尝试即成功;更高的k奖励模型能在多次尝试中最终找到解决方案。GLM-5.3 Flash的差距随k增大而缩小,这就是它适合容忍重试的流水线的原因。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。