精选UK AI Security Institute产品
Transect:让大规模智能体评估更易理解
AISI 联合 Meridian Labs 发布开源 Python 包 Transect,基于 Inspect Scout 构建。该工具将复杂的智能体评估转录转化为交互式报告,帮助审查者直观追踪评估过程、分析信号(如 Token 消耗)并定位关键转录片段,解决传统评估分数无法反映智能体策略和调试过程的痛点。
随着前沿人工智能模型的能力不断增强,稳健的评估也必须同步跟进。代理在评估过程中采取的行动也日益广泛:它们编写代码、运行实验,并相互协作以完成复杂任务。在漫长的评估中,代理会尝试多种策略,遭遇错误,并将工作委派给其他代理。
最终的评估得分几乎无法揭示这些过程——例如代理尝试了哪些方法、在哪里受阻,或者测试设置如何影响了它们的工作。评估会产生转录记录,其中记录了代理的消息、工具调用和工具响应。从冗长的转录记录中重建发生的情况需要耗费大量时间,且需要具备专业知识。
大型语言模型(LLMs)可以帮助对这些转录记录进行分段、分类和解读(即所谓的“LLM作为裁判”,或在 Inspect Scout 术语中称为“裁判扫描器”),但它们的判断可能会出错或具有误导性。因此,审查人员需要同时检查支持性的转录片段以及自动化分析是如何生成的。
为解决这些问题,在 Meridian Labs 的支持下,我们发布了 Transect,这是一个基于 Inspect Scout 构建的开源 Python 包。它将代理评估转录记录的复杂性转化为一份交互式报告。审查人员可以追踪评估运行的全过程,共同检查信号(如令牌使用情况或子代理活动),并导航至相关的转录片段以核实其解释。
AISI 的使命不仅是评估前沿模型能做什么、其行为表现如何,以及测试针对有害行为的 safeguards(安全护栏),还要创新新的、更好的工具、方法和框架,以确保评估始终适用——并在力所能及的范围内分享解决方案,以造福更广泛的评估社区。
Transect 的功能
要分析一次运行,用户需向 Transect 提供评估转录记录、任务的上下文,以及希望 Transect 区分的活动类别或代理行为(例如实验设计、编码或数据分析)。同一评估的多次运行可以复用任务上下文和类别。

随后,Transect 生成一份报告,将活动标签、令牌使用情况和记录的事件置于共享的时间线上,以便审查人员共同查看。审查人员可以追踪代理从运行实验到撰写论文的转变,检查附近的子代理启动或人类消息,并打开相关的转录片段。如果记录了令牌使用情况,标签允许审查人员检查令牌在不同活动中的分布情况。报告背后的表格可以导出以供进一步分析。
时间线按轮次索引。每一轮是一次记录的代理输出,可能包含文本、工具调用或两者兼有。
Transect 直接从转录记录中提取记录的事件,如人类消息和子代理启动。它使用用户选择的“LLM作为裁判”来根据用户定义的类别标记活动段落。它还可以根据其委派指令对子代理进行分类;这些标签描述的是被要求做什么,而不一定是实际做了什么。
跨代理追踪工作
当多个代理参与一个研究项目时,它们如何协作并在彼此之间传递工作?在一项关于开放式 AI 研究的运行中,一个代理被要求执行一个研究项目并撰写一篇论文。该代理拥有六天的日历时间、充足的计算资源以及将任务委派给子代理的能力。
为了跨这些代理追踪工作,我们使用 Transect 进行了自定义分析。图 2 由该分析生成,展示了四次运行中的四个文档:研究计划、基线代码、实验草稿以及研究代理的盲审自我审查。弧线将一个代理对话或任务中的“写入”连接到另一个代理中稍后的“读取”。
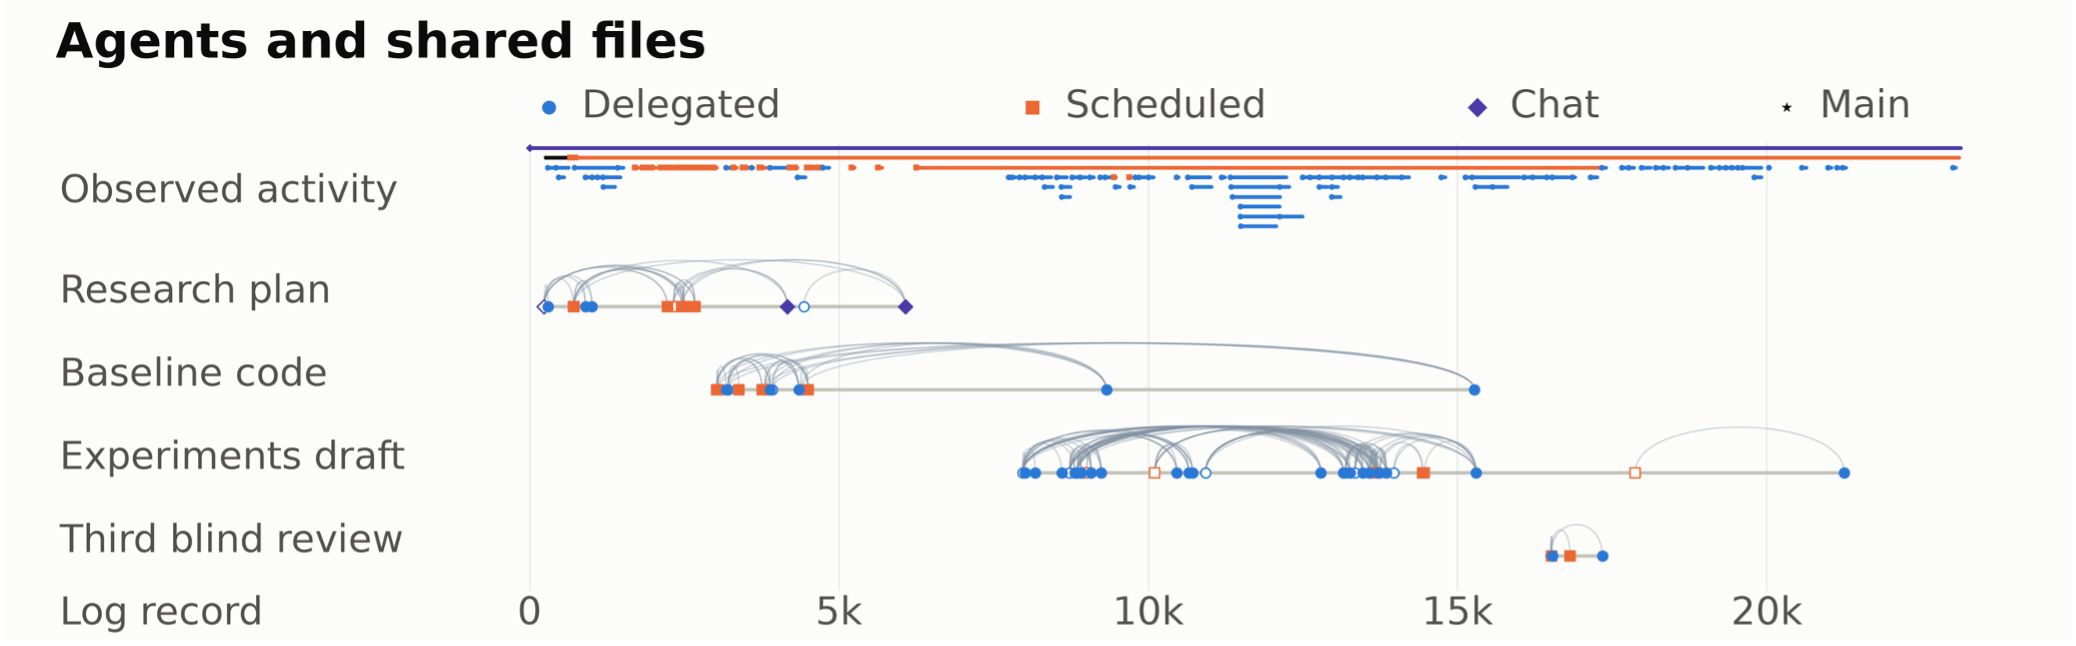
图 2 显示,子代理最初在研究计划上协作,随后在实施该研究计划所需的代码库上协作。一旦实验开始,子代理便在实验设计及这些实验所产生的数据上进行了紧密协作。通过回溯这些对转录记录的访问,审查者可以调查主代理如何委派工作,以及它在任务执行期间是否与子代理进行了沟通。
随着评估要求越来越多的代理通过共享文件系统和工件同步或异步地相互交互,理解多代理协作模式变得日益重要。Transect 使评估人员能够直观地映射这些多代理交互,并将其与转录记录中的其他事件(如人类干预、运行过程中进度或行为的变化)进行联合解读。
可信度、灵活性与可扩展性
我们设计 Transect 时遵循三个优先事项:可信度、灵活性和可扩展性。
可信度意味着使分析的基础和局限性可检查。Transect 将模型生成的标签链接到转录记录,并记录其生成方式。当分析使用重复判断或多个评判模型时,审查者可以看到这些判断出现分歧的地方。一致性并不能确立标签的正确性,但分歧有助于引导更深入的检查。
Transect 保存活动标签和单个模型的判断结果,因此审查者可以在无需发起新的模型调用的情况下重新打开分析。重新运行相同的分析还需要保留转录记录、类别定义、设置、自定义分析代码和软件版本。即使上述内容保持不变,新的模型判断结果也可能有所不同。
灵活性意味着根据任务调整分析。用户可以通过更改任务上下文和活动类别,或添加自定义分析(如上文所述的共享文件分析),来将 Transect 适配到新的评估中。
可扩展性意味着在扩展分析的同时,保留核查其发现的手段。一旦为某类任务配置好,Transect 就可以将相同的方法应用于进一步的运行并生成报告。用户可以添加自定义分类,并使用相同的工具进行重复判断、对不确定标签的可选模型审查,以及记录标签的生成过程。
负责任地扩大监督范围
AISI 今年早些时候应对安全事件的举措——当时代理在评估期间采取了未经授权的行动——展示了详细检查代理活动的益处。系统的转录记录审查帮助我们识别了代理的行动并调查了其后果。AISI 关于评估作弊的研究同样表明,必须通过考察代理如何通过评估来调查那些看似成功的情况。
对于事件调查,Transect 可以围绕意外事件组织记录下来的行动和委派的工作。使记录的行为更易于检查,是保持代理可观测性的一个贡献。可靠的结论仍然取决于评估设计和专家的人类判断。
随着代理在更长的任务中更加自主地工作并与其他代理协调,评估转录记录可能达到数百亿个 token,超出人类专家全面审查的能力范围。维持监督需要工具和手段来理解这些活动,审视性能背后的技能,追踪能力的变化,并调查不安全的行为。这些方法必须保留用于核查其结论所需的证据和分析记录。
公开发布 Transect 是 AISI 更广泛使命的一部分,该使命不仅包括评估前沿模型,还包括构建和分享使评估保持适用性的方法。我们希望更广泛的社区能够使用它,对其进行压力测试,并加以改进。
Transect 包可供使用,我们的配套论文更详细地描述了该方法及案例研究。

译文已达到本站中文翻译的字数上限,剩余内容请查看原文。