LangChain短讯
如何在 Harness 中构建模型路由器以降低成本
Open SWE 团队介绍如何将模型路由器集成到其开发工具链中,通过动态路由策略将编码任务的平均成本降低 64%,且未造成质量下降。文章提供了具体的实现方案与最佳实践,旨在帮助开发者优化多模型调用架构。

关键要点
- 许多任务并不需要前沿智能。在我们的实验中,与基线相比,模型路由将每个编码任务的中位数成本降低了 64%,且质量没有明显变化。
- 有效的模型路由器应位于代理工具链(harness)中,而非通用网关中。选择合适的模型需要领域和任务上下文,而工具链已经具备这些上下文,通用网关通常则缺乏。
- 有效的路由器设计根植于可观测性和评估(evals)。它需要对代理的任务空间、模型性能研究以及明确的成功标准有深入理解。
前沿大语言模型依然昂贵。随着代理变得无处不在并以大规模运行,这种成本是难以承受的。幸运的是,大多数代理并非在每个任务上都需要前沿级别的智能。模型实验室甚至也对此表示认可:Anthropic 的模型选择指南指出,“对于许多应用而言,从更快、更具成本效益的模型(如 Claude Haiku 4.5)开始可能是最佳方案。”
超过某个临界点后,你会面临收益递减:更强大的模型带来的质量提升微乎其微,而成本和延迟却持续攀升。一个好的代理应具备“模型-工具链-任务”的适配性:即为给定任务提供正确的模型和正确的上下文。模型路由器为每个任务挑选出该模型。我们认为,路由决策应属于代理工具链,而非通用网关,因为选择合适的模型需要工具链已经组装好的相同领域和任务上下文,而这通常是通用网关所缺乏的。
最近我们在 LangChain 切身体会到了这一痛点,因为我们每月在编码代理上的支出开始迅速攀升。听到客户们表达同样的担忧后,我们着手为 Open SWE(我们的开源编码代理)构建一个有效的模型路由器。与我们之前始终使用顶级前沿模型的基线相比,它将每条线程的中位数成本降低了 64%,且质量没有任何可测量的变化。本文介绍了我们如何构建路由器、我们学到了什么,以及你如何开始在代理中集成模型路由。
第一步:理解任务
我们的测试平台是 Open SWE,我们的工程师通过 Slack 和 Web UI 使用它来询问关于代码库的问题并请求代码更改。在构建路由器之前,我们需要了解开发者使用 Open SWE 处理的任务类型。我们从 LangSmith 追踪数据中提取了线程级数据:包括传入的请求类型,以及每条线程的成本和轮次计数(作为复杂度的近似衡量指标)。我们在 LangSmith Custom Apps 中进行探索,并在 Open SWE 追踪数据之上构建了一个小型界面。
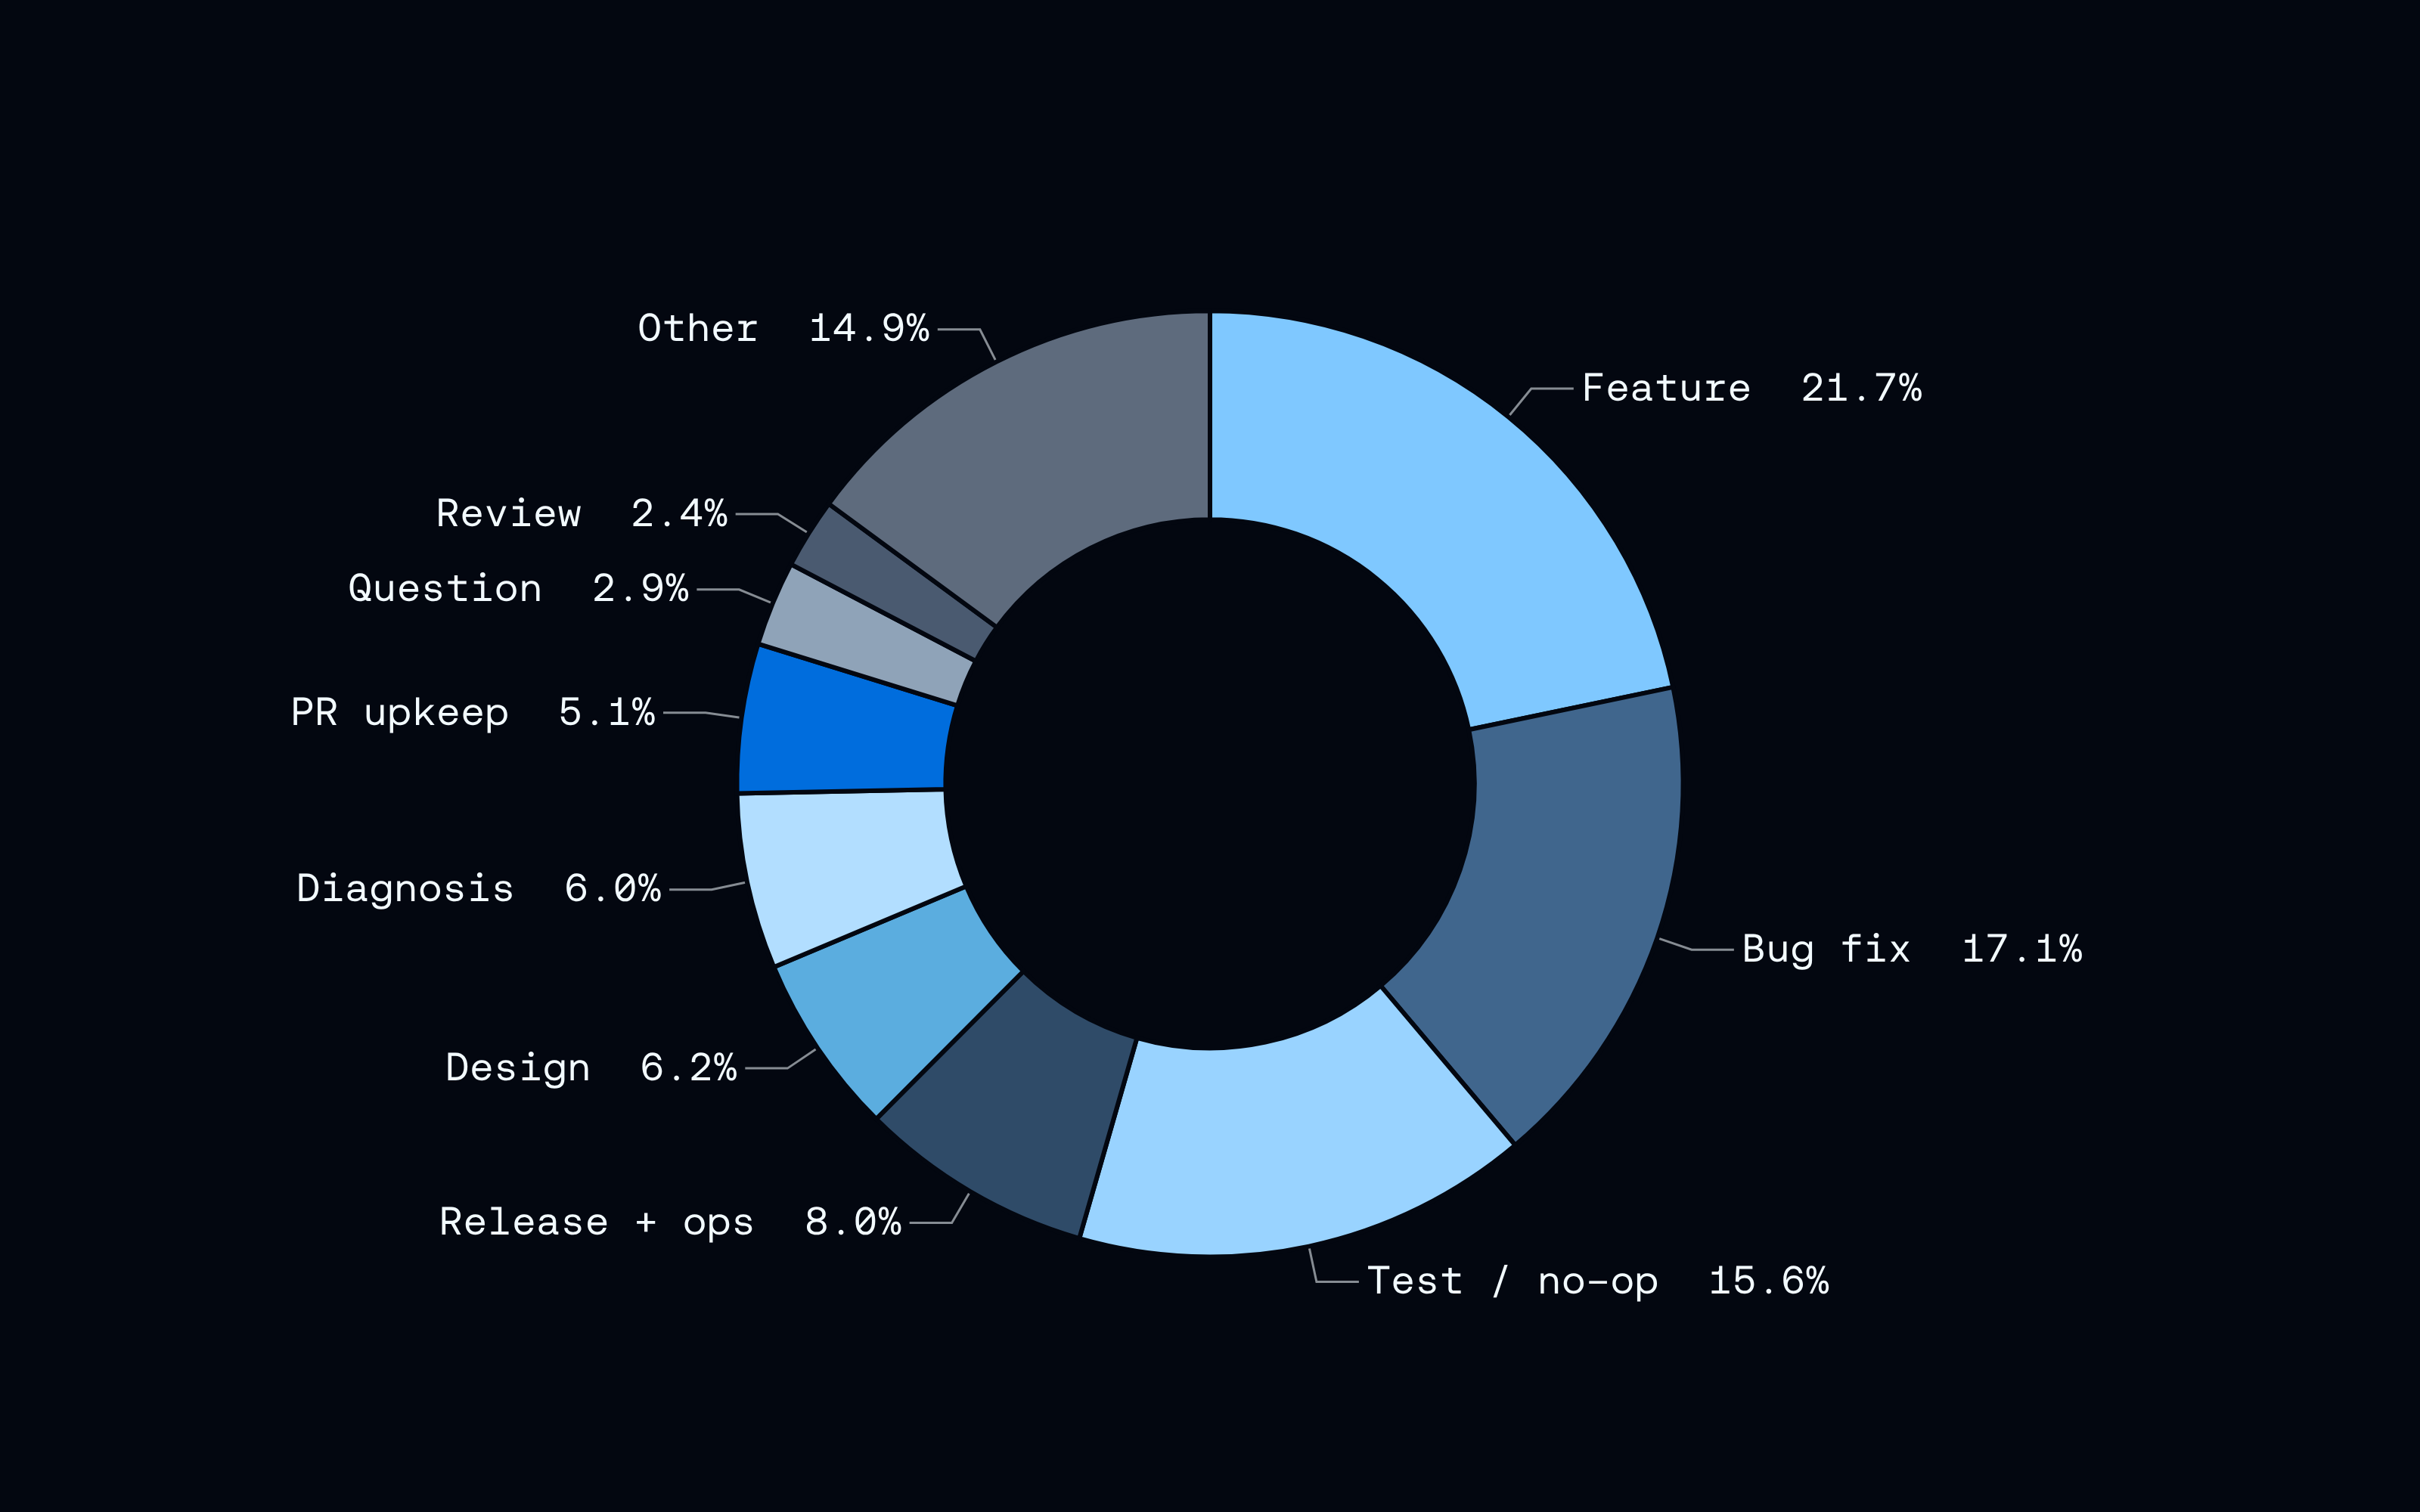
我们选取了一周的交互式线程,并使用 LLM 分类器对每个线程按任务类型进行了标注。LangSmith Insights 也可以为你完成这种跨追踪数据的分组工作。代码更改占据主导:新功能(22%)和错误修复(17%)是两个最大的组别,其次是测试或无操作运行(16%)。类别是基于每条线程的标题和元数据得出的启发式分类。
我们还调查了代理追踪特征如何根据任务类型而有所不同。我们发现,与功能工作调查相关的线程往往更长,具有更高的成本和更高的中位数轮次计数。而与测试和发布程序相关的线程往往相对较短且成本较低。
为了判断“复杂度”,我们同时使用了总成本和调用次数作为信号:成本直接反映了复杂度,因为更大的任务会使用更多的 token;而调用次数则更为微妙,因为高调用次数可能意味着更难的任务,或者意味着模型需要后续跟进才能完成任务。
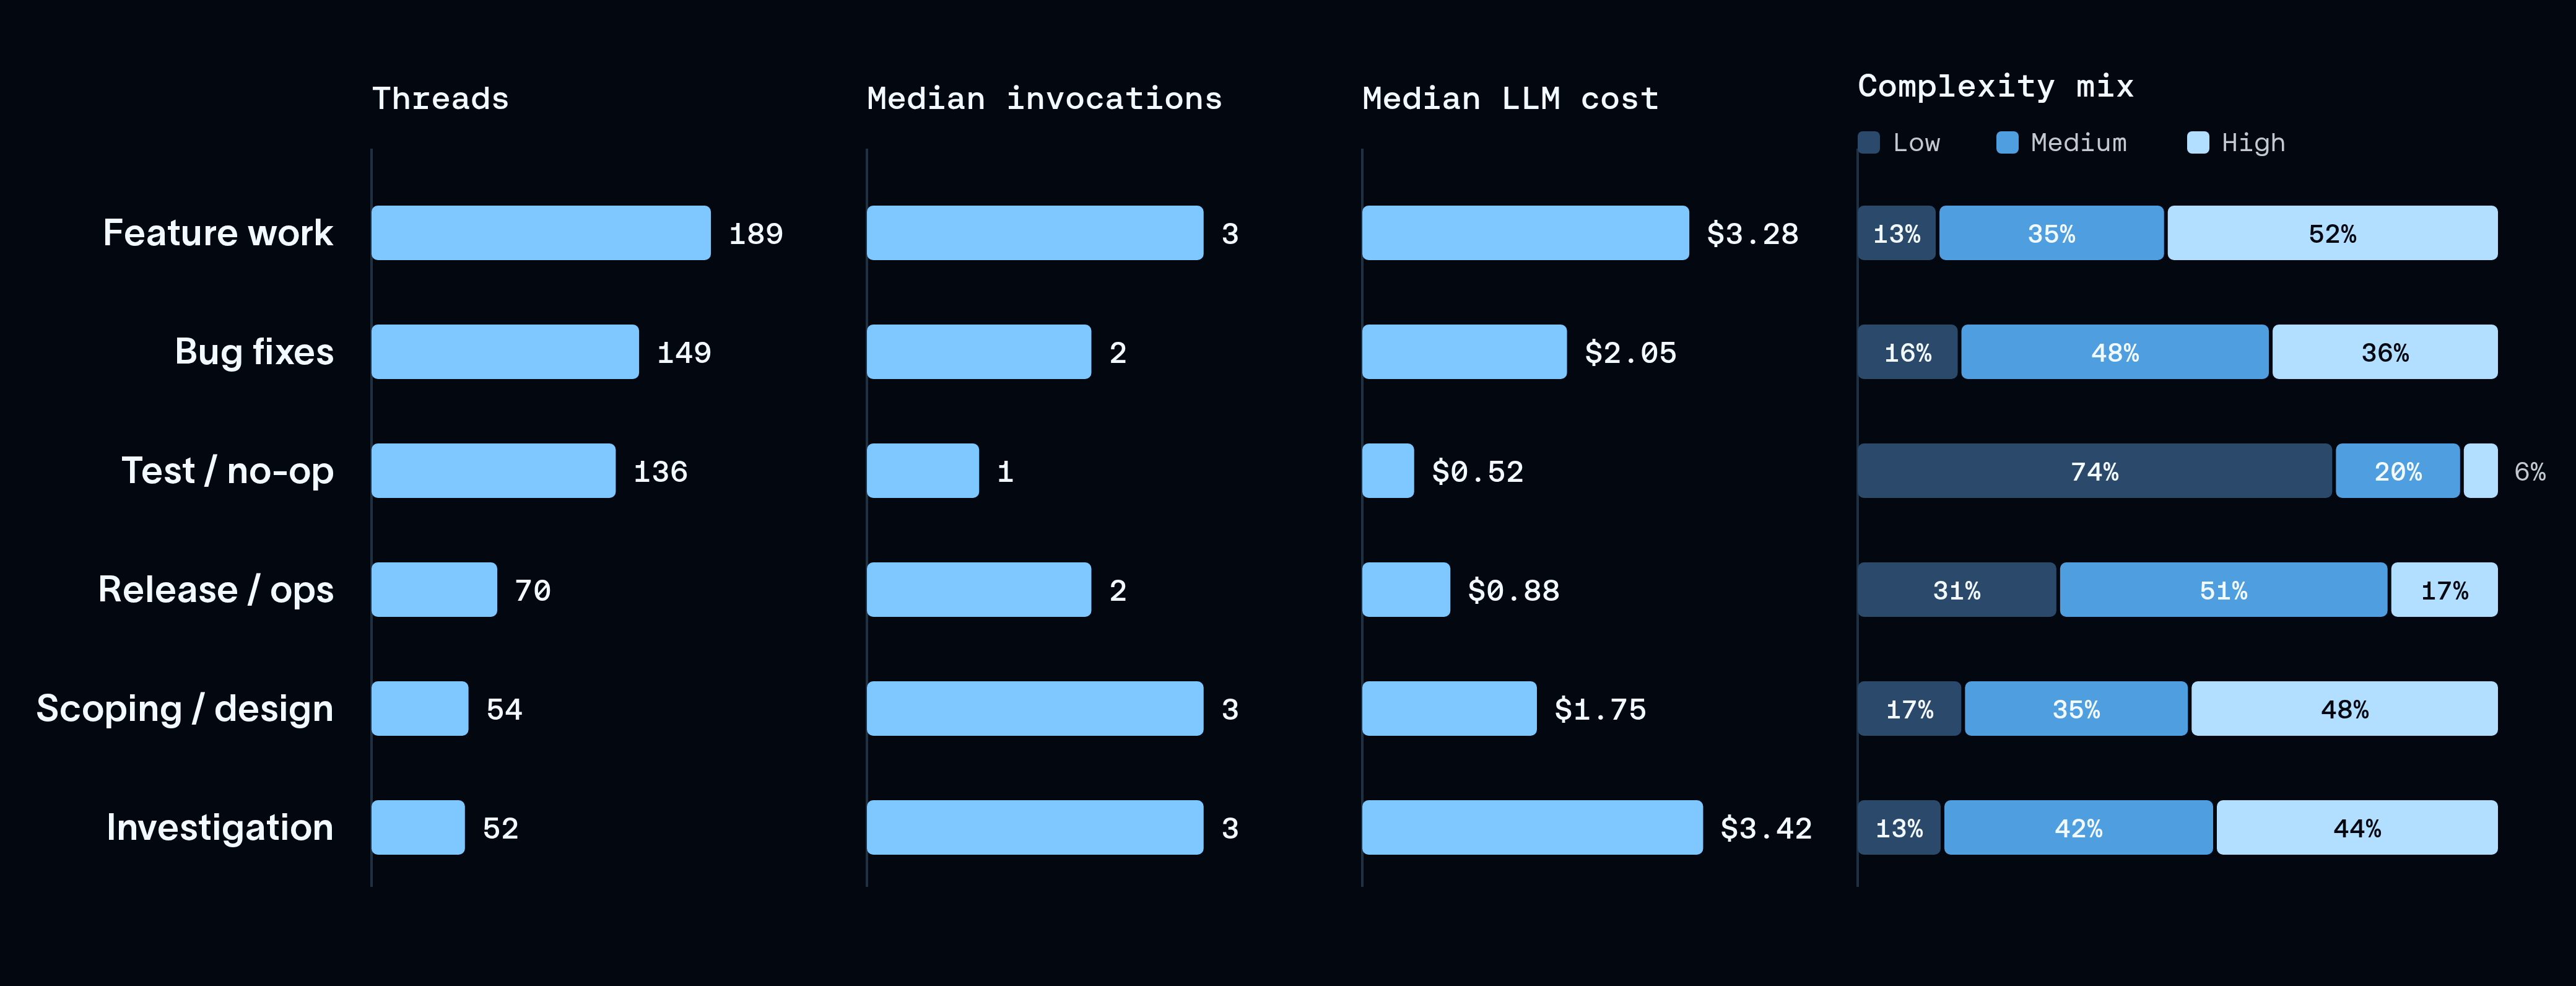
在数据收集时,所有 Open SWE 线程都通过顶级前沿模型进行路由。上述数据表明,鉴于复杂度的范围,Open SWE 处理的许多任务可能并不需要前沿智能。
任务复杂度的这种差异让我们提出了一个值得验证的假设:路由器可以根据初始请求推断任务的类型和难度,并将其发送给更便宜或更快的模型,而不会降低结果质量。
第二步:了解模型
Artificial Analysis Intelligence Index 在一组通用任务上对模型进行评分,并报告每项任务的成本,因此你可以将所有模型绘制在同一张智力与成本的曲线上。帕累托前沿(Pareto frontier)是指那些既最便宜又最聪明的模型集合。
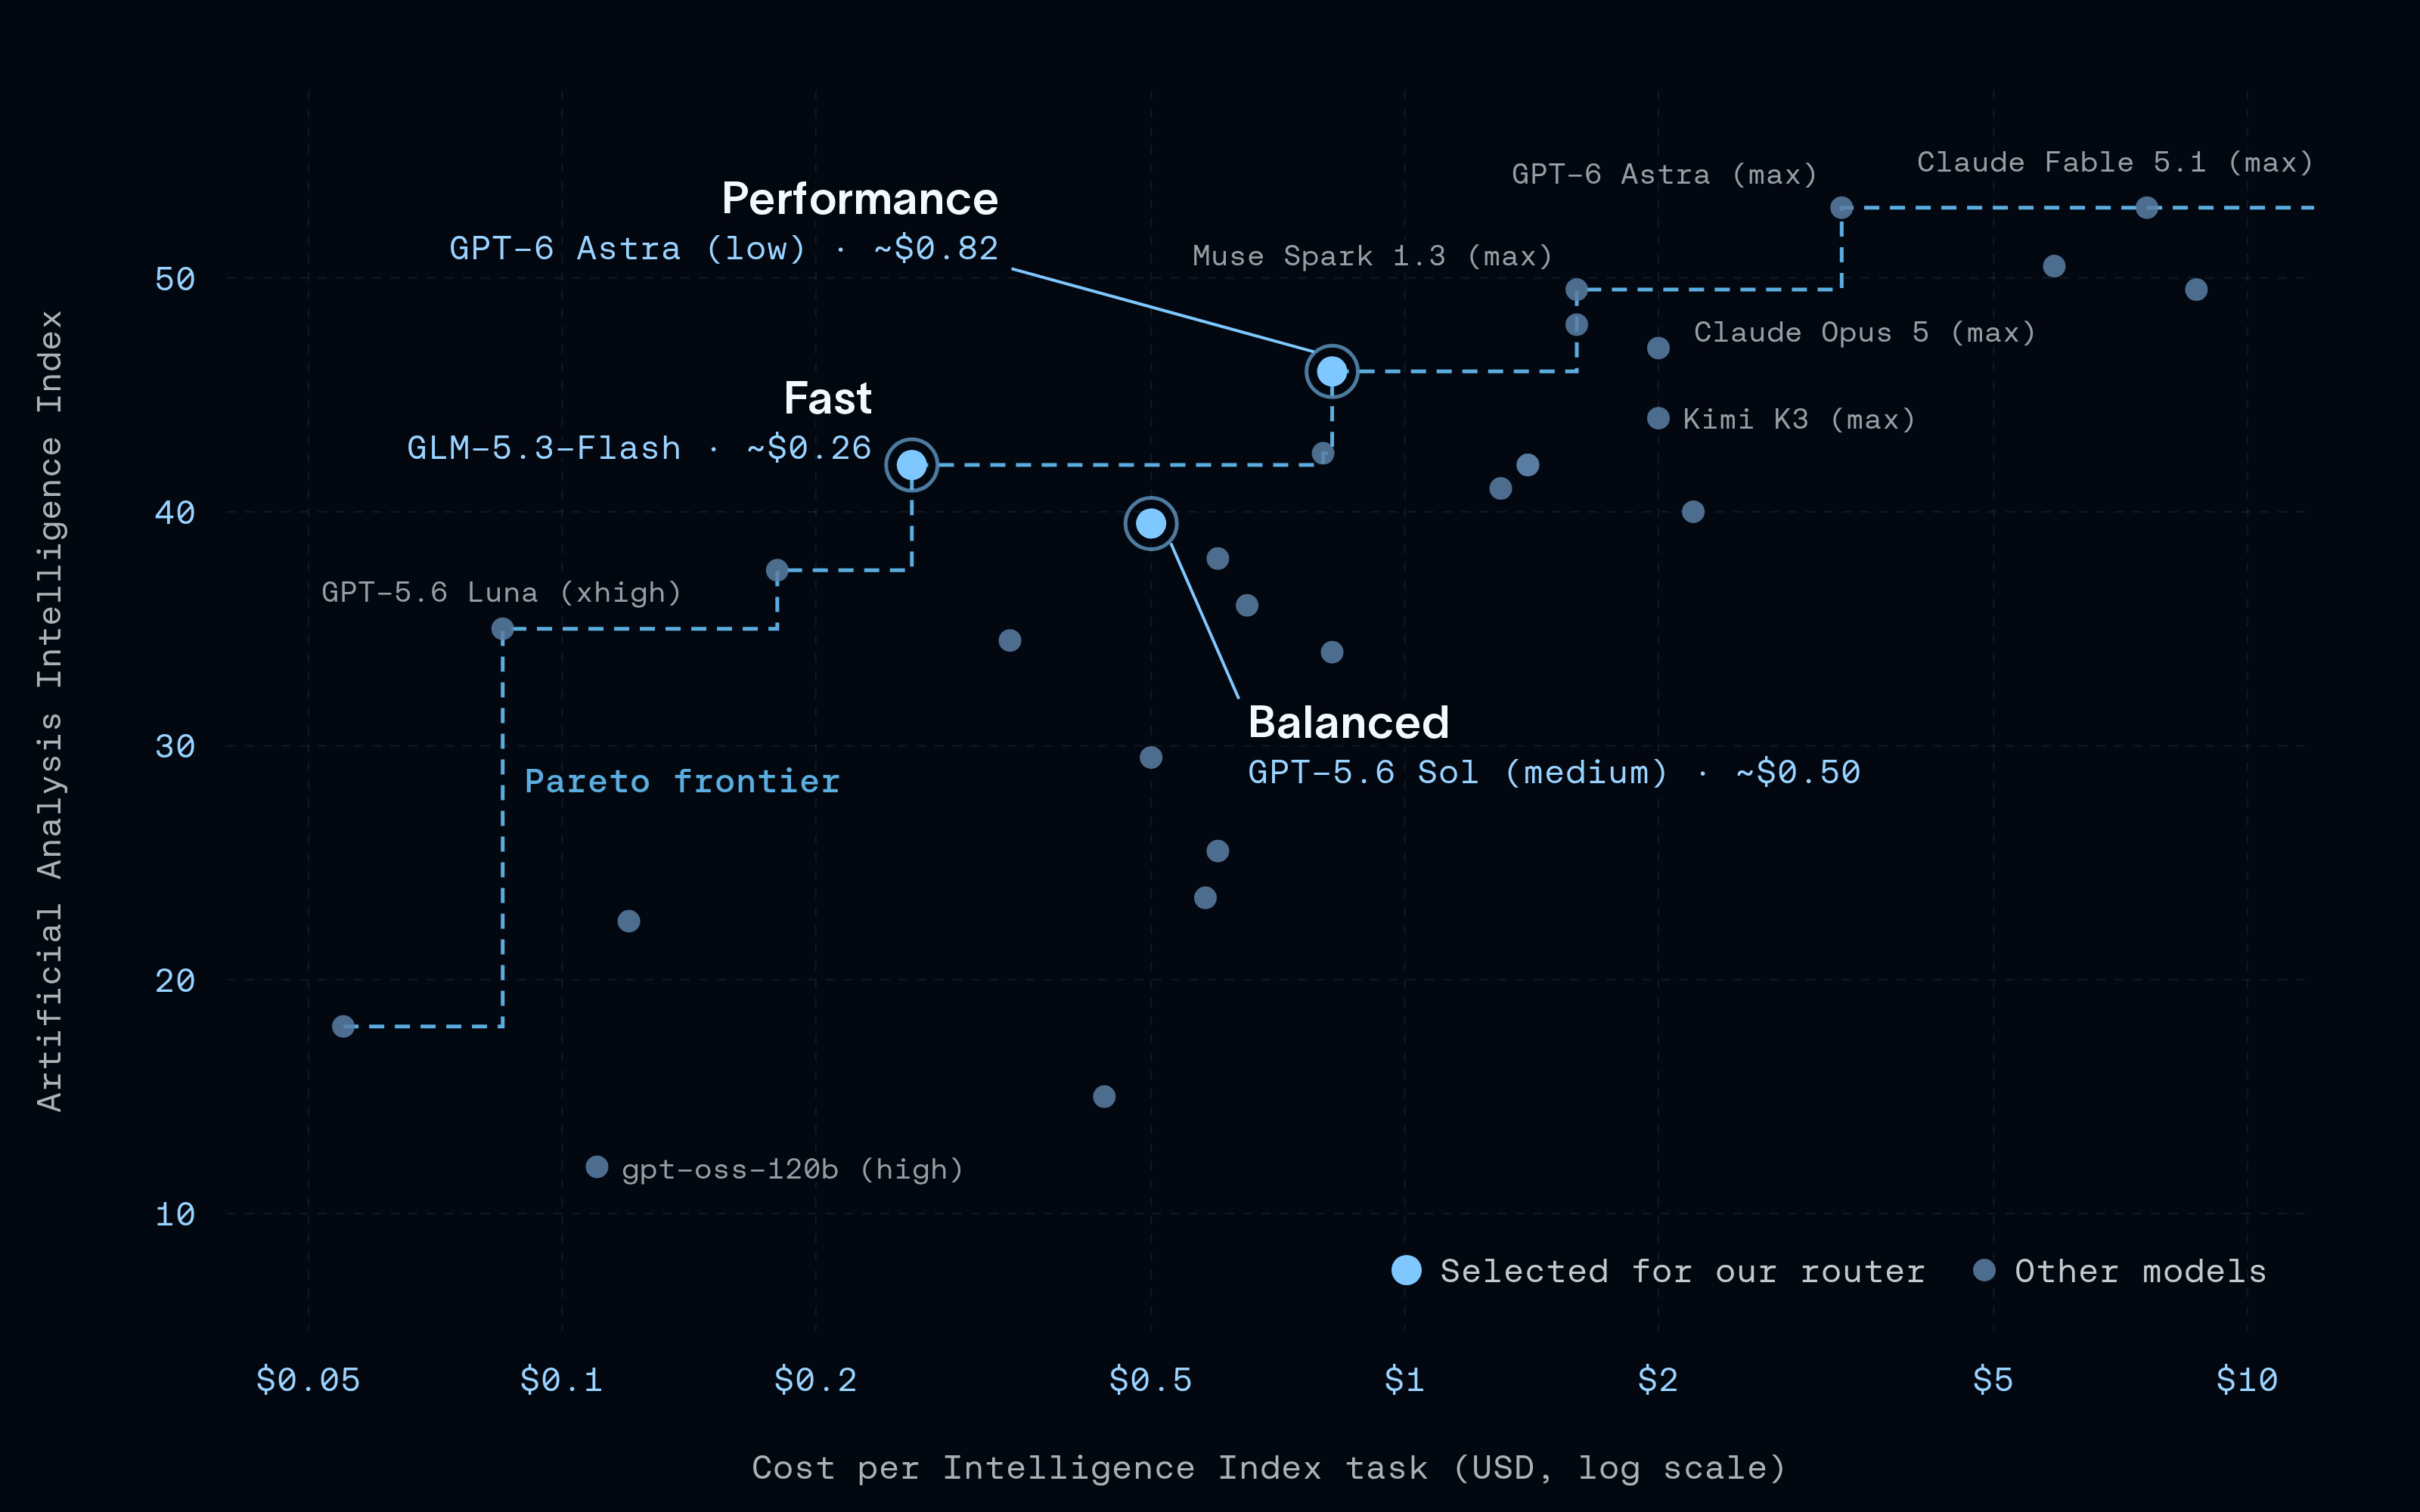
- 快速型:GLM-5.3-Flash (xhigh)
- 均衡型:GPT-5.6 Sol (medium)
- 性能型:GPT-6 Astra (low)
我们选择了来自不同提供商的模型,其中快速层是一个开源模型。GLM-5.3-Flash 位于帕累托前沿上,紧邻闭源模型,这进一步表明开源模型已经跨越了一个门槛。LangChain 是模型无关的,它提供了一个通用的模型接口,在不同提供商之间表现一致,因此当出现更好的模型时,将其替换只需对路由器进行一次一行代码的更改。
第三步:在 Harness 中构建路由器
在映射好任务组合并选定三个层级后,我们需要通过读取每个传入请求,并将其发送到能够成功处理该任务的最便宜层级,从而将任务与模型匹配。在 LangChain 中,这一决策自然地融入中间件(middleware),它可以在不改变智能体其他任何设置的情况下交换智能体调用的模型(参见动态模型选择)。
Open SWE 中的路由器在线程的第一个人类消息处运行。它包含三个部分:
- 基础提示词:告知分类器其任务——选择最有可能完成任务且成本最低的模型。
- 各层级的标准:用简短、通俗的语言描述每个层级应承担的工作。
- 分类器模型:读取请求并根据标准和提示词选择一个层级。
通用基准测试只是一个起点。你需要结合两个来源来编写每个层级的标准:你自己的任务分析,以及各提供商声称其模型擅长的领域。我们将第一步中的任务分解与 GPT-5.6 Sol、GPT-6 Astra 和 GLM-5.3-Flash 的提供商指南相结合,编写了基础提示词和各层级的标准。
这些标准是针对 Open SWE 的任务集编写的,因此路由器与 Open SWE 处理的任务紧密耦合。这就是为什么它属于 Harness 的一部分,因为 Harness 已经拥有智能体的特定任务上下文(其提示词、工具和领域知识),而通用网关则缺乏这些内容。
我们的第一个版本使用带有结构化输出的大型语言模型,并以用户请求作为提示词。现在的分类器运行在 Jev 上,这是一个新发布的决策模型,使分类速度提高了近 50 倍。请参阅“使用 Jev 构建 Harness”一文了解具体实现过程。
路由器在每个线程开始时只选择一次模型,并且该模型将用于整个线程。自然的质疑是:如果线程中途改变主题或复杂度怎么办?虽然这个朴素的路由器设计未解决此问题,但我们在下文的“下一步”部分中涵盖了飞行中路由(mid-flight routing)的内容。
第四步:跟踪任务结果
路由器的价值在于降低成本,但前提是质量不下降。路由器必须做好两件事:所选模型需要能够完成任务,并且它应该是能够完成任务的最便宜、最快的模型。这意味着你需要一种跟踪任务结果的方法。有两种方法可以实现这一点:
- 离线评估(Offline evals)将路由器针对固定数据集运行,这样你可以安全地比较不同版本并确保可重复性。难点在于数据集:它必须看起来像你的真实流量,并根据用户关心的内容进行评分。对于编码智能体来说,这意味着 PR 质量和可审查性,而这些很难在离线状态下进行评分。
- A/B 测试将实时线程在路由器和单模型基线之间进行分割,并根据你能对每个线程衡量的成功指标进行比较。实时流量自然是一个具有代表性的数据集,但缺点在于用户可能会受到非最优路由器的影响。
- 已合并的 PR:Open SWE 现在会记录它打开的每一个 PR,以及该 PR 是已合并还是已关闭。每个线程中已合并的 PR 数量成为了我们的主要成功指标。
- 用户反馈:我们在 Open SWE 中添加了点赞和点踩功能,以便用户可以对任何线程进行评分,包括那些从未产生 PR 的提问。每次评分都会作为对该线程 LangSmith 追踪记录的反馈被记录下来。
我们在 LangSmith Custom App 中跟踪了这两项数据。已合并的 PR 提供了更强的信号。反馈较为稀疏,因为只有少数线程获得了评分,但正是在这里我们听到了关于路由错误的反馈,如下面第一个测试中所引用的例子。
实验
我们的第一次 A/B 测试将路由器与始终使用最强模型的情况进行了对比:在总共 973 个线程中,一半的线程经过路由器处理,另一半则始终使用 GPT-6 Astra。
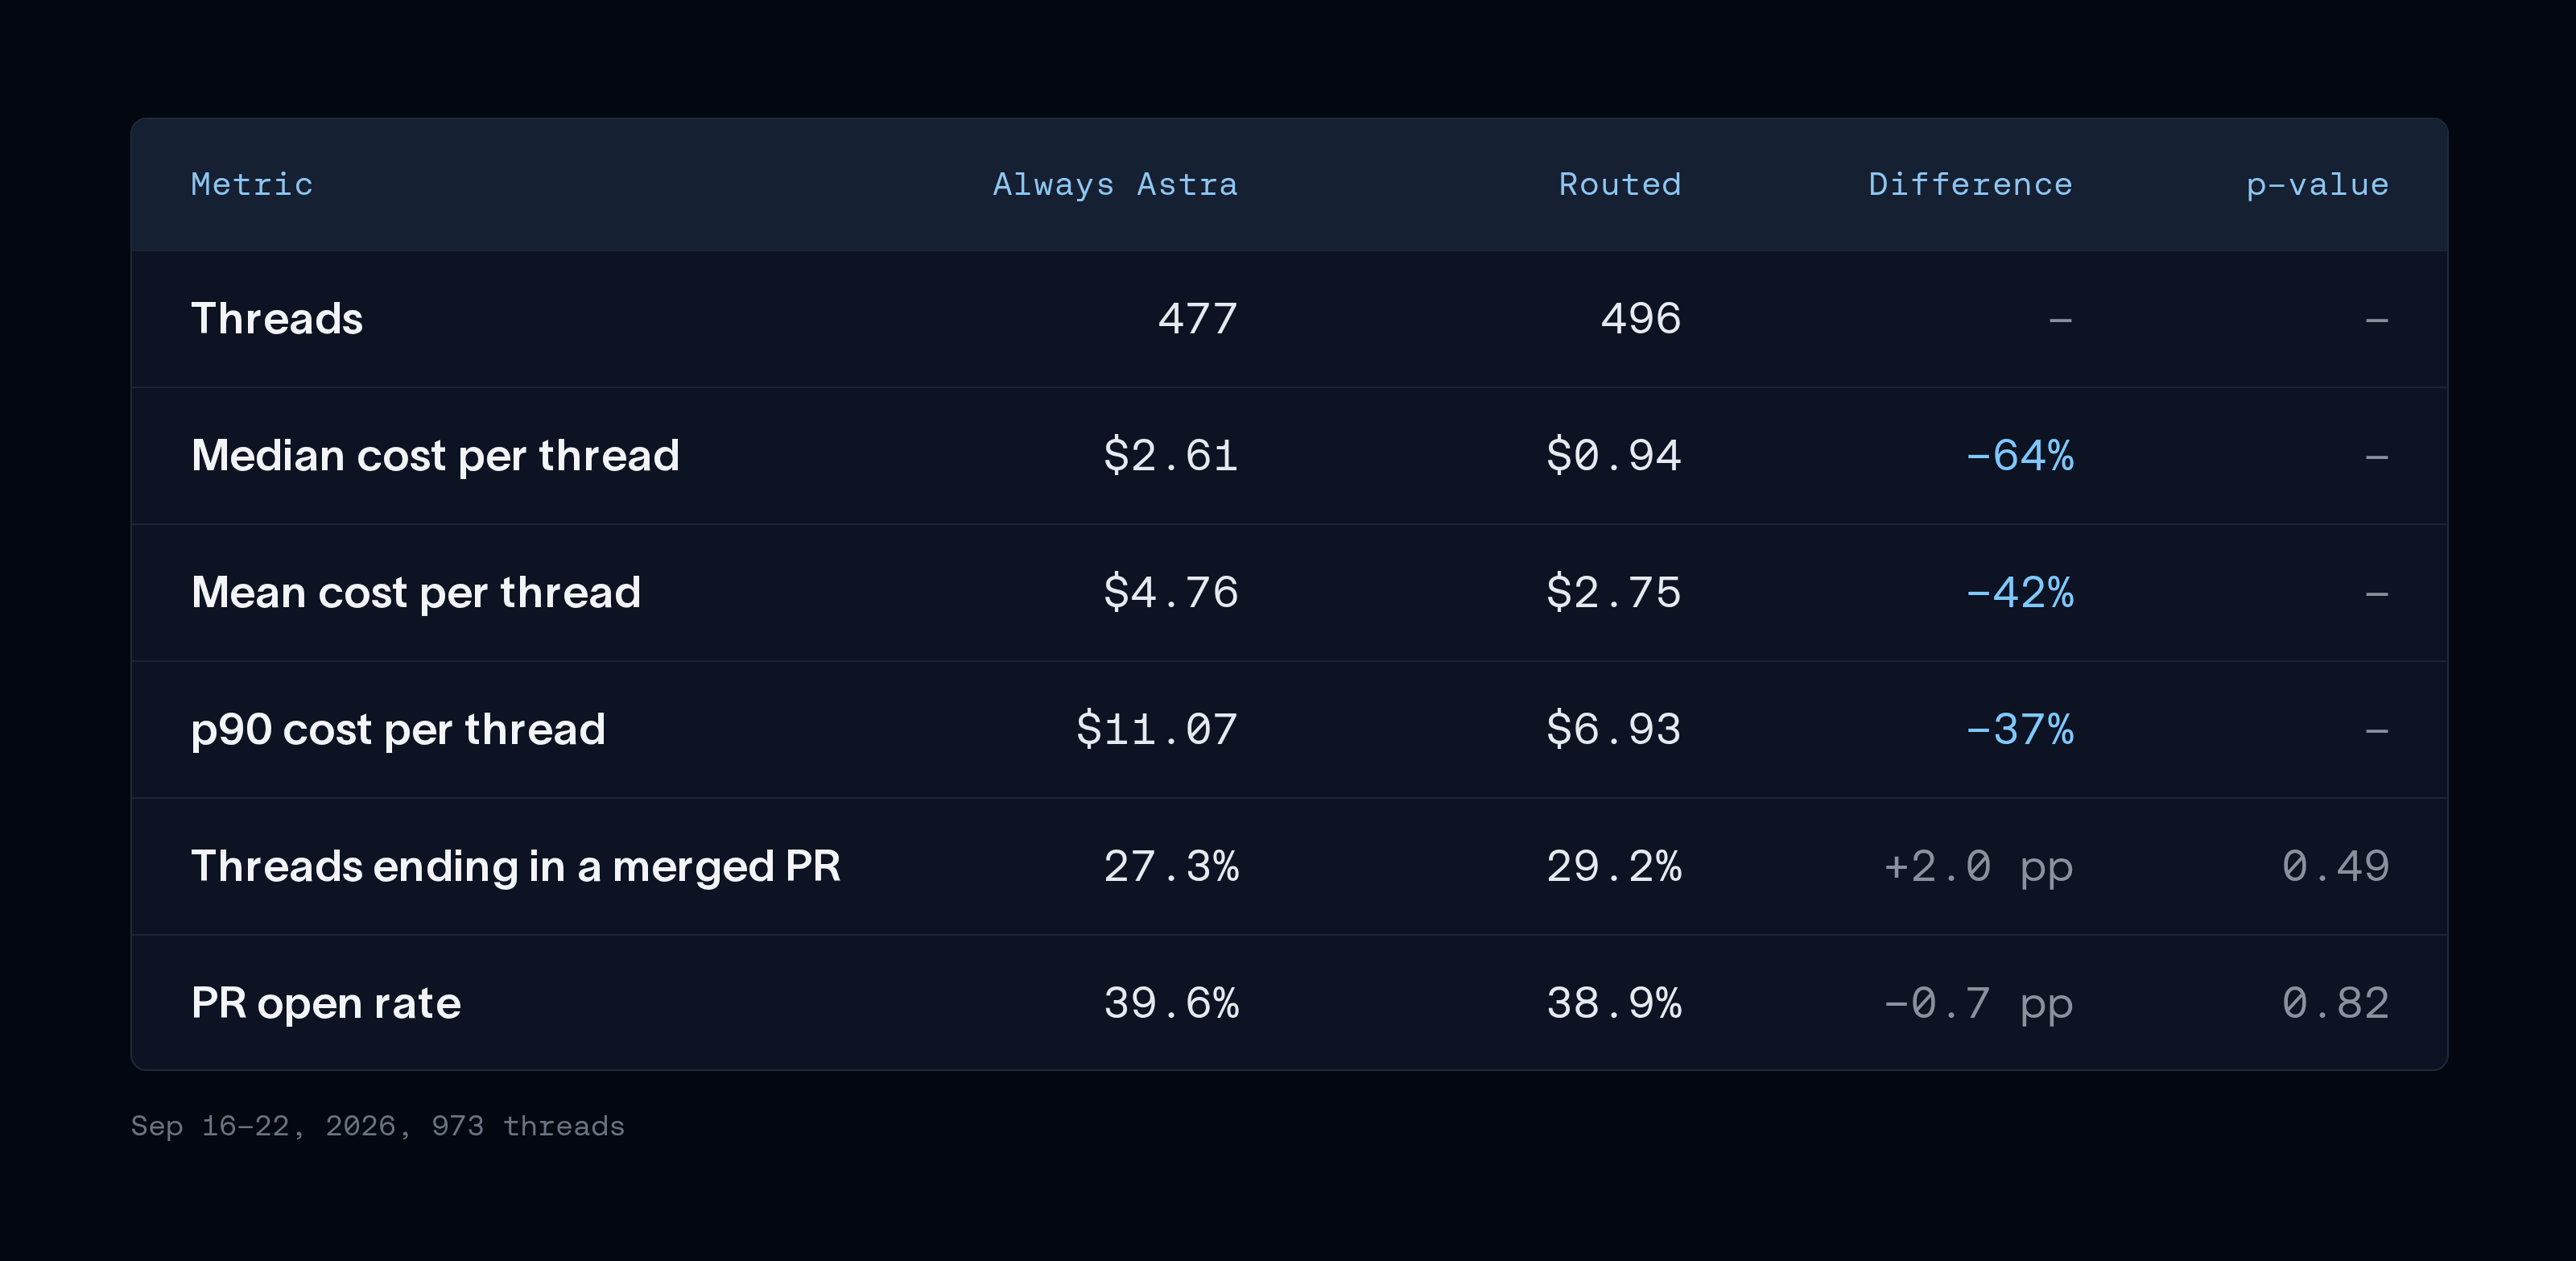
质量没有发生可测量的变化。29.2% 的路由线程最终以合并的 PR 结束,而对照组为 27.3%(p = 0.49)。PR 的开启率也持平(38.9% vs. 39.6%,p = 0.82)。
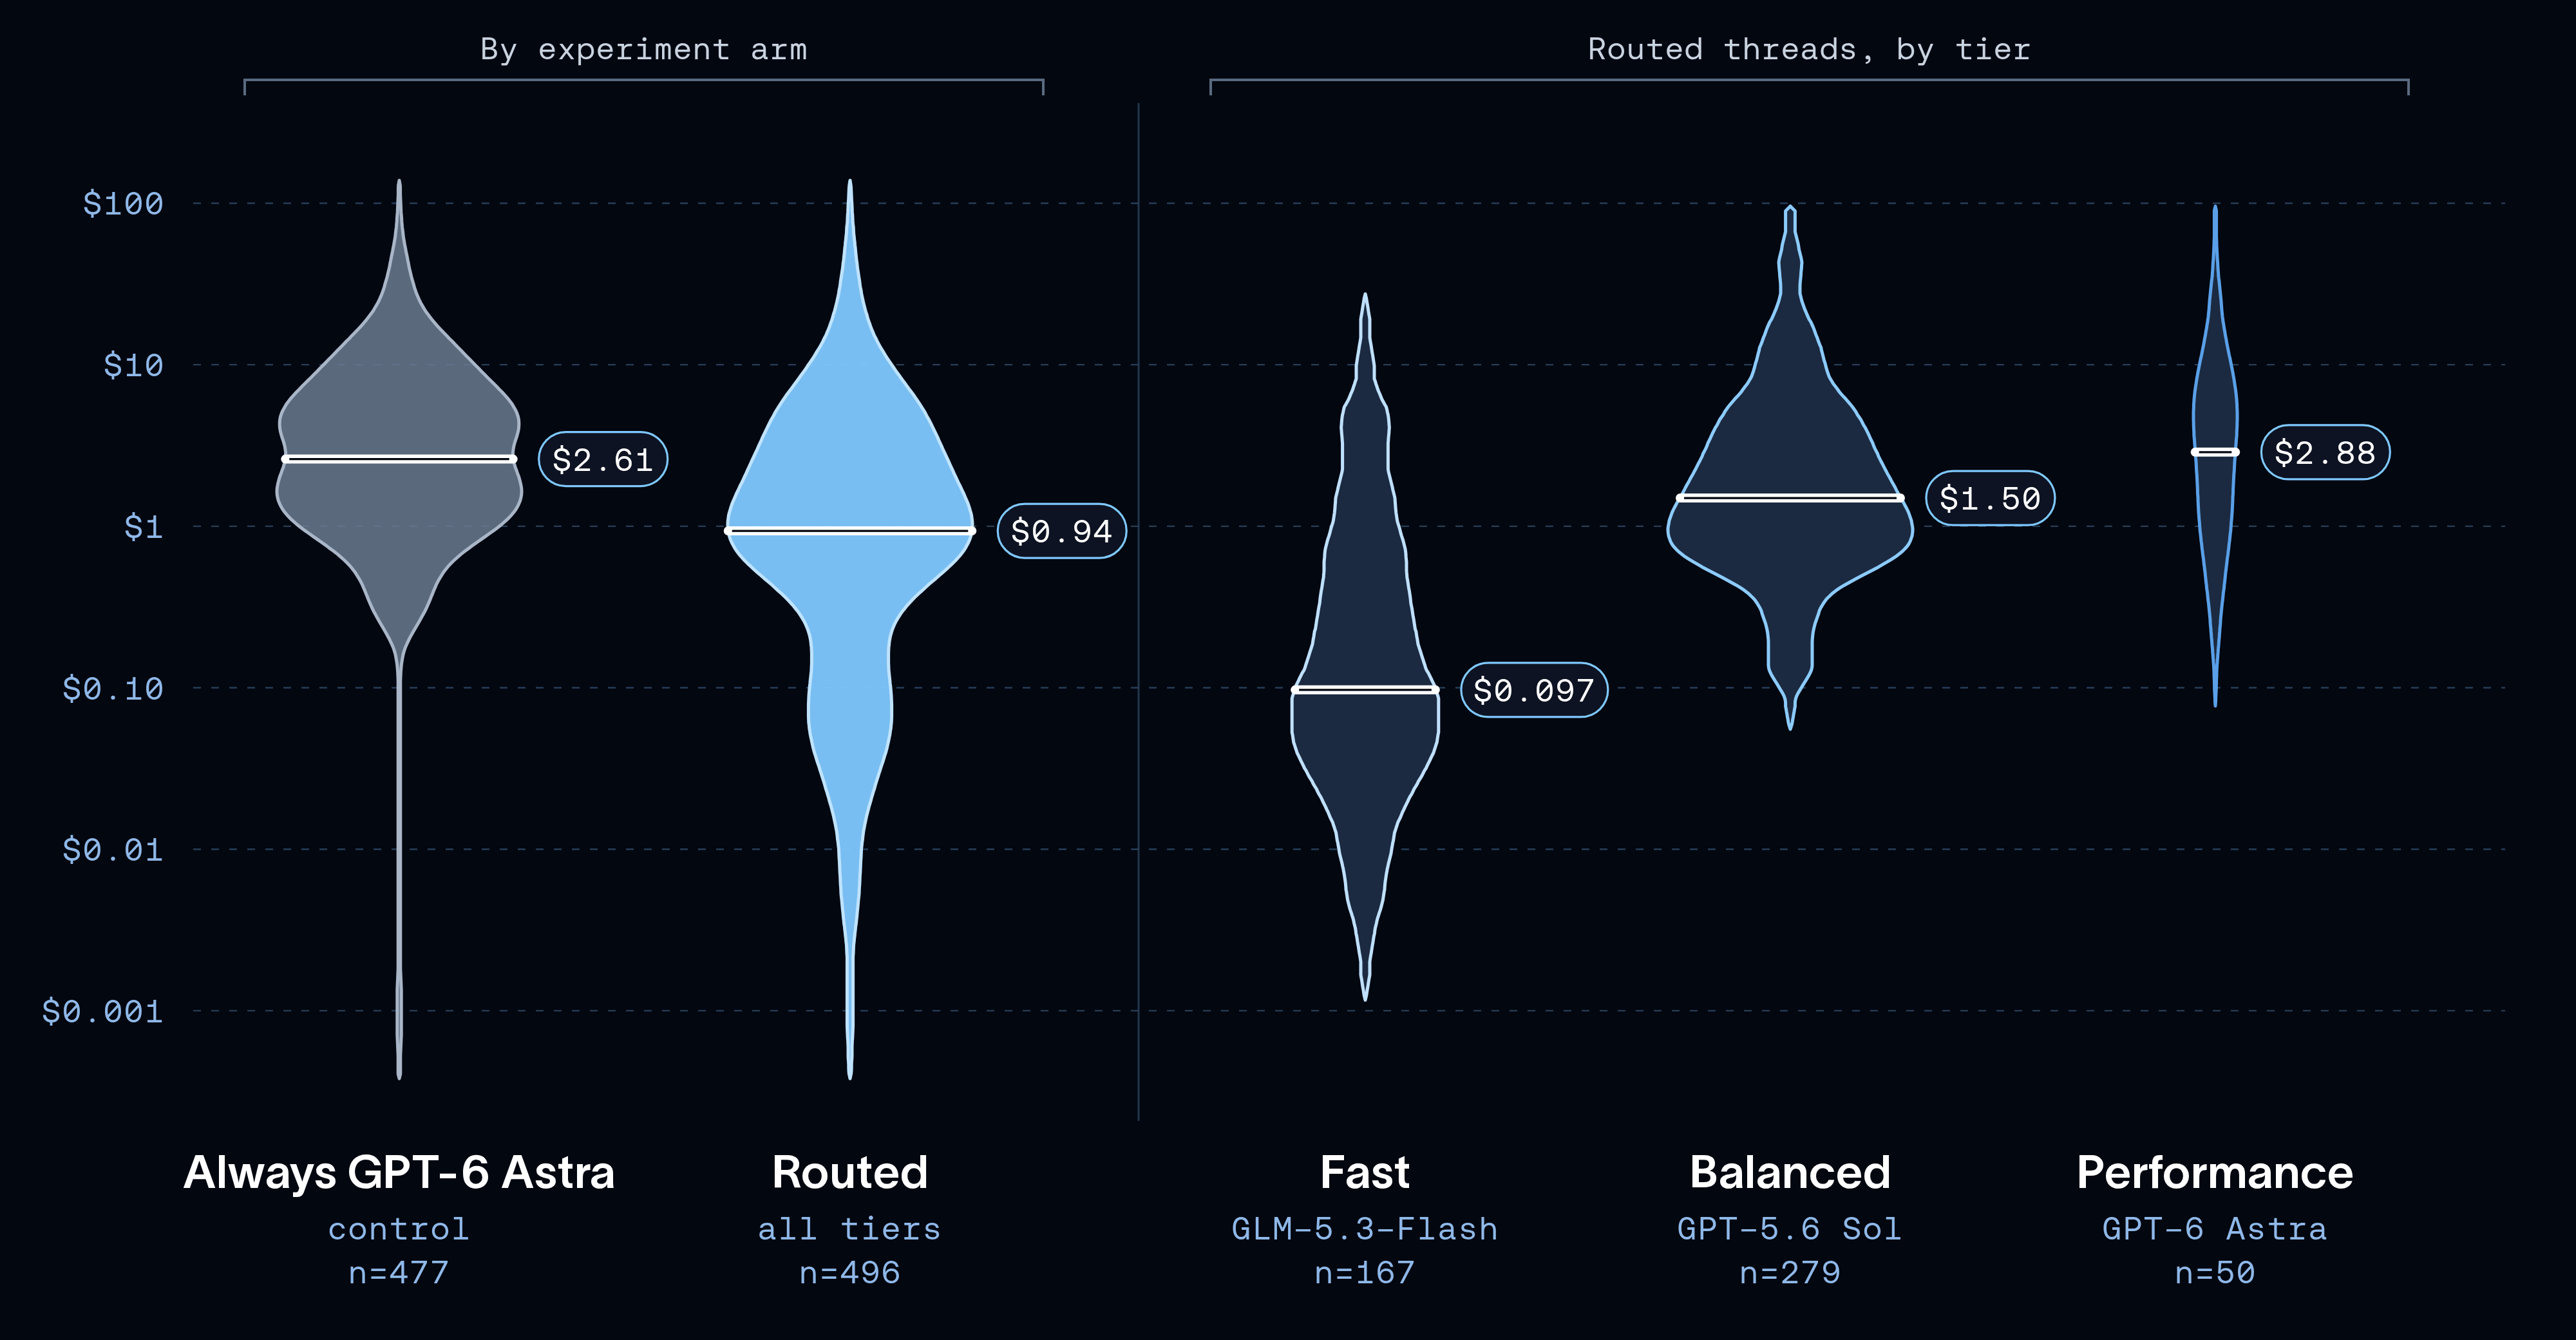
成本大幅下降。中位数显示,经过路由处理的线程成本为 0.94 美元,而对照组为 2.61 美元,降低了 64%。平均值下降了 42%,第 90 百分位值下降了 37%,这表明节省并非仅来自少数低成本异常值。
大多数请求并不需要最强的模型。在路由处理的线程中,56% 分配给了平衡型模型,34% 分配给了快速型模型,仅有 10% 分配给了性能型模型。各层级之间的成本阶梯陡峭:快速型线程的中位数为 0.097 美元,平衡型为 1.50 美元,性能型为 2.88 美元,跨度达 30 倍。
用户反馈也指向了同一方向。当简单请求在 GPT-6 Astra 上运行时,工程师们直接通过评论指出了过度支出问题,例如:“这个查询的成本相当高”以及“此请求不应被路由到性能模型。”
💡 鉴于对照组使用的是我们最昂贵的模型,这一结果并不令人意外。但这是一种许多智能体都能受益的改变:许多智能体在质量上过度倾斜,最终导致支出过高。特别是对于任务集多样的智能体,路由可以有效降低成本。
我们还测试了路由器与另一种对照情况的对比:一半的线程经过路由器处理,另一半始终使用快速型模型。我们在一天内结束了这项测试,因为它尚未产生具有统计意义的结果。工程师几乎立即指出了仅使用快速型模型的问题,由于输出质量低,这严重影响了他们的工作效率。
下一步
这种模型路由器的实现是一个概念验证,可作为构建最优路由器的基础。以下是我们可以探索以改进的几个领域:
- 在 DeepSWE 或其他编码基准上对路由器进行基准测试,以便我们能够针对受控基线评估路由决策,而不是仅依赖生产流量的 A/B 测试。
- 子代理的模型选择。目前,子代理独立于路由器选择其模型。如果也将子代理纳入路由范围,特别是在运行时间较长的任务上,可以进一步降低成本。
- 线程中途重新路由。当新消息与之前的消息差异足够大时(例如一个问题转变为 bug 修复),更换模型可能会带来收益。成本在于提示缓存:切换模型会使其失效,因此新模型需要以全价重新读取整个线程。对于异步智能体而言,这种成本通常可以忽略不计,因为当 TTL 较短(如 5 分钟)时,缓存往往会在人类交互间隔期间过期。
- 通过更多信号细化路由标准,例如挖掘追踪记录中的用户情绪:找出用户感到沮丧的线程,这可能意味着任务需要更强的模型。
入门指南
- 理解任务。你的追踪记录保存了代理被要求执行操作的真实记录,LangSmith Insights 帮助你从中发现模式,以便你在选择层级之前就能看清任务的混合情况。
- 理解模型。沿着成本-智能曲线挑选几款模型,参考现代基准测试的结果。LangChain 的模型接口跨提供商兼容,因此你可以随时更换模型,而无需重新构建你的应用程序。
- 在框架中构建路由器。将路由视为上下文工程,类似于传统的特征工程:决定路由器应看到哪些信息,以便根据你的代理领域做出关于模型适配的最佳决策。
- 跟踪任务结果。在路由之前建立成功指标:评估、在线评估器或基于追踪的用户反馈。如果构建评估数据集的成本过高或过于困难,对实时流量进行 A/B 测试效果良好。
适合某项任务的合适模型会随着新模型(包括开源权重的模型)不断涌现至前沿而持续变化。由于 LangChain 是模型无关的,利用这些提升意味着只需更换一个层级,而无需重建你的代理。
要将路由功能添加到你自己的代理中,你可以添加我们新发布的模型路由中间件。提供你的基础提示词、模型层级以及每个层级的标准,它会在每个线程开始时选择一个模型。欢迎你在 X 或 LangChain GitHub 问题上提供反馈。
进一步阅读
- Open SWE on GitHub
- Building a Harness with Jev
- Model routing middleware docs
- LangSmith Observability docs
- LangSmith Evaluation docs
- LangSmith Custom Apps
- Log user feedback in LangSmith
- Artificial Analysis Intelligence Index
致谢
感谢 Mason Daugherty、Kevin Frank 和 Harrison Chase 对本帖提出的深思熟虑的反馈。同时也感谢支持此次实验的 OpenSWE 团队!
查看你的代理真正在执行的操作
LangSmith 是我们的代理工程平台,帮助开发者调试每一个代理决策、评估变更,并一键部署。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。