精选SemiAnalysis短讯
Intel Panther Lake 拆解:深入 Intel 18A 工艺与架构
SemiAnalysis 发布 Intel Panther Lake 处理器及 Intel 18A 制程工艺的免费深度拆解报告,详细分析了芯片内部结构与制造技术细节。
深入英特尔最新消费级芯片及 18A 工艺节点内部
Panther Lake 首次商用实现了背面供电(BSPDN),引入了英特尔第一代全环绕栅极(GAA)晶体管,并通过其 Foveros-S 封装技术展示了先进的封装能力。随着 Panther Lake 的推出,英特尔的制造轨迹已从模糊的路线图转变为实际出货的硅片,这是其在重返具有竞争力的半导体制造领域的漫长道路上的一座重要里程碑。为了评估英特尔复兴的程度,我们对 Panther Lake 进行了拆解。

SemiAnalysis STEEL 拆解实验室专注于拆解先进数据中心和 AI 硬件。如需了解我们的项目流程或委托进行拆解,请联系 sales@semianalysis.com。
我们正在招聘:架构、布局图、封装、制造和实验室专家。机会涵盖从系统到晶体管以及其间的所有领域。请查看我们的招聘页面。
我们的拆解追踪了 18A 工艺,从其四片式 RibbonFETs(英特尔对 GAAFETs 的营销名称)和栅极堆叠开始,经过接触孔、正面和背面布线,直至键合载体。我们解释了这些材料和集成选择如何改善栅极控制并降低电阻,同时增加了电容、热阻和工艺复杂性。我们的测量数据显示,Panther Lake 的 18A 计算逻辑与台积电 N3E GPU 逻辑在逻辑密度上处于相似水平。然而,18A 在峰值密度方面并未领先于台积电 N3P、N2 或三星 SF2。Panther Lake 的 CPU 核心是增量更新,而高端 GPU 仍使用台积电 N3E。
Panther Lake 采用英特尔的 Foveros-S 先进封装技术,在一个无源基座晶圆之上组装了一个计算晶粒、一个 GPU 晶粒和一个 I/O 晶粒。两种计算晶粒变体均使用英特尔 18A。Xe3 GPU 选项包括基于英特尔 3 工艺的 4 核 GT1 晶粒和基于台积电 N3E 工艺的更大规模的 12 核 GT2 晶粒。两种 I/O 晶粒变体均使用台积电 N6。[1], [2]
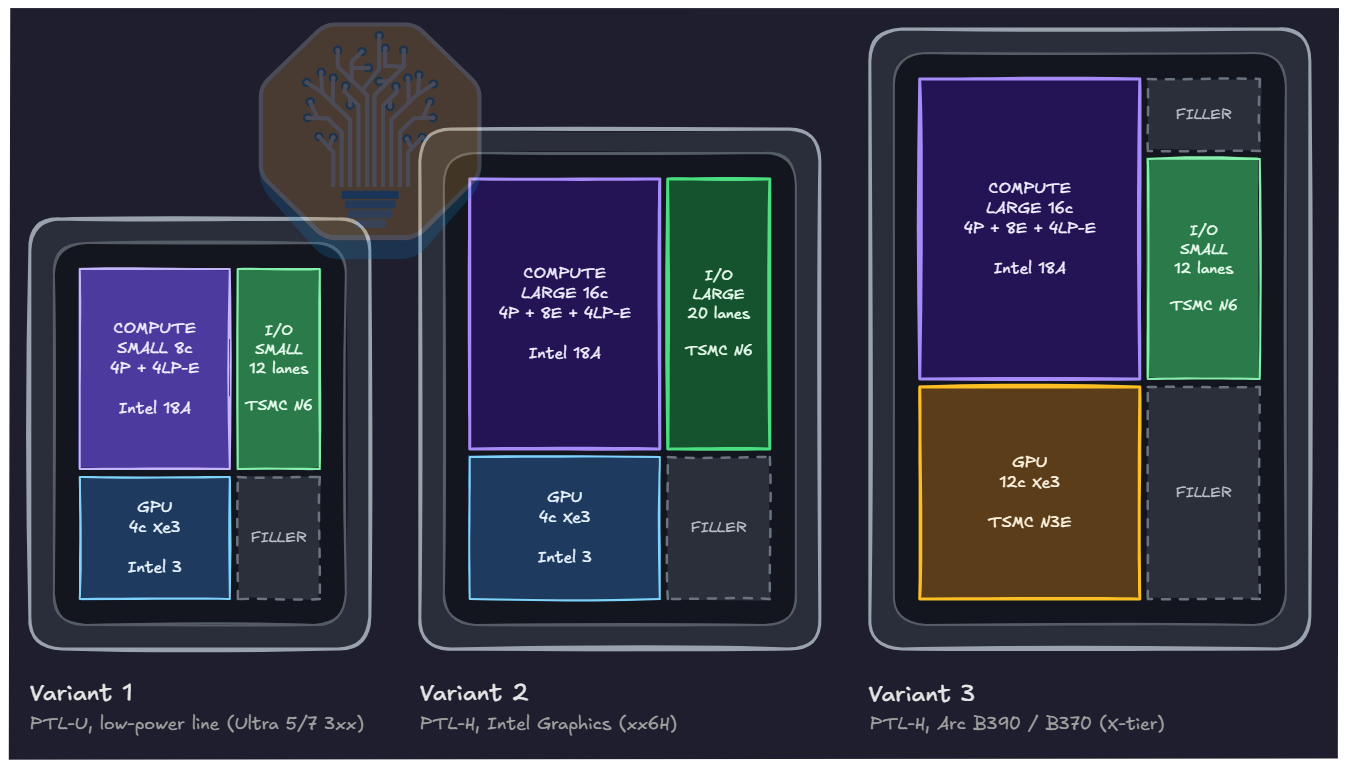
我们的分析集中在 PTL-U 计算晶粒、两种 GPU 晶粒(4 核和 12 核)以及 12 通道 I/O 晶粒上。
在传统芯片中,电源和信号通过相同的正面金属堆栈路由至器件前端。电源轨消耗了晶体管附近稀缺的路由资源,而高大的通孔堆栈则从上层的粗导线将 VDD 和 VSS 传输至局部电源轨。背面供电(BSPD)将主电源网络移至晶体管层后面的背面,将其与正面信号路由分离开来。我们在 2024 年曾讨论过 BSPD 及其影响。[3], [4], [5] 英特尔的 BSPD 实现品牌名为“PowerVia”,它通过专用的背面金属将电力路由至纳米 TSV,这些纳米 TSV 将这些电源轨连接至局部的源/漏(S/D)接触孔。
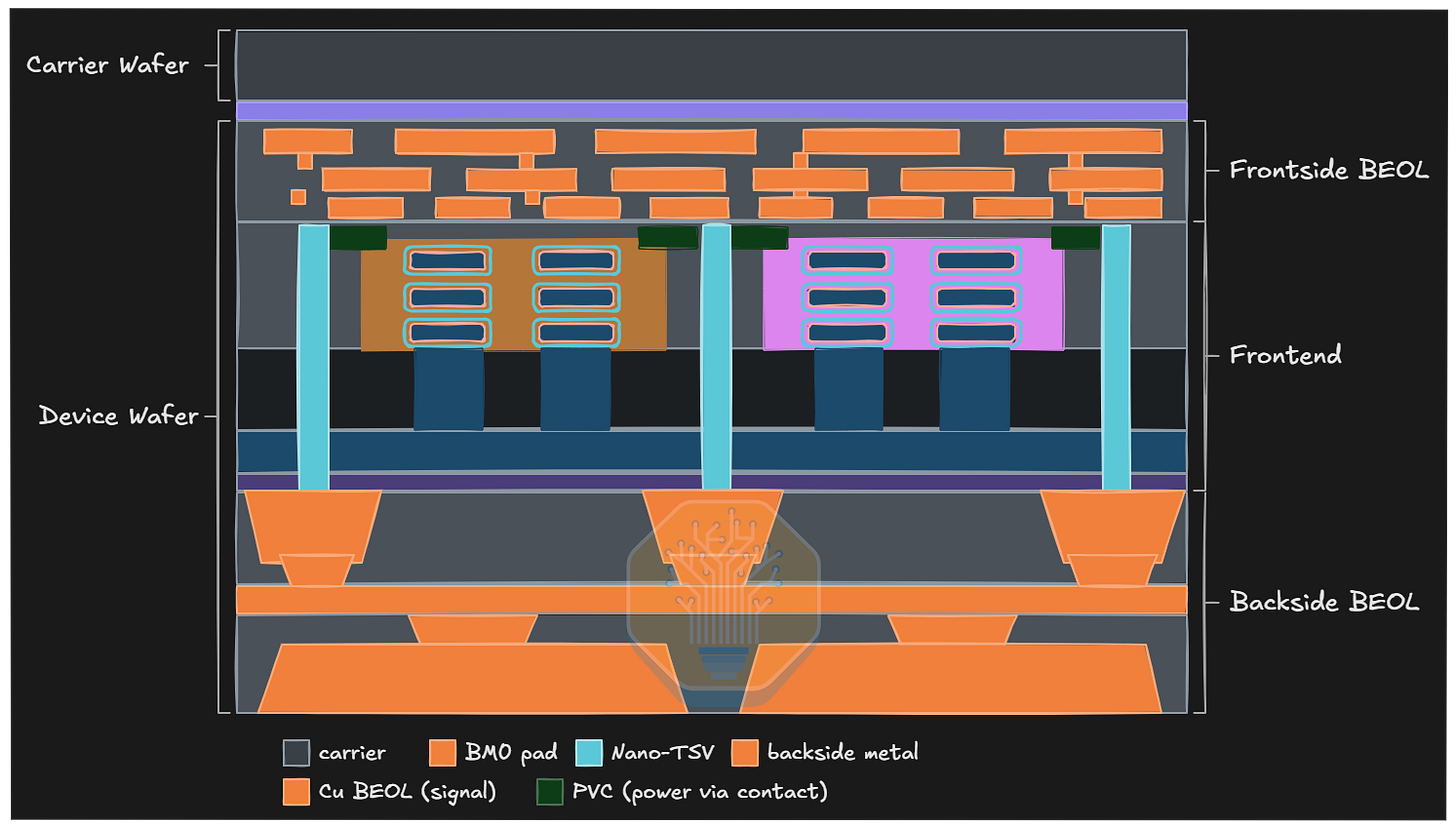
实现这种分离要求英特尔从晶圆的两侧构建互连堆栈。正面包括 M0-M14 信号堆栈,而背面包括 BM0-BM5 电源堆栈。M0 和 BM0 最靠近晶体管。

纳米 TSV 连接两侧,但英特尔在形成接触孔后,从正面图案化和蚀刻每个通孔。一个狭窄的通孔从接触孔侧面深入硅衬底内部。随后,英特尔完成正面信号金属堆栈,将晶圆键合到载体上,翻转晶圆并去除原始衬底,直到埋藏通孔尖端暴露出来。然后直接在暴露的通孔上沉积背面金属堆栈。
由于英特尔从晶圆相反的一侧形成它们,纳米 TSV 和背面通孔的轮廓呈相反的锥形。晶体管结构形成 FEOL(前道工艺)。局部接触孔和纳米 TSV 将它们与布线连接起来。M0 开始了正面互连堆栈。
硅载体仍然附着在正面互连件上方。它在衬底去除和背面处理期间支撑器件晶圆,并成为成品芯片热路径的一部分。
PowerVia 将主要的电源分配从拥挤的前侧金属层中移除,通过更短更宽的后侧导线进行供电。其横向接合点仍占用标准单元内的面积,因此相比直接后侧接触,它回收的单元面积较少。[3] 逻辑器件旁边的纳米通孔(Nano-TSV)通过后侧电源网络传输 VDD 或 VSS,而信号连接则继续通过前侧金属层向上延伸。
后侧互连
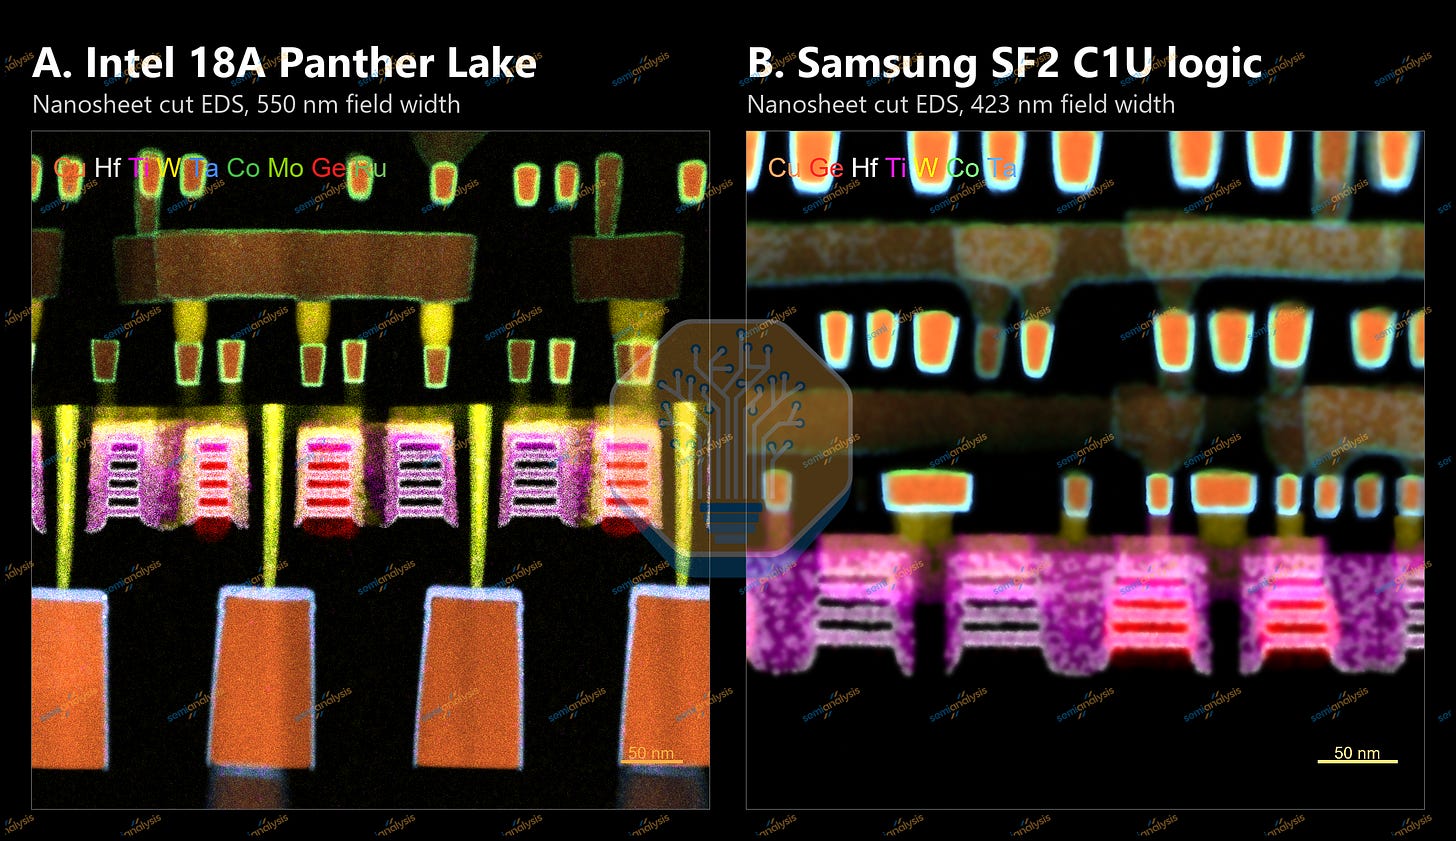
本文中包含三星 SF2 的数据,以便与 Panther Lake 进行比较。SF2 是目前主流的 GAA 代工节点,但缺乏 BSPD(背面电源分布),作为评估 18A 的一个有用参考。关于在 SF2 上制造的三星 S26 产品的完整拆解报告即将发布。纳米片切割的 EDS 比较。
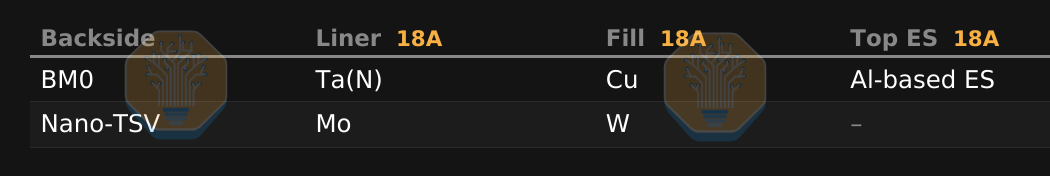
PowerVia 供电路径从后侧铜轨出发,穿过钼衬里的钨纳米通孔到达局部晶体管接触点。在此横截面中,锥形连接从接触层延伸到 BM0,跨度约为 150 纳米。钽(Ta)衬里限制铜扩散并促进其与周围堆层的粘附;氧化铝(AlOₓ)刻蚀停止层控制导轨上方下一层介质的刻蚀。带状物下方的电介质在电气上将器件与后侧布线隔离开来,并去除沟道下方的导电硅体。[6]
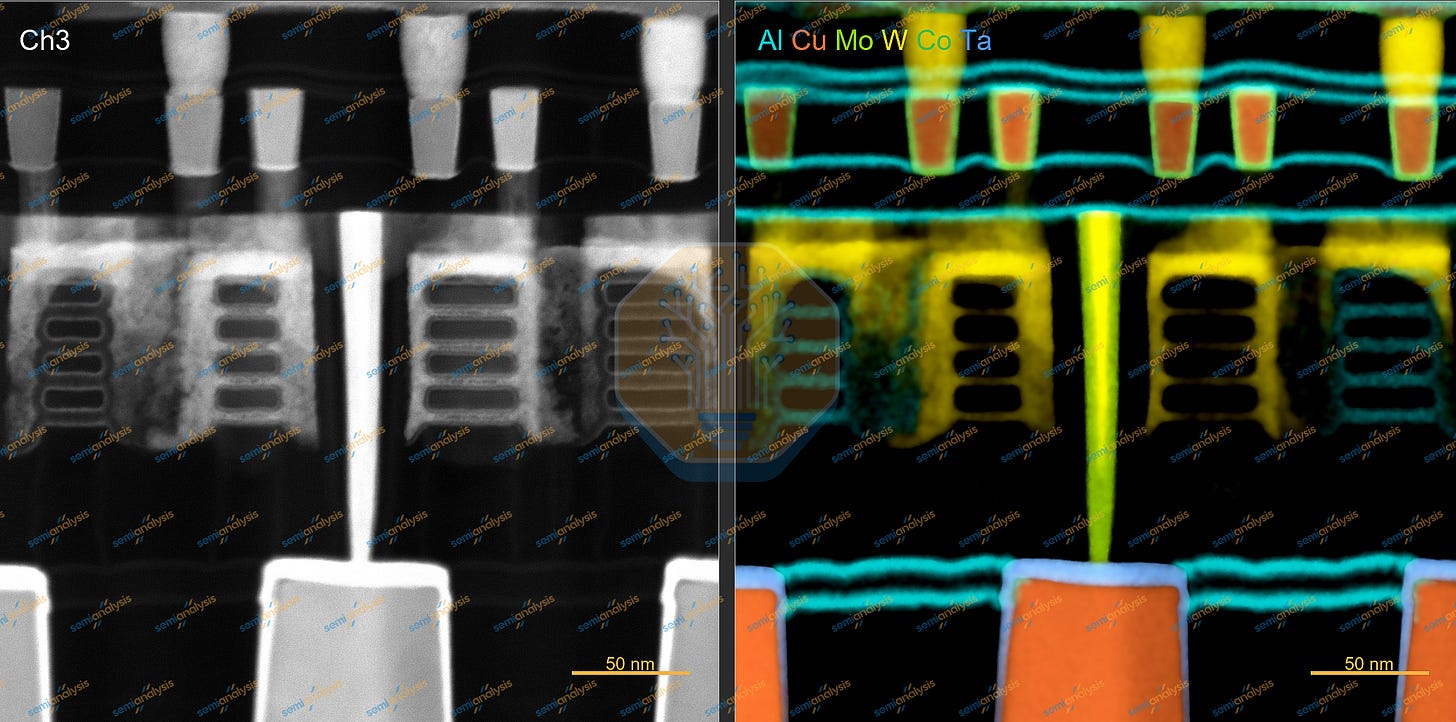
氧化铝(AlOₓ)充当刻蚀停止层(ES),实现终点检测并保护底层结构。低挥发性的氟化铝反应产物能够抵抗氟等离子体,使得一层薄薄的 AlOₓ 薄膜能够在去除周围低 k 值介质的同时保护金属。[6], [7]。虽然 BM0 和 M1 线以上的层显示出双层 AlOx,但我们对中国商汤科技(SMIC)N+3 节点的拆解显示为单层 AlOₓ。SMIC 使用更简单的局部 AlOₓ 子堆层,而其余的盖帽和刻蚀序列提供了所需的接合点保护。
那么为什么是双层呢?紧密排列的 AlOₓ 双联体在刻蚀序列中提供了两个受保护的终点。英特尔文档描述了一种 AlOₓ/SiN/AlOₓ 堆层,解释了其优势。主介质等离子体刻蚀在第一层 AlOₓ 薄膜上停止;选择性湿法清洗打开该薄膜;第二次等离子体刻蚀去除中间的氮化硅(SiN)并在第二层 AlOₓ 薄膜上停止。最后的湿法清洗暴露出金属接合面。SiN 是英特尔公开示例中的中间介质。[8]
第二个停止层通过盖帽突破保护金属。宽开口比窄开口刻蚀得更快,且刻蚀深度在整个晶圆上会有所变化。如果没有早期清除的开口下的金属原本会暴露出来,而其他开口仍需更多刻蚀。分阶段保护扩大了工艺窗口,并减少了金属侵蚀、腐蚀和空洞形成。[8]
台积电记录了铜上方的 AlN/AlOₓ/SiOC/AlOₓ 结构,其中氮化铝(AlN)阻挡铜扩散,以及一种更简单的 AlN/SiOC/AlOₓ 变体,省略了一层 AlOx 薄膜。[9] 具有不同开口尺寸、长宽比、图案密度和盖帽材料的层级需要不同的刻蚀余量。当另一个受保护的终点足以证明增加处理步骤的合理性时,双层 AlOx 停止层是有用的。
额外的薄膜增加了成膜、选择性开孔和清洗步骤,以及另一组需要控制粘附性、水分和应力的界面。这些整面薄膜是通过现有的通孔图案打开的,因此每层薄膜都不需要额外的光刻掩模。当 AlOₓ 取代低 k 值介质时会增加寄生电容;然而,两层薄的 AlOₓ 薄膜所含的 AlOₓ 总量可能少于一层厚的 AlOₓ 薄膜。总厚度、位置以及中间介质决定了电气成本。沉积化学也会改变 AlOx 的介电常数和残留羟基含量,后者可能会氧化底层金属。[7], [8], [10], [11]
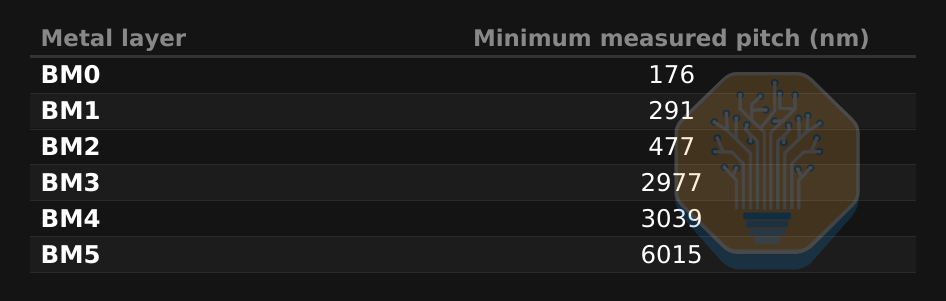
背面堆叠在器件附近分为较细的BM0-BM2布线,而在电源分配方面则采用较粗的BM3-BM5。最大的线距增加发生在BM2和BM3之间。BM0的线距与逻辑行高度紧密匹配,从而适应单元行的局部电源输送。更高层级通过更大的导体汇聚电流:随着网络接近封装,布线密度变得不如低电阻和电流容量重要。这种层级结构为电源分配网络提供了宽电源布线,同时不消耗稀缺的前面信号布线资源。[3]
前面互连
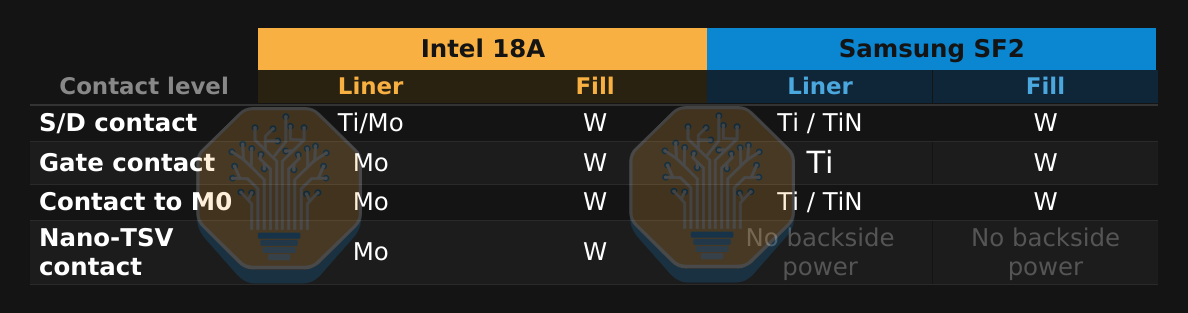
Intel 18A将Mo衬里的W接触点和纳米TSV与独立的背面Cu电源网络相结合。三星SF2将电源保留在前面,使用基于Ti的接触界面以及围绕Cu布线的基于Ta的阻挡层和Co内衬。
在18A标准单元行中,背面电源轨通过单元内的纳米TSV向器件供电,从而释放了前面的布线资源。三星的M0同时容纳电源和信号连接。
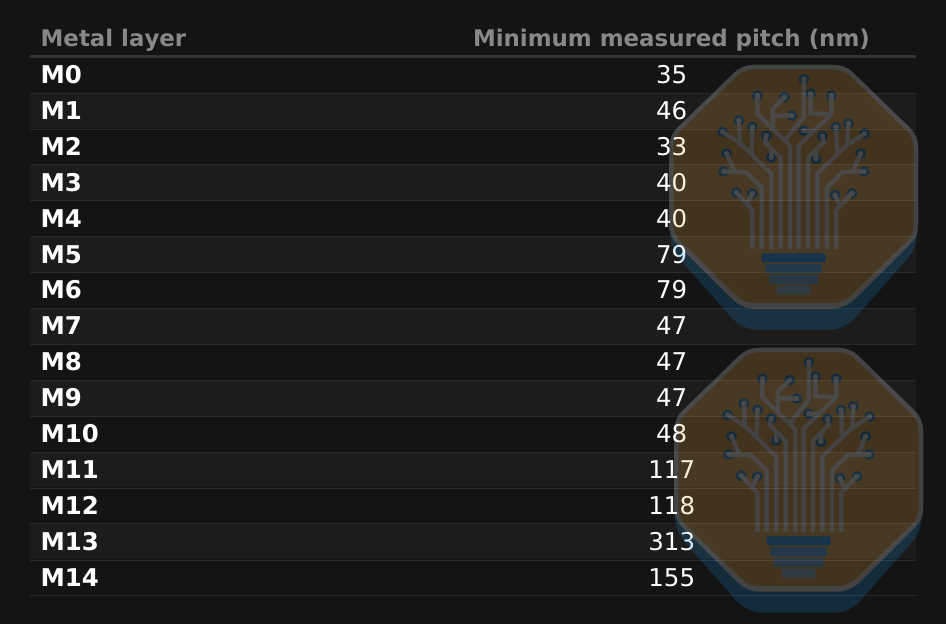
从器件到M0,连接路径穿过基于Ti的S/D界面、W接触填充、Mo衬里的W通孔以及Cu M0导线。Mo为W提供导电成核和附着层,取代了传统W集成中使用的电阻性TiN内衬。这在保持W填充及其成熟的抛光、清洗和蚀刻工艺的同时,增加了特征内部的有效导电路径体积。Intel的Mo/W专利描述了这种集成权衡。纳米TSV在背面供电路径中也使用了相同的Mo衬里W结构。[12]
从TiN到Mo的转变是一种渐进式变化。虽然全Co或全Mo填充也可以减少极小特征中因内衬而损失的体积,但这需要增加复杂性和风险的新集成方案。由于Cu具有低电阻特性,它在较宽的导线中仍具吸引力。随着导线和通孔缩小,扩散屏障占其横截面的比例越来越大。[12], [12], [14]
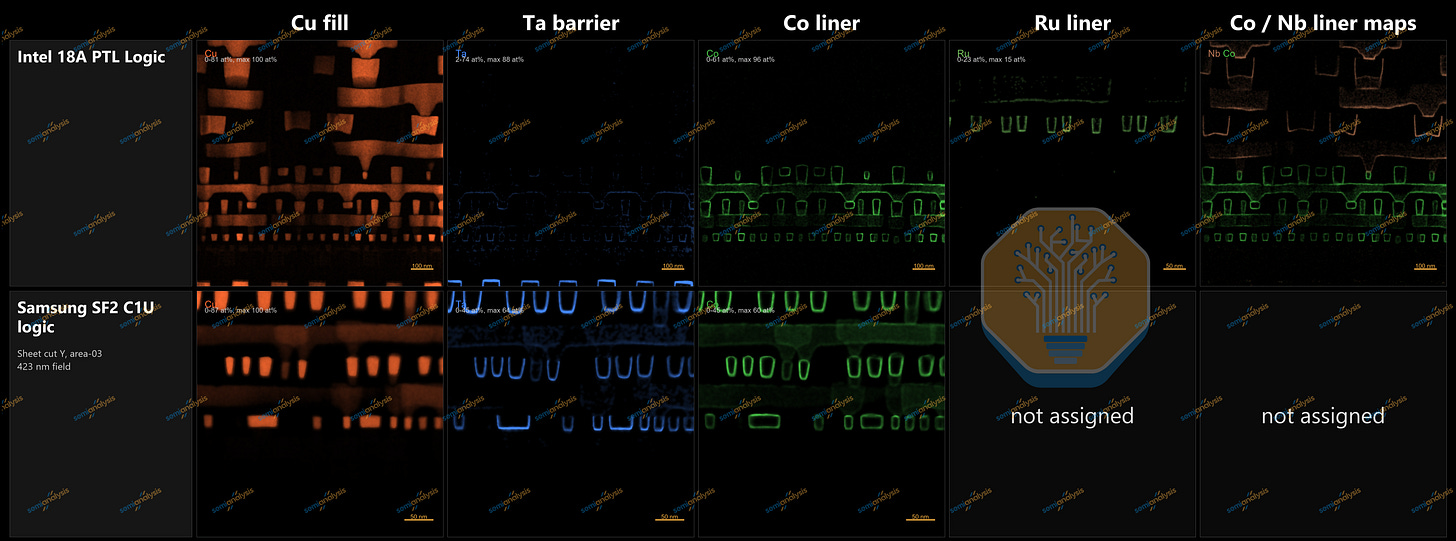
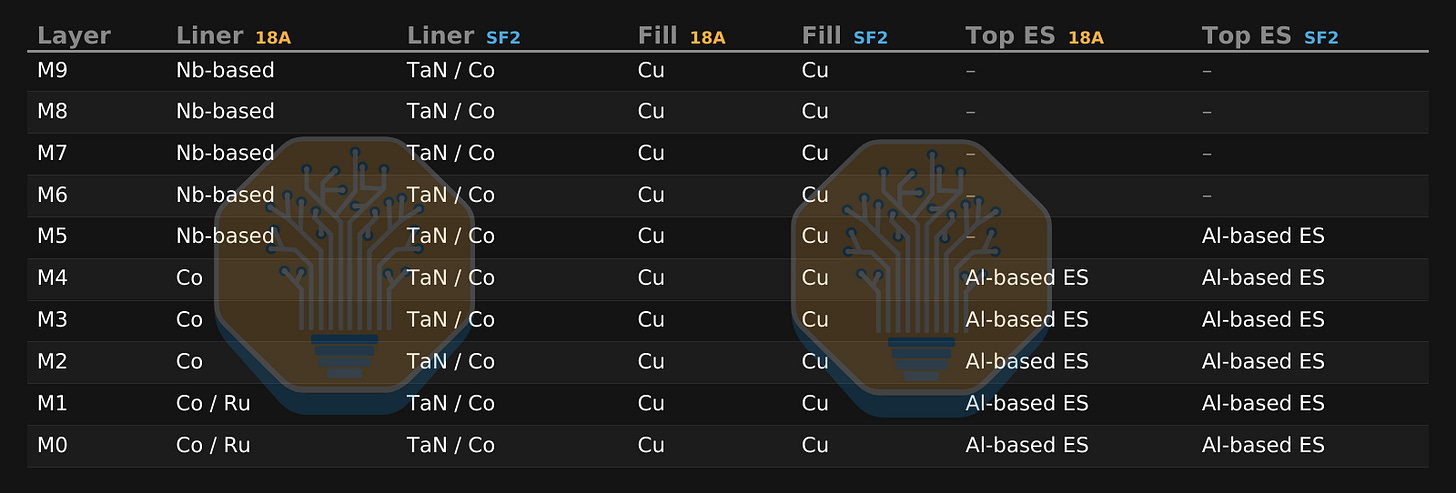
Intel在M0-M1使用Co/Ru内衬,在M2-M4使用Co,在M5-M9使用Nb。较低层级的内衬有助于Cu附着并减少沟槽填充过程中的空洞形成。应用材料公司的Endura设备具有新的热控制技术,促进了润湿过程,因此薄膜连续性足够好,毛细管压力足以驱动Cu原子到达通孔底部而不产生空洞。
Intel选择使用Nb尤其引人关注。Intel的Nb专利描述了一种导电扩散屏障,旨在降低屏障相对于传统基于Ta的屏障对电阻的贡献,特别是在所有电流都穿过屏障的通孔底部。该专利将Nb用于较粗的层级,并提供了成本较低的PVD加工选项。[15], [16]
尽管物理气相沉积(PVD)的覆盖率和均匀性较差,但上层金属层支持通过PVD形成的较厚屏障。与此同时,下层金属层需要通过保形原子层沉积(ALD)沉积较薄的屏障。Co/Ru增加了另一个材料界面,并要求受控沉积和Cu填充。按金属层更换内衬和屏障使Intel能够优化互连电阻、工艺复杂性和可靠性。[15, 16]
RibbonFET是Intel对其环绕栅场效应晶体管(GAAFETs)的命名,它用四个堆叠的水平硅纳米片取代了FinFET的垂直鳍片,允许栅极在每个侧面环绕沟道。通往GAAFET的路径始于平面晶体管。
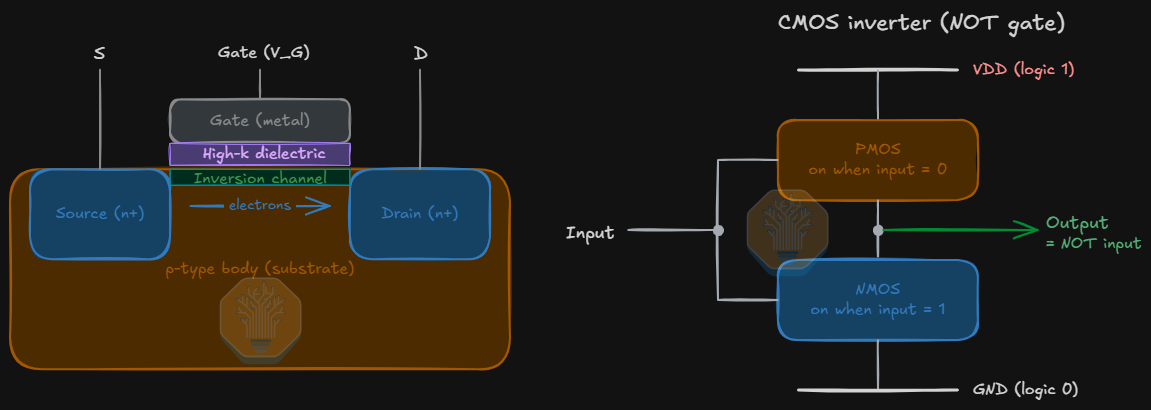
平面MOSFET将栅极置于源极和漏极之间的沟道上方。将NMOS与PMOS晶体管配对可创建CMOS反相器,其中NMOS在高输入时将输出拉低,而PMOS在低输入时将输出拉高。栅极必须保持对沟道的静电控制以确保干净的开关。随着栅长缩短,漏极开始与栅极争夺这种控制,导致关态漏电增加。
静电控制通过架构演进得以恢复,该演进将沟道抬升为垂直鳍片,并将栅极包裹在三个侧面。这种被称为“FinFET”的新架构在更小的占地面积内集成了更多的有效沟道宽度。进一步的缩放使得在更小的单元中同时维持驱动电流和漏电流变得更加困难,并重新引入了平面MOSFET所面临的问题。纳米片GAAFET通过将垂直鳍片替换为水平纳米片的堆叠来封闭第四个侧面,每个纳米片都被栅极包围。更紧密的静电控制在较短的栅长下抑制了漏电流,而堆叠则在单元占地面积内增加了有效沟道宽度。
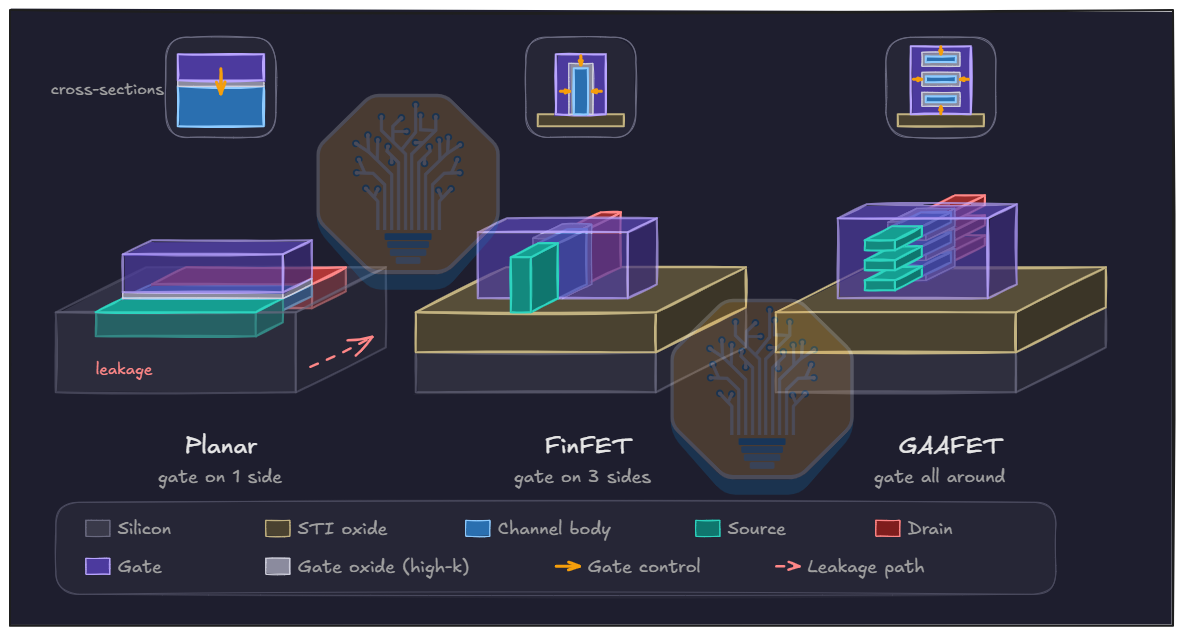
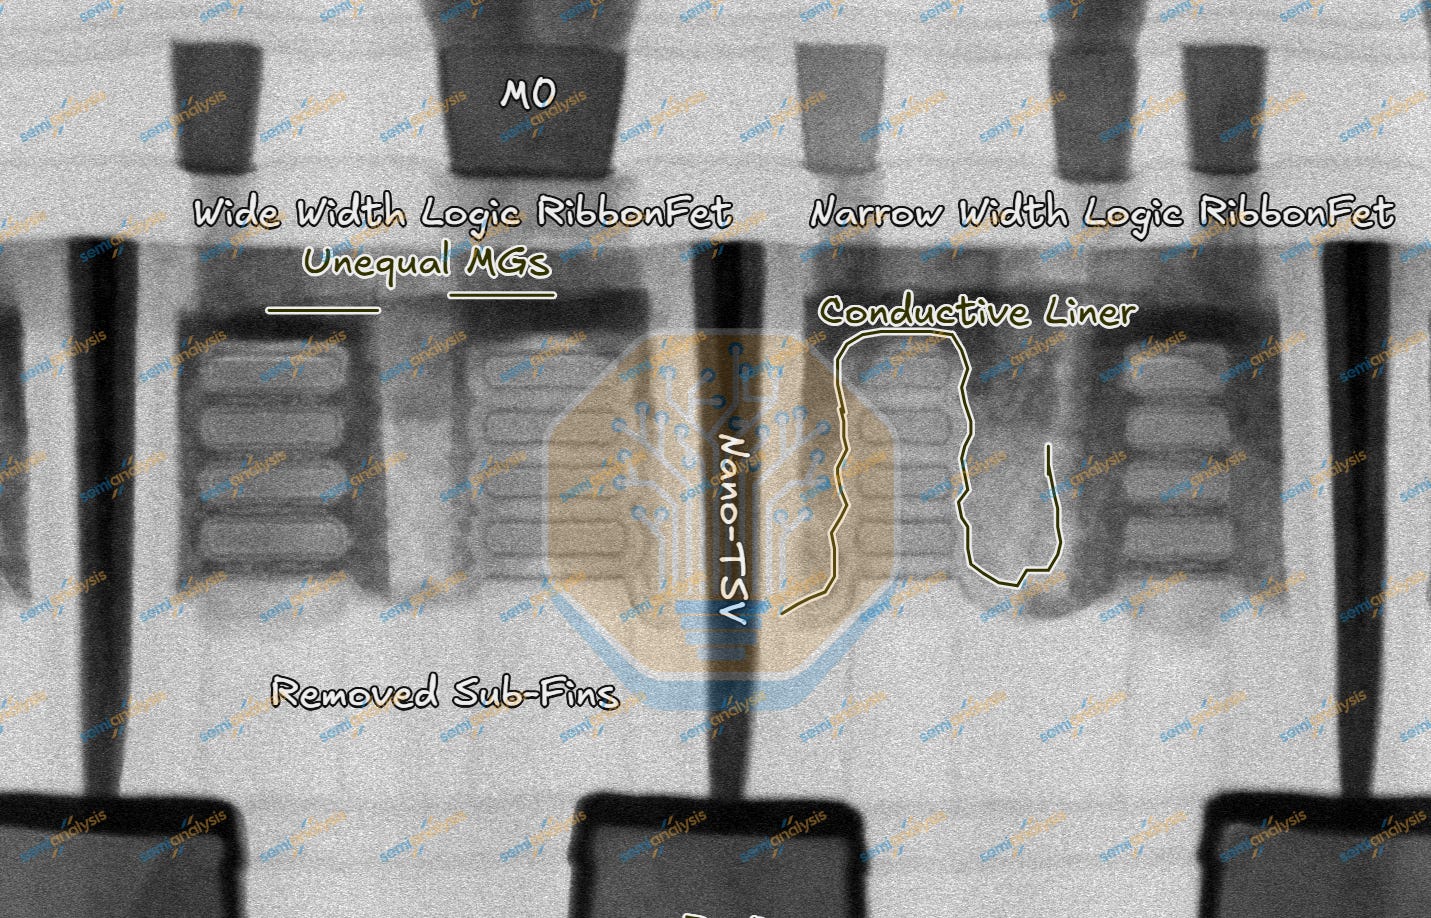
在FinFET工艺中,沟道宽度以离散步骤变化,因为设计师必须添加或移除整个鳍片。相反,纳米片宽度可以在工艺的设计规则内进行连续调整。更宽的纳米片增加驱动电流,而更窄的纳米片则以牺牲驱动电流为代价降低电容。Intel 18A使用每个包含四个纳米片的堆叠,并在逻辑电路和SRAM之间改变其宽度。在工艺层面,在每个堆叠中添加更多纳米片会增加有效沟道宽度和驱动电流,但会使制造复杂化。
RibbonFET与MBCFET对比
三星于2022年凭借SF3E开始了GAAFET的生产,随后推出了SF3,现在是SF2。其“MBCFET”为英特尔的首款RibbonFET实现提供了有用的结构对比。[17] STEEL将在即将到来的通讯文章中深入探讨用于Exynos 2600的SF2以及用于苹果A20 Pro的台积电GAAFET N2。我们在X上发布了一些预告。让我们比较三星SF2的MBCFET与英特尔18A的RibbonFET。
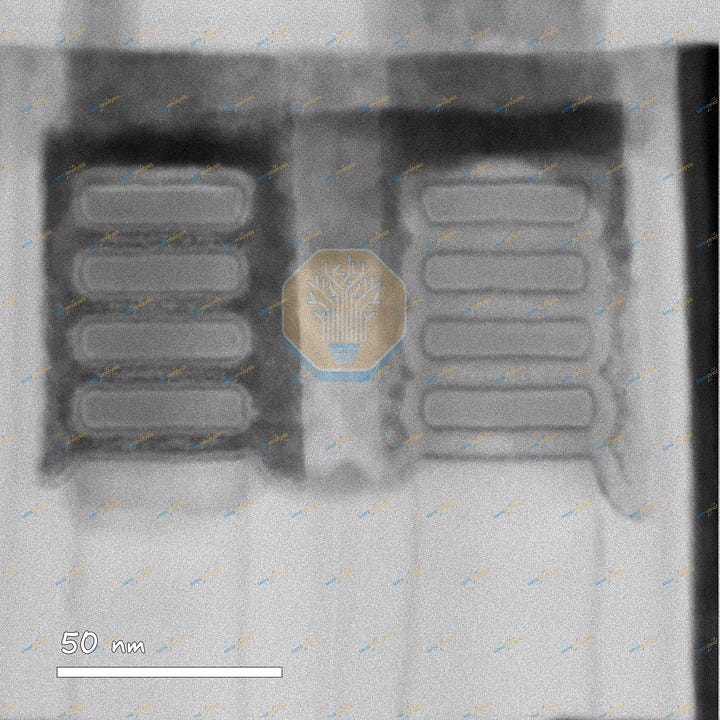
即使对于外行来说,英特尔额外的纳米片也显而易见。英特尔堆叠了四条带子,而三星只有三条。在这些区域中,三星的纳米片要宽得多,因此纳米片数量和宽度都对可用的沟道周长有影响。纳米片宽度还会改变承载电流的硅表面。在传统的(001)硅上,宽纳米片强调宽阔的顶部和底部表面,有利于电子传输;而在窄纳米片中较大的侧壁贡献则有利于空穴传输。较薄的纳米片改善了栅极控制,但增加了限制和散射效应。这使得宽度和厚度成为NMOS/PMOS平衡的一部分,与应变和阈值电压并列。[18], [19]
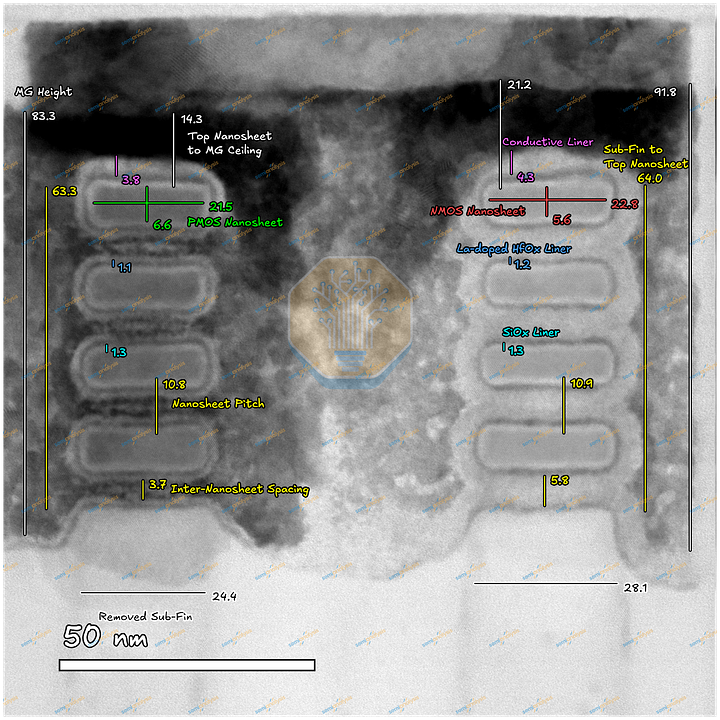
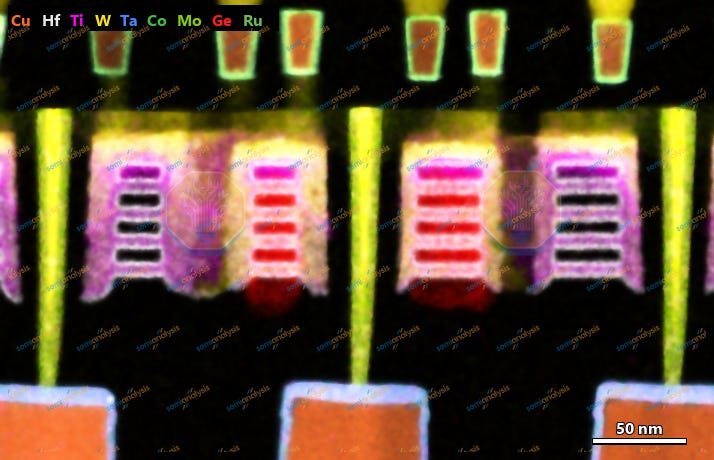
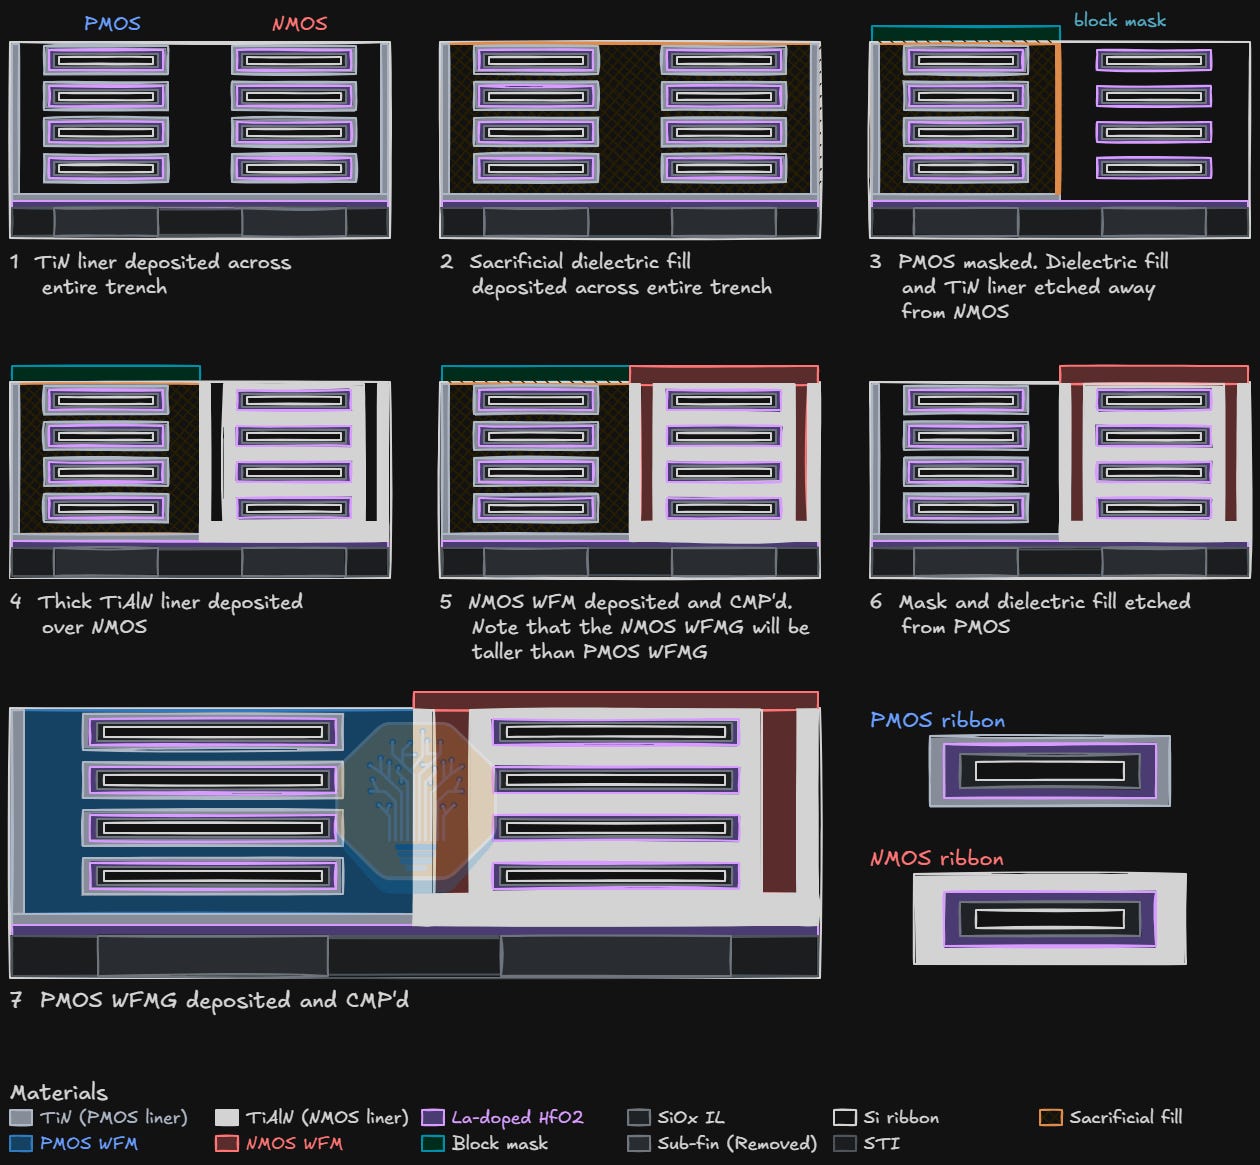
像18A这样的GAAFET设计为NMOS和PMOS使用不同的功函数金属(WFM)堆栈。在每个带子周围,一层薄薄的SiOx界面层将硅沟道与HfOx高k电介质隔开,La提供偶极子调谐,WFM包裹电介质。NMOS使用基于TiAl的堆栈,而PMOS使用TiN WFM。W填充剩余的栅极沟槽,在不再需要功函数层的区域提供更低的电阻路径。在该区域中,PMOS堆栈在带子之间留出W的空间,而NMOS堆栈占据了这些间隙的更多部分。基于硅的电介质标记P/N边界,允许共享同一栅极沟槽的PMOS和NMOS栅极进行顺序处理。
快速逻辑路径、保持电路和SRM需要一系列阈值选项。在不显著改变器件尺寸、电容或制造复杂度的情况下改变阈值是非常有价值的。FinFET工艺通常使用不同的功函数金属堆栈。在四带GAA堆叠中,狭窄的片间间隙限制了可以围绕每个通道放置多少WFM。栅极电介质中的La在SiOx/HfOx边界处产生界面偶极子,从而移动有效功函数并调谐阈值电压。这为英特尔提供了除了NMOS和PMOS WFM堆栈之外的另一个控制手段。低阈值器件提高了关键路径的驱动能力;较高的阈值在其他地方减少了漏电流。偶极子调谐在GAA中特别有用,因为它在不消耗狭窄片间间隙的情况下改变阈值,而不是用更厚的WFM去填充。
长期以来,对镧(La)掺入、扩散及界面质量的精确控制一直是一个挑战,这限制了其在大规模生产中的可行性,但如今这一技术已被所有领先的代工厂所掌握。英特尔的专利描述了在 HfOx 之上沉积形成偶极子的氧化物,并在完成功函数和填充金属之前将其退火至界面氧化物处。这将阈值调节与金属可用空间分离开来。较新的研究则着眼于热成本问题:imec 的 2026 年“中间偶极子”研究将移位层插入两层 HfOx 之间,缩短了扩散路径,同时在图形化过程中保护 SiOx。[20]、[21] 匹配切割的 EDS 分析,英特尔 18A(左)对比三星 SF2(右)。
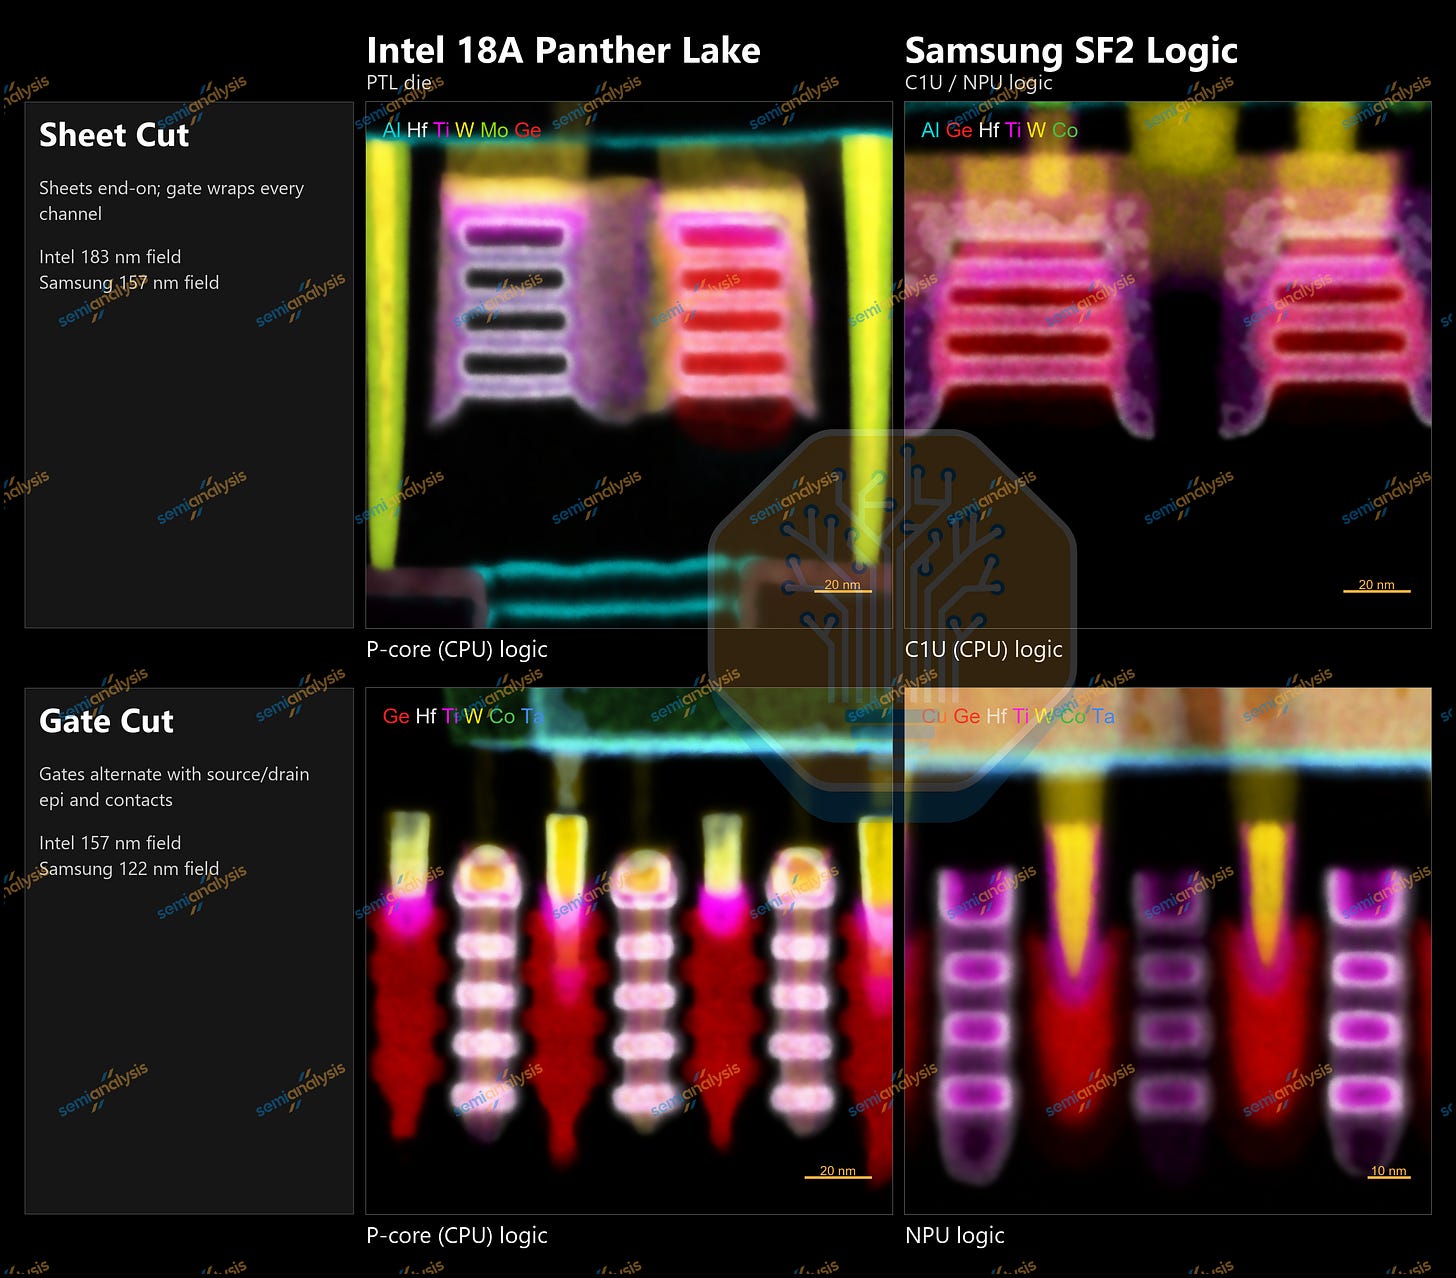
英特尔在其接触孔下方保留了抬高的源/漏外延层,而三星则将钨(W)深深嵌入外延层中以形成 V 形的钛衬里界面。更深的接触孔增加了金属与半导体的接触面积,并缩短了从下层 sheets 到接触点的电流路径,从而降低了接触电阻和展布电阻。它还减少了外延层的体积,使接触刻蚀更接近沟道末端。保留更多的外延层有助于维持用于应变传递的材料,特别是从 SiGe 到 PMOS 的应变传递。这些几何结构在接触访问、应力工程和刻蚀余量之间取得了平衡。[22]、[23]
三星堆叠了三层 sheet,而英特尔采用四条 ribbon,两种工艺均利用 sheet 宽度来调节驱动强度。在我们的三星截面图中,NPU 行的宽度大约在 19 到 30 纳米之间,CU 单元则在 37 到 50 纳米之间。三星的纳米片呈锥形分布,底部最宽,顶部最窄。两种工艺均采用 HfOx 栅介质和基于钛的功函数堆栈,其中 NMOS 堆栈中包含铝(Al)。在所示的三星器件中,介质和功函数材料占据了片间间隙,使得钨位于最顶层 sheet 之上。英特尔的 PMOS 堆栈在 ribbons 之间留出了更多空间,钨填充了这些间隙,而较厚的 NMOS 堆栈则主要将钨保留在上部沟槽中。栅堆栈的 EDS 映射图。
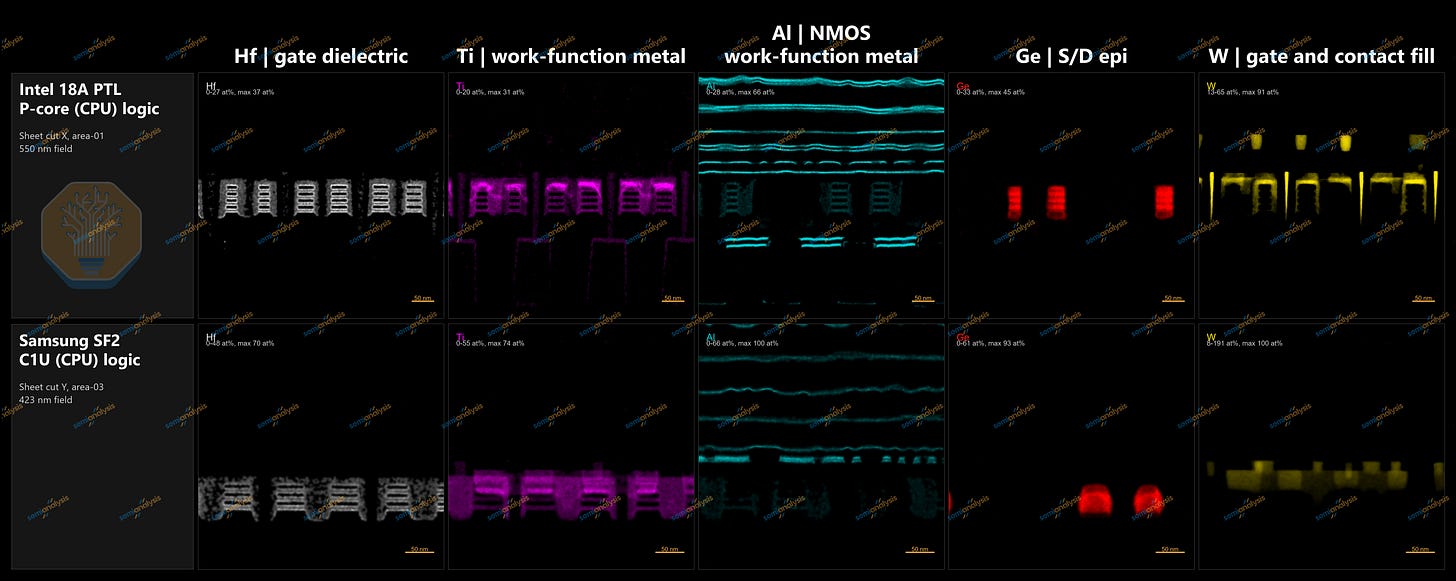
英特尔 PMOS ribbons 之间的钨提供了靠近下层栅极的导电通路。当功函数材料填满整个间隙时,栅极仍然包围着沟道,但电压需通过电阻率较高的功函数薄膜传导。较薄的功函数材料和偶极子调谐为低电阻率填充材料保留了空间;钼(Mo)和钌(Ru)是正在开发的替代填充金属,以实现进一步缩放。[24]
掩模化的顺序功函数流程解释了不同的栅极高度和纳米片间的填充情况。下面提出的序列展示了单独的 NMOS 和 PMOS 功函数步骤如何产生这种几何结构。
得益于 BSPDN 工艺,英特尔用介电质取代了密集逻辑硅子鳍,消除了 ribbon 下方的寄生导电路径,并降低了与衬底相关的电容。像经典非 SOI 平面和 FinFET 设计那样保留硅体需要结工程和穿通停止工程来抑制漏电流。介电隔离使漏电流对子鳍掺杂分布的敏感性降低,但增加了去除和填充步骤。它还削弱了通过硅的直接热路径,使得接触孔、金属堆栈和封装在散热方面变得更加重要。[24]、[26]
氟元素集中在英特尔某些器件结构的映射图中。WF6 是钨成核和填充的标准前驱体,而阻挡膜则保护相邻介电质免受氟侵蚀。低氟钨工艺减少了残留氟的负担。基于氯化物的前驱体避免了在钨沉积过程中引入氟,但需要控制氯侵蚀、成核和填充质量。集成的目标是一条连续、低电阻的钨通路,具有薄保护层,并对周围堆栈造成最小的化学损伤。[20]、[27]、[28]
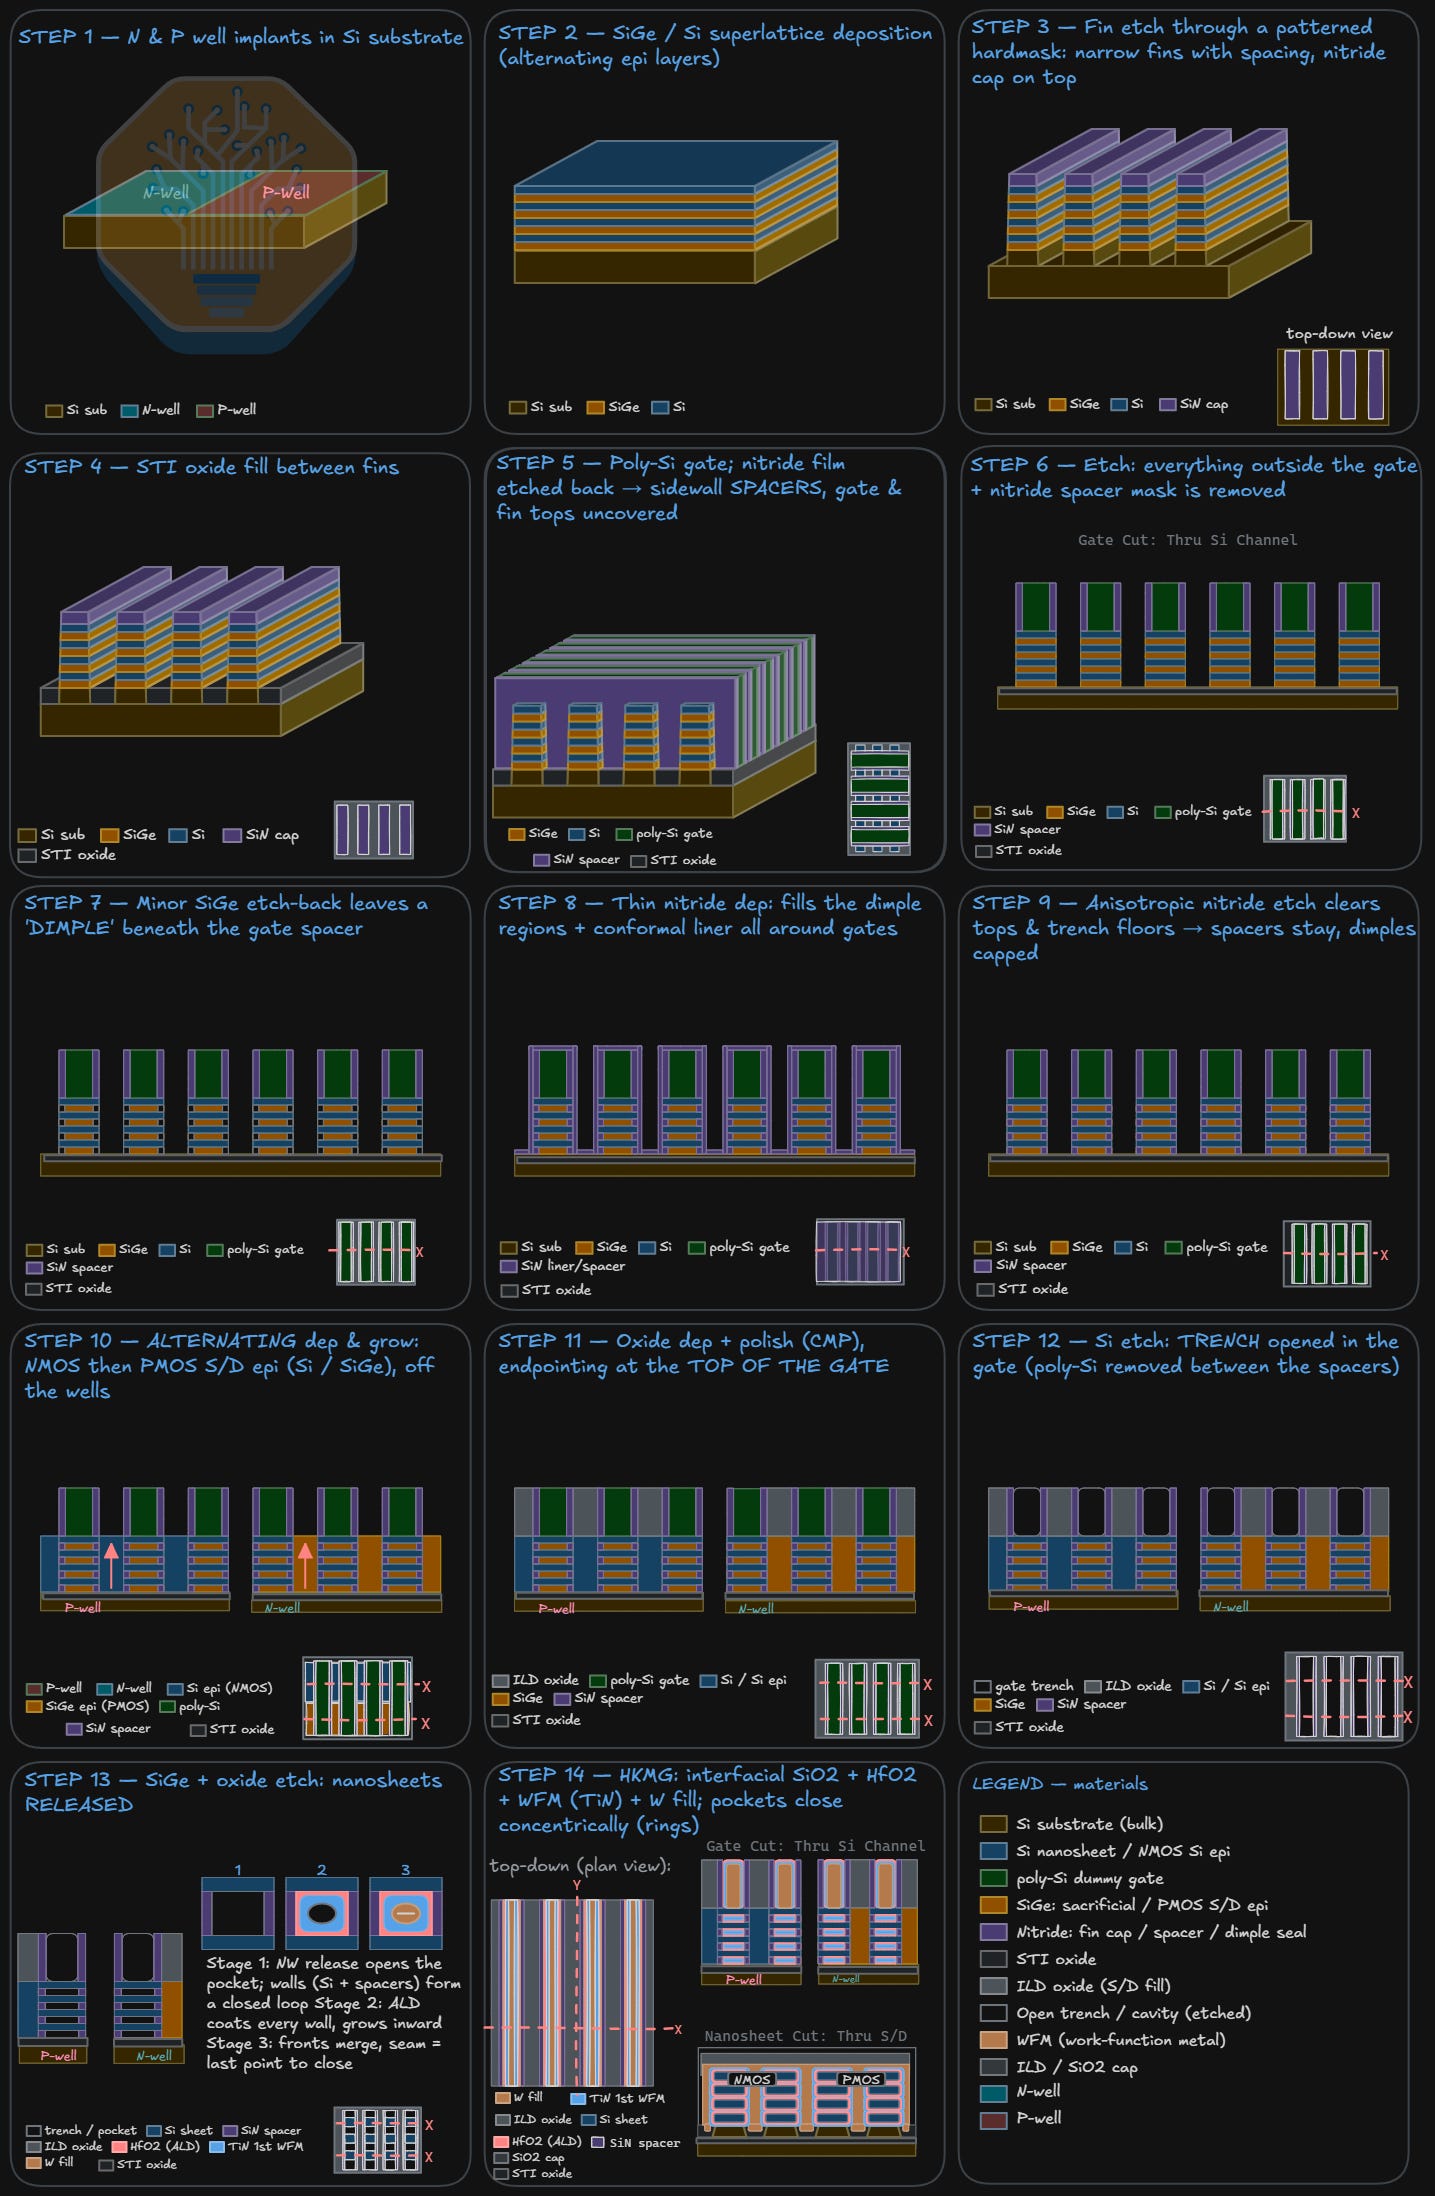
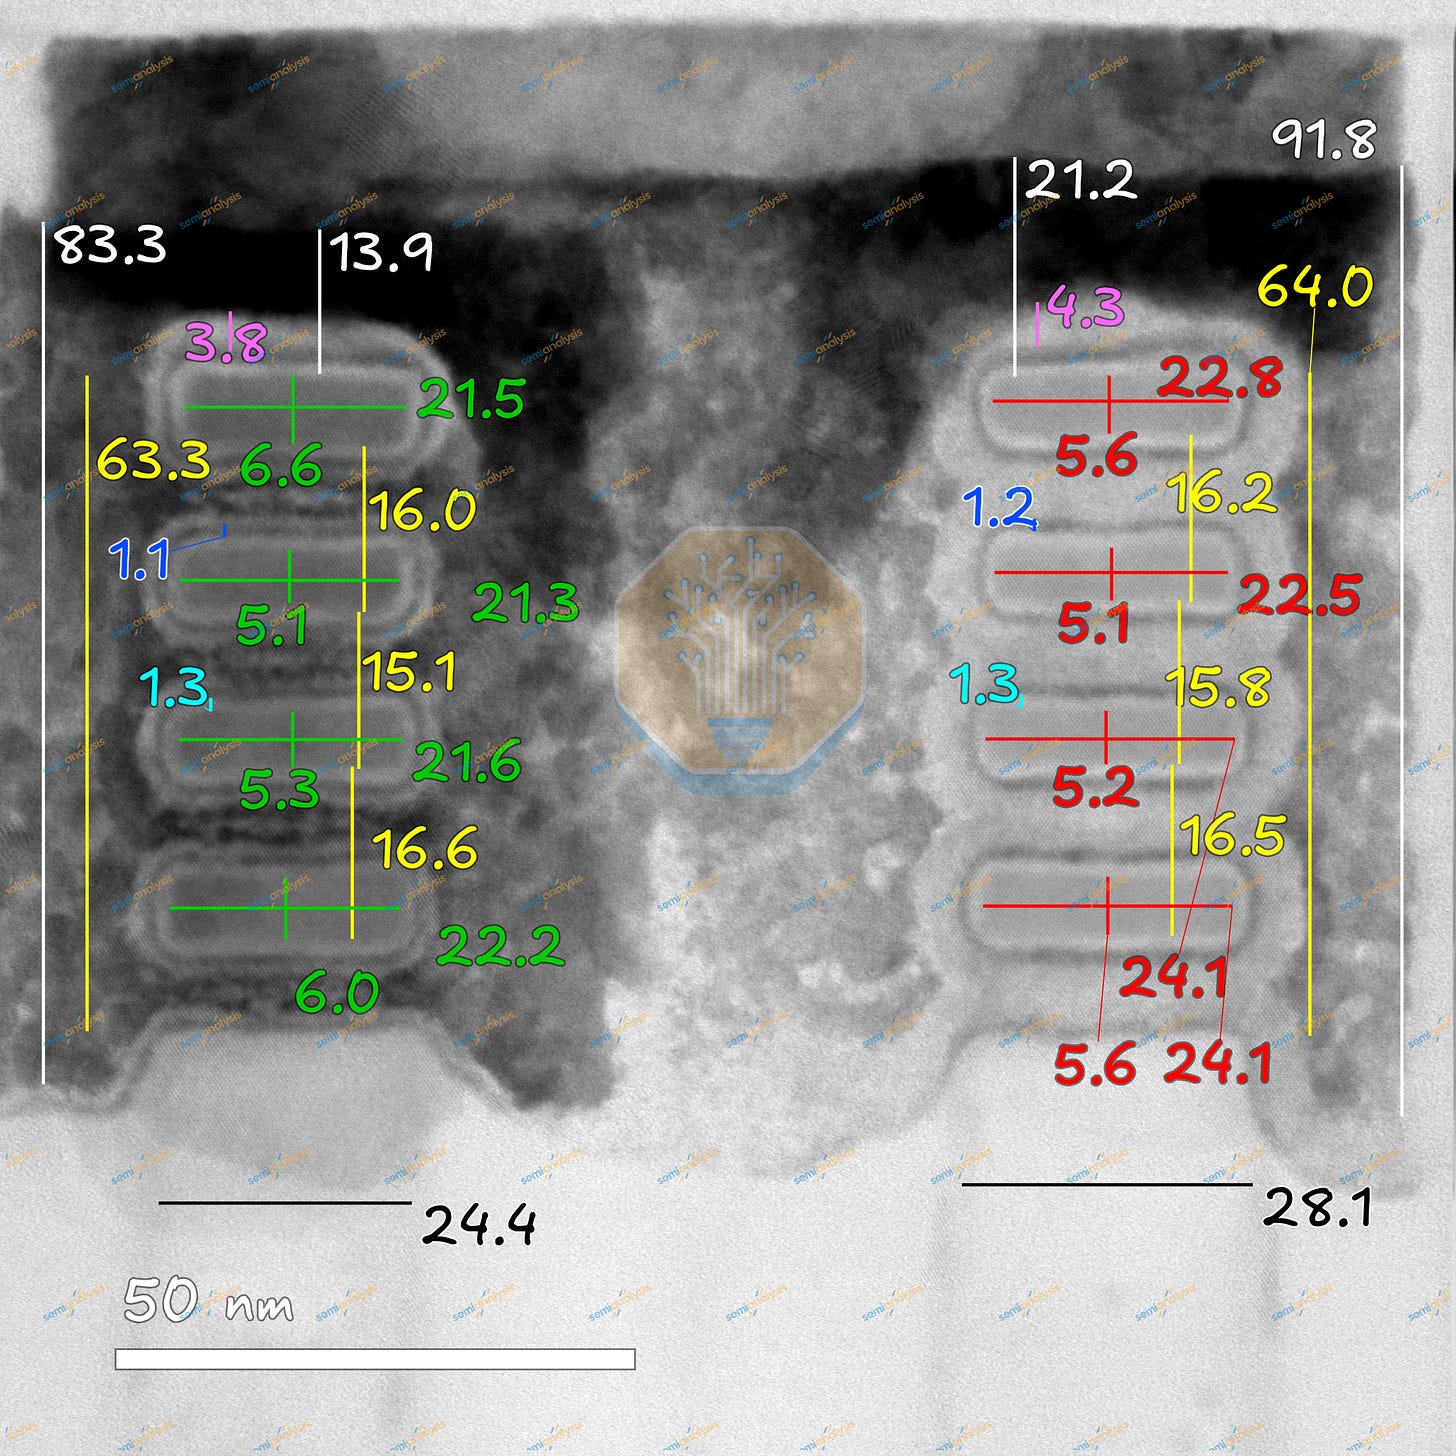
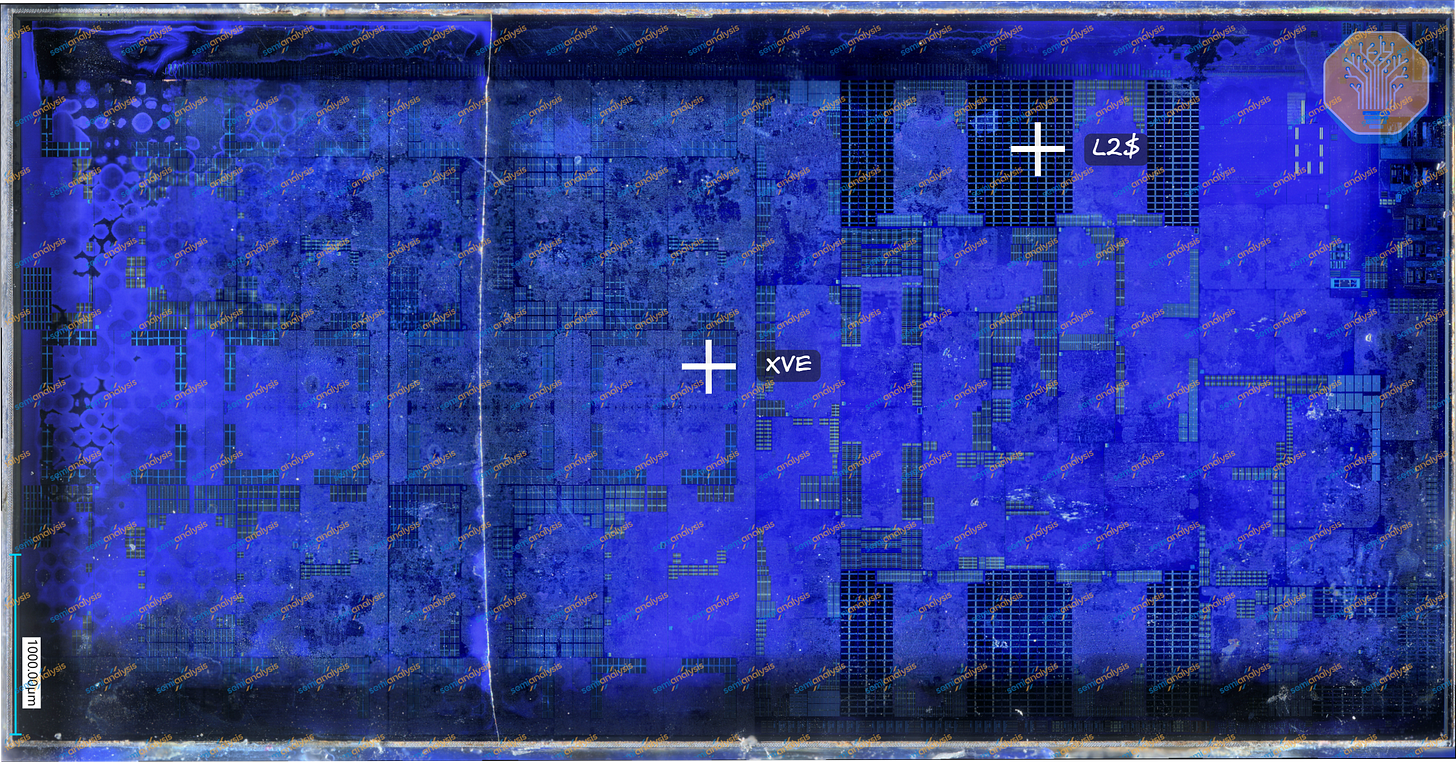
我们在下图中所示的 XTEM 位点测量了单元高度、栅极间距、金属几何结构和纳米片尺寸。表格按位点和器件极性对这些尺寸进行了分组。我们的“截面切片”穿过硅沟道,从端面展示纳米片;“栅极切片”则沿沟道方向穿过连续的栅极。
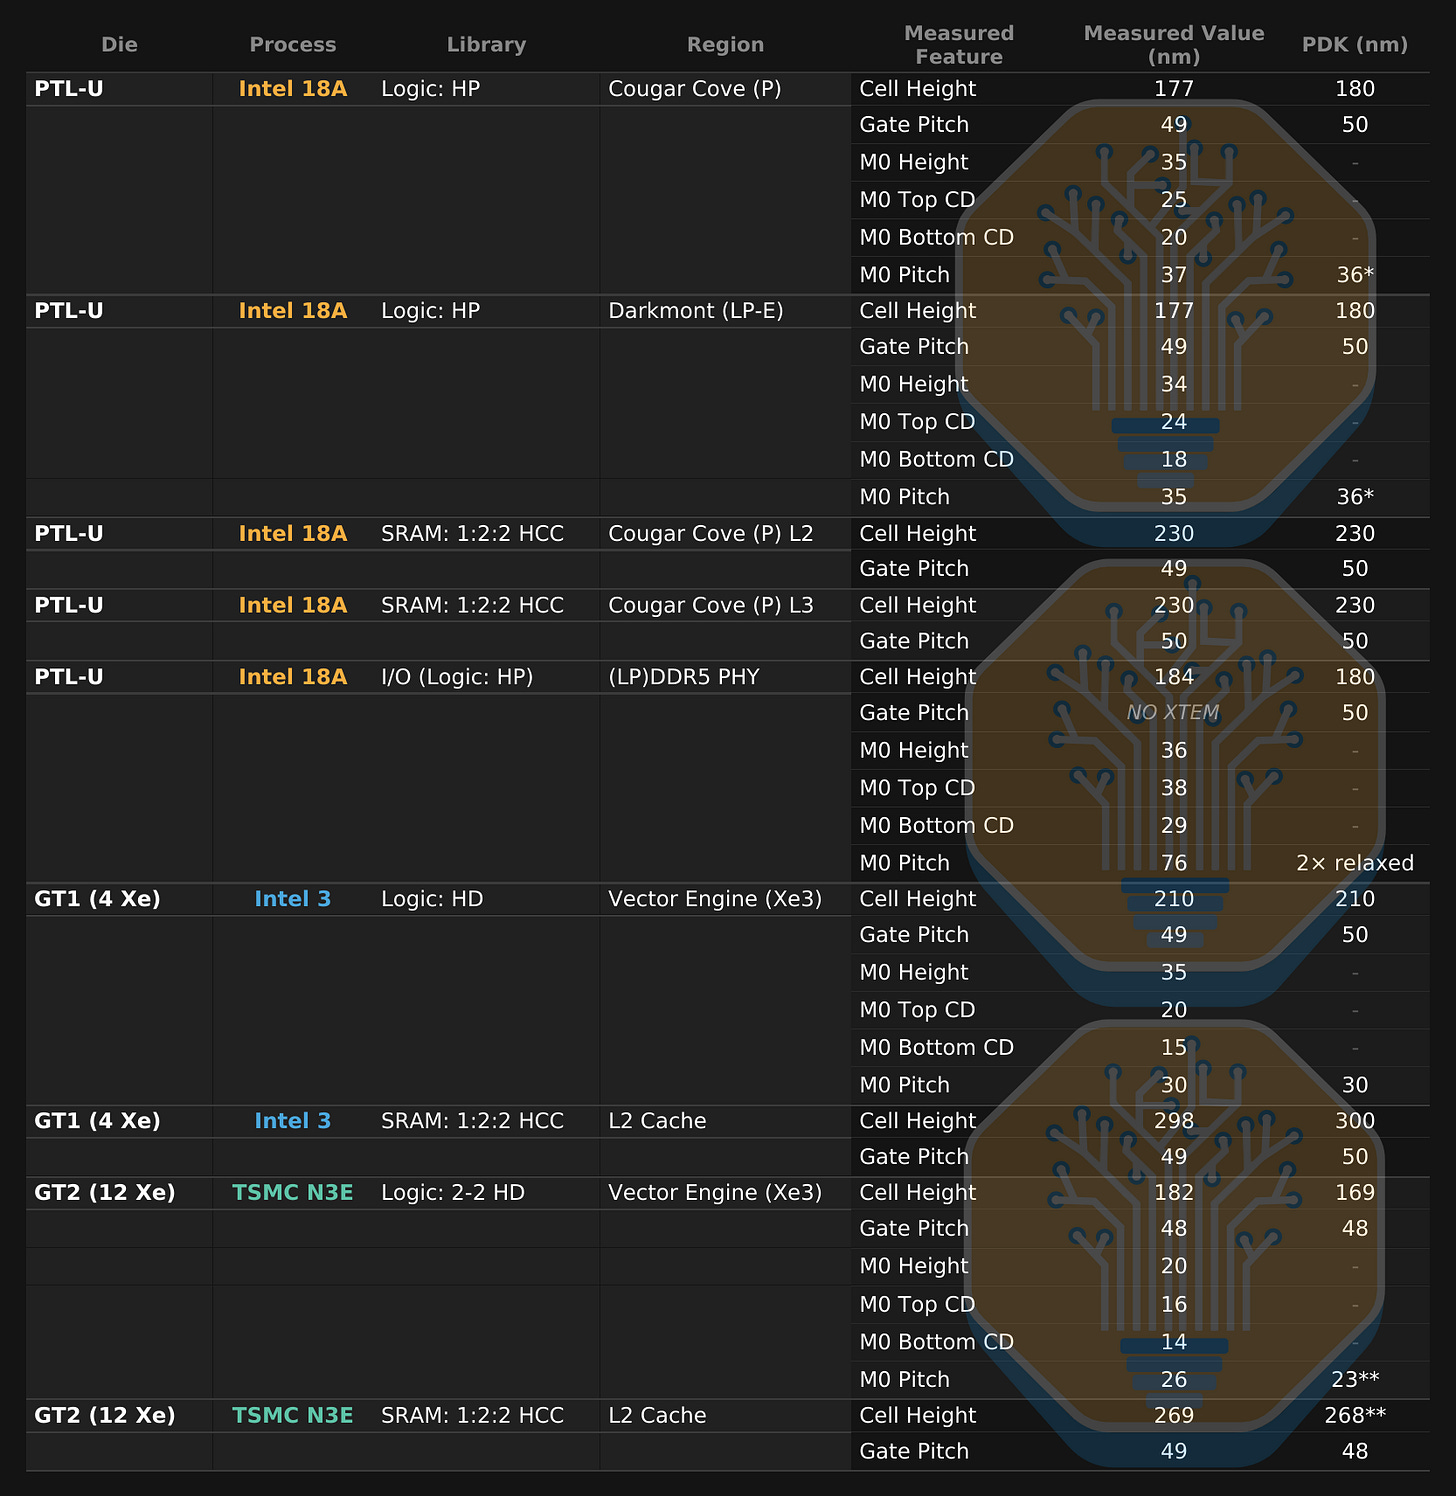
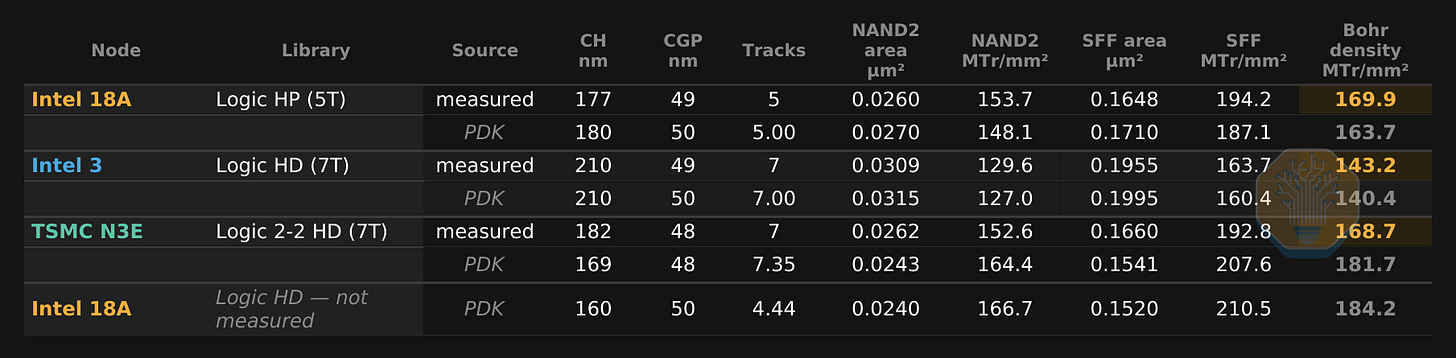
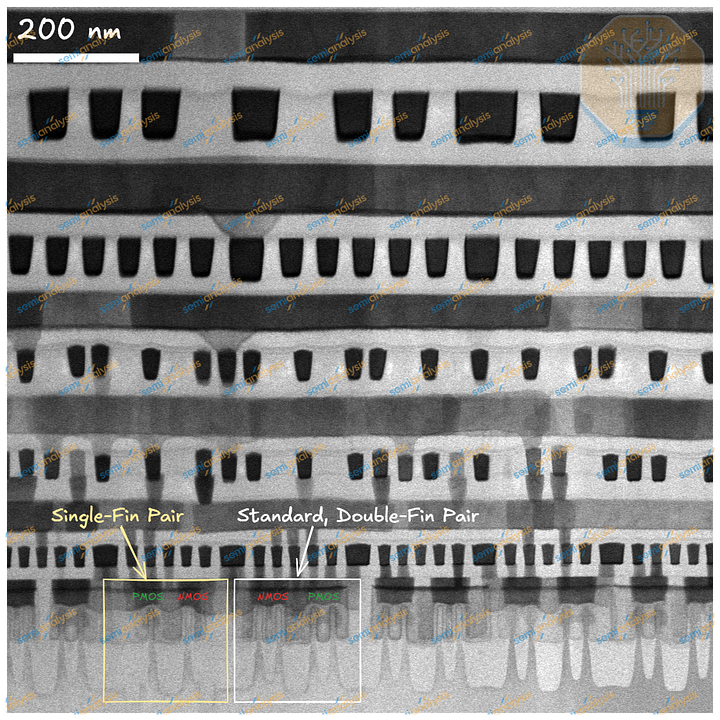
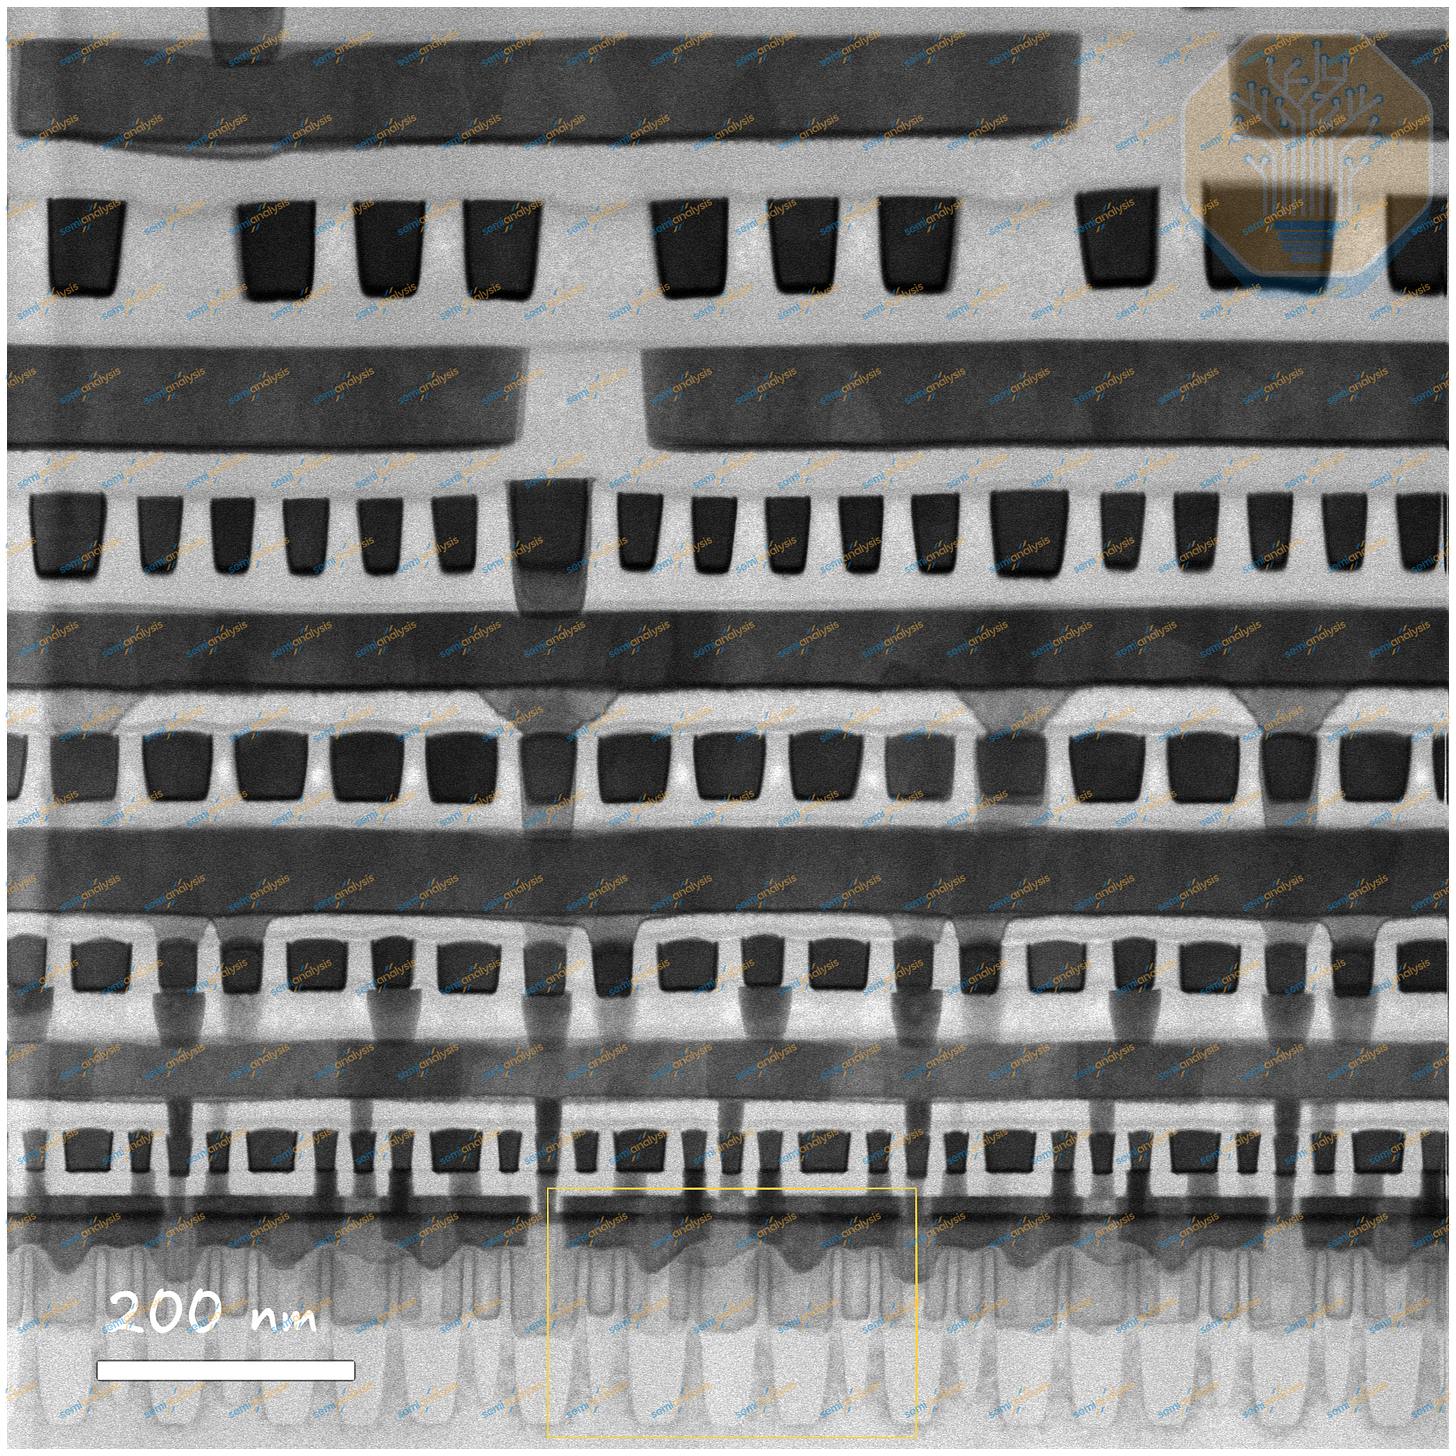
18A 逻辑单元的维度指向一个五轨逻辑库,而 N3E 和 Intel 3 的单元维度则表明采用了七轨逻辑库。DDR-PHY 使用了更宽的 M0 导线和比核心逻辑大得多的间距。这种设计以布线密度换取更低的导线电阻以及相邻网络间较弱的耦合效应。这种几何结构适合模拟电路、时钟电路和 I/O 电路的电流传输和耦合要求。
PowerVia 技术通过将主电源轨移出信号布线轨道,使 18A 能够在保持紧凑单元高度的同时采用更宽的 M0 几何结构。这在保留小型单元占地的同时,缓解了局部布线的缩放限制。单元高度和栅极间距决定了几何密度;引脚可访问性和可布线性则决定了实际模块能利用多少密度。[29]
从我们的栅极间距测量中得出的最大启示是:Intel 18A 计算逻辑与 TSMC N3E GPU 逻辑在 Bohr 代表性单元模型中具有相似的密度。18A 示例比 Intel 3 GPU 示例密集 18.6%。三个位点的栅极间距几乎相同,因此单元高度是导致差异的主要原因。
Bohr 模型结合了一个跨越三个栅极间距的四晶体管 NAND2 门和一个跨越十九个间距的 32 晶体管扫描触发器(SFF),并将它们的密度权重设为 60:40。灵敏度列显示了独立改变单元高度和栅极间距 ±1 nm 对结果的影响。这比较了代表性单元的几何形状;整片晶圆密度还取决于单元组合和布局。
18A P-core 提供的 M0 金属横截面积远大于 N3E 矢量引擎。将每个剖面视为梯形,每根线条的面积增加了 2.63 倍,经布线间距归一化后的面积增加了 1.84 倍。更大的横截面降低了线路电阻的几何贡献,并在给定电流下降低了电流密度。更高更宽的导线也会增加电容,因此电路延迟取决于电阻和电容之间的平衡。DDR-PHY 每单位布线宽度的金属面积少于 18A 核心区域,但仍高于 N3E。[30]
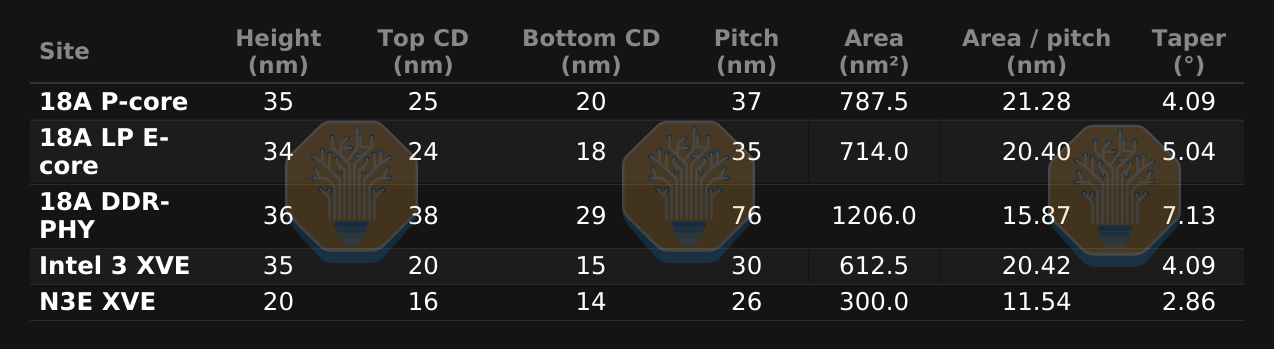
面积 = 高度 × (顶部关键尺寸 + 底部关键尺寸) / 2,包括衬垫。面积/间距通过布线宽度进行归一化。锥度是指相对于垂直方向的对称侧壁角度,其中 DDR-PHY 的角度最大。
计算芯片块
测量结果显示了纳米片尺寸和栅堆叠几何结构如何在计算芯片块内变化,以及在 NMOS 和 PMOS 之间如何变化,以平衡沟道驱动能力、栅极负载以及逻辑、SRAM 和 DDR-PHY 所需的介电层/WFM 堆叠空间。宽度主要改变可用的沟道周长;厚度也改变静电控制和载流子限制。然后,栅堆叠厚度决定了留给低电阻填充材料的剩余空间。
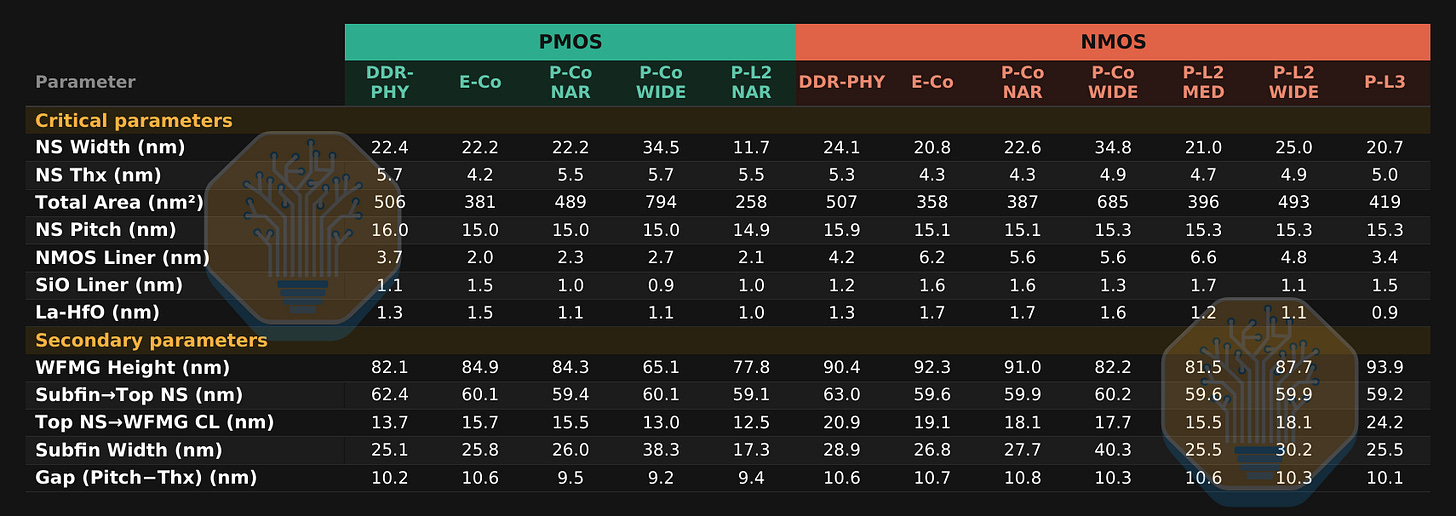
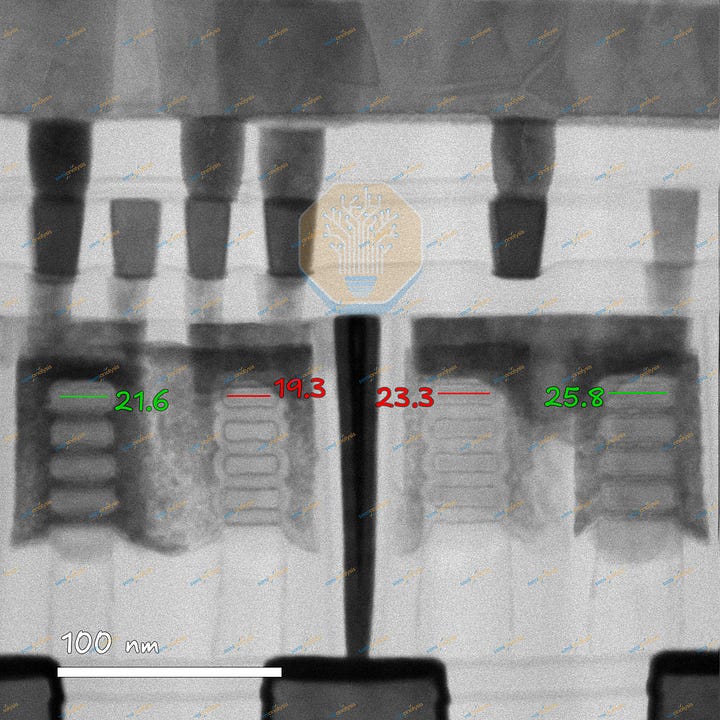
P-core 和 LP E-core 逻辑
P-core 和 LP E-core 均使用多种纳米片宽度。宽度是在高放大倍数 XTEM 上测量的,而宽视野图像展示了 LP E-core 内额外的宽度选择。即使在 LP E-core 内部,预计也存在多种宽度。时序关键路径、缓冲器和具有不同扇出的单元需要不同的驱动强度。低放大倍数的视野展示了超出表格量化位点的这种宽度多样性。
L2 和 L3 SRAM
GAA 为 SRAM 设计人员提供了另一种平衡上拉(PU)、传输门(PG)和下拉(PD)晶体管的方法。FinFET 位单元通过鳍片数量来设定器件强度,而 GAA 则增加了纳米片宽度作为尺寸调节手段。在 6T SRAM 单元中,相对于传输门较强的下拉管可限制读取干扰,而相对于上拉管较强的传输门可提高写入能力。在写入过程中,传输门和写驱动器将存储“1”的节点拉至反相器翻转点以下。在读取过程中,下拉管保持存储“0”的节点处于低电平。偏置、阈值电压、失配以及辅助电路决定了剩余的裕量。FinFET 高电流单元通常采用 PU:PG:PD 鳍片数量比为 1:2:2 的模式,这是一种器件尺寸比而非电流比。
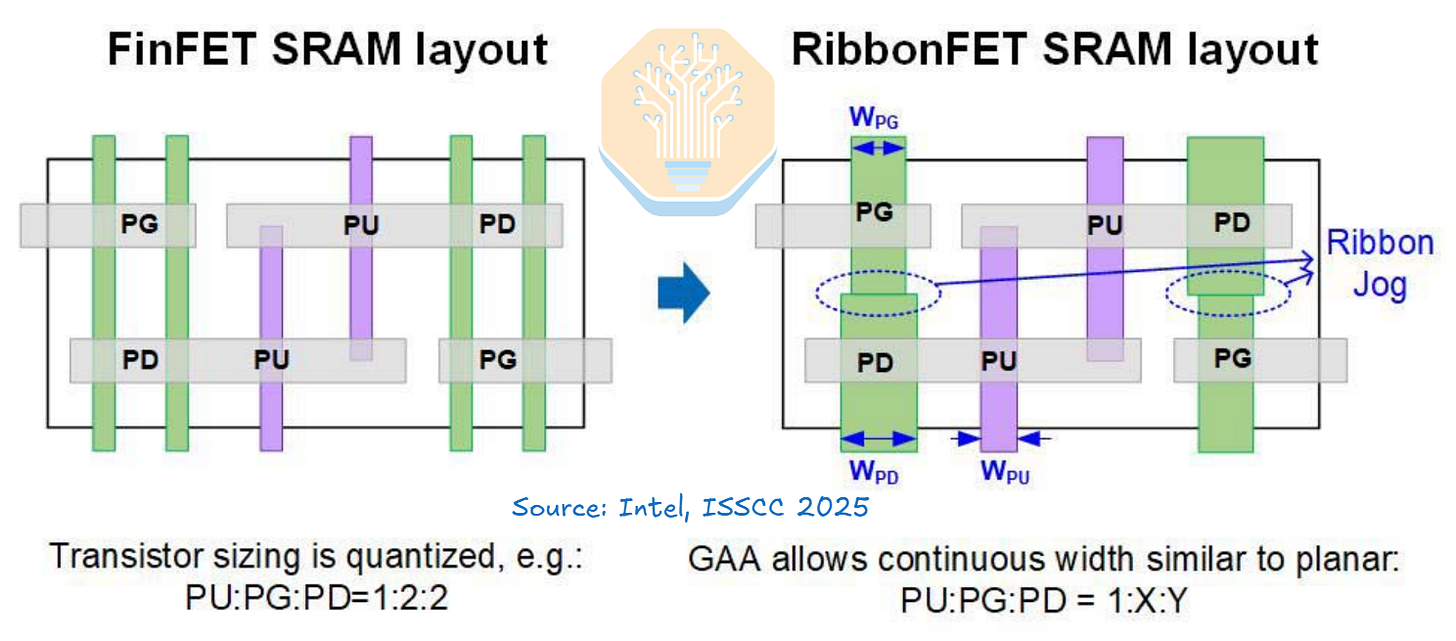
纳米带宽度使英特尔能够在不增加完整鳍片的情况下平衡 SRAM 的性能优势。L2 单元对其 PU 使用最窄的纳米带,对 PD 使用最宽的纳米带,从而分别提高写入能力和读取稳定性。英特尔公开的 HCC 无需辅助即可工作;其更密集的 HDC 使用负位线写入辅助。将选定的位线短暂拉至地电位以下可增加传输门的过驱动电压,使其能在较低的供电电压下克服上拉管。这以牺牲电路复杂性、开关能耗以及必须控制的额外电压应力为代价,换取了密度和低电压下的写入能力。[31], [32]
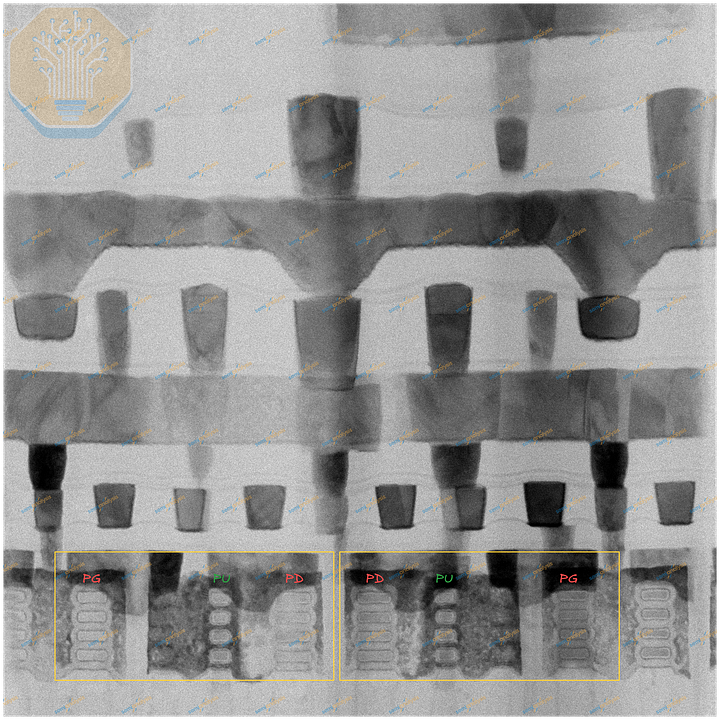
四条矩形纳米带给出的周长 = 8 × (宽度 + 厚度),未考虑圆角处理。PG/PU 为 1.49,PD/PG 为 1.16。
L3 结构在布局和单元高度上与 L2 非常相似。由于可用的高倍率图像较少,因此列出的 L3 纳米片宽度也较少。
DDR PHY
DDR-PHY 以密度为代价换取可控的模拟行为和可靠的片外信号传输。它包含驱动器、接收器、延迟电路和校准逻辑,用于设置驱动强度、采样时间和电压裕量。具有相似宽度的重复四片器件适合使用标准晶体管单元进行匹配和可编程驱动。其较宽的局部布线为电流传输和敏感信号的隔离提供了空间,同时比密集的核心逻辑网格消耗更多面积。该布局既满足了内存总线的电气要求,也兼顾了数字逻辑的密度。[33]
Intel 3 GPU 器件
矢量引擎逻辑
Intel 3 的 XVE 逻辑使用双鳍 PMOS 和 NMOS 器件,电源轨位于 M0 层。其单元高度和 M0 间距给出了七轨道几何结构,比 18A 逻辑多两个轨道。在双鳍器件中也出现了一鳍组。
Intel 3 L2 SRAM
Intel 3 L2 SRAM 使用熟悉的 HCC 尺寸模式:一个 PU 鳍片,两个 PG 鳍片和两个 PD 鳍片。
N3E GPU 器件
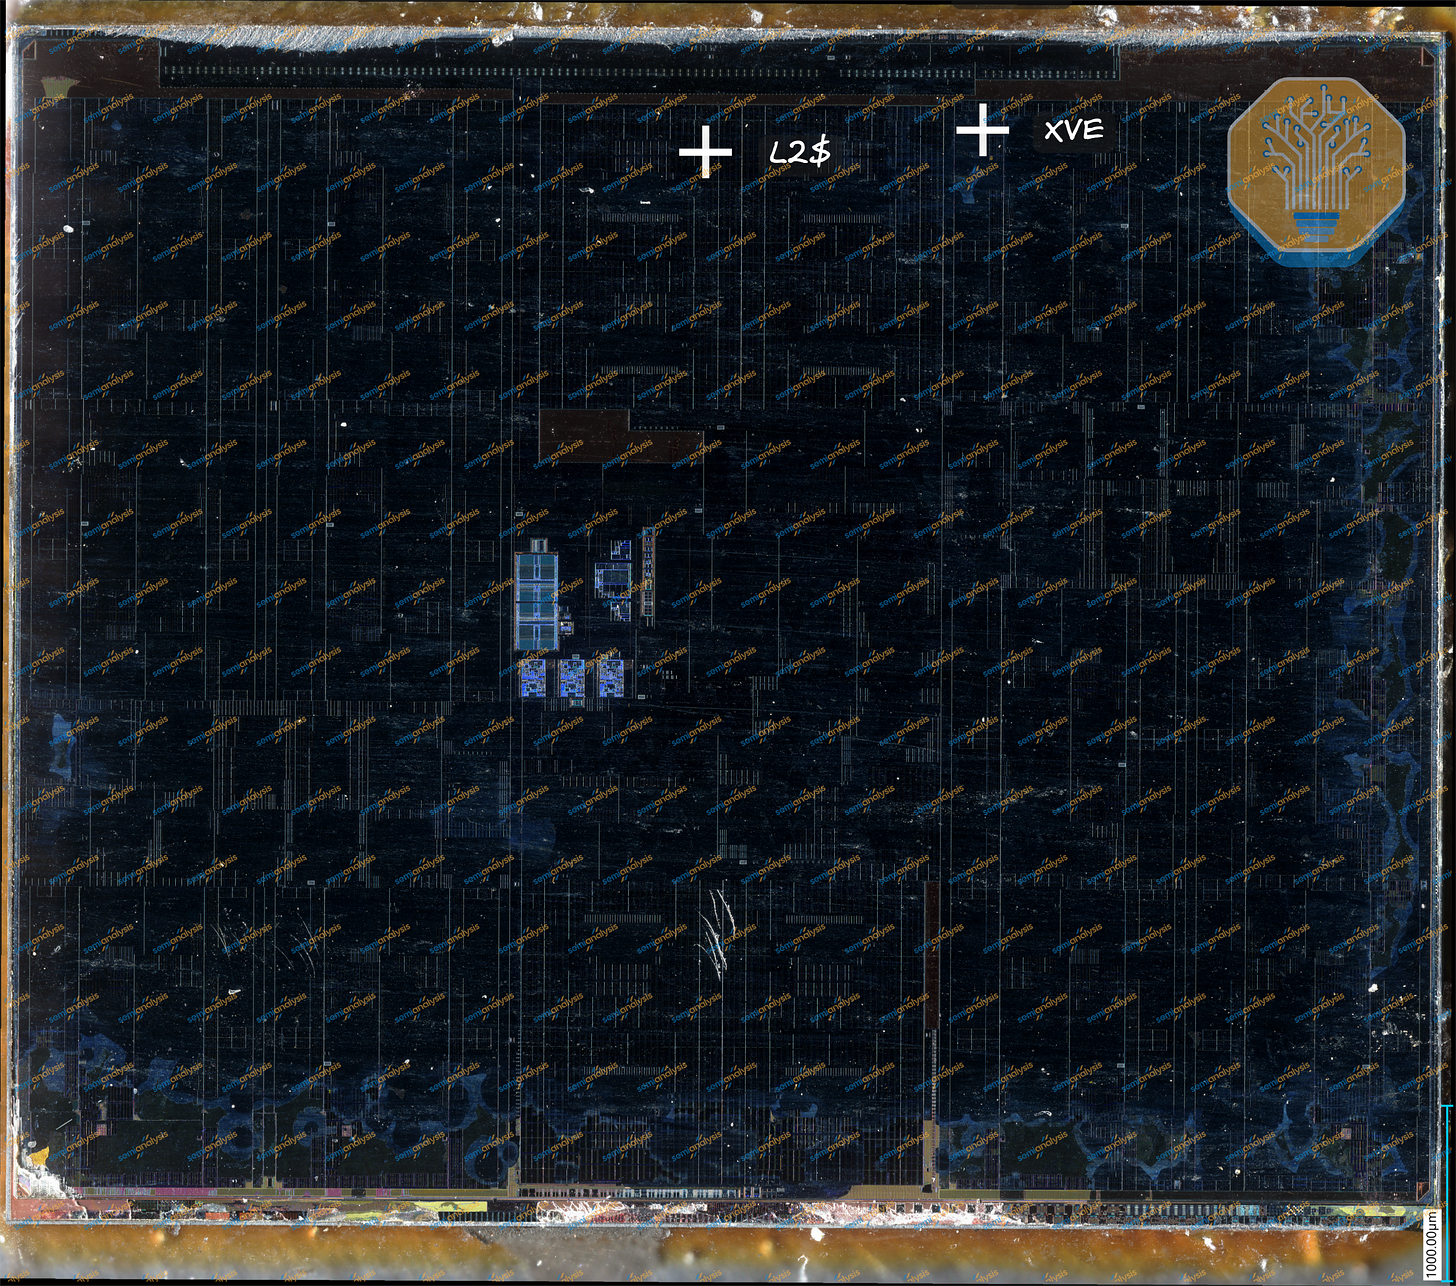
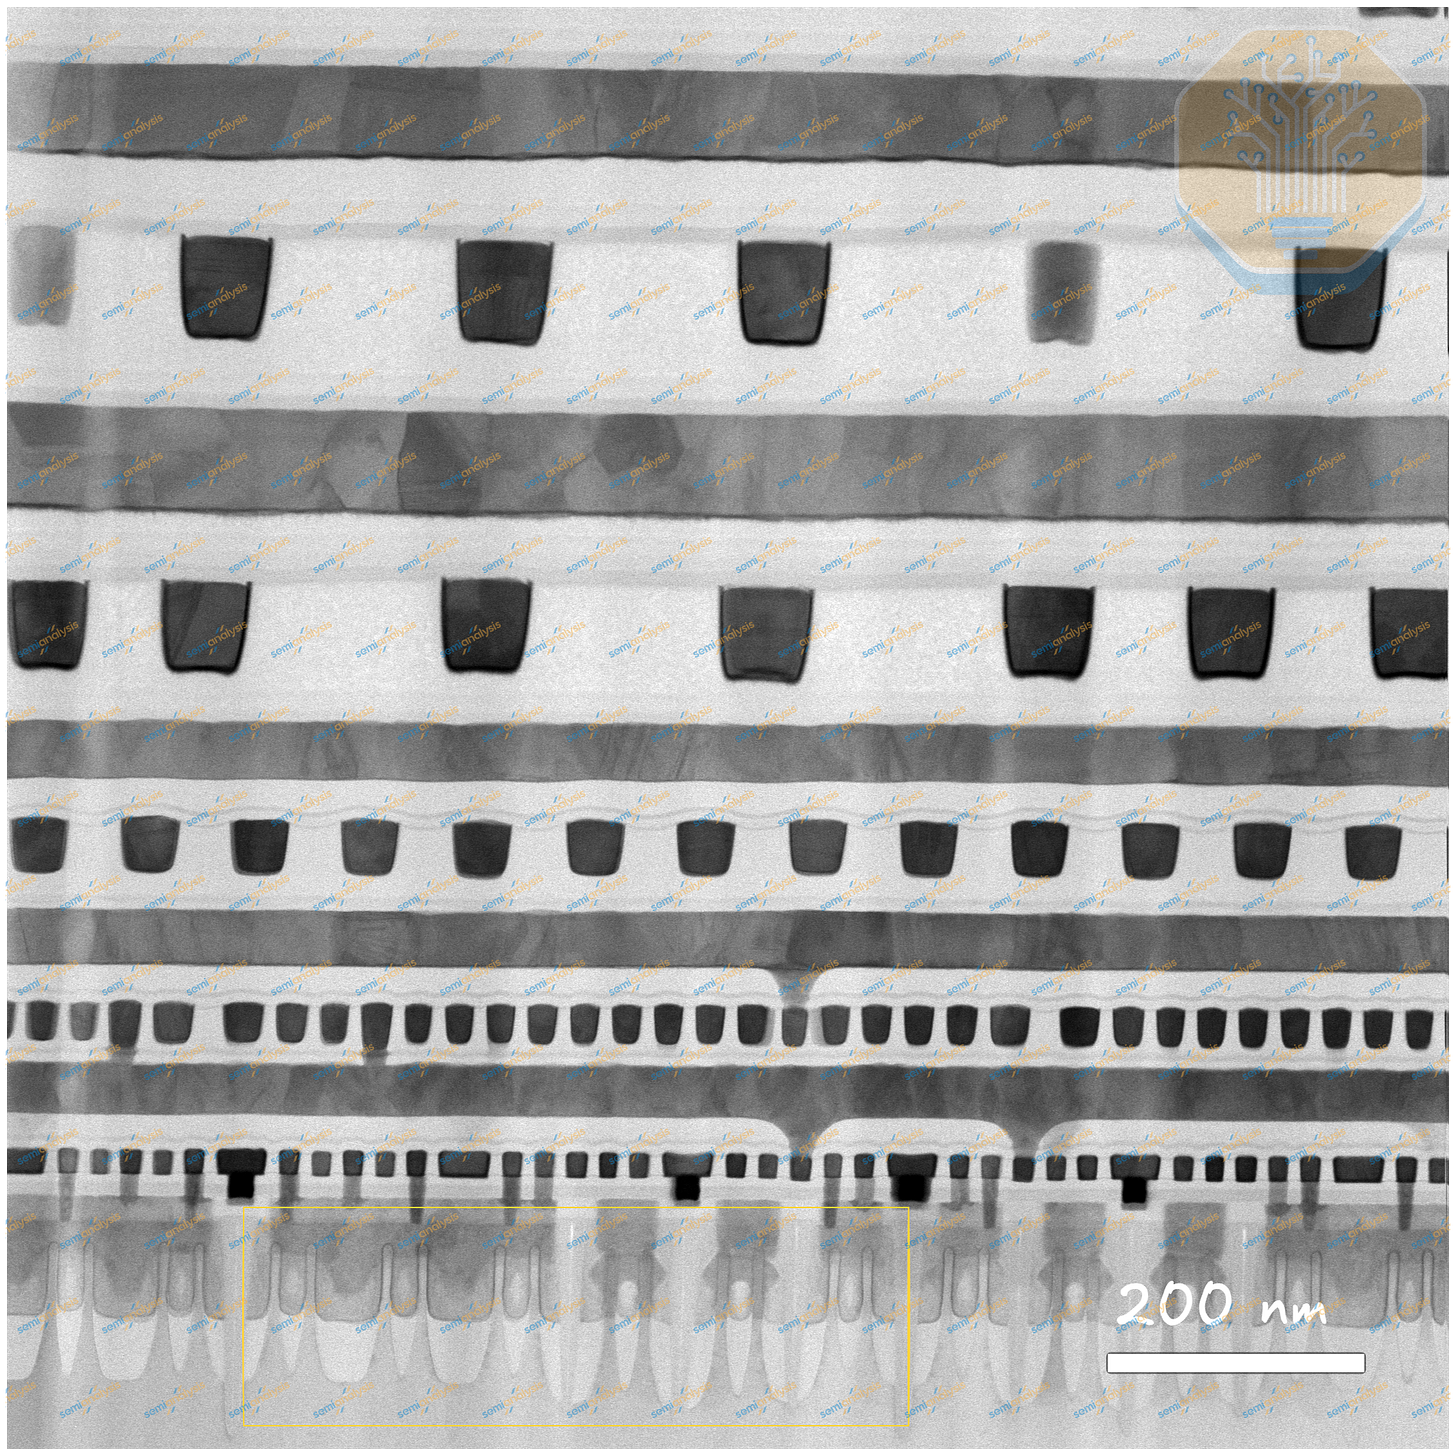
N3E XVE 场包含具有七轨道单元几何结构的重复双鳍器件。N3E 仍然是 FinFET 工艺,这使得 Panther Lake 能够直接进行 FinFET 到 RibbonFET 的比较。
N3E L2 SRAM
N3E L2 SRAM 使用相同的 PU:PG:PD 鳍片数量比 1:2:2。
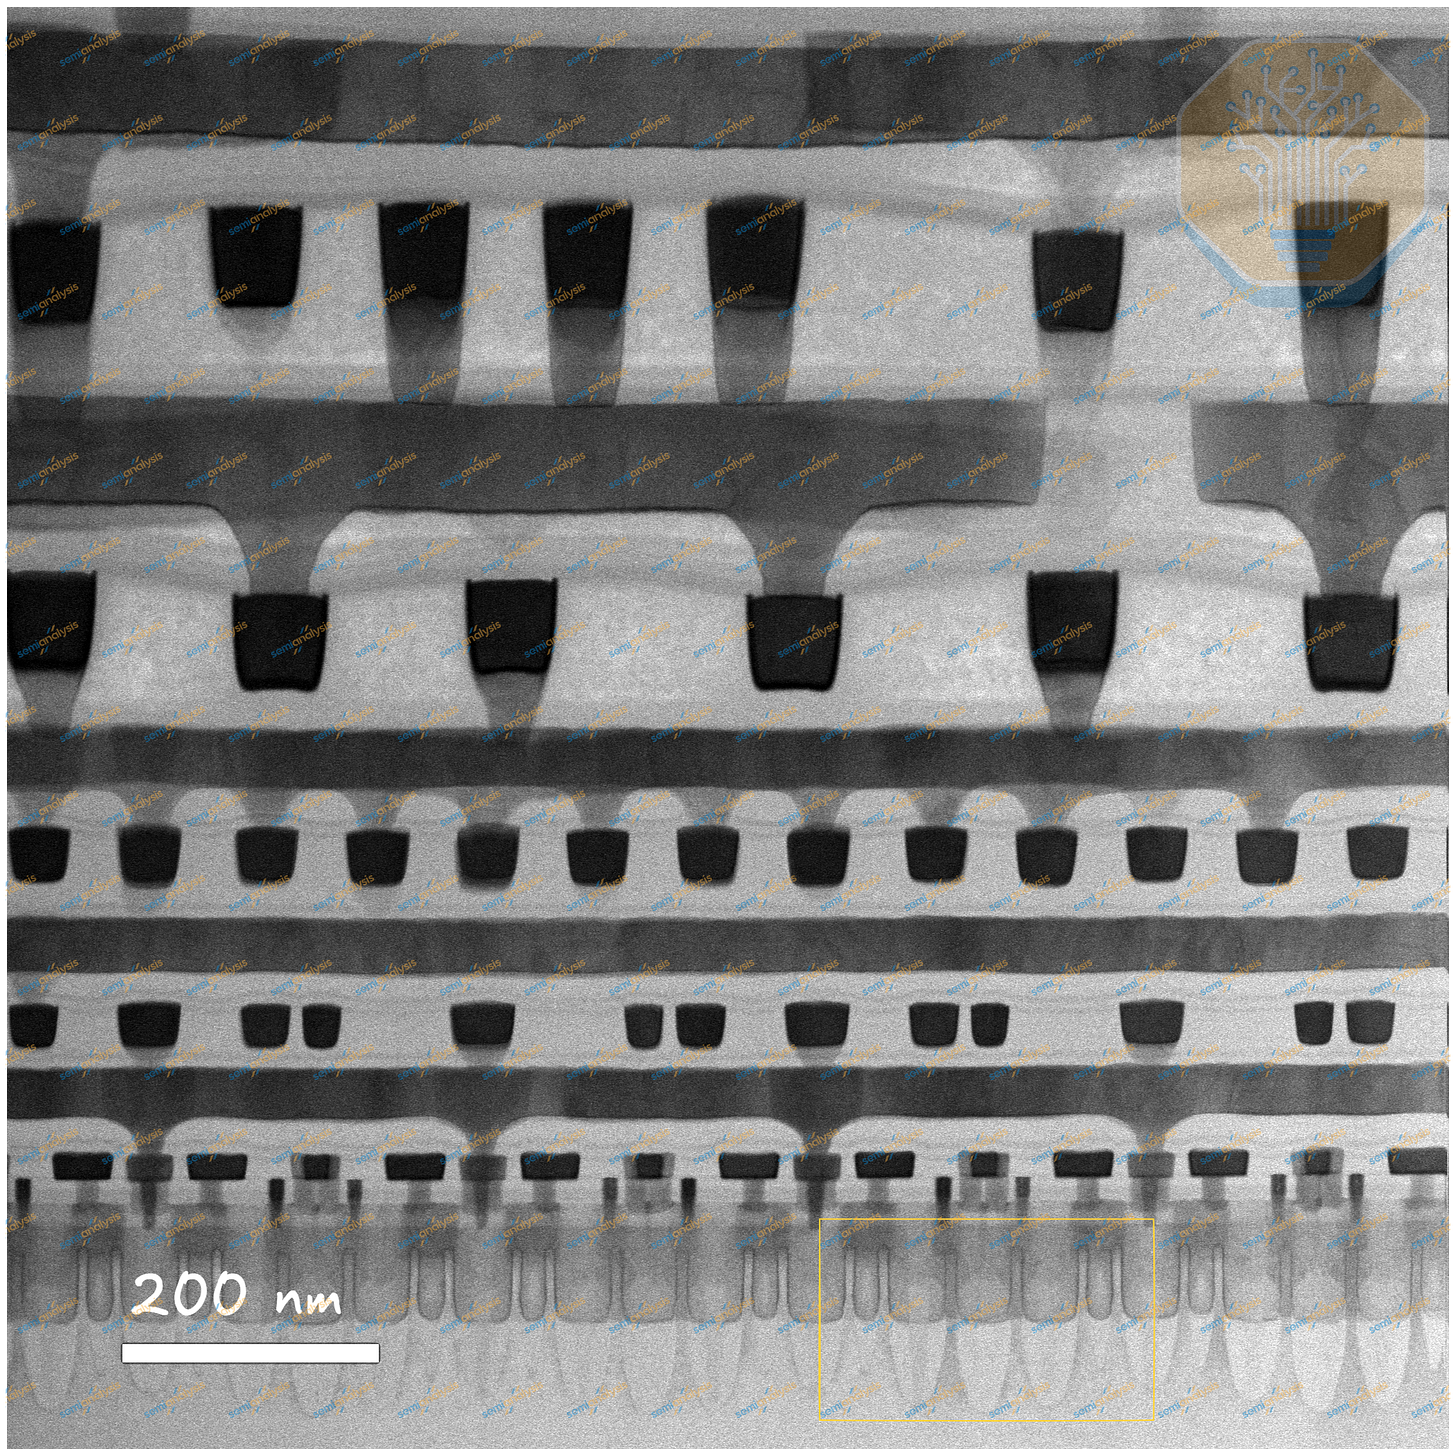
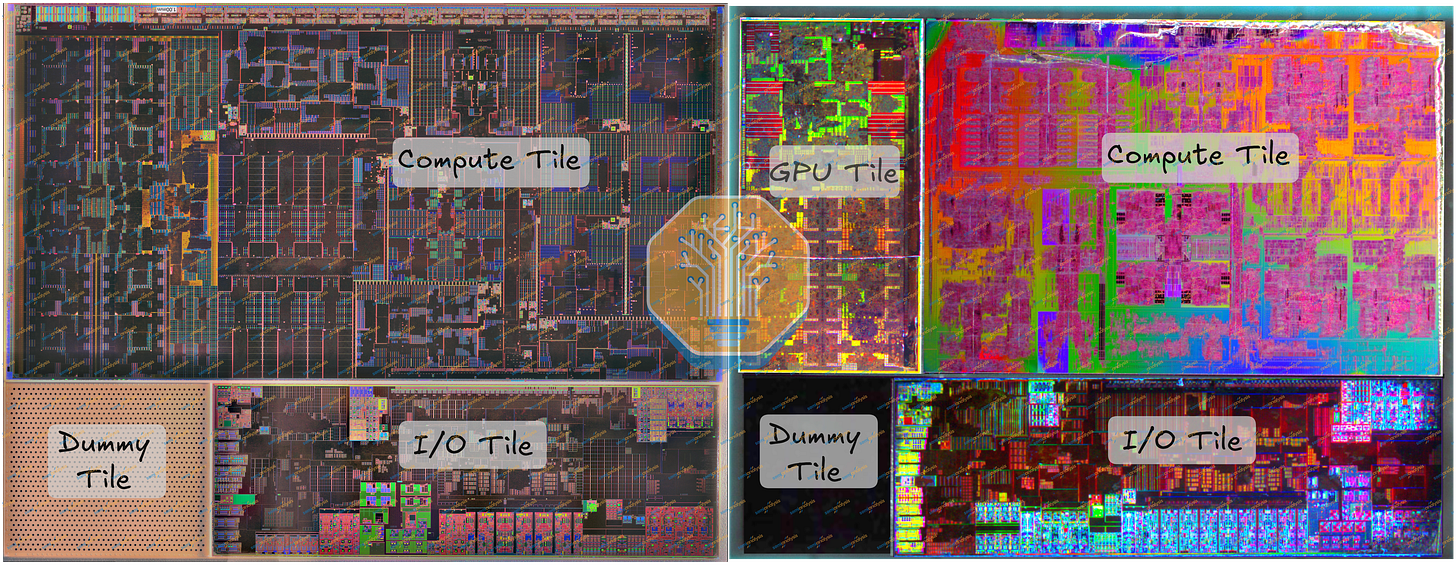
Panther Lake-U 在很大程度上遵循了 Lunar Lake 的平面布局。两者都将 4 个 P 核心与 4 个 LP E 核心以及 NPU、媒体和显示引擎配对,且位置相似。Lunar Lake 也使用 Xe2,这是 Panther Lake 的 Xe3 GPU 的直接前身。这使得 Lunar Lake 成为我们比较的最直接基础。Arrow Lake 在核心数量上有所不同,并使用较旧的 Xe-LPG GPU 架构,因此我们仅在它能提供更直接的组件级比较时才使用它。
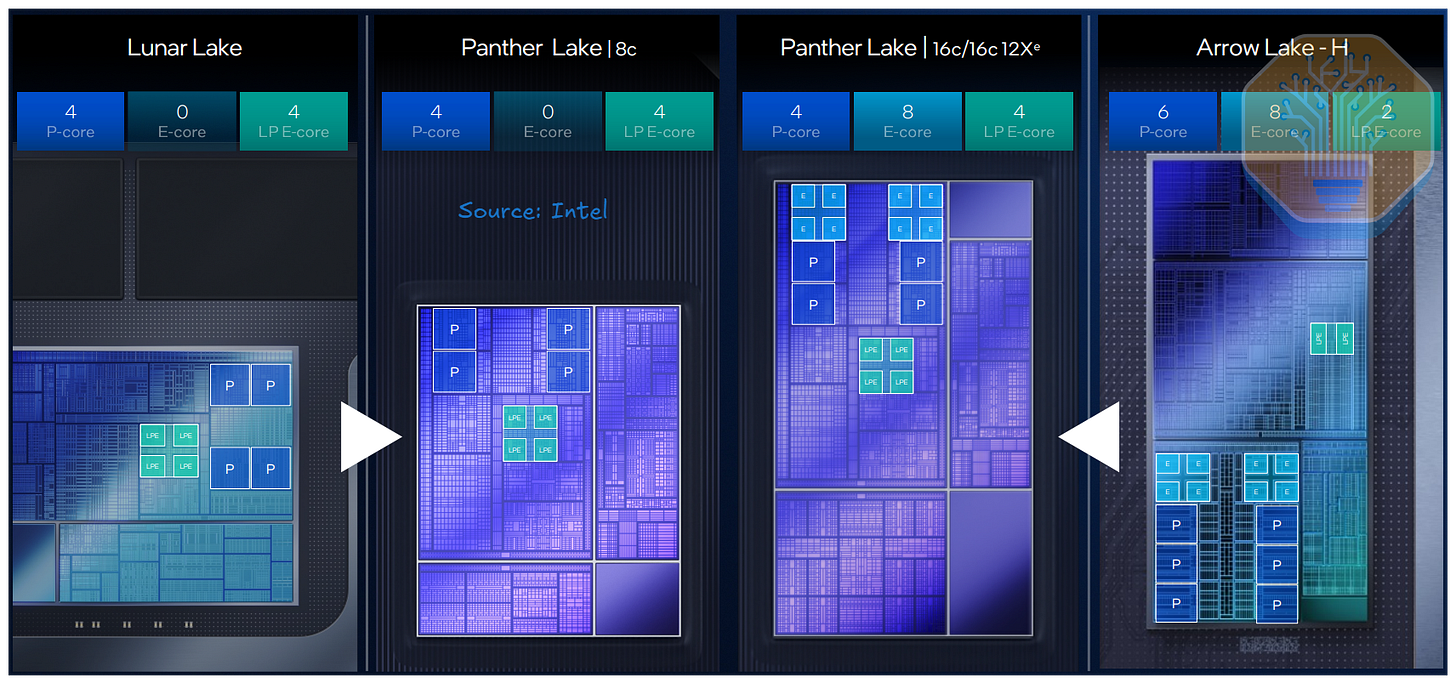
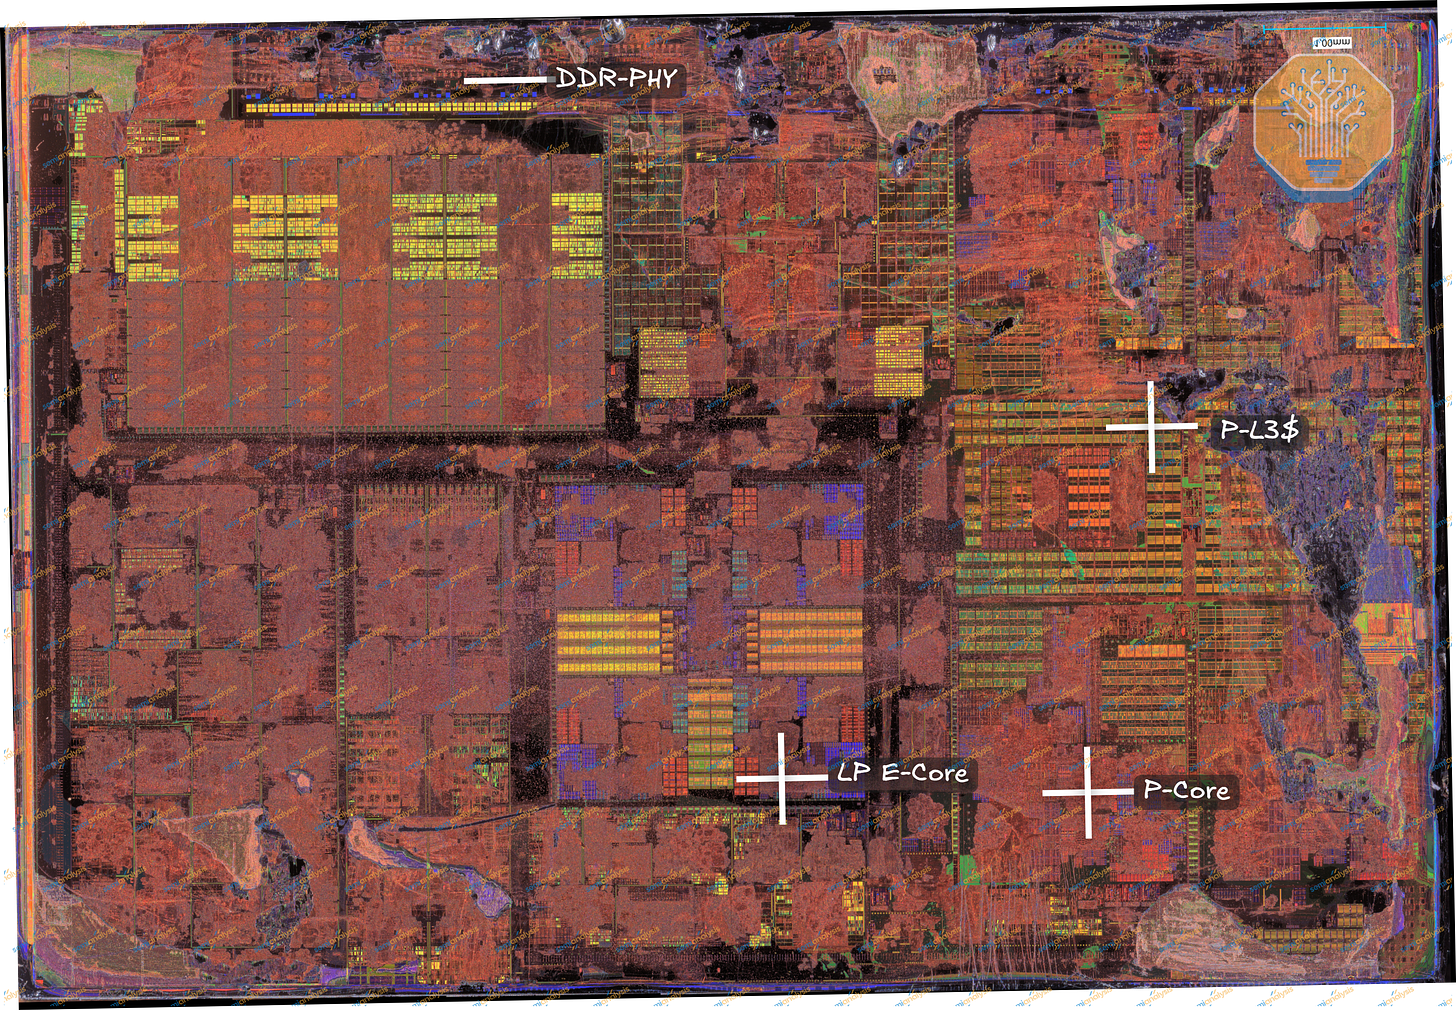
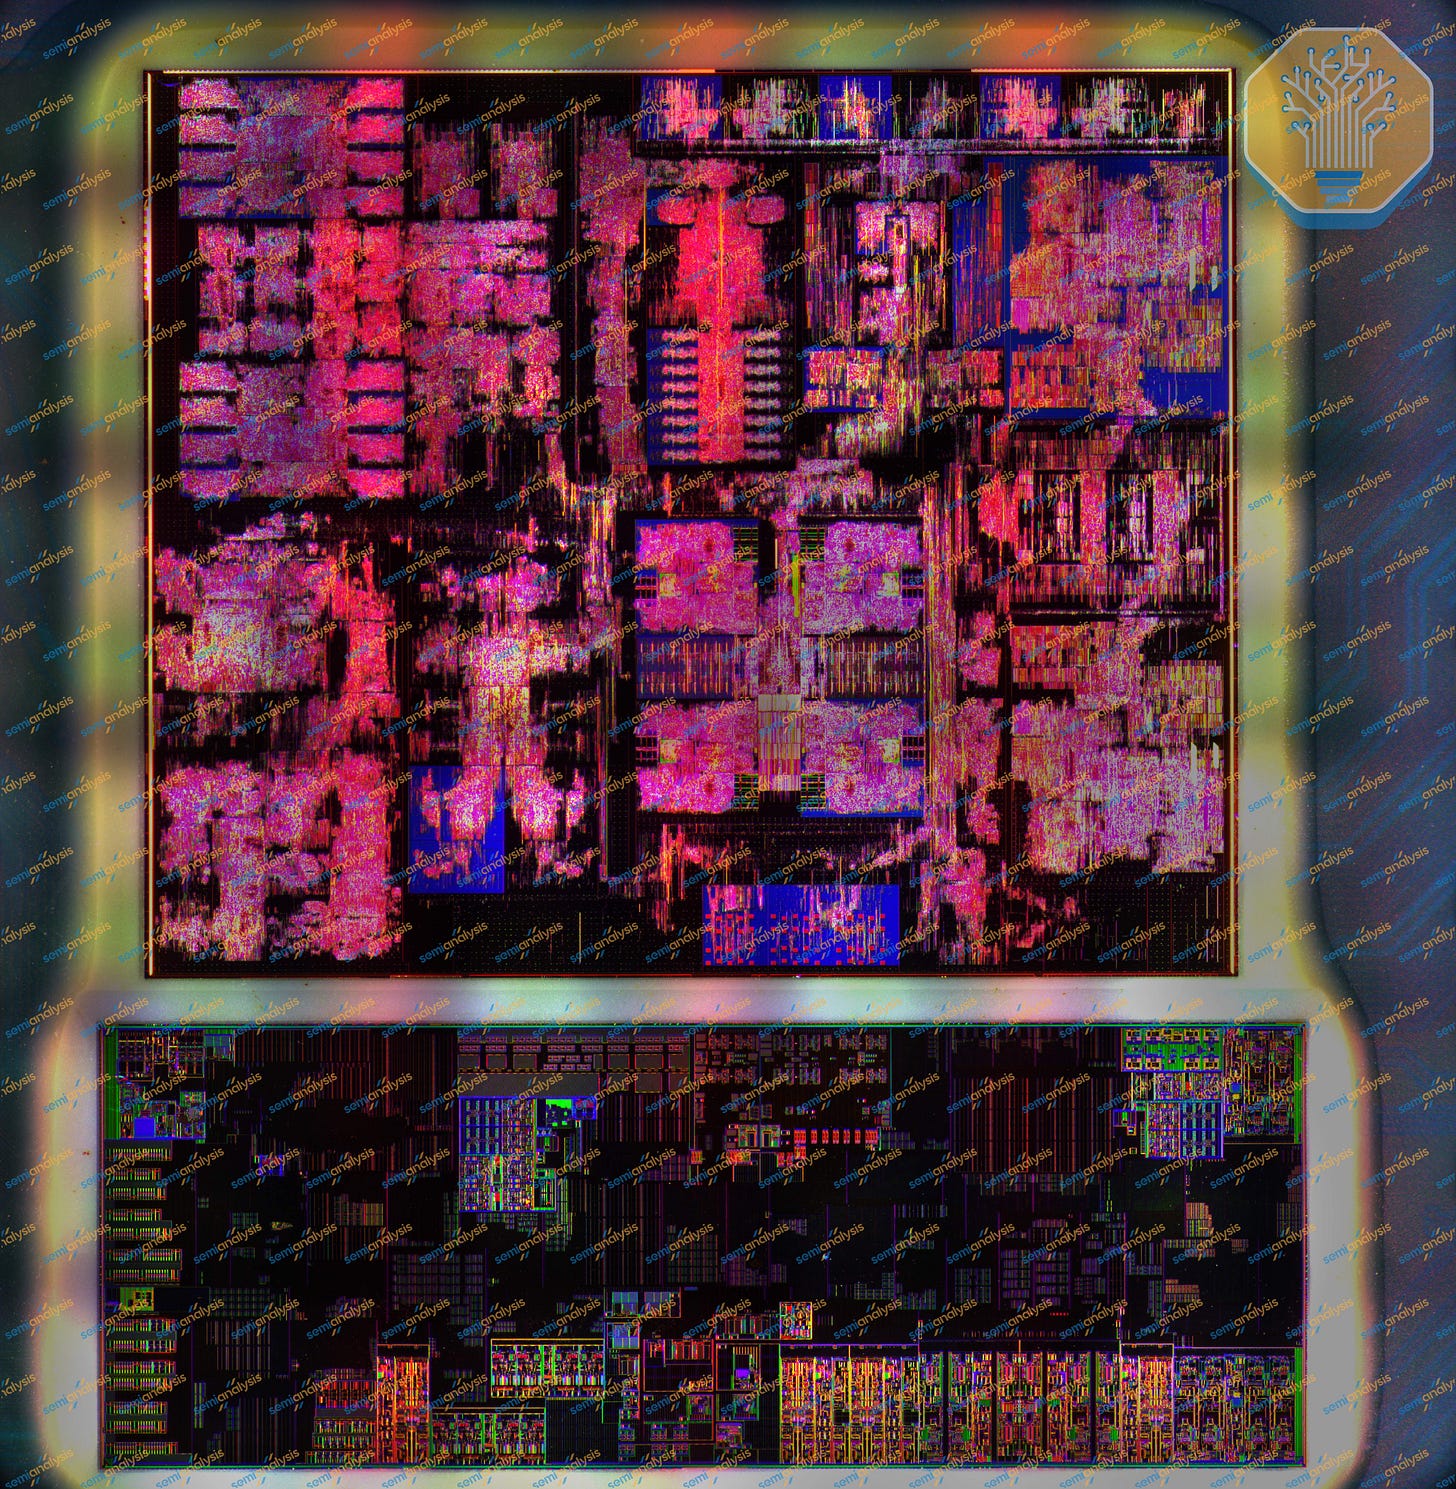
Panther Lake 计算晶圆的布局图在发布数月后仍然稀疏。在能够拍摄清晰的晶体管级布局图之前,必须在不损坏底层结构的情况下移除 Intel 18A 的后侧金属和介电层堆栈。大多数发布的晶圆照片都隐藏或重度处理了背景,但我们对自己取得的晶圆照片成果感到相当自豪,并很高兴展示我们所做的工作。
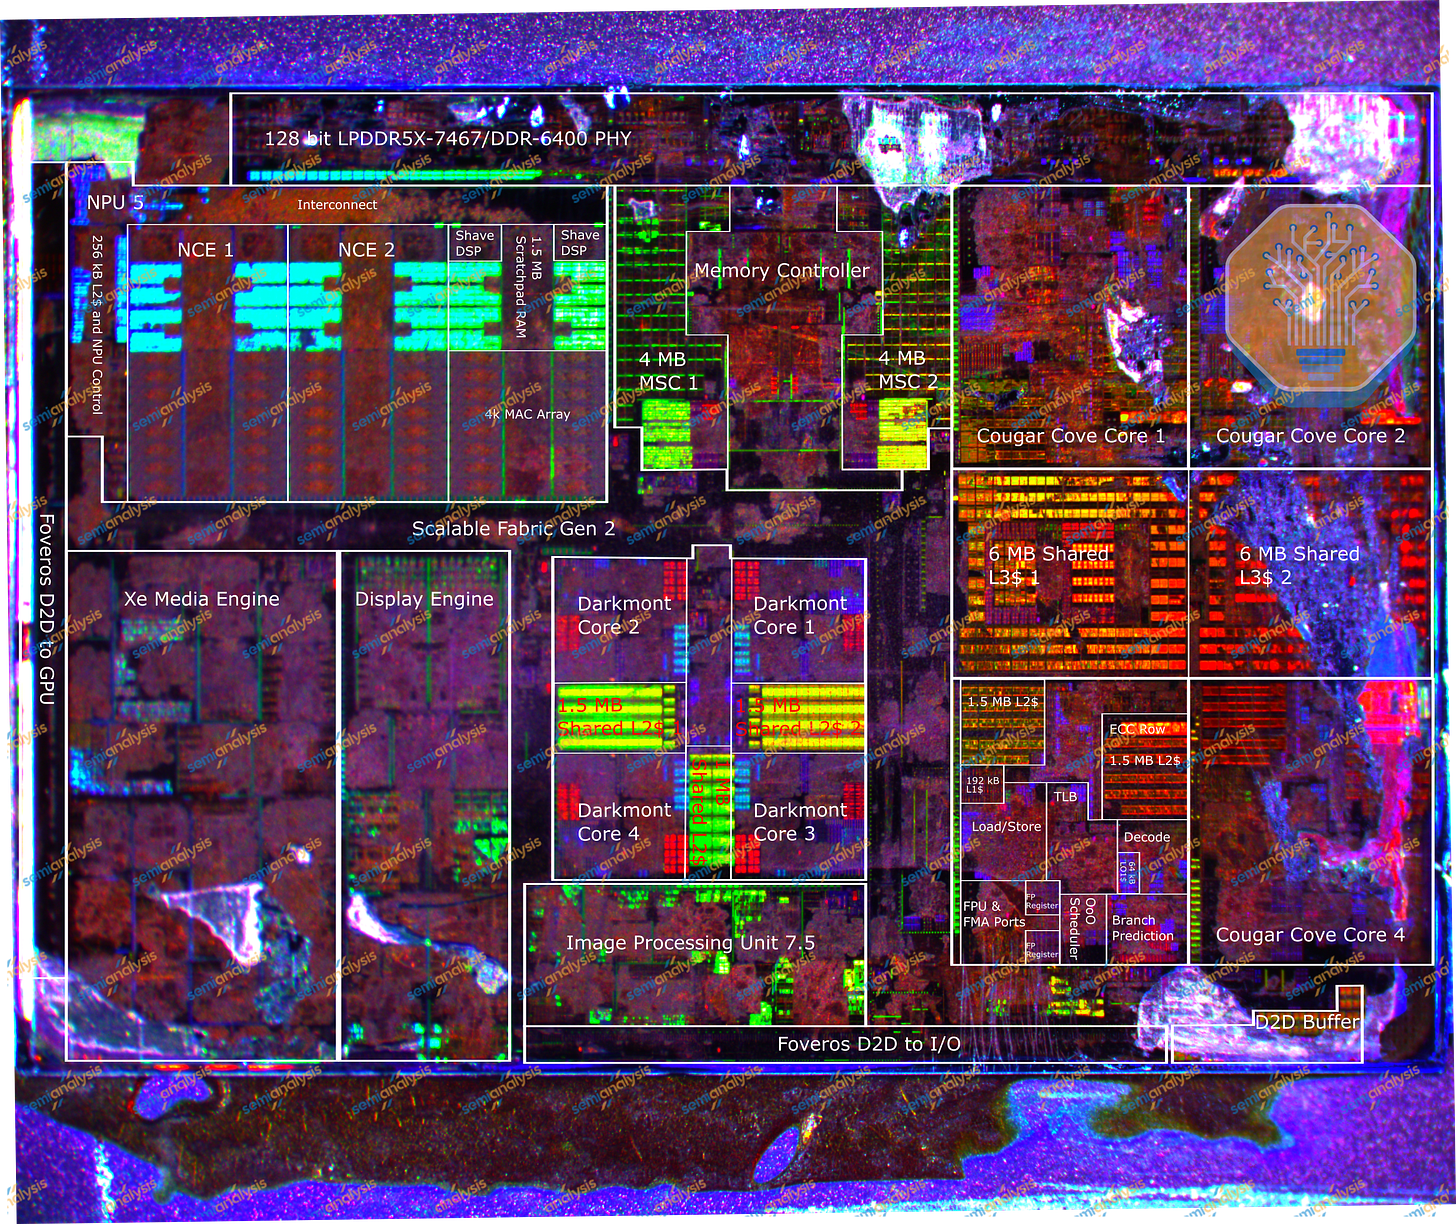
我们测量了计算晶圆上关键组件的面积,并将其与 TSMC N3B 上的 Lunar Lake 前身进行了比较。这有助于我们捕捉区块面积的变化,并在工艺节点和设计之间比较这两款芯片。
我们的总晶圆面积排除了划片槽区域。下面的“计算+GPU”小计使用了 PTL-U 计算晶圆和 GT1 GPU;它不包括 I/O 晶圆和无源基板。各个区块的面积使用布局图上标记的边界。
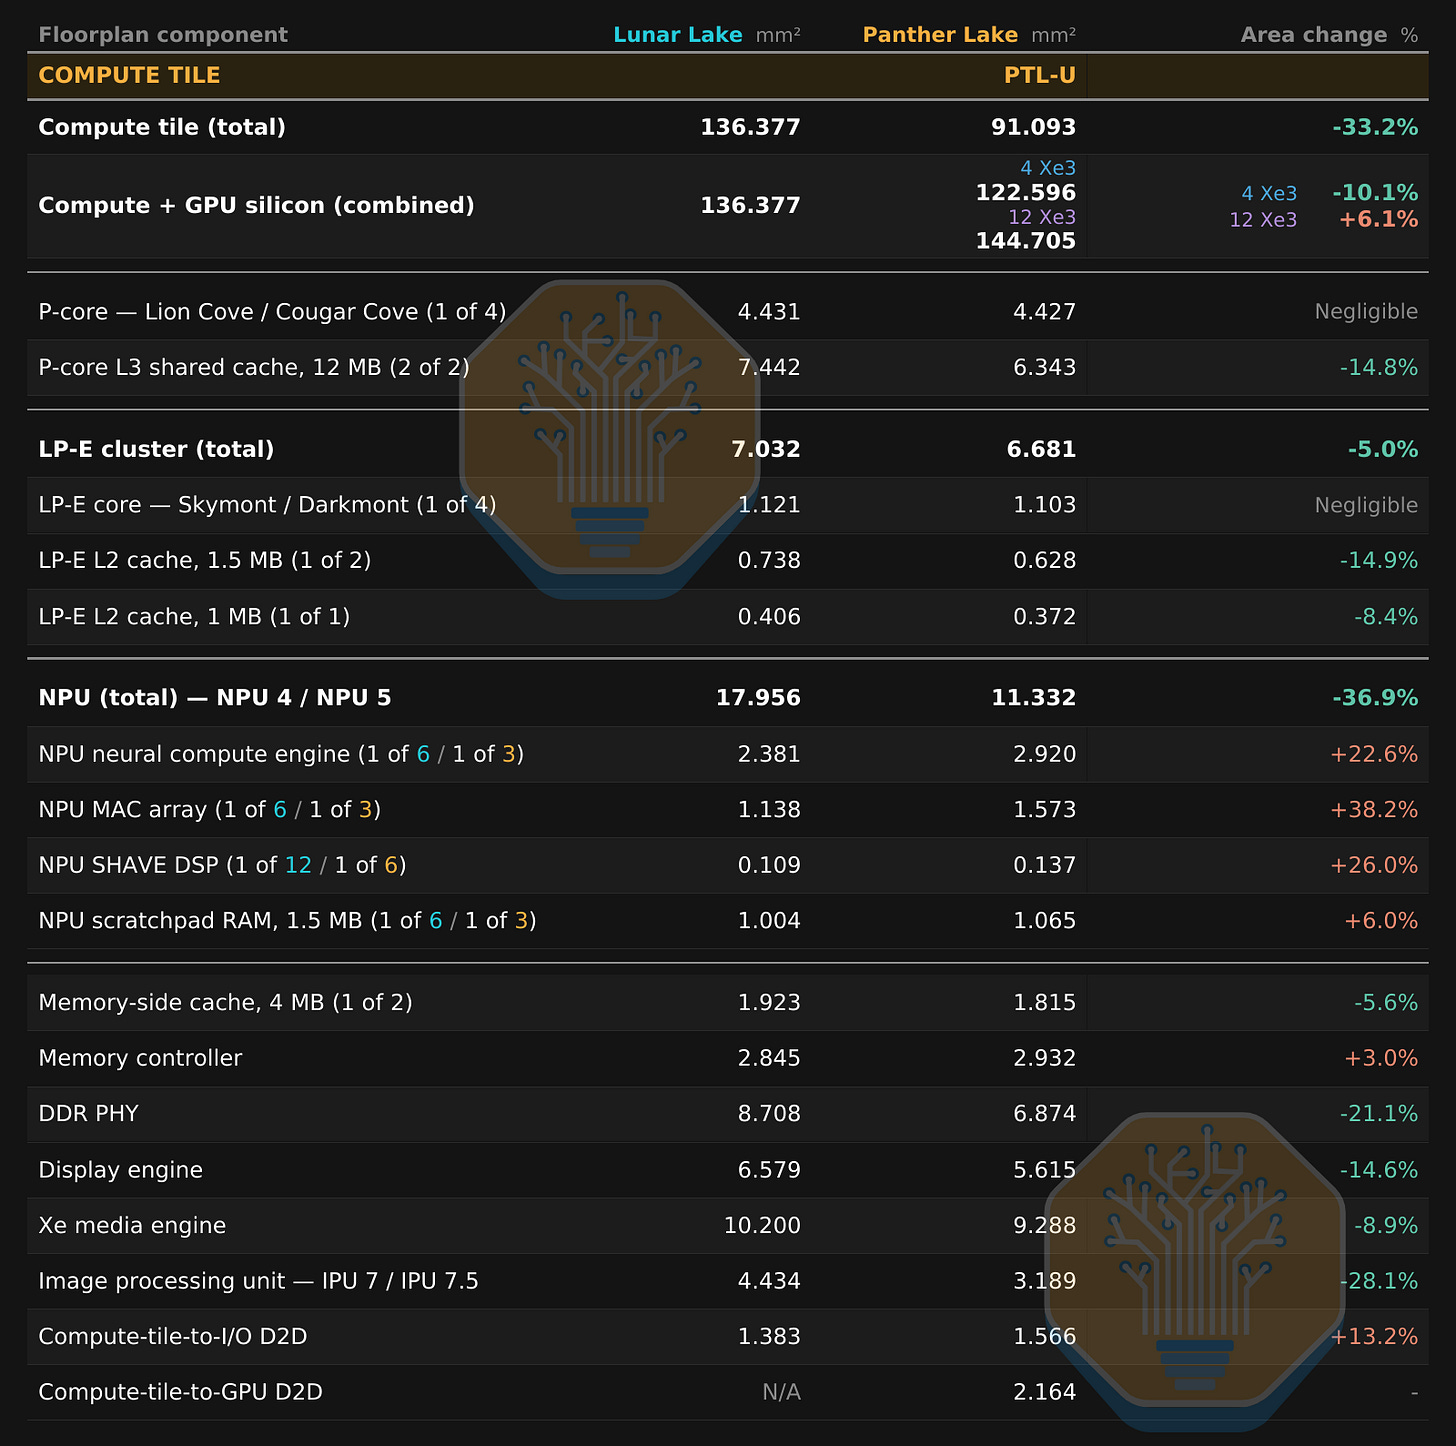
“计算+GPU”行是根据显示的 PTL-U 和 GT1 面积重新计算的。组件行使用其声明的每区域数量,并不是整个晶圆的累加分区。
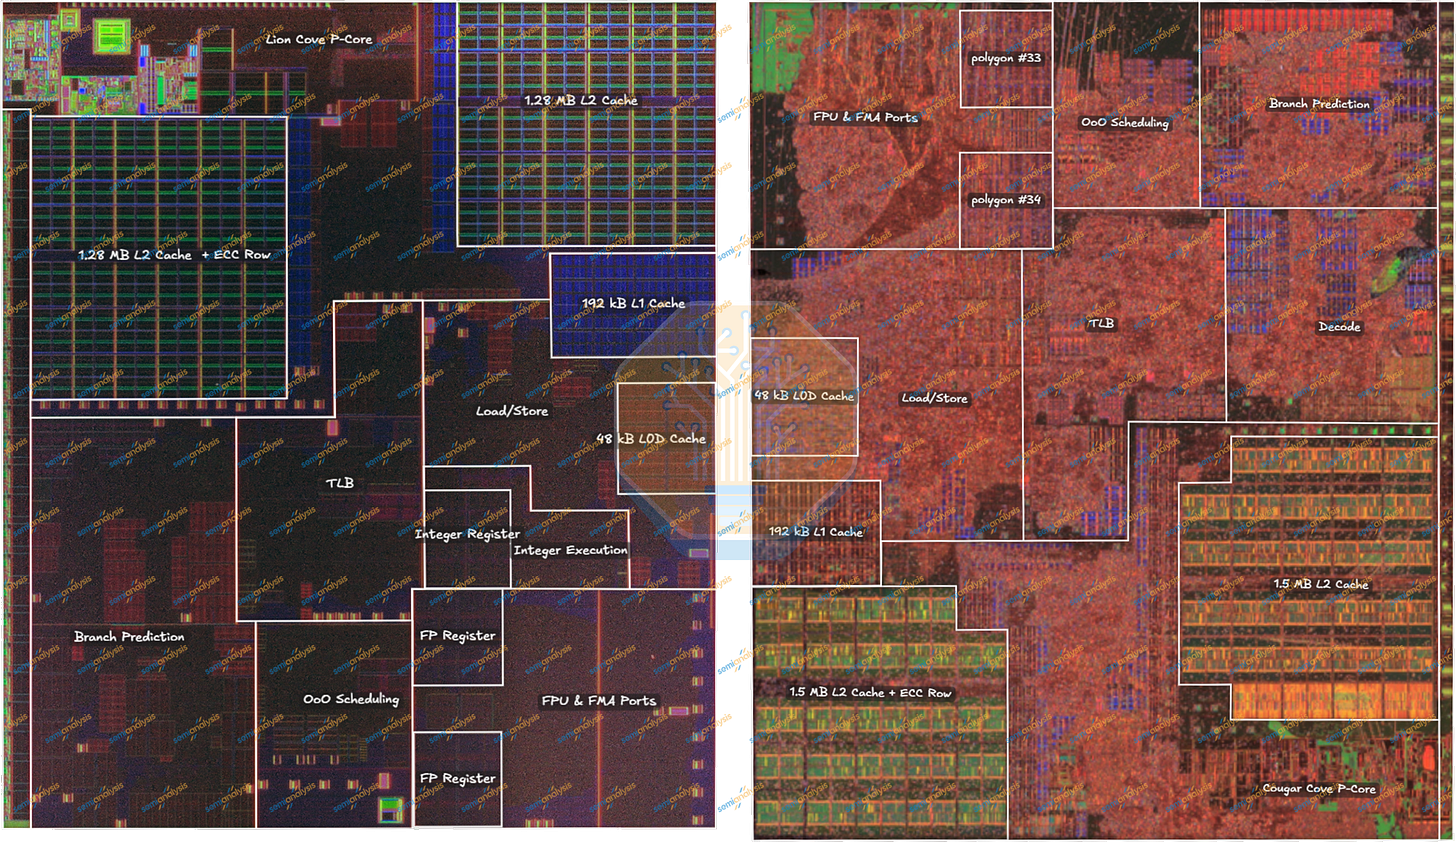
尽管 L2 容量从 2.5 MiB 增加到 3 MiB,但 Lunar Lake 和 Panther Lake 之间的 P-core 面积几乎保持不变。Arrow Lake 使用与 Lunar Lake 相同的 Lion Cove 核心,但也拥有 3 MiB 的 L2。Cougar Cove 在相同的 P-core 面积中容纳了多 20% 的 L2。更大的私有缓存将每个核心的工作集更多地保持在执行单元附近,从而减少了对共享 L3 和 DRAM 的访问。额外的容量会增加存储泄漏和查找能耗,因此设计师需要在避免较低层级访问的收益与之之间取得平衡。共享的 P-core L3 缓存也缩小了 14.8%。[2]
Cougar Cove 结合了相似的占地面积与英特尔报告的能效改进。RibbonFET 更紧密的沟道控制减少了泄漏,而 PowerVia 减少了供电电压跌落并允许更紧密的电压保护带。[1]
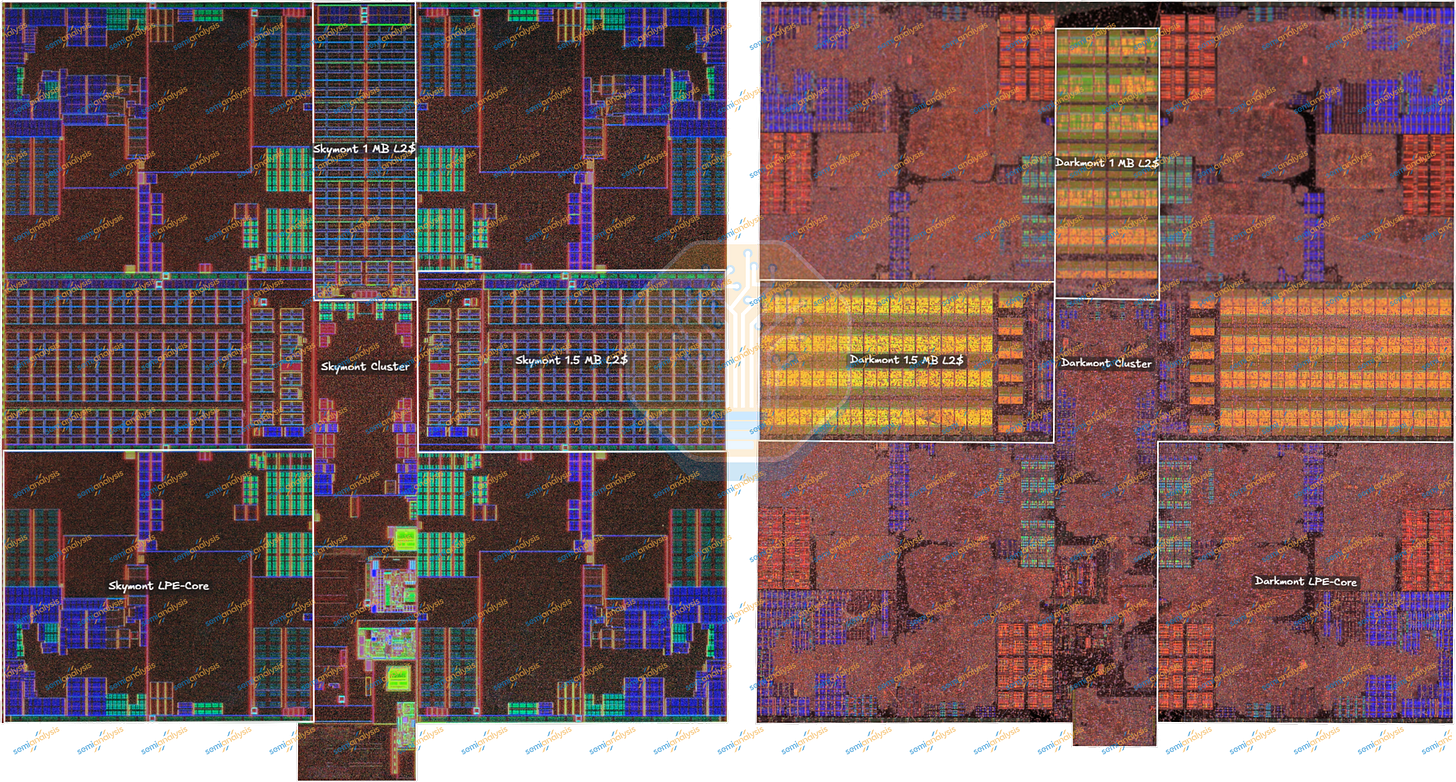
Darkmont 的四核低功耗 E-core 集群比 Lunar Lake 上的 Skymont 小 5.0%,大部分缩减发生在其 L2 区域。1 MiB 区域缩小了 8.4%,1.5 MiB 区域缩小了 14.9%。标签阵列也少了一行可见的行。标签用于识别数据阵列持有的内存地址,因此重新排列它们会改变缓存的布局和布线,而不需要减少数据容量。[2]
低功耗 E-core 共享一个 L2。这池化了容量并避免了复制所有缓存机制,但这四个核心竞争其存储库和带宽。它们独立的集群也将轻量级工作远离性能集群及其 L3,允许该较大的域进入睡眠状态。[1], [2]
缓存面积不仅包括存储单元。标签标识每一行,解码器选择行,灵敏放大器读取微小的位线信号,导线连接到存储库。将阵列分割成较小的部分可以缩短字线和位线,提高访问速度,但会复制外围电路。因此,Panther Lake 较小的缓存区域反映了完整的内存实现,包括每个区域中有多少专用于存储。[34]
与 Meteor Lake 和 Arrow Lake 不同,Panther Lake 没有单独的 SoC 晶圆。NPU、低功耗 E-core、内存控制器、PHY、媒体和显示引擎现在共享计算晶圆。这移除了一个有源晶圆,并将 CPU 内存流量保留在一个晶圆上。代价是将 PHY 和 I/O 相关电路移至 18A:驱动器、接收器和模拟电路仍必须满足外部电压、负载和信号完整性要求,因此它们的面积不会像密集数字逻辑那样缩小。[1], [2]
最大的面积缩减来自 NPU,其面积减少了 36.9%。NPU 5 将相同的 INT8 MAC 总数整合到数量减半的神经计算引擎中。三个 NCE 中的每一个都拥有更大的 MAC 阵列,使得完整的 NCE 包比 NPU 4 引擎大 22.6%。整合还将暂存器和 SHAVE DSP 的数量从 12 个减少到 6 个。MAC 阵列处理矩阵乘法和卷积,而 SHAVE 执行不适合该阵列的向量和自定义操作。[1], [2], [35]
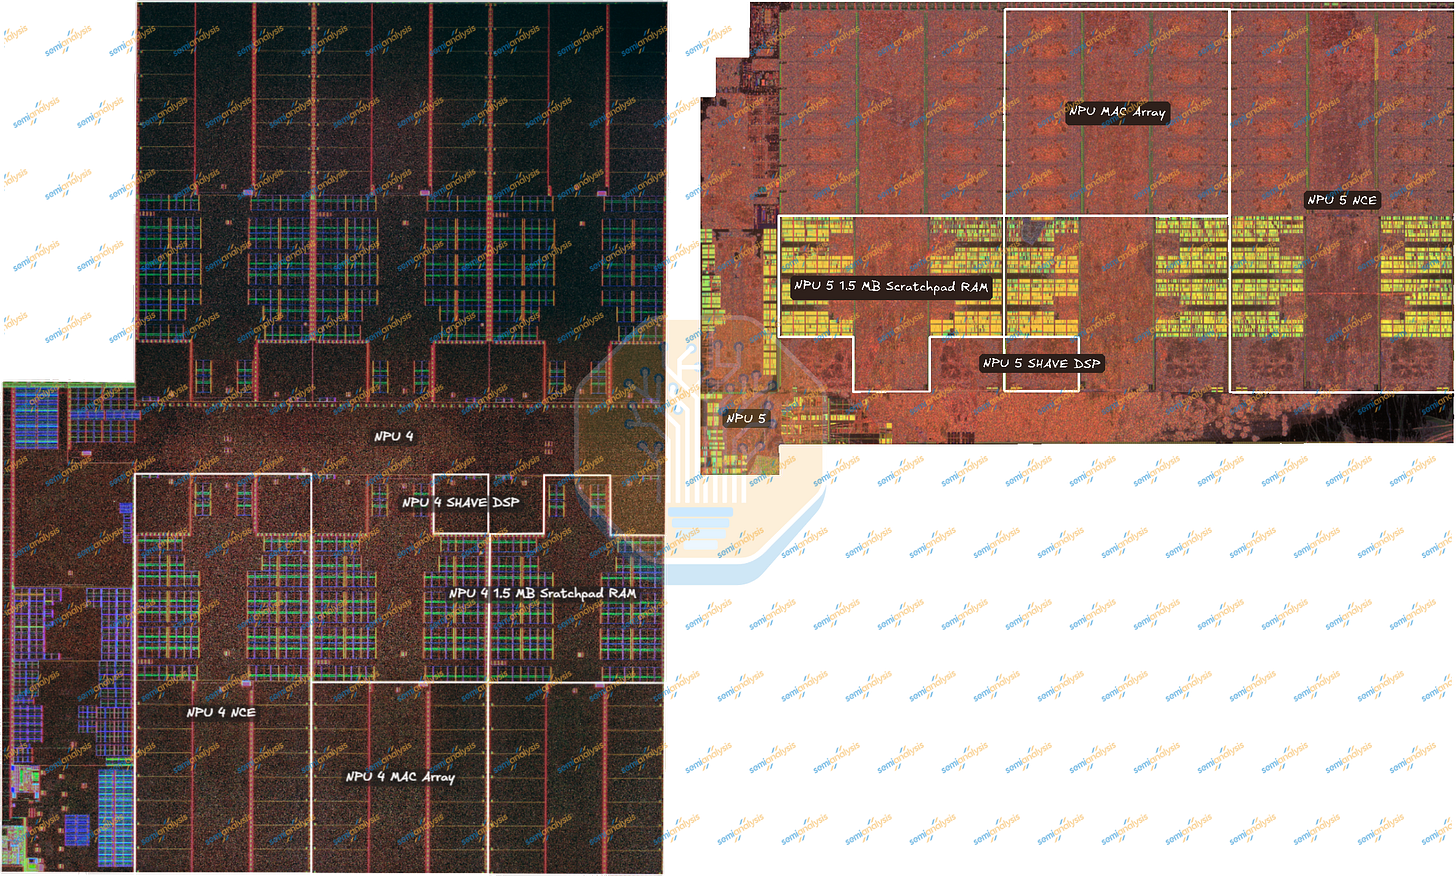
配对的版图标识了每个 NCE 包及其暂存器、MAC 和 SHAVE 区域。在下面的面积统计中,每个测量的 MAC 多边形在每个 NCE 中只计一次。
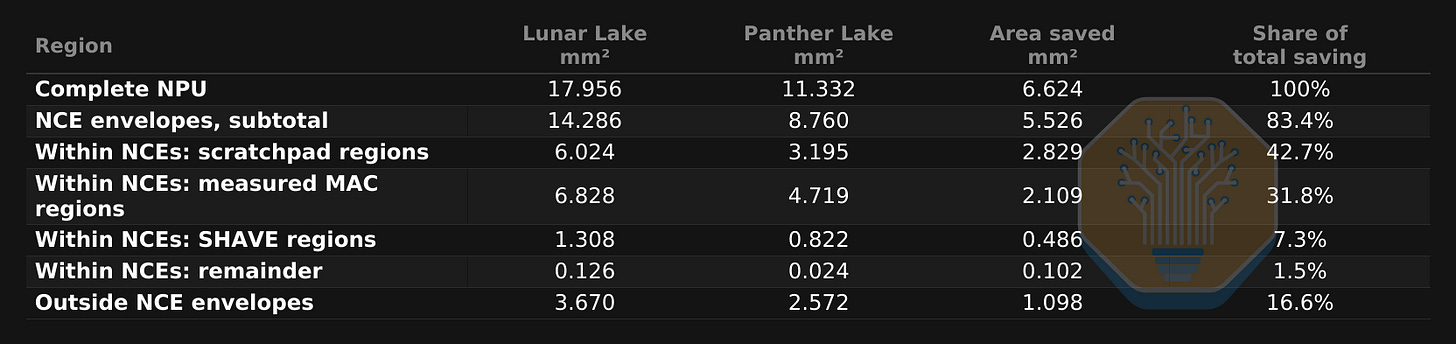
暂存器将权重、激活值和中间结果存储在 MAC 阵列附近,允许重复使用而无需再次从 DRAM 获取。将其数量减半带来了最大的测量面积节省,但在相同的总 MAC 计数下留下了更少的本地存储。无法在本地容纳的层需要更小的工作图块或更多的中间数据传输。其好处取决于在管理更紧张的存储预算的同时保持扩大的阵列处于忙碌状态。[36]
NPU 5 还增加了原生 FP8 支持。使用 FP16 一半的操作数宽度降低了存储和传输需求,有助于工作负载适应更小的本地内存预算。较低的精度和依赖于格式的取值范围使得缩放和模型验证成为部署的一部分。硬件激活函数进一步减少了原本会占用可编程 DSP 的工作量。[1], [2]
微软要求 Copilot+ PC 的 NPU 至少提供 40 TOPS 的性能。Lunar Lake 和 Panther Lake 均达到这一阈值,但 Panther Lake 使用的硅片面积显著更少。
GPU 图块
Panther Lake 是英特尔首款采用 Xe3 架构的产品,这是其最新的 GPU 架构。它提供两种不同的 GPU 图块:基于 Intel 3 工艺、包含 4 个 Xe3 核心的较小 GT1 图块,以及基于台积电 N3E 工艺、包含 12 个 Xe3 核心的较大 GT2 图块。
Panther Lake 让我们能够比较同一 GPU 架构在 Intel 3 和台积电 N3E 上的表现。Wildcat Lake 在 Intel 18A 上增加了第三种 Xe3 实现。未来的通讯简报将详细介绍 Xe3 及其在所有三个工艺节点上的实现差异。
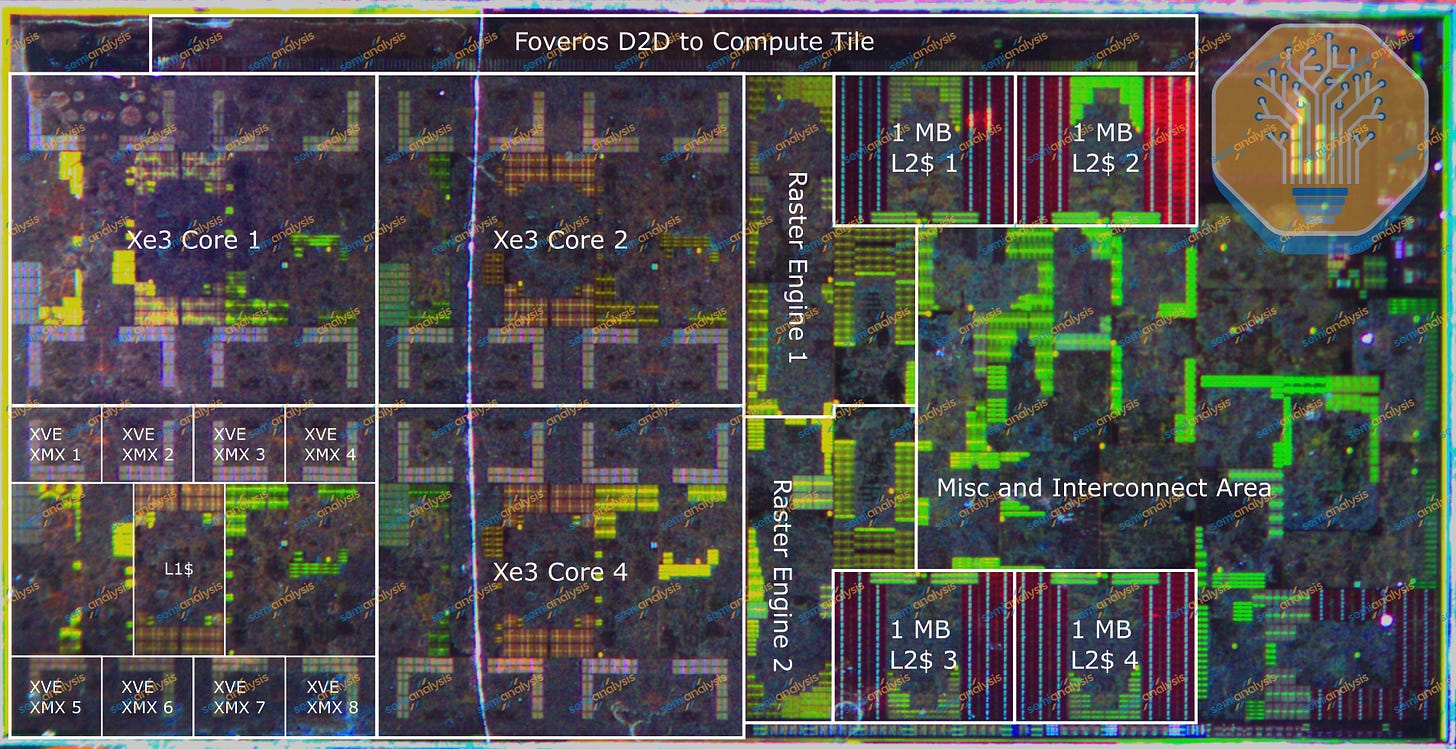

GT2 将 Xe3 扩展到不同的物理布局,渲染切片垂直排列,而不是 GT1 的水平排列。切片的放置决定了到共享缓存库和 D2D 接口的距离。这些导线消耗面积并增加延迟,因此扩展 Xe 核心的数量也需要重新平衡缓存放置、布线和时序。[1]
显而易见的是,台积电 N3E 上的 GT2 图块中的 Xe 核心比 GT1 小得多。这些区块面积包括逻辑电路、缓存和布线。
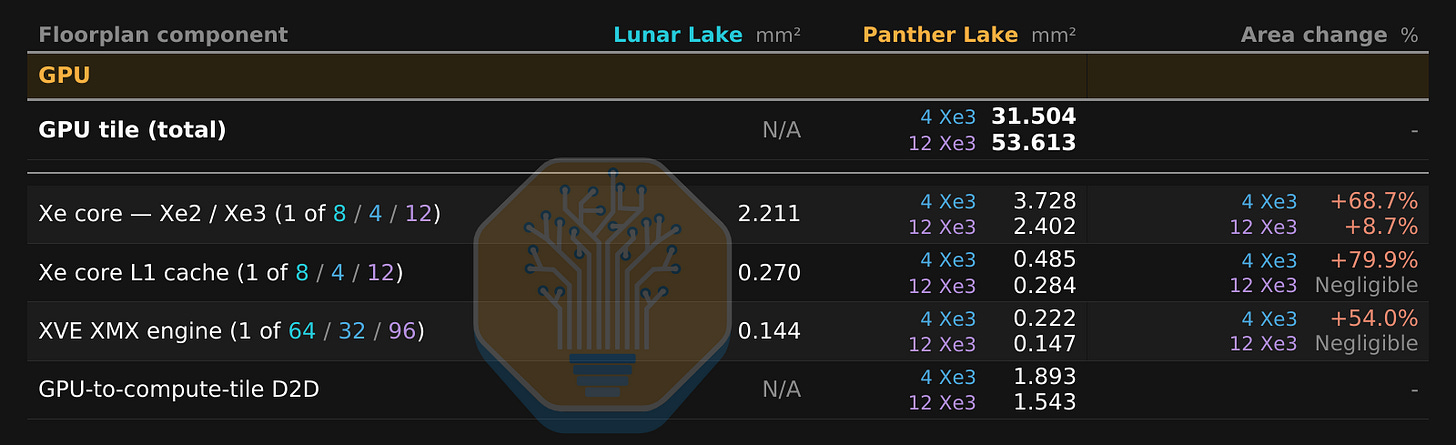
GT1 图块上的 Xe 核心比 Lunar Lake 上的核心大约大 69%,比 GT2 上的核心大约大 55%。因此,Intel 3 在每个 Xe 核心上使用了 substantially 更多的面积。区块面积的差距超过了测量的逻辑和 SRAM 密度差距,将布线、时序目标、单元混合和版图分配纳入比较之中。
Lunar Lake 和 Panther Lake 的 GT2 图块之间,测量的向量/矩阵引擎区域几乎未变。Xe3 在每个核心中保留了八个 512 位向量引擎和八个 2048 位 XMX 引擎。其增益还来自于更有效地为这些引擎提供数据:更多的驻留线程隐藏了停顿,而可变寄存器分配允许着色器在线程间交换寄存器与保持活跃的线程数量。[1]
共享 L1/SLM 容量从 192 KiB 增加到 256 KiB,增幅为 33%,而其面积仅增加了 5%,有效密度提高了 27%。L1 保留重用的缓存行,而软件管理的 SLM 允许线程组在本地共享数据。两者都减少了对更远内存的访问流量。为每组分配更多的 SLM 也可以限制同时驻留在一个核心上的组数。[1], [37]
GT1 模块配备 4 MiB L2 缓存,而 GT2 模块则为 16 MiB。GT1 将其 L2 缓存划分为四个 1 MiB 的存储体(bank),而 GT2 使用八个 2 MiB 的存储体。每个存储体包含 128 个宏单元,但 N3E 宏单元的容量为 16 KiB,是 Intel 3 工艺宏单元 8 KiB 容量的两倍。N3E 宏单元的尺寸仅增大了 54%,却容纳了两倍的位数,从而实现了 30% 更高的密度:约为 23.7 Mbit/mm²,而 Intel 3 工艺为 18.3 Mbit/mm²。计入存储体级电路后,差距进一步扩大,GT2 约为 16.9 Mbit/mm²,而 GT1 仅为 10.4 Mbit/mm²。
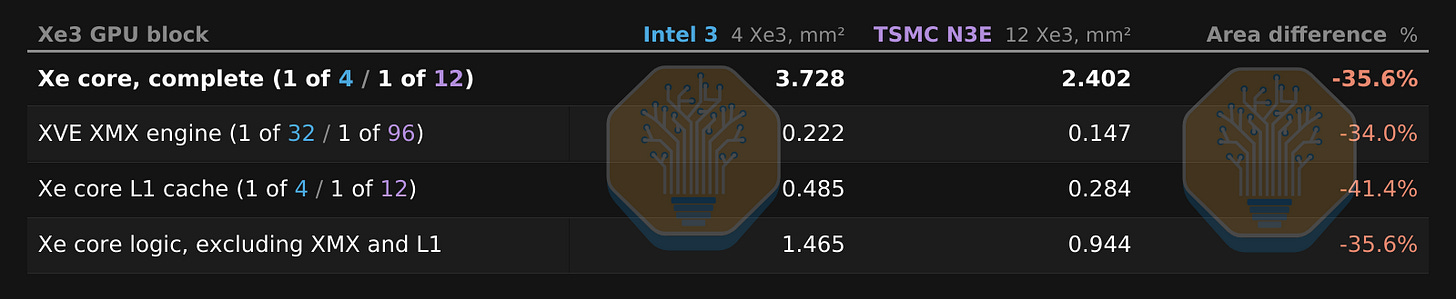
GT2 通过其宏单元在单位面积内存储更多位来提升密度,且这些宏单元占据了每个缓存存储体的更大比例。较大的宏单元将解码器和灵敏放大器的开销分摊到更多的存储空间上,而更紧凑的存储体布局则减少了用于控制和布线的比例。这种权衡导致字线和位线更长,从而带来更大的电容。[34]
I/O 模块
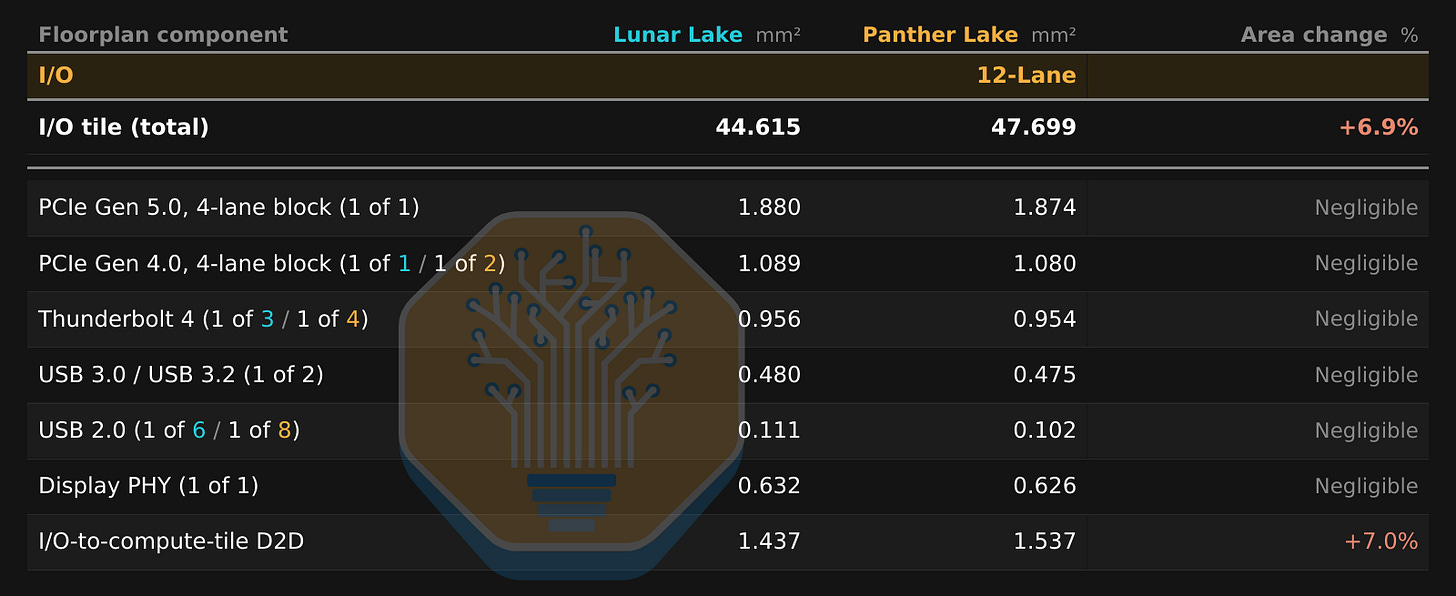
Panther Lake 采用两种 I/O 模块变体,均在 TSMC N6 工艺上制造。较小的变体提供 4 条 PCIe 5.0 和 8 条 PCIe 4.0 通道,服务于低端系统以及没有独立显卡的系统;较大的变体额外增加了 8 条 PCIe 5.0 通道,使总数达到 20 条通道,以支持独立显卡连接。配备较大 10 或 12 Xe GPU 的 Panther Lake SKU 使用较小的 I/O 模块。[38]
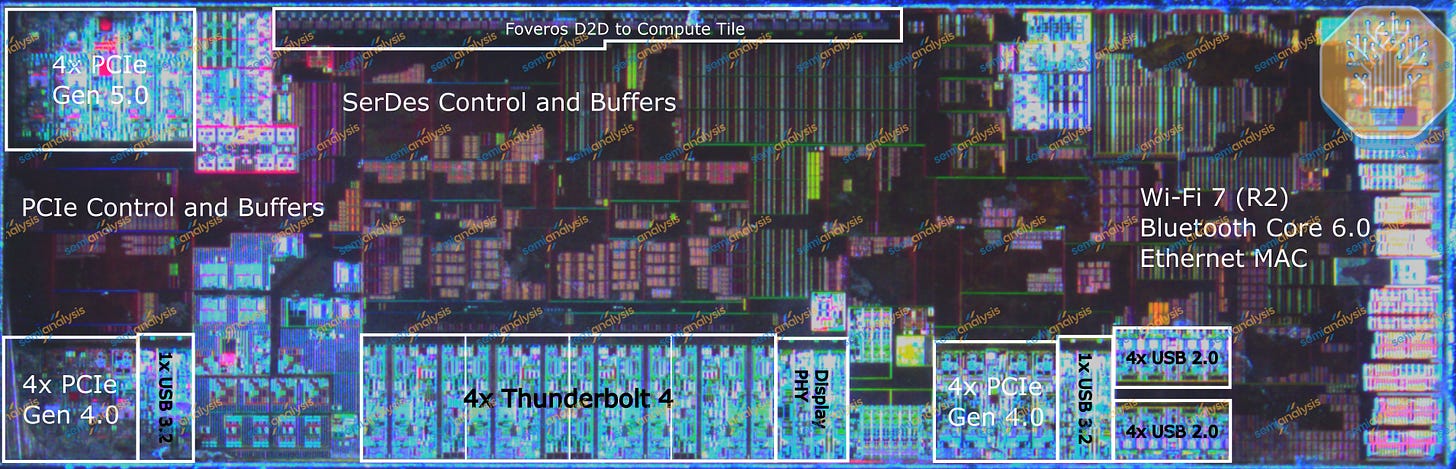
较小的 I/O 模块在 Lunar Lake 的 I/O 布局基础上增加了 PCIe 4.0 模块和 Thunderbolt 模块,提供了四条额外的 PCIe 4.0 通道和另一个 Thunderbolt 4 端口。其重复使用的 N6 模块保留了几乎相同的面积和布局。复用这些经过验证的物理层(PHY)和控制器避免了在 18A 工艺上移植和重新认证外部接口,因为在 18A 上,更快的数字逻辑对受限于片外链路的电路带来的收益较小。[38]
SemiAnalysis 的拆解实验室(STEEL)深入探索全球先进数据中心和 AI 硬件领域。如需了解更多关于我们流水线的信息或委托进行拆解分析,请联系 sales@semianalysis.com。
我们正在招聘从系统级到晶体管级的技术专家,以及中间各个环节的人才。请查看我们的招聘页面。
Panther Lake 通过解耦封装技术提供可扩展性和模块化,该技术将计算、GPU 和 I/O 硅片划分为单独的模块,允许一系列模块配置组合。这种划分使得封装成为英特尔节点经济学的一部分,因为它决定了每个产品消耗多少前沿晶圆面积,哪些功能可以保留在其他工艺上,以及英特尔可以从共享的模块集中提供多大的配置自由度。
此外,单独制造计算和 GPU 模块将新的 18A 工艺限制在计算模块上,并允许图形和 I/O 使用其他更成熟、更具成本效益的工艺。对于 Panther Lake,GPU 和 I/O 模块与计算模块一起使用 Foveros-S 技术在无源硅基板上组装。
英特尔当前的技术简报列出了 Foveros-S 的名义间距为 36 µm。基板中的硅通孔(TSV)将上方的细布线连接到下方的较大封装连接。功能模块以 2.5D 配置并排坐落在那块无源基板上。[39]
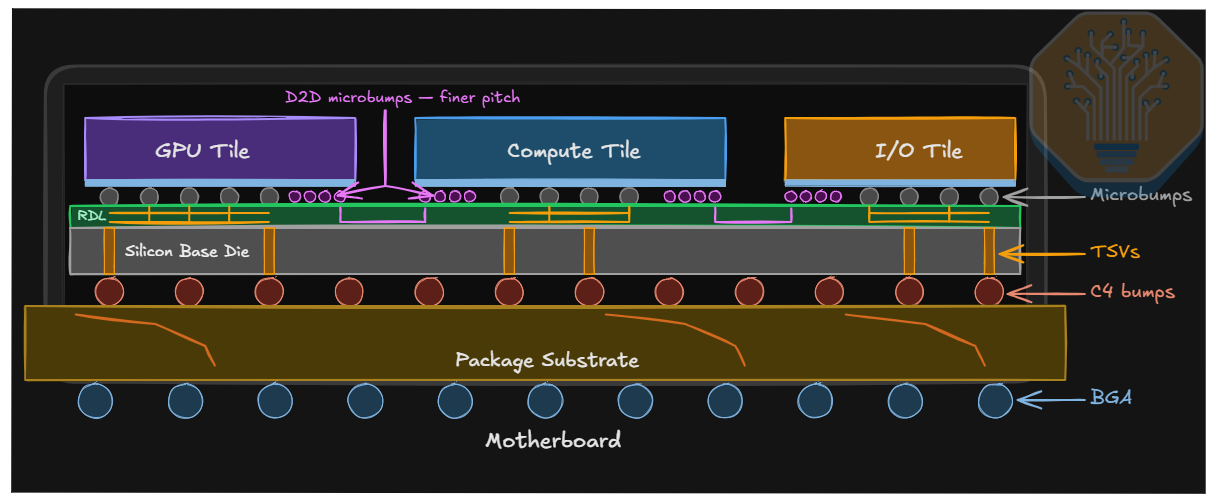
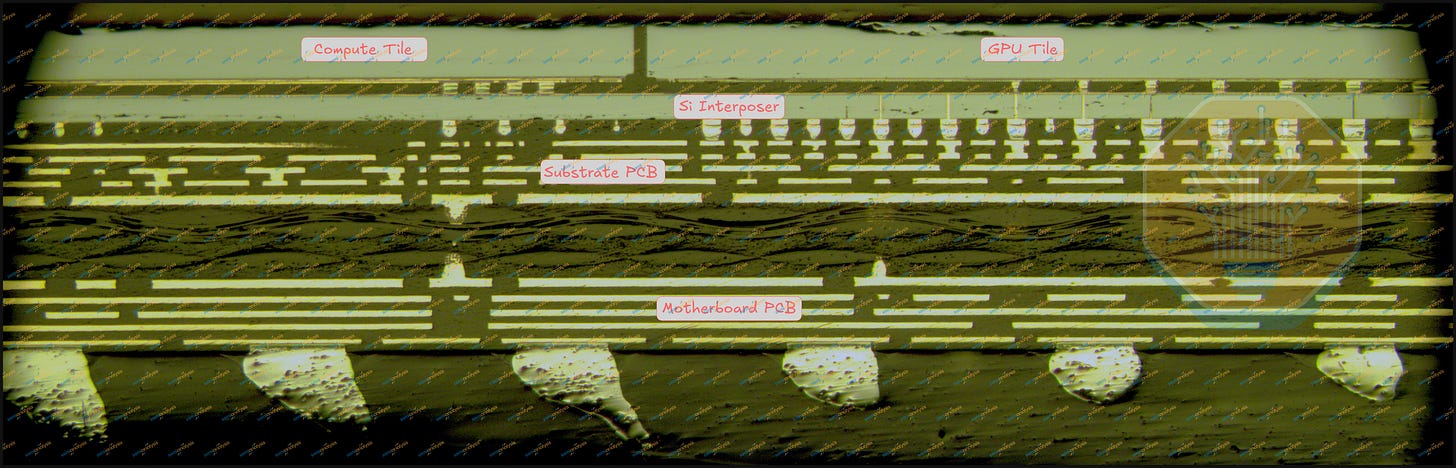
我们穿过计算和 GPU 模块的横截面展示了封装的布线层级。微凸点将每个有源模块连接到无源硅基板;其精细重分布层(RDL)承载短而密集的模块间链路。TSV 将连接穿过基板传递到封装基板,并将其扩展至更粗糙的主板焊球。基板提供互连,而计算则保留在其上方的有源模块中。[39]
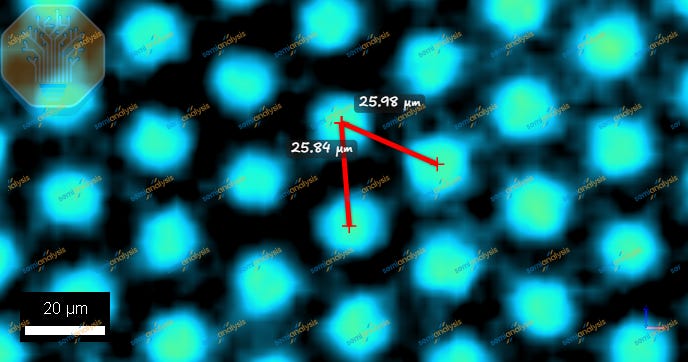
在计算模块的边缘,高倍率插图显示了局部微凸点间距约为 25.24 µm,特征宽度为 12.33 µm。
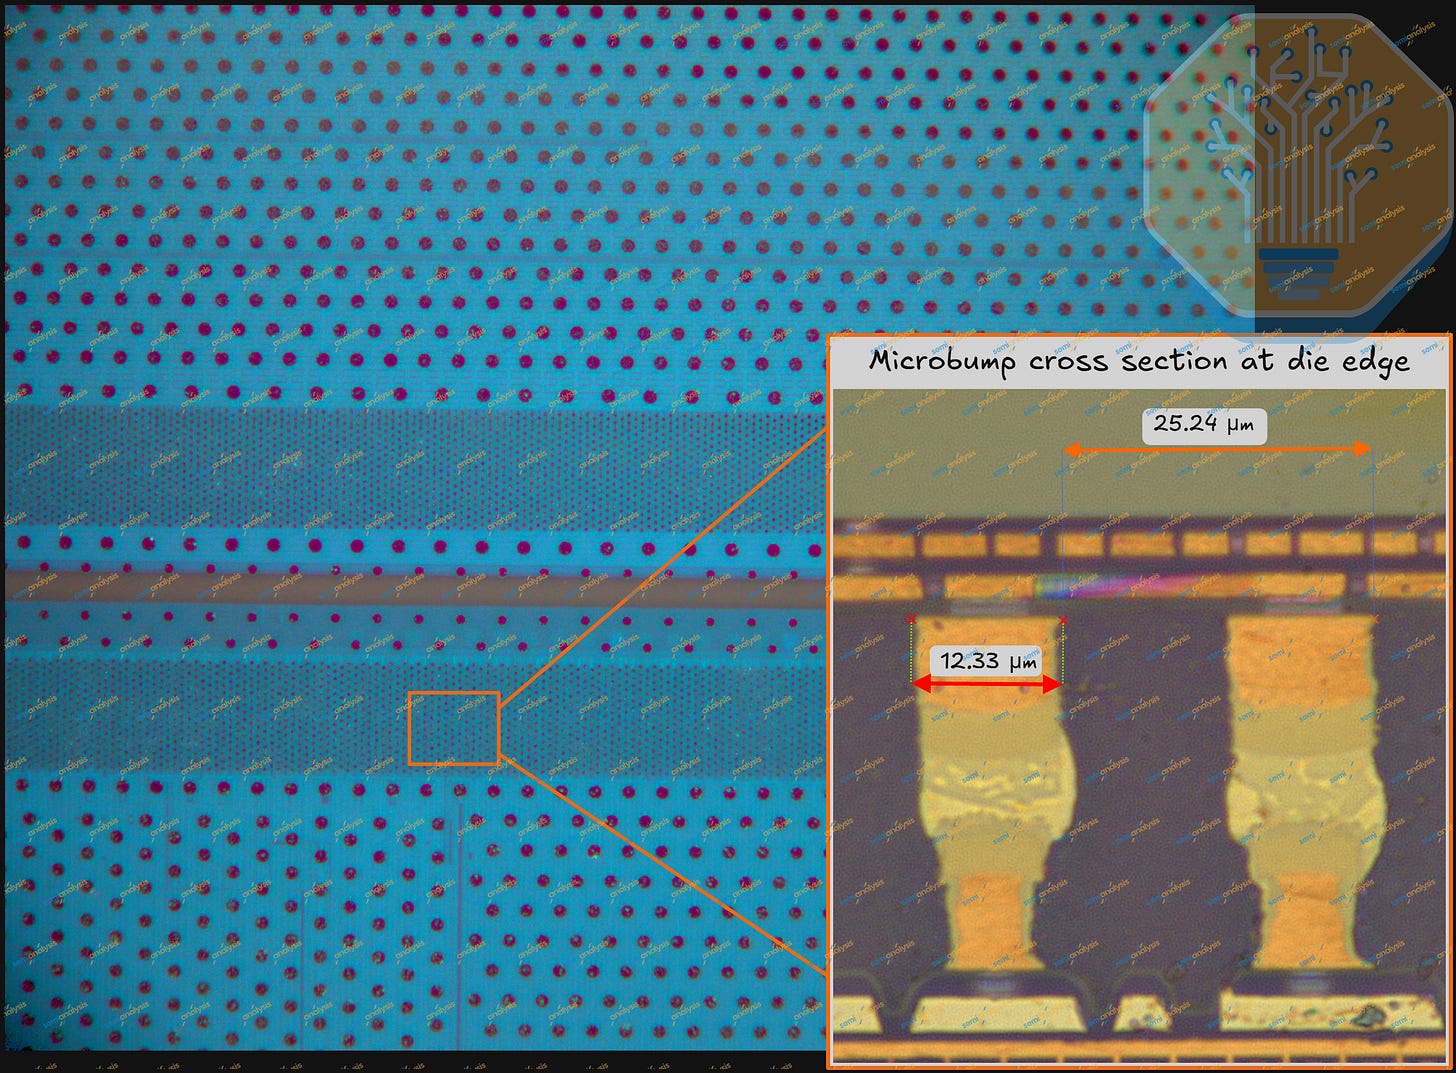
这些局部间距比英特尔名义上的 Foveros-S 值更细。X 射线图像进一步证实了相邻凸点更紧密,这在每个模块上发现的每个芯片到芯片(die-to-die)区域都是一致的。付费墙后有额外的 X 射线分析内容。
将内存控制器置于 CPU 旁边,消除了 Meteor Lake 和 Arrow Lake 中 CPU 内存请求所需的 D2D(Die-to-Die)传输。这避免了额外的发射器、接收器和链路遍历,从而节省了接口能耗和延迟。Panther Lake 的独立 GPU 仍需跨越 D2D 链路以访问 DRAM,因此其更大的本地缓存也有助于限制封装内的流量。[1], [40]
较小的芯片更不可能包含随机致命缺陷,而在组装前对其进行筛选可以防止一个不良晶粒消耗掉整个优质硅片封装。复用还能将设计和认证工作分摊到更多产品上。然而,英特尔为此支付了无源基板、D2D 电路、额外的键合和测试步骤的成本,以及组装过程中的损耗。组合产品中每个可用产品的成本反映了晶圆良率、复用、测试和组装的综合影响。[29]
Wildcat Lake 封装
英特尔于 2026 年 4 月 16 日推出了 Core Series 3(前身为 Wildcat Lake),面向价值型移动设备和边缘系统。Wildcat Lake 保留了 18A 工艺,但去除了无源基板,并将更多功能集成在单个芯片上以简化封装。因此,这两款产品揭示了商业化同一领先工艺的两种截然不同的方式。[41]
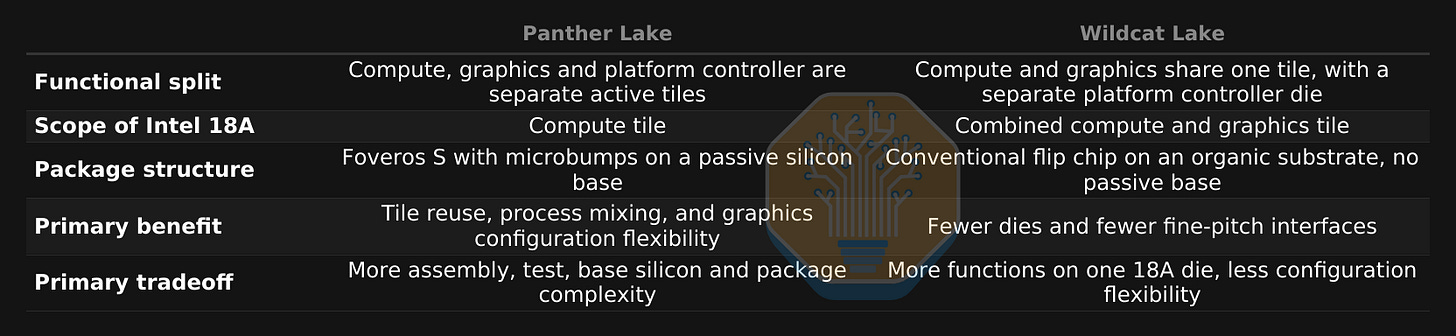
Wildcat Lake 的 18A 芯片集成了多达两个 Cougar Cove P 核、四个 Darkmont LP E 核、两个 Xe3 核心和一个较小的 NPU。独立的平台控制器芯片提供 I/O 功能,通过 UCIe 连接,这是英特尔首次在该标准上的处理器实现。整合图形单元消除了晶粒边界和无源基板,降低了中等带宽价值产品的组装复杂度。这也使 CPU 和图形扩展绑定在同一芯片上,放弃了 Panther Lake 能够更换更大 GPU 的能力。[42], [43]
2021 年 7 月,英特尔首席执行官帕特·基尔辛格提出了一项雄心勃勃的工艺路线图,旨在到 2025 年重新夺回性能领先地位,后来被描述为“四年五个节点”。五年后,随着一位新 CEO 的上任,英特尔的复兴故事并不像帕特所希望的那样明确积极。[44], [45]
英特尔曾一度引领工艺技术的步伐,比行业其余部分早多年将高介电常数金属栅极技术和 FinFET 技术投入量产。其 22 nm FinFET 工艺随 2012 年的 Ivy Bridge 进入消费市场。[46] 英特尔的集成器件制造(IDM)模式使其架构师和工艺工程师能够协同优化产品和工艺。从 Sandy Bridge 开始,英特尔主导了 x86 市场,而 AMD 则在 Bulldozer 架构上挣扎。
这一优势在 14 nm 处开始动摇,并在 10 nm 处彻底破裂。英特尔目标是实现高达 2.7 倍的密度提升,但该节点迟到数年,并经过多次修订后才支持英特尔的全系列产品线。这一延误迫使英特尔将 14 nm 工艺横跨六代产品使用,而台积电则在工艺技术方面取得进展,AMD 也在 x86 领域复苏。
到 2019 年,英特尔仍在大部分产品堆栈中出货 14 nm 产品,其 10 nm 客户端产能主要集中在 Ice Lake 移动处理器上。与此同时,台积电正在出货 N7 和 N7+,而 AMD 的 Zen 2 计算晶粒采用 N7 工艺以提高核心数量和改善效率。
英特尔的工艺失败是其衰落的核心原因,但不健全的商业决策进一步加剧了其下滑趋势。产品延误加剧了产品失误,导致客户端、服务器和 FPGA 路线图偏离计划。几次尝试进入 AI(Nervana 和 Gaudi)和网络(Tofino)领域的努力也未能建立起持久的业务。
英特尔的复苏重点在于消费级 CPU 和先进封装。Tiger Lake、Alder Lake、Lunar Lake 以及如今的 Panther Lake 已恢复了英特尔的消费级产品路线图。在制程方面,Meteor Lake 带来了 Intel 4,Granite Rapids 和 Sierra Forest 带来了 Intel 3,而 Panther Lake 则采用了 Intel 18A。英特尔还将先进封装纳入其代工服务范畴。然而,英特尔在服务器领域仍处于追赶状态。多款 Xeon 处理器世代发布严重滞后,且在性能、能效和核心数量上均落后于同期的 AMD 和 Arm 服务器 CPU。虽然制程路线图已重回正轨,但英特尔并未重获其在 10 纳米之前所拥有的制程技术领先地位。
全环绕栅极纳米片(GAA nanosheets)和背面供电(backside power delivery)是十年来晶体管集成技术的两大重大变革。英特尔同时应对了这两项变革:在 Panther Lake 中,Intel 18A 将其首款 RibbonFET 与 PowerVia 相结合。
Panther Lake 是一个重大的制造里程碑。我们的截面图展示了 RibbonFET 和 PowerVia 如何重塑局部接触和布线,而平面图则显示了架构整合和制程选择如何在面积节省上发挥作用。持续的竞争优势取决于产品性能、成本、良率以及下一代的实现情况。
[1] Intel, “Intel Tech Tour 2025 Panther Lake recap,” Doc. 866361, 2025. Accessed: Sep. 14, 2026. [Online]. Available: https://cdrdv2-public.intel.com/866361/ITT_2025_Panther_Lake_Recap1.pdf
[2] Intel, “Core Ultra processors Series 3 datasheet, volume 1,” Doc. 872188-001, Jan. 2026. Accessed: Sep. 14, 2026. [Online]. Available: https://cdrdv2-public.intel.com/872188/872188-001.pdf
[3] N. Horiguchi and E. Beyne, “Backside power delivery: How to power chips from the backside,” imec Reading Room, Nov. 25, 2022. Accessed: Sep. 14, 2026. [Online]. Available: https://www.imec-int.com/en/articles/how-power-chips-backside
[4] W. Hafez et al., “Intel PowerVia technology: Backside power delivery for high density and high-performance computing,” in Proc. IEEE Symp. VLSI Technol. Circuits, Kyoto, Japan, Jun. 2023, pp. 1–2, doi: 10.23919/vlsitechnologyandcir57934.2023.10185208.
[5] K. Fischer et al., “Intel 18A platform technology featuring RibbonFET (GAA) and PowerVia for advanced high-performance computing,” in Proc. Symp. VLSI Technol. Circuits, Kyoto, Japan, Jun. 2025, pp. 1–3, doi: 10.23919/vlsitechnologyandcir65189.2025.11075006.
[6] K.-F. Cheng, C.-L. Teng, H.-Y. Huang, and H.-C. Chen, “Metal oxide composite as etch stop layer,” U.S. Patent 12 176 247 B2, Dec. 24, 2024. Accessed: Sep. 14, 2026. [Online]. Available: https://patents.google.com/patent/US12176247B2/en
[7] S. W. King, “Dielectric barrier, etch stop, and metal capping materials for state of the art and beyond metal interconnects,” ECS J. Solid State Sci. Technol., vol. 4, no. 1, pp. N3029–N3047, 2015, doi: 10.1149/2.0051501jss.
[8] A. V. Mule’, D. J. Towner, D. Seghete, C. R. Ryder, and A. A. Gonzalez, “Multi-layer etch stop layers for advanced integrated circuit structure fabrication,” U.S. Patent Appl. 20220102343 A1, Mar. 31, 2022. Accessed: Sep. 14, 2026. [Online]. Available: https://patents.google.com/patent/US20220102343A1/en
[9] C.-C. Wang and J. H. Wang, “Interconnect structure with dielectric cap layer and etch stop layer stack,” U.S. Patent Appl. 20230253247 A1, Aug. 10, 2023. Accessed: Sep. 14, 2026. [Online]. Available: https://patents.google.com/patent/US20230253247A1/en
[10] Y. J. Wu, K.-F. Cheng, C.-C. Lee, H.-K. Chang, and H.-Y. Huang, “Etch stop layer for interconnect structures,” U.S. Patent Appl. 20240332070 A1, Oct. 3, 2024. Accessed: Sep. 14, 2026. [Online]. Available: https://patents.google.com/patent/US20240332070A1/en
[11] M. G. Rainville, N. Shankar, K. S. Reddy, and D. M. Hausmann, “Deposition of aluminum oxide etch stop layers,” U.S. Patent Appl. 20180197770 A1, Jul. 12, 2018. Accessed: Sep. 14, 2026. [Online]. Available: https://patents.justia.com/patent/20180197770
[12] J. S. Leib 等人,“具有钼衬层和钨填充的导电线路,用于先进集成电路结构制造”,美国专利申请 20240429126 A1,2024年12月26日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.justia.com/patent/20240429126
[13] M. Naik,“钴实现单数字逻辑节点下的功耗与性能扩展”,应用材料公司,2018年12月17日。访问日期:2026年9月14日。[在线]。可用链接:https://www.appliedmaterials.com/us/en/blog/blog-posts/cobalt-enables-power-and-performance-scaling-at-single-digit-logic-nodes.html
[14] 拉姆研究公司,“以钼突破人工智能的无形壁垒”,拉姆研究公司新闻室,2025年5月6日。访问日期:2026年9月14日。[在线]。可用链接:https://newsroom.lamresearch.com/molybdenum-metallization-ai-revolution
[15] P. Yashar、G. Malyavanatham 和 H. Vijwani,“具有铌阻挡材料的集成电路互连结构”,美国专利申请 20240112951 A1,2024年4月4日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.google.com/patent/US20240112951A1/en
[16] 应用材料公司,“应用材料公司展示芯片布线创新,助力更节能的计算”,应用材料公司投资者关系,2024年7月8日。访问日期:2026年9月14日。[在线]。可用链接:https://ir.appliedmaterials.com/news-releases/news-release-details/applied-materials-unveils-chip-wiring-innovations-more-energy
[17] 三星,“三星在 SFF 2024 上展示人工智能时代愿景及最新代工技术”,三星半导体,2024年6月13日。访问日期:2026年9月14日。[在线]。可用链接:https://semiconductor.samsung.com/news-events/news/samsung-showcases-ai-era-vision-and-latest-foundry-technologies-at-sff-2024/
[18] C. W. Yeung 等人,“堆叠纳米片的沟槽几何形状影响及窄条效应”,收录于 IEEE 国际电子器件会议(IEDM)论文集,2018年12月,第 28.6.1–28.6.4 页,doi: 10.1109/iedm.2018.8614608。
[19] S. Mochizuki 等人,“评估 (110) 与 (001) 沟道取向对全环绕栅极纳米片技术中 nFET/pFET 器件性能权衡的改善”,收录于国际电子器件会议(IEDM)论文集,2023年12月,第 1–4 页,doi: 10.1109/iedm45741.2023.10413854。
[20] D. G. Ouellette 等人,“制造具有氮化钼金属栅极和带偶极层栅介电质的全环绕栅极集成电路结构”,美国专利 12 051 698 B2,2024年7月30日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.google.com/patent/US12051698B2/en
[21] imec,“通过新型集成模块和标准单元架构推进基于 CFET 的器件路线图”,imec,2026年。访问日期:2026年9月14日。[在线]。可用链接:https://www.imec-int.com/en/articles/advancing-cfet-based-device-roadmap-novel-integration-modules-and-standard-cell
[22] A. Reznicek、X. Miao、C. Lee 和 J. Zhang,“用于纳米片源漏外延的环绕接触”,美国专利 11 302 813 B2,2022年4月12日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.google.com/patent/US11302813B2/en
[23] J. A. Kittl、J. G. Hong、D. R. Palle 和 M. S. Rodder,“用于纳米级场效应晶体管器件施加不同应力的方法”,美国专利 9 978 833 B2,2018年5月22日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.google.com/patent/US9978833B2/en
[24] S. Gandikota 等人,“降低下一代 NMOS 器件应用的金属栅极电阻的方法”,国际专利申请 WO 2024/137272 A1,2024年6月27日。访问日期:2026年9月14日。[在线]。可用链接:https://patents.google.com/patent/WO2024137272A1/en
[25] J. Zhang 等人,“全底部介质隔离以实现用于低功耗和高性能应用的堆叠纳米片晶体管”,收录于 IEEE 国际电子器件会议(IEDM)论文集,2019年12月,第 11.6.1–11.6.4 页,doi: 10.1109/iedm19573.2019.8993490。
[26] C. Yoo, J. Chang, Y. Seon, H. Kim 和 J. Jeon,《考虑底部隔离和封装选项的多纳米片 FET 中的自热效应分析》,IEEE Trans. Electron Devices,第 69 卷,第 3 期,第 1524–1531 页,2022 年 3 月,doi: 10.1109/ted.2022.3141327。
[27] S. S. Pradhan, D. B. Bergstrom, J.-S. Chun 和 J. Chiu,《用于非平面晶体管的钨栅极》,欧洲专利申请 EP 3 506 367 A1,2019 年 7 月 3 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/EP3506367A1/en
[28] L. Schloss 和 X. Ba,《低氟含量的钨薄膜》,美国专利 9 754 824 B2,2017 年 9 月 5 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US9754824B2/en
[29] Intel Foundry,《利用先进工艺和封装技术加速 AI 和高性能计算》,文档编号 367370-001US,2026 年 6 月。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.intel.com/content/dam/www/central-libraries/us/en/documents/2025-11/intel-foundry-hpc-ai-brief.pdf
[30] M. Lofrano, X. Chang, H. Oprins 和 Z. Tokei,《缓解先进互连中的热瓶颈》,imec,2023 年 9 月 28 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.imec-int.com/en/articles/mitigating-thermal-bottleneck-advanced-interconnects
[31] S. Bair,《ISSCC 2025 上的英特尔:Navid Shahriari 特邀演讲、八篇论文、论坛、小组成员及产品详情》,Intel Community,2025 年 2 月 19 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://community.intel.com/t5/Blogs/Tech-Innovation/Edge-5G/Intel-at-ISSCC-2025-Navid-Shahriari-Invited-Talk-Eight-Papers/post/1667592
[32] D. Chandra, E. Potladhurthi, D. R. S. Reddy 和 K. S. Rengarajan,《可调谐负位线写辅助及升压衰减电路》,美国专利申请 20160203857 A1,2016 年 7 月 14 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://patents.google.com/patent/US20160203857A1/en
[33] Synopsys,《高速 DDR IP 中基于固件的训练的优势》,Synopsys IP 技术简报。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.synopsys.com/articles/firmware-based-training-ddr-ip.html
[34] N. Muralimanohar, R. Balasubramonian 和 N. P. Jouppi,《CACTI 6.0:理解大型缓存的工具》,惠普实验室,2009 年。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://users.cs.utah.edu/~rajeev/cacti6/cacti6-tr.pdf
[35] Intel,《2024 英特尔技术之旅 Lunar Lake AI 硬件加速器》,文档编号 824436,2024 年。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://cdrdv2-public.intel.com/824436/2024_Intel_Tech%20Tour%20TW_Lunar%20Lake%20AI%20Hardware%20Accelerators.pdf
[36] Y.-H. Chen, J. Emer 和 V. Sze,《Eyeriss:一种用于卷积神经网络能效数据流的空间架构》,Proc. 43rd ACM/IEEE Annu. Int. Symp. Comput. Archit. (ISCA),2016 年 6 月,第 367–379 页,doi: 10.1109/isca.2016.40。
[37] Intel,《Xe-HPG 架构简介》,文档编号 758306,2022 年 11 月 4 日。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.intel.com/content/www/us/en/developer/articles/technical/introduction-to-the-xe-hpg-architecture.html
[38] Intel,《面向边缘的 Core Ultra 处理器系列 3》,文档编号 855291。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://cdrdv2-public.intel.com/855291/Intel%C2%AE%20Core%E2%84%A2%20Ultra%20Processors%20Series%203%20for%20Edge%20Overview_2.pdf
[39] Intel Foundry,《Foveros 技术简报》,文档编号 366411-001US,2026 年 2 月。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.intel.com/content/dam/www/central-libraries/us/en/documents/2025-07/foveros-25d-product-brief.pdf
[40] D. Das Sharma,《UCIe:构建开放的 Chiplet 生态系统》,UCIe Consortium,2022 年。访问日期:2026 年 9 月 14 日。[在线]。可用链接:https://www.uciexpress.org/_files/ugd/0c1418_c5970a68ab214ffc97fab16d11581449.pdf
[41] Intel,“Intel 推出 Intel Core Series 3 处理器”,Intel Newsroom,2026年4月16日。访问日期:2026年9月14日。[在线]。可用链接:https://www.intel.com/content/www/us/en/newsroom/news/client-computing/intel-launches-intel-core-series-3-processors-changing-the-game-for-everyday-computing.html
[42] Intel,“Core Series 3 发布新闻稿”,2026年4月。访问日期:2026年9月14日。[在线]。可用链接:https://download.intel.com/newsroom/2026/Intel-Core-Series-3/Intel-Core-Series-3-Launch-Press-Deck.pdf
[43] Intel,“Intel 在 Hot Chips 2026 上概述代理式 AI 架构”,Intel Newsroom,2026年8月24日。访问日期:2026年9月14日。[在线]。可用链接:https://www.intel.com/content/www/us/en/newsroom/news/client-computing/intel-outlines-architectures-for-agentic-ai-at-hot-chips-2026.html
[44] Intel,“Intel 加速工艺和封装创新”,Intel Investor Relations,2021年7月26日。访问日期:2026年9月14日。[在线]。可用链接:https://www.intc.com/filings-reports/all-sec-filings/content/0001193125-21-224438/d199788dex991.htm
[45] Intel,“Intel 公布 2021 年第三季度财务业绩”,Intel Investor Relations,2021年10月21日。访问日期:2026年9月14日。[在线]。可用链接:https://www.intc.com/news-events/press-releases/detail/1505/intel-reports-third-quarter-2021-financial-results
[46] Intel,“第三代 Intel Core 处理器为 PC 带来令人兴奋的新体验和乐趣”,Intel Investor Relations,2012年4月23日。访问日期:2026年9月14日。[在线]。可用链接:https://www.intc.com/news-events/press-releases/detail/577/3rd-generation-intel-core-processors-bring-exciting
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。