精选Hugging Face Blog短讯
介绍 Olmo-core 3:面向大型 MoE 的开源可扩展训练基础设施
EleutherAI 发布 Olmo-core 3,旨在为大型混合专家(MoE)模型提供开源、可扩展的训练基础设施。

今天我们发布 Olmo-core 3,这是我们对开发大型语言模型框架的重大升级,其特色是重新设计的开放式混合专家(MoE)训练系统。
Olmo-core 3 旨在将 MoE 训练扩展至万亿参数规模,同时保持计算效率。它是下一代 Olmo 背后的核心系统之一,也是我们持续致力于开放每个新模型背后工具和训练基础设施的一部分。
训练大型 AI 模型需要大量的计算资源,这不仅推高了成本和能源消耗,还使许多学术研究人员和小型实验室难以触及先进的模型开发。MoE 模型提供了一种更高效的途径——它们可以包含更多的学习组件(即参数),而无需让每个输入都使用所有参数。然而,整个模型仍必须存储在 GPU 内存中并在训练期间进行更新,而在集群中将输入路由到正确的专家(MoE 内的专用组件)会产生自身的通信和协调成本。随着 MoE 规模的扩大,这些成本可能会侵蚀仅使用部分模型处理每个输入所带来的大部分计算优势。
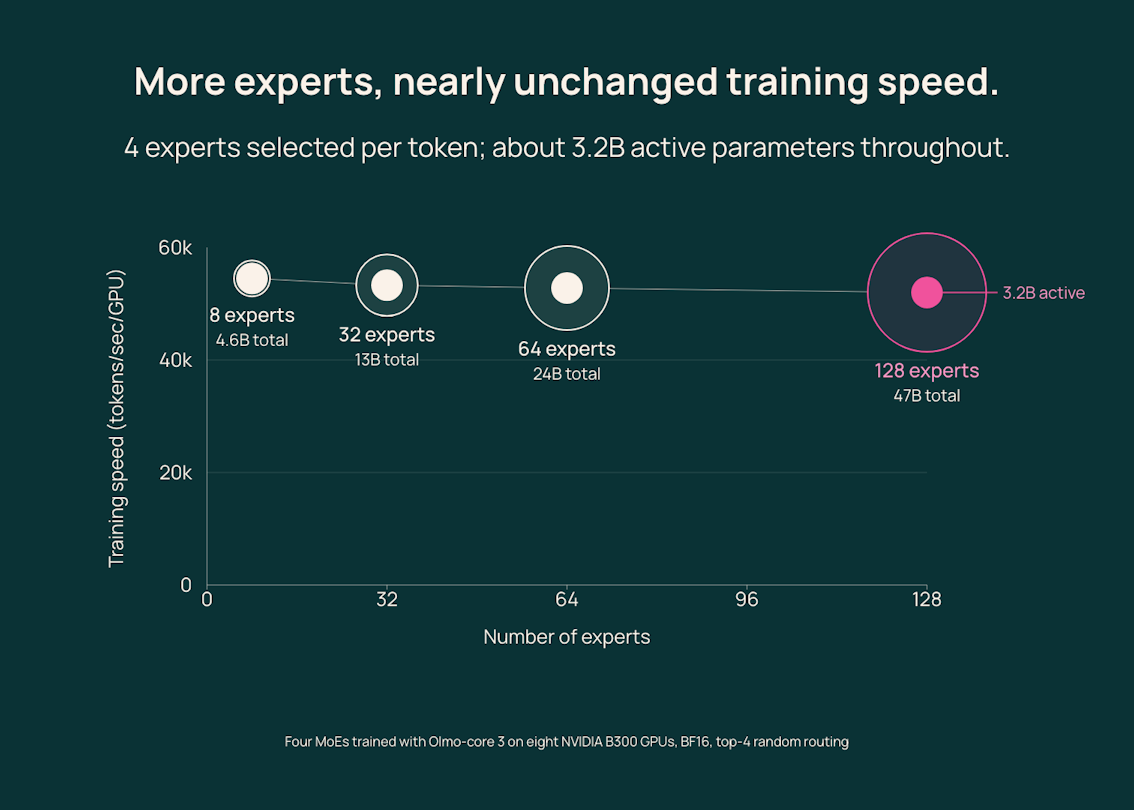
Olmo-core 3 旨在弥补这一差距。在一个基准测试中,我们将专家池从 8 个增加到 128 个,同时每个 token(语言模型处理的文本小单元)仅选择四个专家,使每个 token 的活跃参数数量大致固定在约 32 亿。总参数容量从 46 亿增长到 470 亿,而训练吞吐量下降不到 5%。
同一基础设施在超过一万亿总参数的规模下进行了基准测试。
围绕 MoE 的实际工作方式构建训练栈
Olmo-core 已随每一代 Olmo 不断演进。
我们在稀疏模型方面的工作可追溯至 OlmoE,它使用了具有 64 个路由专家的 MoE 架构。相比之下,Olmo 3 使用了密集架构,意味着几乎所有模型对每个 token 都是活跃的,其训练栈也是围绕该设计构建的。Olmo-core 3 通过一个专为更大规模 MoE 模型设计的训练系统扩展了该框架。
我们在 Olmo-core 中早期的 MoE 实现使用了完全分片数据并行(FSDP),配置为收集并重新分片每个小批次训练数据的模型权重。Olmo-core 3 切换到一个基于分布式数据并行(DDP)的系统。它将专家驻留在 GPU 上并将相关数据路由给它们,从而避免了重复的权重收集操作。
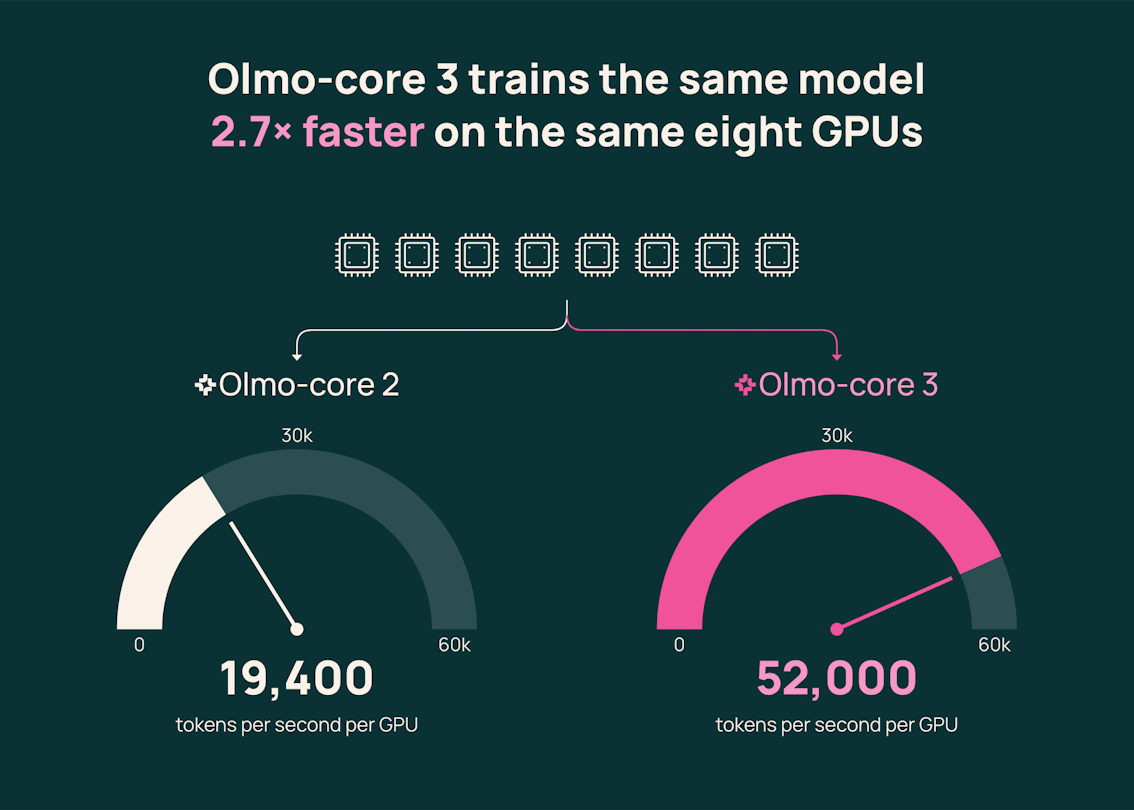
NVIDIA 的 Megatron-Core 是训练大型 MoE 的一个成熟选项。Olmo-core 3 为 Olmo 背后的框架带来了集成的 MoE 训练栈,并通过重新设计提高了我们早期基于 FSDP 实现的吞吐量。在八块 NVIDIA B300 GPU 上的初步测试中,使用新栈时,一个拥有 470 亿参数的 MoE 每块 GPU 每秒处理 52,000 个 token,而使用我们早期的实现则为 19,400——吞吐量约为之前的 2.7 倍。
扩展和优化 MoE 训练
Olmo-core 3 结合了多种技术,用于在 GPU 集群上分布大型 MoE,并优化路由和计算以提高效率。
三种技术决定了模型及其训练状态如何在硬件上拆分:
- 专家并行(Expert parallelism)将专家分散到各个 GPU 上,因此每个 GPU 仅存储完整专家池的一部分。
- 流水线并行(Pipeline parallelism)将模型的层(转换输入的连续阶段)拆分到各组 GPU 上,减少了每个 GPU 需要在内存中保留的模型量。
- 分布式优化器(Distributed optimizer)将优化器状态(用于在训练期间计算和应用更新的额外数据)分散到各个 GPU 上,而不是在每个 GPU 上存储完整的副本。
结合这些技术,MoE 可以在不需要每个 GPU 都在内存中保留整个模型及其训练状态的情况下进行扩展。
Olmo-core 3 还降低了将数据路由到正确专家并运行其计算的成本。行级专家并行性将路由数据直接放入专家输入缓冲区,从而最大限度地减少重新排列数据所需的额外工作。GPU 驻留路由将路由元数据保留在 GPU 上,因此 CPU 可以在不等待信息复制回来的情况下排队工作。而分组 GEMM(通用矩阵乘法)将许多小型专家计算组合在一起,以便 GPU 更高效地执行它们。
最后,Olmo-core 3 支持 MXFP8,这是一种较低精度的数字格式,用更少的位数表示某些值。只要节省下来的成本超过在不同数字格式之间转换的成本,这就可以减少计算量以及 GPU 之间移动的数据量。
我们在四个 NVIDIA B300 GPU 上的受控基准测试中测量了 MXFP8 对端到端训练吞吐量的影响,工作量均匀分布在各个专家上。在系统中最受益的部分启用 MXFP8 后,与作为基线的更高精度格式 BF16 相比,训练吞吐量提高了约 21%,同时峰值活跃内存从 103 GiB 降至 95 GiB。大部分增益来自前馈计算以及在专家之间移动数据,而不仅仅是注意力机制。
这些技术和优化必须协同工作。加快训练的某一部分可能会在其他地方产生成本;更快的计算可能需要更多的数据移动,而如果数据转换时间过长,移动更少的位可能也无济于事。Olmo-core 3 围绕整个训练过程中的这些权衡而构建,使我们——以及使用开源堆栈的研究人员——能够控制各部分如何组合在一起。
探索我们的交互式演示,了解数据、专家和流水线并行性如何协同工作以扩展 MoE 训练规模——从单个 GPU 到多个 GPU。

扩展到万亿参数范围
我们已在 NVIDIA B300 GPU 上的各种配置中对 Olmo-core 3 进行了基准测试,包括一个拥有 1.2 万亿参数的模型,该模型在 512 个 GPU 上每个令牌激活 583.6 亿个参数。其观察到的最高吞吐量为每 GPU 858 TFLOP/s——即每个 GPU 每秒有用的模型计算量。这些测试使用随机路由来衡量系统性能,而非已训练模型的质量。
我们还尝试了 DeepEP v2,这是一种处理 GPU 间专家通信的替代方法,达到了具有 2.38 万亿总参数的配置。这是一次短容量测试,而非完整的训练运行,因此它展示了 Olmo-core 3 所能达到的规模,而非持续的训练性能。
在这些规模下,系统性能只是图景的一部分。我们的技术报告还记录了指导我们如何训练 MoE 并衡量其性能的实验。例如:
- 旨在鼓励平衡路由的评分指标,即使实际工作负载变得不那么平衡时也可能提高。我们将此称为失败标记杰利蝾螈(failure token gerrymandering)。
- 由于处理的令牌较少而降低专家的 learning rate(学习率,即训练更新的大小),在我们测试的模型系列中并未改善结果。
- 当处理的值发生变化时,即使矩阵维度相同,GPU 计算所需的时间也不同。因此,性能比较需要匹配的输入值以及匹配的形状。
- 在不同的 GPU 流上重叠通信和计算并不总是能加快训练速度。在某些测试中,它反而减缓了端到端执行——这提醒我们,更多的重叠并不一定意味着更高的吞吐量。
报告解释了这些发现,以及我们测试过但未采用的方法。
为下一代 Olmo 打造,向所有人开放
Olmo-core 3 是我们正在构建的下一代的基石。我们的下一代 Olmo 将采用 MoE 架构,我们的目标是使其成为迄今为止最强大的 Olmo,将在我们最大的数据集上进行训练,并具有最长的上下文窗口。
这套新架构使我们能够超越此前在混合专家(MoE)模型上的扩展能力,同时为适应模型与硬件的演进提供了更大的训练灵活性。它完全开源——研究人员和开发者可以使用 Olmo-core 3 训练自己的 MoE 模型,将其适配到不同的硬件上,并对路由机制、并行策略及其他系统组件进行实验。
这正是我们对开放模型开发的思考方式之一:当支撑模型的底层基础设施和训练决策同样开放时,模型权重才更具价值。
若想了解更深入的系统设计细节、实验结果、消融研究以及我们在开发过程中尝试的各种方法,请阅读我们的技术报告,并在 GitHub 上探索 Olmo-core 3。
译文已达到本站中文翻译的字数上限,剩余内容请查看原文。