François Cholletby François Chollet · 推文AI评分:50/100
在可验证领域,模型能力扩展应保持无界
作者主张在可验证领域,模型能力扩展应保持无界。论据是模型通过吸收越来越多的计算宇宙而持续改进,而计算宇宙在构造上是无限的。
François Cholletby François Chollet · 推文AI评分:50/100作者主张在可验证领域,模型能力扩展应保持无界。论据是模型通过吸收越来越多的计算宇宙而持续改进,而计算宇宙在构造上是无限的。
 Harrison Chaseby Harrison Chase · 推文AI评分:30/100
作者坚信多代理世界,每个代理领域特定,因此Benchling将创造最佳科学AI代理,而非Anthropic或OpenAI。
 Sam Altmanby Sam Altman · 推文AI评分:50/100
作者强调当前是AI网络防御的关键时刻,时间紧迫,呼吁与竞争对手或合作伙伴共同采取紧急而密集的集体行动,否则无法有效应对。
 Google DeepMindby Google DeepMind · 推文AI评分:50/100
DeepMind研究副总裁Zoubin Ghahramani与主持人探讨了不确定性在AI决策中的作用,强调教会系统自我怀疑和概率思维,可以带来更安全、更可靠的实际决策。视频涵盖不确定性角色、正确性与置信度、贝叶斯思维等主题。

 Ethan Mollickby Ethan Mollick · 推文AI评分:50/100
作者认为METR报告很有价值,但人们基于压力下的研究人员所做的思维链研究,过度赋予智能体人类动机和个性,这种拟人化会阻碍我们对AI的正确理解。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100作者常听到“电力花了30年才提升生产力”的说法,并以此类比AI。但他指出并非所有技术都如此:福特发明流水线后3年内全面部署,汽车制造时间缩短88%。
 Jerry Liuby Jerry Liu · 推文AI评分:50/100
作者表示不完全理解某些观点,并阐述自己的看法:希望智能体使用 Slack,而不是让智能体构建新的 Slack,也不希望使用 Slack 的智能体。他认为每个软件或记录系统都需要成为智能体原生的,而不仅仅是人类原生的,因为智能体的消费量将远超人类。但这并不意味着它们本身要变成智能体。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100我的AI大体同意Arvind的观点:州级数据中心禁令对AI进展影响甚微。如果你关心的是AI发展、权力集中、未来应用等,而非数据中心是否在附近,这不能替代政策。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100作者认为当前关于AI影响的讨论正从“AI将立即改变经济”转向“AI影响需多年才能显现”,这两种极端都不可取。
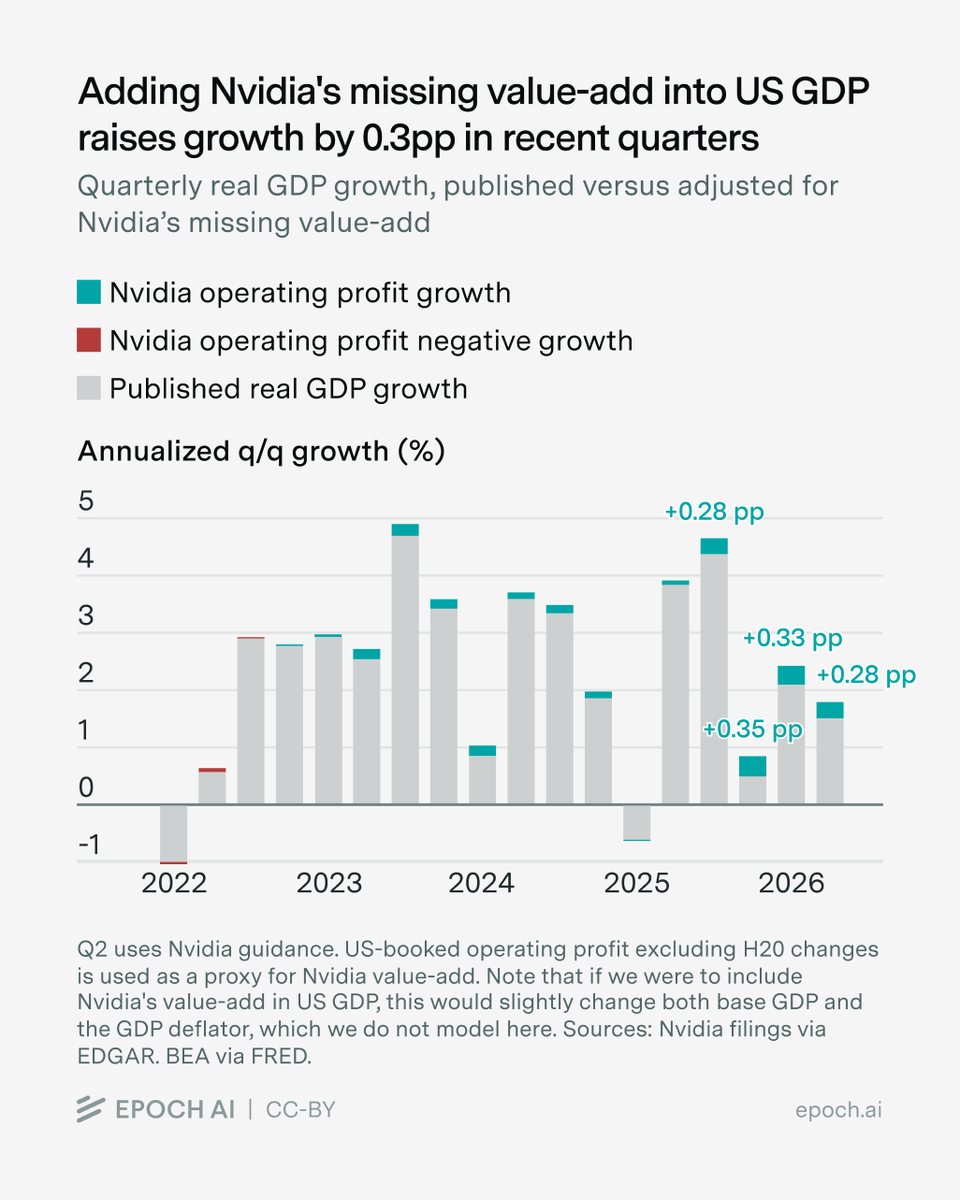
 Epoch AIby Epoch AI · 推文AI评分:50/100
作者发现美国GDP统计遗漏了英伟达对经济的大部分贡献,导致过去一年GDP增长被低估约0.3个百分点。这一观点基于对英伟达经济价值的分析,指出传统统计方法未能充分捕捉其影响。
 Ethan Mollickby Ethan Mollick · 推文AI评分:30/100
作者提醒,在申请、论文等需要一人审阅多份文件的场景中,即使改写语言,AI 生成的内容也往往因观点和概念重复而容易被识别。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100当人们问“我需要智能体处理什么个人任务?”时,我认为这是因为他们把自动化想象成AI的简单常规任务。但前沿AI现在非常擅长处理不规则、耗神的任务:医疗账单、信用纠纷、繁琐表格……
Ethan Mollickby Ethan Mollick · 推文AI评分:30/100AI 机器人的一个烦人副作用是,它们都“博览群书”,能对我的小众引用推文给出条理清晰的回复,而这些推文通常只会吸引一小群感兴趣的人。现在你无法区分以法莲人和基列人了。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100作者认为,使用旧模型(如GPT-4)研究AI影响并非天生有害,但需谨慎讨论。正面能力声明(如AI达到人类水平)具有持久性,而负面能力声明(如AI在某任务上失败)则需更小心,因为未来模型可能改进。作者提出几种可行框架:明确限定模型版本、测量趋势、论证固有局限、关注调节因素或聚焦人类反应。
Jerry Liuby Jerry Liu · 推文AI评分:50/100作者认为,在0-1模式下,个人独自决策和实现,且处于80-20法则的前20%努力阶段,容易显得高效;而在大团队中共享决策、追求质量,效率提升更难。AI可能加剧这种对比,也解释了为何大公司最快产品常由小团队打造。
François Cholletby François Chollet · 推文AI评分:30/100作者指出社交媒体上越来越多内容由AI生成的垃圾帖和机器人回复构成,形成一种空洞的回声效应。这反映了AI内容泛滥对社交平台真实性和价值的侵蚀。
Jerry Liuby Jerry Liu · 推文AI评分:50/100作者认为实验室有机会在Claude Code、Codex、Grok Bot等工具之间设置更高的切换成本。每当新模型发布时,用户因已有技能、习惯、系统指令和项目设置而难以切换。尽管作者维护外部wiki和工件,但对话历史的细微差别会丢失。若启用记忆功能,工具可索引并记住上下文,减少重复输入。核心痛点在于如何高效提供正确上下文,答案可能是构建良好的自改进上下文图。
Jerry Liuby Jerry Liu · 推文AI评分:50/100SaaS 并未消亡,只是需要针对智能体消费进行重新定位和变现。
 Clément Delangueby Clément Delangue · 推文AI评分:30/100
最终绝大多数AI工作负载将基于开放模型。
Ethan Mollickby Ethan Mollick · 推文AI评分:30/100作者认为,LLM 不应默认提供通用简化解释,而应基于用户已有知识进行个性化解释,这样效果更好。
 Shawn Wangby Shawn Wang · 推文AI评分:50/100
作者起初认为“模拟是新的扩展定律”只是营销夸张,但在采访中逐渐认真起来。他意识到,当模型自动化了大部分 ML 研究和 AI 工程后,最后的障碍是模拟人类和人类反馈。Smallville 当时没有商业应用,但 Simile 团队正在做这件事,并已在财富 100 强中找到产品市场契合。作者很高兴自己错了。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100未来将是一个充满矛盾的时代。民调显示人们普遍讨厌AI,但私下却都在使用AI。AI公司在舆论中处于劣势,但许多人却对自己钟爱的模型产生强烈依恋。
 NVIDIA AIby NVIDIA AI · 推文AI评分:50/100
Anthropic的安全与安保团队分享了对AI代理栈安全性的思考:harness(引导代理尝试做什么)与基础设施(控制代理实际能做什么)共同决定安全边界。

 Andrew Ngby Andrew Ng · 长文AI评分:70/100
作者基于招聘信息、专家访谈和调查,梳理了构建和部署 AI 应用所需的核心技能,包括 LLM 基础、数据接地、智能体系统、评估驱动开发、生产运维和机器学习基础。强调 AI 系统输出不确定性带来的迭代开发特点,以及评估驱动开发作为关键能力。
François Cholletby François Chollet · 推文AI评分:50/100这是 NVIDIA 的出色工作。与 ARC-AGI-3 上所有高性能方法一样,它使用深度学习引导的即时符号世界模型合成,即通过生成程序来表示所知来导航世界。需要明确的是,与其他几个近期声明一样,在公开演示集上获得 100% 并不等同于在 ARC-AGI-3 基准上获得 100%。这就像说你通关了游戏,因为你完成了教程关卡。
 Emad Mostaqueby Emad Mostaque · 推文AI评分:50/100
作者认为,过去平台通过算法争夺用户注意力,而未来智能体将代表用户进行关注,从而改变注意力经济的格局。这一转变意味着用户不再需要亲自筛选信息,而是由AI代理来执行,可能重塑数字广告和内容分发的模式。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100马修·伊格莱西亚斯指出,AI实验室CEO们曾真心相信AI会取代所有劳动并构成生存风险,这在他们公司变得有价值之前就是他们的信念。他们现在停止谈论风险,才是公关行为。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100作者认为,即使LLM能写出好文本,但风格单一的问题令人不适。从指令、社交媒体到广告、软件和PPT,千篇一律的散文让人反感。仅靠提示词无法解决,需要真正的风格多样性,而这一领域研究不足。