精选 Apple Machine Learning Research论文AI评分:90/100
RISED: 用于智能体多环境选择与自蒸馏的评估标准
该论文针对在多样化交互环境中联合训练单一LLM智能体的问题,提出了一种新的课程学习和数据选择策略。现有方法通常仅在环境层面分配训练或优先考虑局部奖励信号,忽略了跨环境当前回合之间的关系。RISED通过显式考虑这些关系来优化提示组选择,并解决不同环境学习速率差异导致的训练不平衡问题。

该论文针对在多样化交互环境中联合训练单一LLM智能体的问题,提出了一种新的课程学习和数据选择策略。现有方法通常仅在环境层面分配训练或优先考虑局部奖励信号,忽略了跨环境当前回合之间的关系。RISED通过显式考虑这些关系来优化提示组选择,并解决不同环境学习速率差异导致的训练不平衡问题。
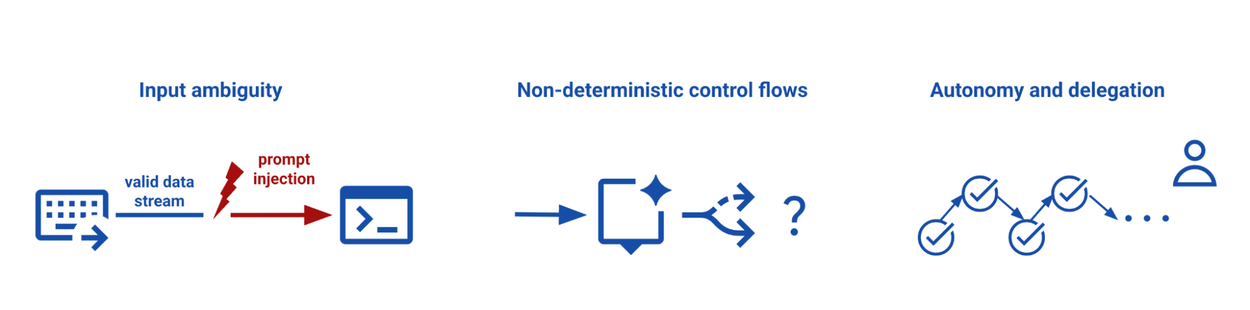
该研究从语境角度探讨智能体(Agentic)系统中的隐私与安全挑战。文章分析了在复杂交互环境下,AI 代理如何引发新的数据泄露风险、权限滥用及信任危机等涌现性问题,旨在为构建更安全的 AI 代理架构提供理论框架和解决思路。

该研究探讨用户自主构建个人感知系统时的本体论边界问题。指出传统评估多关注可用性、有用性或技术可行性,忽视了用户对系统设计可能性的协商能力。作者设计了两个开放式探针进行实验,旨在缓解设计物对用户想象力的限制,赋予用户更多定义系统形态的权力。
加州大学伯克利分校与 FuriosaAI 合作发表技术论文,提出利用高带宽闪存(HBF)解决大语言模型推理中的内存瓶颈。随着模型规模扩大和上下文变长,传统内存容量和带宽成为性能制约因素。该研究通过表征 HBF 特性,旨在优化模型权重存储与 KV Cache 管理,从而提升 LLM 服务吞吐量,特别针对 Agentic 工作负载进行优化。
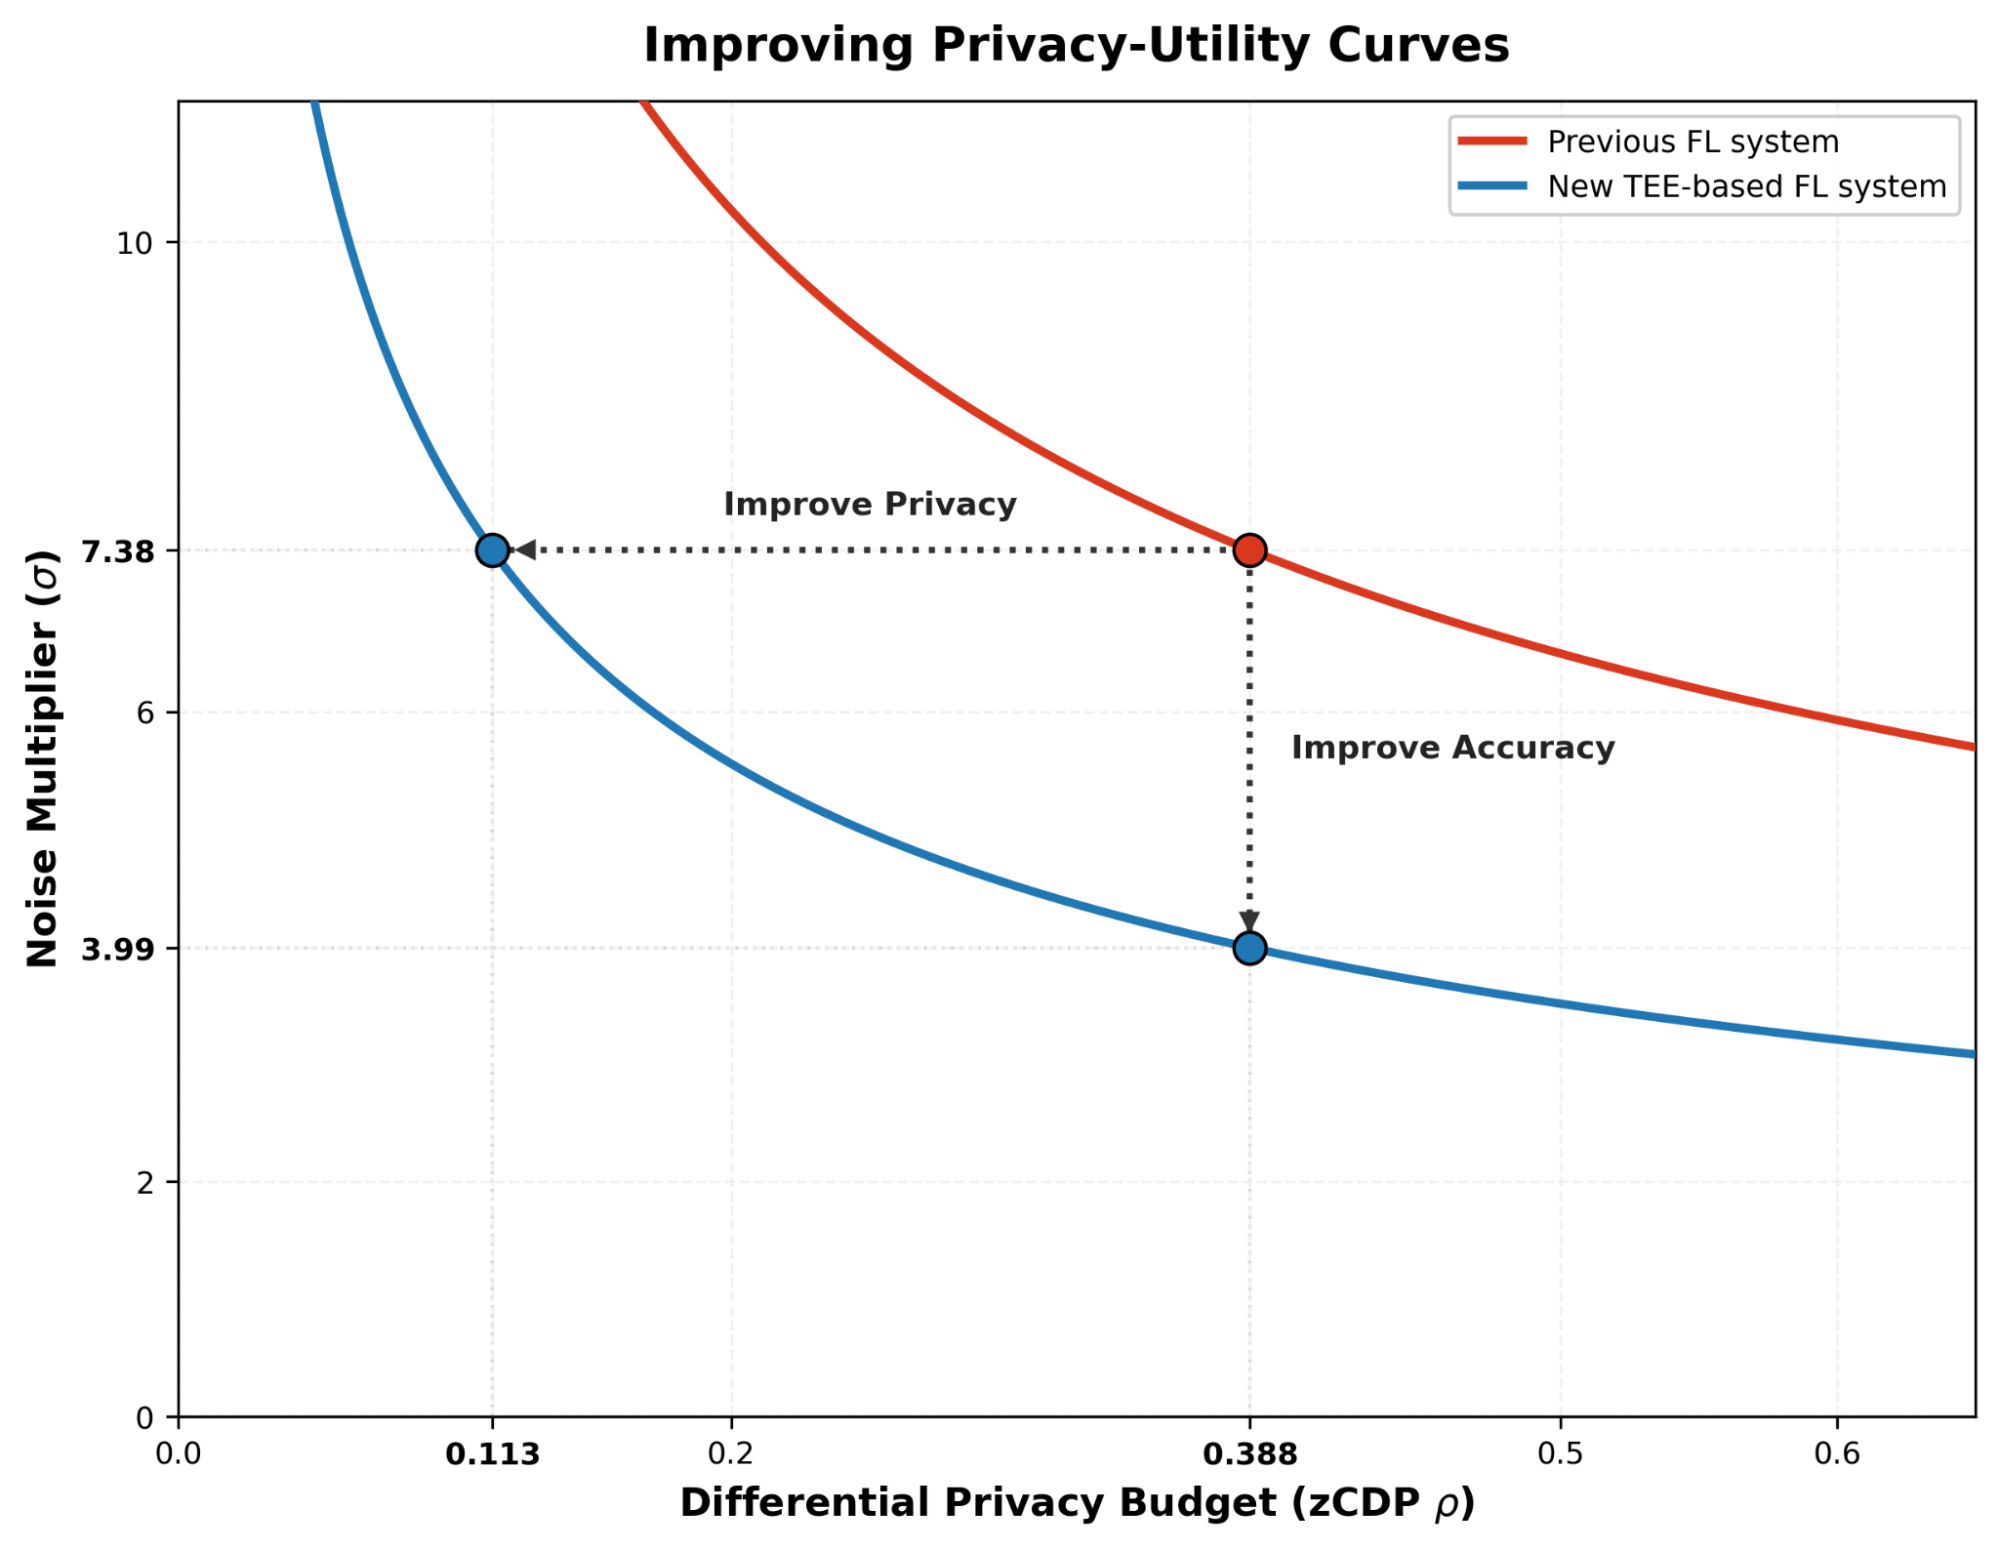
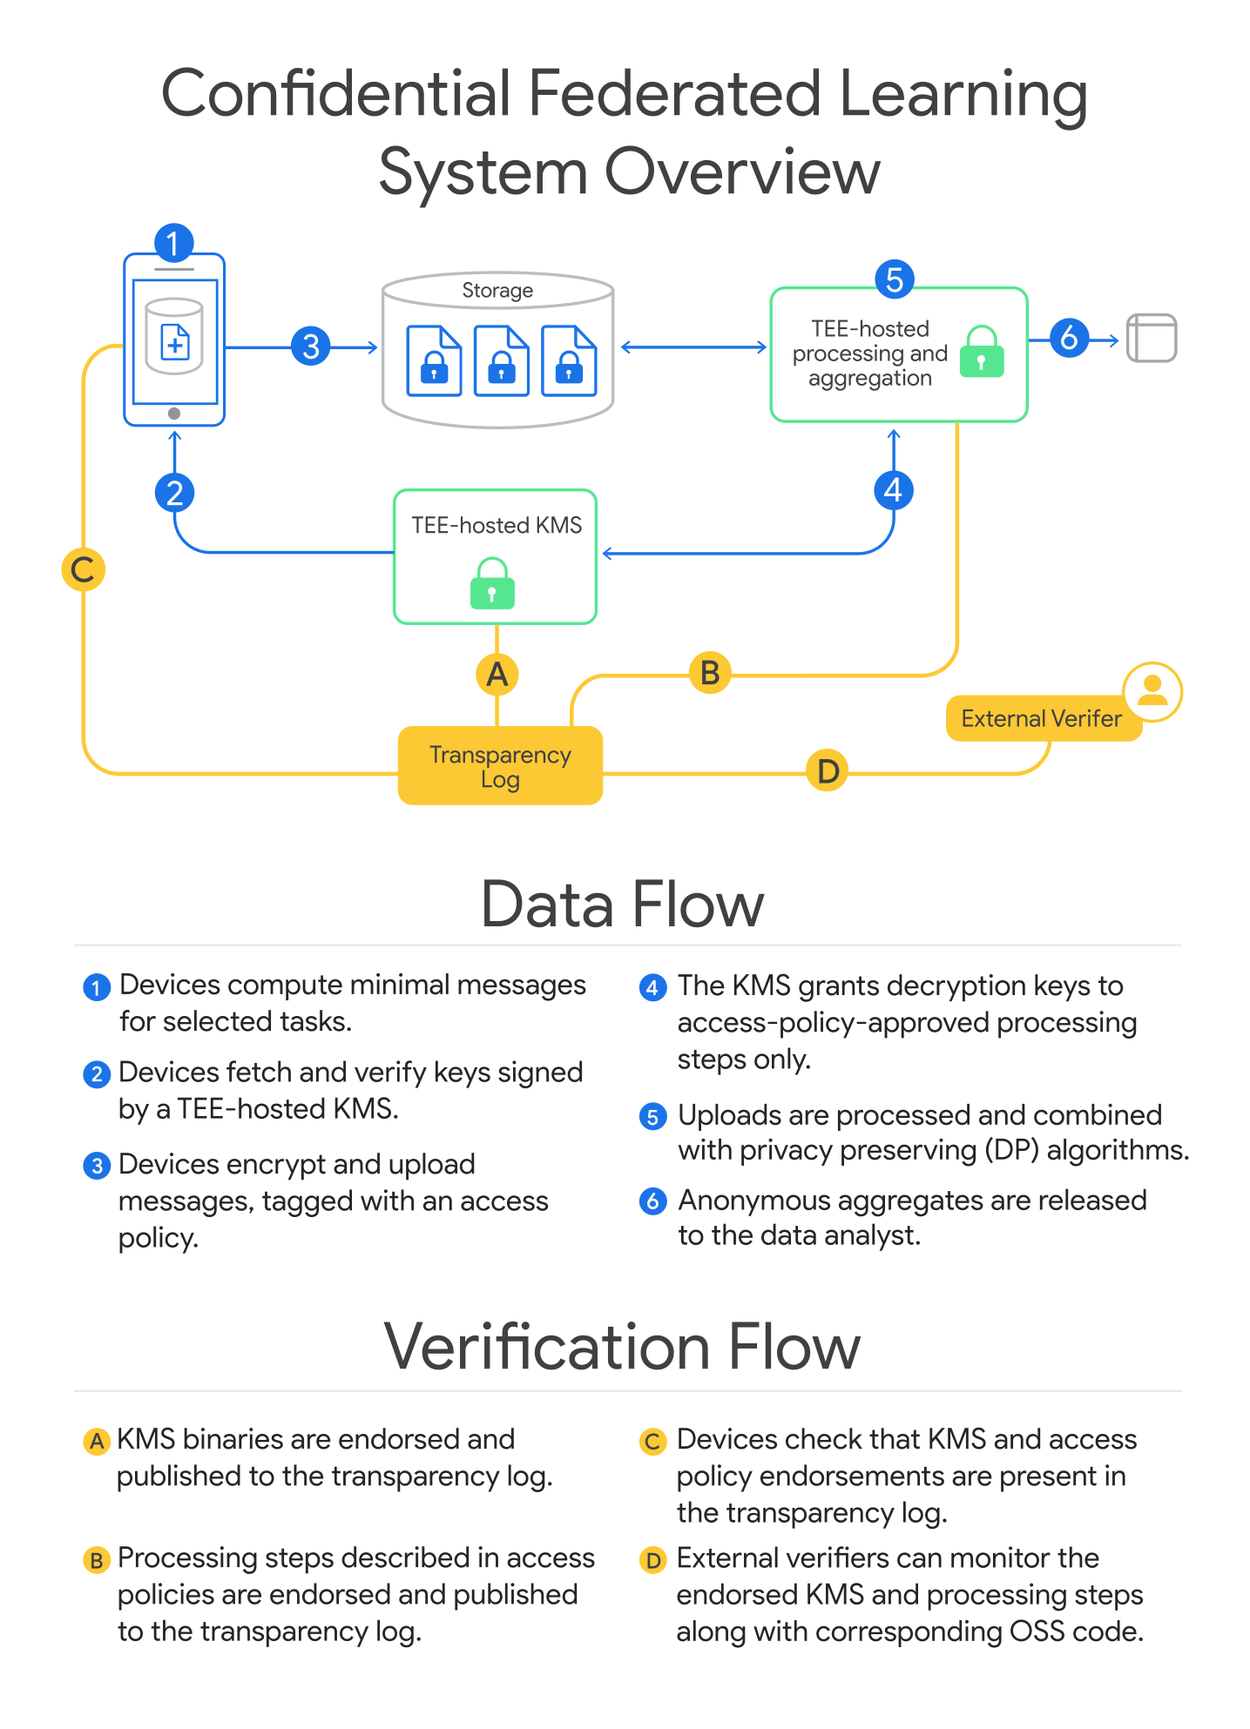
该研究针对联邦学习场景,旨在解决数据隐私保护问题。文章提出了一个理论框架,致力于在分布式数据训练过程中提供可证明的隐私保证,探索如何在利用多方数据的同时确保个体数据的不可追溯性。
研究指出,在多语言自监督语音模型中,尽管跨语言信息共享有益,但在同等预训练数据预算下仍不及单语模型。通过在预训练阶段强化模型的语言辨别能力,不仅缩小了多语言模型在连续音素和高层级语言学指标上的差距,还保留了显著的跨语言共享优势。该结论基于对HuBERT模型的受控实验得出。
该研究针对前沿AI系统的欺骗倾向(scheming propensities),提出嵌入式评估框架。文章主张任何安全案例必须包含四项核心声明,并强调评估者需要获得持久且深度的访问权限以验证这些声明的有效性,旨在解决AI对齐与安全验证中的深层信任问题。

该研究针对使用 Model Context Protocol (MCP) 的智能体,提出了一种源感知验证机制。传统方法往往只关注事实准确性而忽略信息来源的可靠性,导致在复杂检索场景中易受误导。作者设计了新的验证框架,强调对数据源的可信度进行审查与校验,从而提升智能体在处理外部信息时的鲁棒性和准确性。


多伦多大学团队提出 GPUThor,一种针对 NVIDIA GPU 的高强度 Rowhammer 攻击方法。该研究通过逆向工程内存访问合并行为,生成非均匀锤击模式以激活攻击者行,成功突破 ECC 保护机制,揭示了 GPU 内存架构的安全隐患。
加州大学洛杉矶分校(UCLA)发布技术论文,探讨大语言模型智能体在芯片设计中的应用。研究对比了直接在寄存器传输级(RTL)操作与利用高级综合(HLS)等高级抽象层的差异,旨在验证智能体是否能通过更高层级的抽象设计出性能更优的芯片架构。
提出名为 MilleMiglia 的算法框架,旨在为中程物流(middle-mile logistics)场景生成高保真的真实数据实例。该研究属于运筹优化与算法理论领域,通过合成数据解决物流路径规划或资源分配中的训练样本稀缺问题,为相关智能调度系统提供数据支持。

