 Simon Willisonby Simon Willison · 推文AI评分:50/100
我的LLM陈词滥调高亮器现在支持38种模式
Simon Willison 更新了他的 LLM 陈词滥调高亮器,现在能识别 38 种常见模式,帮助写作者避免使用陈词滥调。
 Simon Willisonby Simon Willison · 推文AI评分:50/100
Simon Willison 更新了他的 LLM 陈词滥调高亮器,现在能识别 38 种常见模式,帮助写作者避免使用陈词滥调。
 向阳乔木by 向阳乔木 · 推文AI评分:50/100
作者认为,腾讯Hy4 preview通过内部专家共建高质量数据,在真实生产力任务上取得显著进步,这印证了数据质量对模型表现的重要性。作者批评只重算法不重数据的厂商,主张应重视数据建设。
向阳乔木by 向阳乔木 · 长文AI评分:70/100腾讯发布混元 Hy4 preview 模型,总参数770B,激活49B,上下文1M,强化了多步骤Agent、代码开发和生产力任务能力。实测显示前端审美大幅提升,长程任务稳定,能生成动效画布、在线鼓机、游戏等,并主动询问和遵守版权。模型已内置到Workbuddy,免费试用两周。
 Gorden Sunby Gorden Sun · 推文AI评分:70/100
加州北区联邦法院裁定,美国政府因Anthropic拒绝将Claude用于大规模监控和自主武器而将其列入供应链风险并禁止合作,属于非法报复。法院认为封杀违反第一修正案和正当程序,支持Anthropic诉求。

 歸藏by 歸藏 · 推文AI评分:70/100
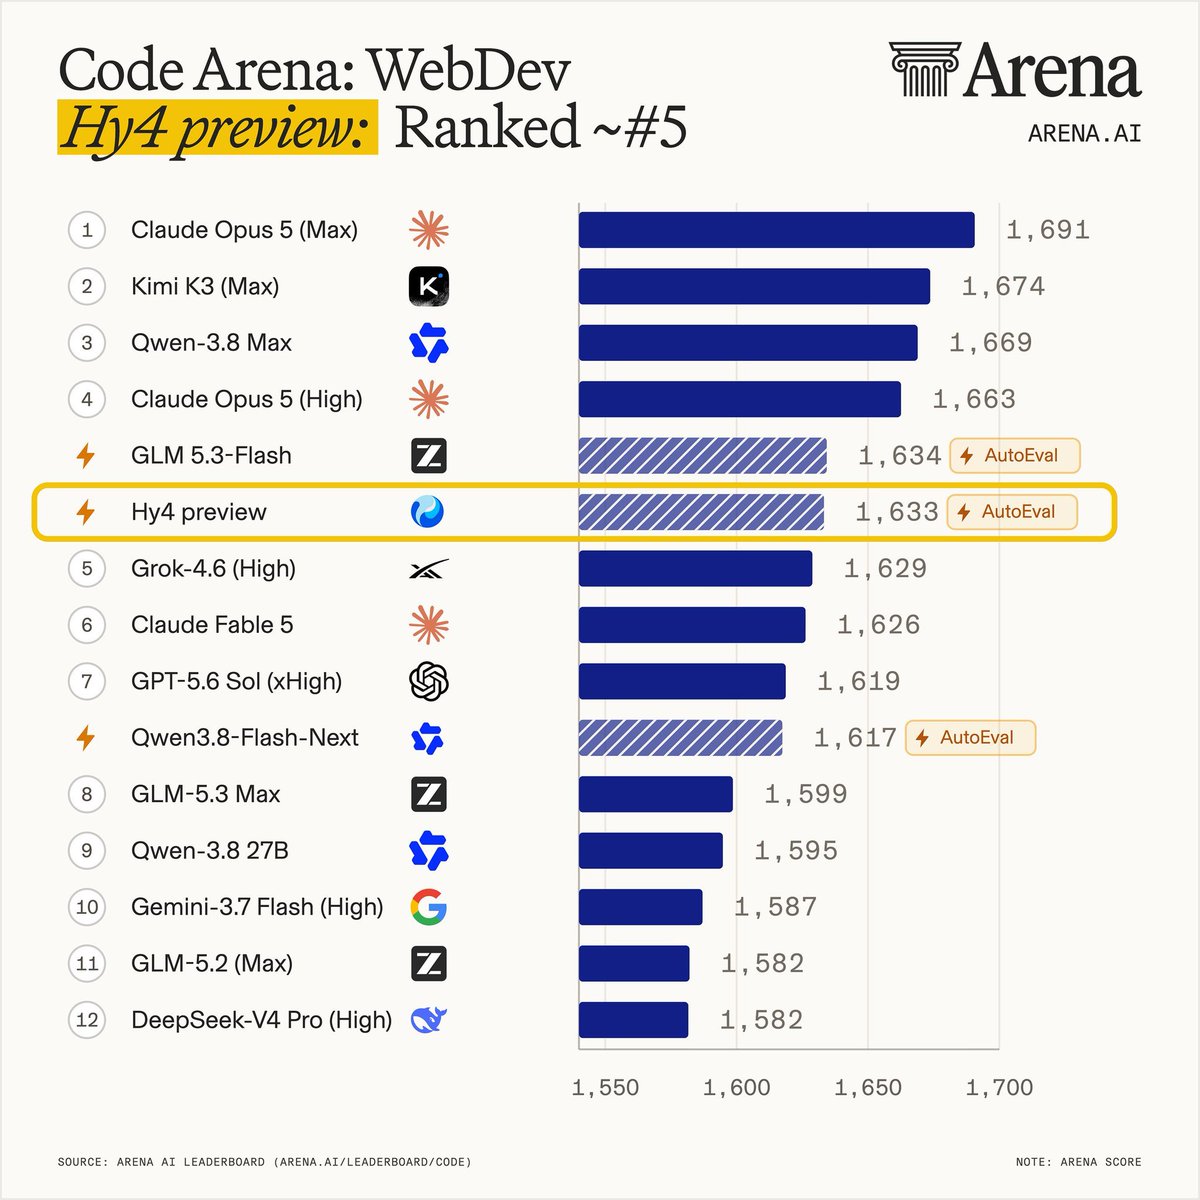
腾讯混元4Preview模型发布,在Arena的WebDEV评分中排名第五,与刚发布的GLM-5.3Flash相近。该模型总参数770B,激活参数49B。
 Qwenby Qwen · 推文AI评分:50/100
OpenCode 宣布 Qwen3.8-Flash 模型现已在 OpenCode Go 中可用,支持 125B/6B 参数、1M 上下文和多模态能力。
 Jerry Liuby Jerry Liu · 推文AI评分:30/100
Grok 机器人出奇地有趣。从 Claude Code/Cowork/Codex 转过来,我原本没期望会这么喜欢它,但我严重低估了拥有持久云计算机的好处。
Jerry Liuby Jerry Liu · 推文AI评分:50/100PDF解析很有趣,因为企业文档种类繁多。对于每种文档,都需要精确的边界框、置信度和领域特定标注,以便为下游代理提供丰富元数据。以表单为例,除了输出为markdown,我们检测每个注释、字段、复选框和部分,从而无需单独的LLM提取步骤即可获得结构化信息,并附带来源引用。这很难,但值得优化。查看LlamaParse!

 Matt Shumerby Matt Shumer · 推文AI评分:30/100
很多人说 Gauntlet Loops 不适用于没有现实世界对应物的构建(例如 Claude of Duty 是针对 CoD 进行基准测试的)。在这种情况下,只需使用 gpt-image-2 生成你正在构建的物体的图像!试试看效果如何。
Gorden Sunby Gorden Sun · 推文AI评分:70/100OpenAI联合微软、谷歌、亚马逊、Anthropic等上百家企业发布公开信,呼吁各界加强AI网络安全防御。信中指出,AI技术发展迅速,未来数月可能出现更严重的AI网络攻击,关键基础设施如医院、电网等易受攻击。倡议各方协同行动:企业应修补漏洞、加强权限管理;安全公司应开发廉价AI防护工具;政府应提供支持并打击黑客;AI大厂应提供更强模型和资金支援。
Gorden Sunby Gorden Sun · 推文AI评分:70/100Cohere 发布文档解析模型 Parse 5,支持文本、表格、表单和图像识别,并提供边界框定位,便于 RAG 和自动化处理。定价每 1000 页 1.50 美元,比前沿模型和主流云服务便宜 95%,比 Mistral 便宜 63%。模型未开源,可通过 API 或 HuggingFace 体验。
向阳乔木by 向阳乔木 · 推文AI评分:50/100感觉Grok Bot最佳场景之一是各种榜单监控,自动化测试。比如让它监控Github Trend,给项目写摘要,自动安装运行给报告。让它每天自动访问Producthunt,发现好的产品,自动注册测试,每天9点发昨天的体验报告。它能一直运行,登录你给的各种账号,超级的Computer Use。群聊协作目前还没感觉到特别大的必要性。
 Gorden Sunby Gorden Sun · 推文AI评分:50/100
谷歌发布Gemini Omni 1.1 Flash,感觉提升不明显但够用。Gemini Pro会员在Flow里每月可生成100个10秒视频,额度充足。同时发布了生成视频的提示词手册。

 Artificial Analysisby Artificial Analysis · 推文AI评分:70/100
新加坡 AI 实验室 Agnes AI 发布了 Agnes 2.5 Pro Beta,在 Artificial Analysis 智能指数上得分 49,较 Alpha 版提升 9 分,主要得益于智能体能力的显著增强,但输出 token 消耗约为前代的两倍。该模型在智能体指数上从 25 跃升至 44,接近 Gemini 3.7 Flash,同时在前沿推理评测中也有小幅提升。模型支持 1M 上下文,定价为每百万输入/输出/缓存命中 token 0.10/0.30/0.01 美元,现可通过其 API 使用。
 向阳乔木by 向阳乔木 · 推文AI评分:30/100
Codex 的电脑使用回顾功能记录了一周电脑操作,生成了一份 recap 报告。报告显示:研究风格很少只做抽象研究,常将 PDF 转化为网站、PPT、视频等;常用工具包括 Chrome、微信、Finder、AI 编程工具等;写作风格具体、有冲劲、重视证据,且适合重复利用。

 AKby AK · 推文AI评分:70/100
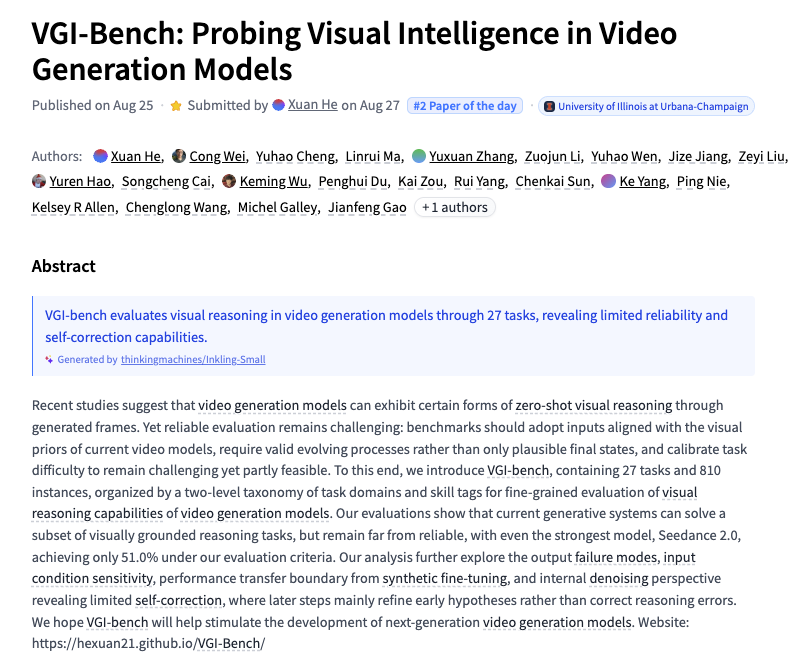
该论文提出VGI-Bench基准,用于系统评估视频生成模型的视觉智能水平。通过设计涵盖物理规律、因果推理、空间关系等维度的测试任务,量化模型对视觉世界的理解能力,为视频生成模型的智能评估提供新标准。
 Gorden Sunby Gorden Sun · 推文AI评分:70/100
Google 团队发布了 GlucoFM,一个针对连续血糖监测(CGM)数据的基础模型。该模型利用超过 10 万小时无标注的真实血糖数据进行训练,能够将血糖走势分解为基础水平和突发波动两个信号。在预测糖尿病风险、胰岛素抵抗等 7 种代谢健康问题上,其准确度优于现有模型;还能根据餐前血糖和饮食信息预测餐后血糖,且在小样本和跨机构场景下具有较好的适应性。模型目前未开源。

 Elon Muskby Elon Musk · 推文AI评分:50/100
Grok 现已登陆 Microsoft Foundry。
 Orange AIby Orange AI · 长文AI评分:50/100
发布了一个基于 Claude Opus 4.6 的写作 Skill,通过分析一篇获奖文章提炼出写作技巧,包括数字运用、物件描写、重复结构等,并提供了使用方法和推荐模型。
向阳乔木by 向阳乔木 · 推文AI评分:30/100TTS语音合成模型领域的OpenRouter,YC投资,注册就送100美元。刚测试生成了中英文各一条,消耗0.02美金,太棒了!地址见评论区。

 向阳乔木by 向阳乔木 · 推文AI评分:30/100
用户开始体验 Grok 的 Computer Use 功能,认为其操作浏览器更原生,可自动打开 Product Hunt 并登录谷歌账号测试产品生成报告,类似场景可用于调研分析,至少算高级爬虫。

 François Cholletby François Chollet · 推文AI评分:50/100
作者主张在可验证领域,模型能力扩展应保持无界。论据是模型通过吸收越来越多的计算宇宙而持续改进,而计算宇宙在构造上是无限的。
 MiniMaxby MiniMax · 推文AI评分:50/100
fal 团队发布深度解析,介绍如何结合后训练与协同设计的推理栈构建 H3 Max,以提升提示遵循、视觉质量和速度。MiniMax H3 作为基础模型,团队对此表示祝贺与感谢。
 Epoch AIby Epoch AI · 推文AI评分:50/100
2025年,Anthropic和OpenAI已是历史上同规模公司中增长最快的。2026年,它们的营收增长进一步加速。@justjoshinyou13和@lynette_bye在最新一期通讯中讨论了这对AI未来的意义。
 MiniMaxby MiniMax · 推文AI评分:50/100
fal 团队优化了 MiniMax-H3 Max 模型,提升了实际性能,并协同设计推理系统以实现超实时速度。这结合了前沿模型研究与深度推理优化能力,展示了第三方后训练模型的潜力。
 Harrison Chaseby Harrison Chase · 推文AI评分:30/100
作者坚信多代理世界,每个代理领域特定,因此Benchling将创造最佳科学AI代理,而非Anthropic或OpenAI。
 Ethan Mollickby Ethan Mollick · 推文AI评分:50/100
作者实验发现,H3 Max通过网页界面即可在观看时间内生成高质量AI视频,从点击生成按钮到完成几乎实时,且包含提示增强功能。
 Epoch AIby Epoch AI · 推文AI评分:50/100
过去几周,我们非正式测试了 GPT-5.6 Sol 的计算机使用能力,让它玩《杀戮尖塔》。发现其限制不在操作,而在战术与策略,表现优于新手但低于专家。

 Cursorby Cursor · 推文AI评分:50/100
Cursor 现在支持创建新的 Web 应用,代码存储在 Origin,并可一键部署到 Vercel。
 Matt Shumerby Matt Shumer · 推文AI评分:30/100
增加到5台机器!再次澄清,我没有运行本地模型(抱歉,它们太差了)。这纯粹是为了让数百个前沿智能体协作处理大型项目。