 Simon Willisonby Simon Willison · 推文AI评分:50/100
我的LLM陈词滥调高亮器现在支持38种模式
Simon Willison 更新了他的 LLM 陈词滥调高亮器,现在能识别 38 种常见模式,帮助写作者避免使用陈词滥调。
 Simon Willisonby Simon Willison · 推文AI评分:50/100
Simon Willison 更新了他的 LLM 陈词滥调高亮器,现在能识别 38 种常见模式,帮助写作者避免使用陈词滥调。
 Jerry Liuby Jerry Liu · 推文AI评分:30/100
Grok 机器人出奇地有趣。从 Claude Code/Cowork/Codex 转过来,我原本没期望会这么喜欢它,但我严重低估了拥有持久云计算机的好处。
Jerry Liuby Jerry Liu · 推文AI评分:50/100PDF解析很有趣,因为企业文档种类繁多。对于每种文档,都需要精确的边界框、置信度和领域特定标注,以便为下游代理提供丰富元数据。以表单为例,除了输出为markdown,我们检测每个注释、字段、复选框和部分,从而无需单独的LLM提取步骤即可获得结构化信息,并附带来源引用。这很难,但值得优化。查看LlamaParse!

 Matt Shumerby Matt Shumer · 推文AI评分:30/100
很多人说 Gauntlet Loops 不适用于没有现实世界对应物的构建(例如 Claude of Duty 是针对 CoD 进行基准测试的)。在这种情况下,只需使用 gpt-image-2 生成你正在构建的物体的图像!试试看效果如何。
 Artificial Analysisby Artificial Analysis · 推文AI评分:70/100
新加坡 AI 实验室 Agnes AI 发布了 Agnes 2.5 Pro Beta,在 Artificial Analysis 智能指数上得分 49,较 Alpha 版提升 9 分,主要得益于智能体能力的显著增强,但输出 token 消耗约为前代的两倍。该模型在智能体指数上从 25 跃升至 44,接近 Gemini 3.7 Flash,同时在前沿推理评测中也有小幅提升。模型支持 1M 上下文,定价为每百万输入/输出/缓存命中 token 0.10/0.30/0.01 美元,现可通过其 API 使用。

 AKby AK · 推文AI评分:70/100
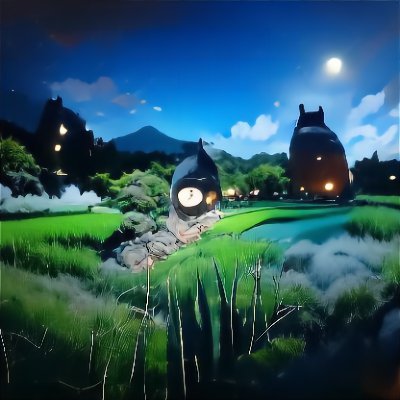
该论文提出VGI-Bench基准,用于系统评估视频生成模型的视觉智能水平。通过设计涵盖物理规律、因果推理、空间关系等维度的测试任务,量化模型对视觉世界的理解能力,为视频生成模型的智能评估提供新标准。
 Elon Muskby Elon Musk · 推文AI评分:50/100
Grok 现已登陆 Microsoft Foundry。
 François Cholletby François Chollet · 推文AI评分:50/100
作者主张在可验证领域,模型能力扩展应保持无界。论据是模型通过吸收越来越多的计算宇宙而持续改进,而计算宇宙在构造上是无限的。
 Epoch AIby Epoch AI · 推文AI评分:50/100
2025年,Anthropic和OpenAI已是历史上同规模公司中增长最快的。2026年,它们的营收增长进一步加速。@justjoshinyou13和@lynette_bye在最新一期通讯中讨论了这对AI未来的意义。

 Harrison Chaseby Harrison Chase · 推文AI评分:30/100
作者坚信多代理世界,每个代理领域特定,因此Benchling将创造最佳科学AI代理,而非Anthropic或OpenAI。
 Ethan Mollickby Ethan Mollick · 推文AI评分:50/100
作者实验发现,H3 Max通过网页界面即可在观看时间内生成高质量AI视频,从点击生成按钮到完成几乎实时,且包含提示增强功能。
 Epoch AIby Epoch AI · 推文AI评分:50/100
过去几周,我们非正式测试了 GPT-5.6 Sol 的计算机使用能力,让它玩《杀戮尖塔》。发现其限制不在操作,而在战术与策略,表现优于新手但低于专家。

 Cursorby Cursor · 推文AI评分:50/100
Cursor 现在支持创建新的 Web 应用,代码存储在 Origin,并可一键部署到 Vercel。
 Matt Shumerby Matt Shumer · 推文AI评分:30/100
增加到5台机器!再次澄清,我没有运行本地模型(抱歉,它们太差了)。这纯粹是为了让数百个前沿智能体协作处理大型项目。
 OpenAIby OpenAI · 推文AI评分:50/100
OpenAI与Anthropic、AWS、Google、Microsoft和Oracle等组织联合呼吁全球共同努力,为防御者提供工具、资源和支持,以保护关键基础设施。OpenAI表示,如果果断行动,可以将当前的AI进步转化为持久的安全改进,使数字世界更安全。

 Greg Brockmanby Greg Brockman · 推文AI评分:30/100
ChatGPT 现在可以帮你预约理发,这标志着它正逐步成为你的个人通用人工智能(AGI)。
 Sam Altmanby Sam Altman · 推文AI评分:50/100
作者强调当前是AI网络防御的关键时刻,时间紧迫,呼吁与竞争对手或合作伙伴共同采取紧急而密集的集体行动,否则无法有效应对。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100学者发现预印本网站出现多篇冒用其名的AI生成垃圾论文,其他学者也有类似遭遇。作者提醒勿轻信,并预测高质量AI论文工厂即将出现。
Ethan Mollickby Ethan Mollick · 推文AI评分:50/100一篇论文指出,任务自动化与人类增强并非必然相关。擅长执行任务的模型不一定擅长帮助人类更好地工作。在推动模型成为优秀智能体的压力下,这可能削弱人机协作。
 DAIR.AIby DAIR.AI · 推文AI评分:70/100
该研究提出从智能体轨迹中提取紧凑的有限状态机(FSM),以分析智能体行为中模型与外部框架的贡献。在12个公开数据集上,诱导出的FSM仅含7至43个状态,对保留数据的重放适应度达0.997,且跨分割拓扑几乎一致,构建时间仅需毫秒。FSM状态上下文在下一步预测上优于Agent Workflow Memory,基于状态的故障预测AUROC最高达0.94,在线监控可提前停止失败运行。作者认为行为拓扑更多由部署框架而非底层LLM塑造。
 Harrison Chaseby Harrison Chase · 推文AI评分:50/100
openwiki 现已支持 OKF 2.0。
Jerry Liuby Jerry Liu · 推文AI评分:70/100LlamaIndex 在 LlamaParse 中新增了原生智能体电子表格提取功能。该功能针对电子表格与 PDF 等文档格式的差异,采用代码解释器而非 OCR 方式,通过调优的智能体引擎(模型+框架)实现大规模模式引导的提取,可将资产负债表等密集表格转换为干净的结构化字段。用户可在 API 文档中集成,或在 UI 的 agentic plus 模式中启用电子表格选项。
 Greg Brockmanby Greg Brockman · 长文AI评分:70/100
包括Anthropic、AWS、Google、Microsoft、OpenAI和Oracle在内的100多家组织签署公开信,呼吁全球加强网络防御,以应对日益严重的AI网络攻击威胁。信中指出,AI能力提升将加剧攻击,但也能增强防御,提出提高安全标准、赋能防御者、集体响应等原则,并呼吁各组织、政府和科技公司立即行动。
 Google DeepMindby Google DeepMind · 推文AI评分:50/100
DeepMind研究副总裁Zoubin Ghahramani与主持人探讨了不确定性在AI决策中的作用,强调教会系统自我怀疑和概率思维,可以带来更安全、更可靠的实际决策。视频涵盖不确定性角色、正确性与置信度、贝叶斯思维等主题。

 Logan Kilpatrickby Logan Kilpatrick · 推文AI评分:70/100
Gemini Omni Flash 1.1 发布,支持 360p 草稿、4K 上采样、10 秒视频上下文扩展及视频引用。
 Ethan Mollickby Ethan Mollick · 推文AI评分:70/100
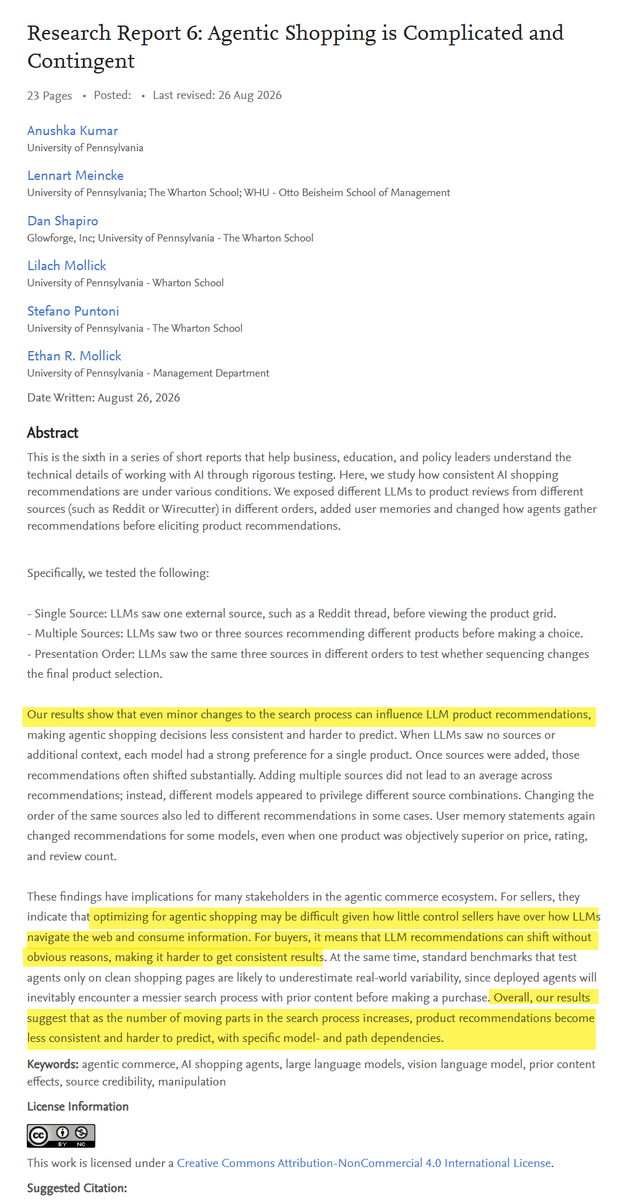
该研究探讨智能体购物行为,发现即使页面浏览顺序、记忆等微小差异也会导致AI偏好发生不可预测的变化,表明营销难以稳定影响智能体决策。

 Aidan Gomezby Aidan Gomez · 推文AI评分:50/100
Cohere 表示,解析是企业数据有效用于 LLM 的最大瓶颈之一。过去只能在高质量但昂贵且不可扩展的解析与低质量但可扩展的解析之间选择。现在,Cohere 宣称不再需要妥协。
 Ethan Mollickby Ethan Mollick · 推文AI评分:50/100
作者认为METR报告很有价值,但人们基于压力下的研究人员所做的思维链研究,过度赋予智能体人类动机和个性,这种拟人化会阻碍我们对AI的正确理解。
Google DeepMindby Google DeepMind · 推文AI评分:70/100谷歌宣布率先试点前沿AI双盲评估,通过创建安全环境,不泄露测试提示和模型权重,确保外部安全与性能评估的私密性、稳健性和可信度。

 Clément Delangueby Clément Delangue · 推文AI评分:70/100
Hugging Face今日发布Microduck,一款售价399美元的开源机器人,可通过强化学习训练新技能,如行走、拾物、跌倒后起身甚至轮滑。此举旨在推动物理AI和世界模型的民主化,降低机器人开发门槛。