精选 GitHub Blogby Michelle Zhou · 产品AI评分:70/100
ReviewBench:面向 AI 代码审查的开放基准测试
GitHub 发布 ReviewBench,这是一个针对 AI 代码审查智能体的开放基准测试。该基准基于具有代表性的 GitHub Pull Requests、多源真实标签、校准评估以及生产环境对齐指标构建,旨在客观衡量 AI 在代码审查场景下的实际表现与能力。

GitHub 发布 ReviewBench,这是一个针对 AI 代码审查智能体的开放基准测试。该基准基于具有代表性的 GitHub Pull Requests、多源真实标签、校准评估以及生产环境对齐指标构建,旨在客观衡量 AI 在代码审查场景下的实际表现与能力。
发布 Open TTS Leaderboard,旨在为多语言文本转语音(TTS)和声音克隆技术提供可扩展的评估标准。


斯坦福大学研究人员发表新研究,质疑主流AI评测基准的有效性。研究发现,许多声称测量偏见或推理能力的基准测试实际上并未达到预期目标,甚至出现相互矛盾的结果。例如,某偏见测试可能仅反映模型的阅读理解能力而非真实偏见。研究呼吁业界采用更严谨的科学方法重新评估AI性能。
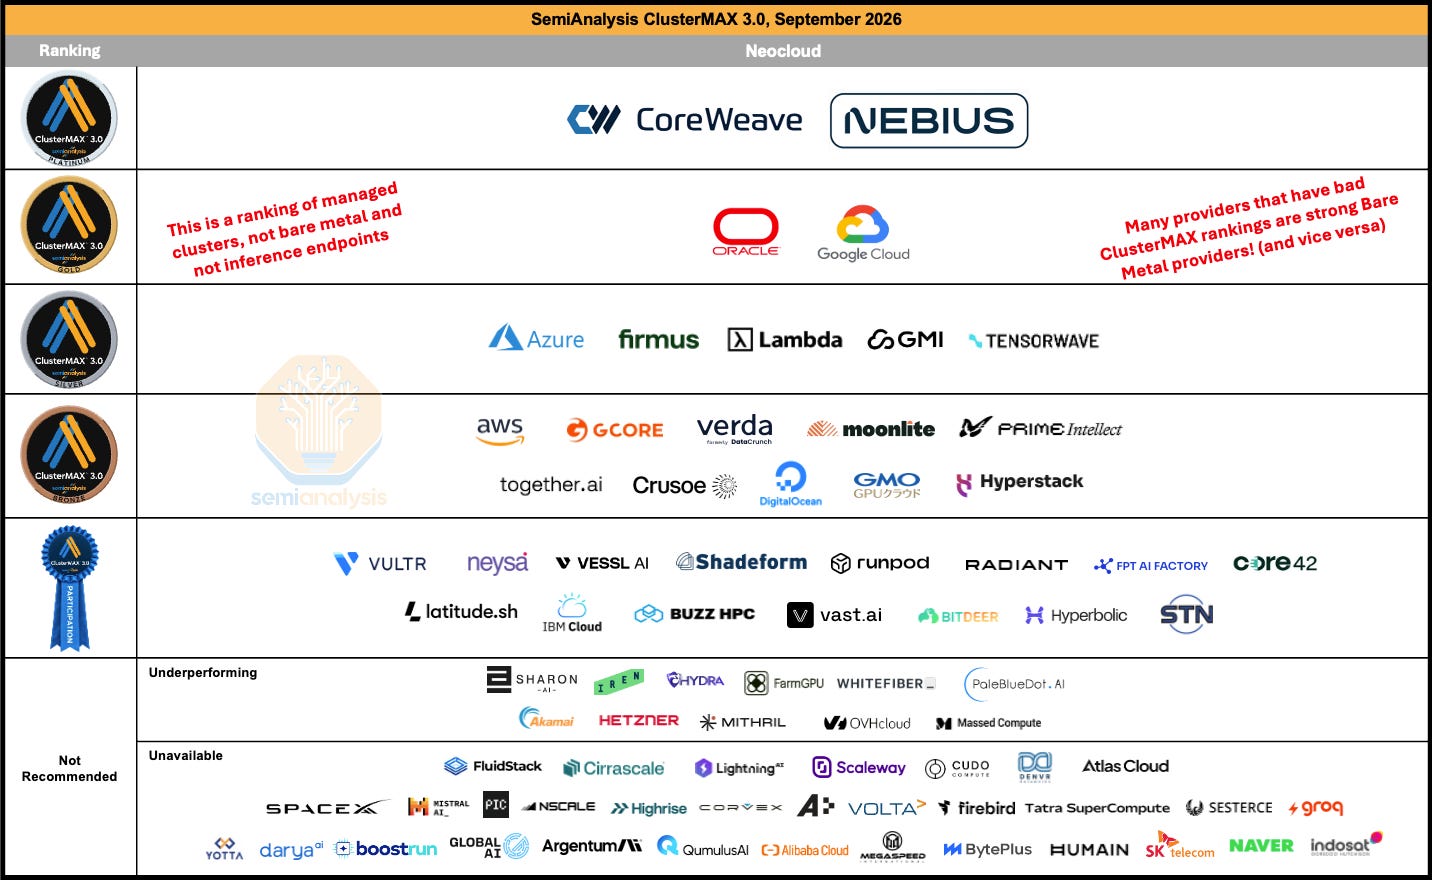
ClusterMAX 3.0 评测体系发布,从可靠性、性能、支持、定价及安全等维度对全球 GPU 云服务提供商进行深度分析。

MentalHealthBench 是一个由专家制定的基准测试,旨在评估人工智能在真实心理健康对话中提供有益且安全回应的能力。
英国人工智能研究所(AISI)与评估平台EvalEval合作,致力于解决AI模型基准测试中的结果不可复现问题。该举措旨在通过标准化流程和透明化数据,确保不同机构发布的性能评测具有可比性和可信度,为行业建立统一的评估标准。
Vals AI 获得 Andreessen Horowitz 投资,旨在建立一个中立且可信的 AI 模型基准测试平台。在 AI 模型泛滥的背景下,该组织致力于解决评测市场缺乏统一标准和信任度的问题,试图确立行业基准测试的黄金标准。
 AWS AI Blogby Surafel Lakew · 新闻AI评分:70/100
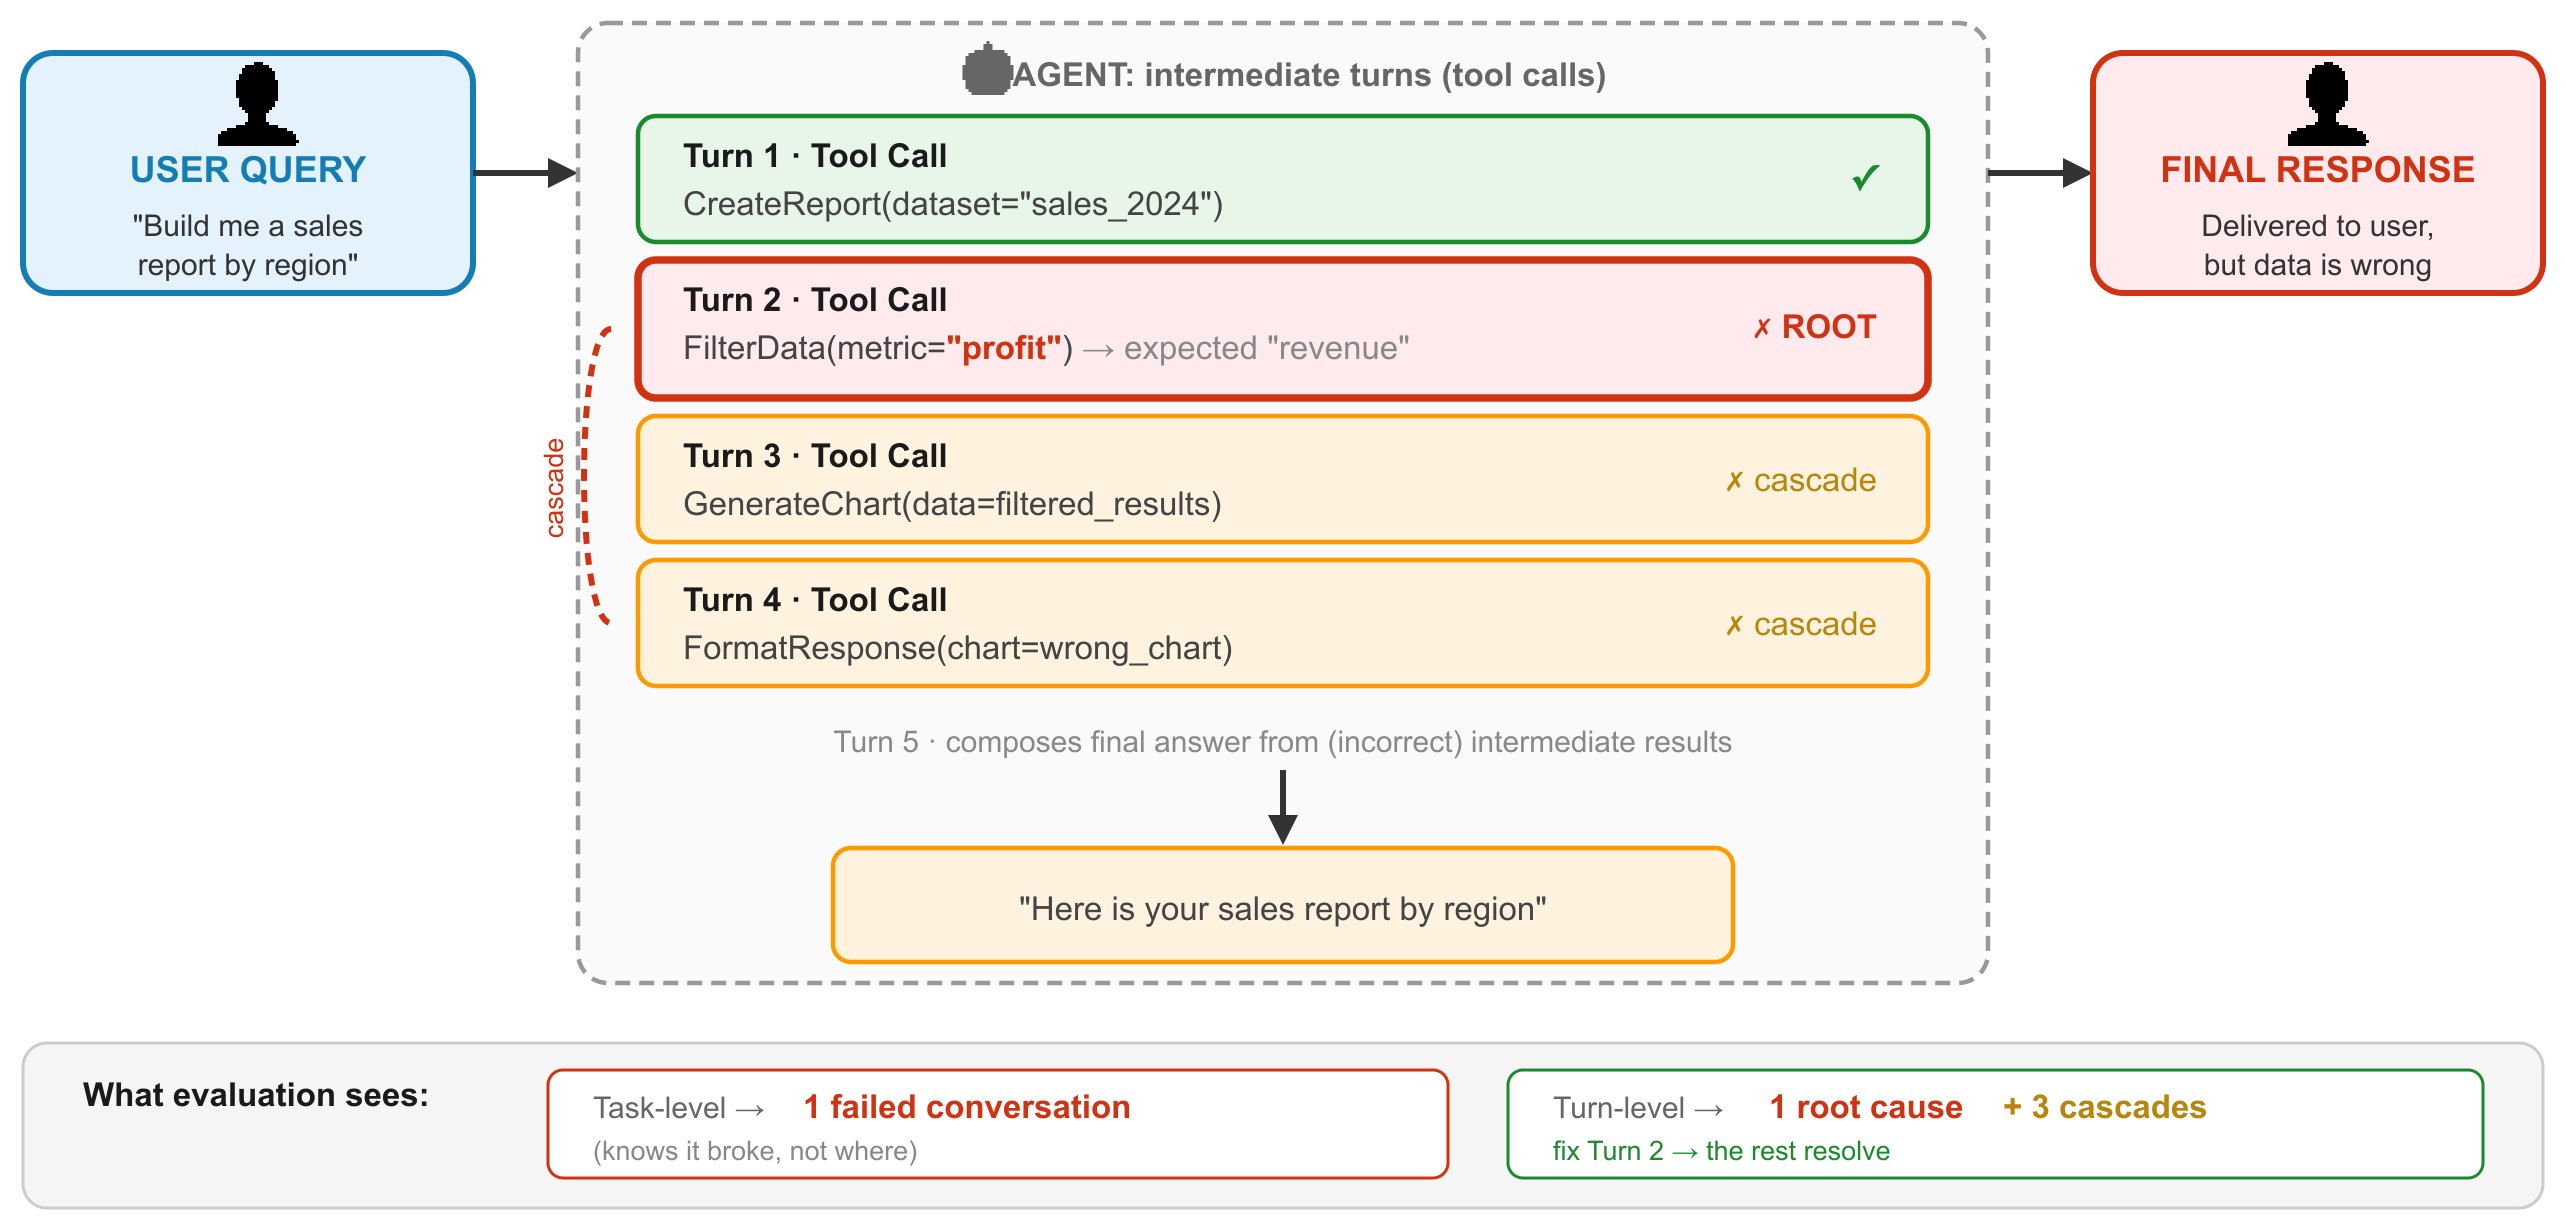
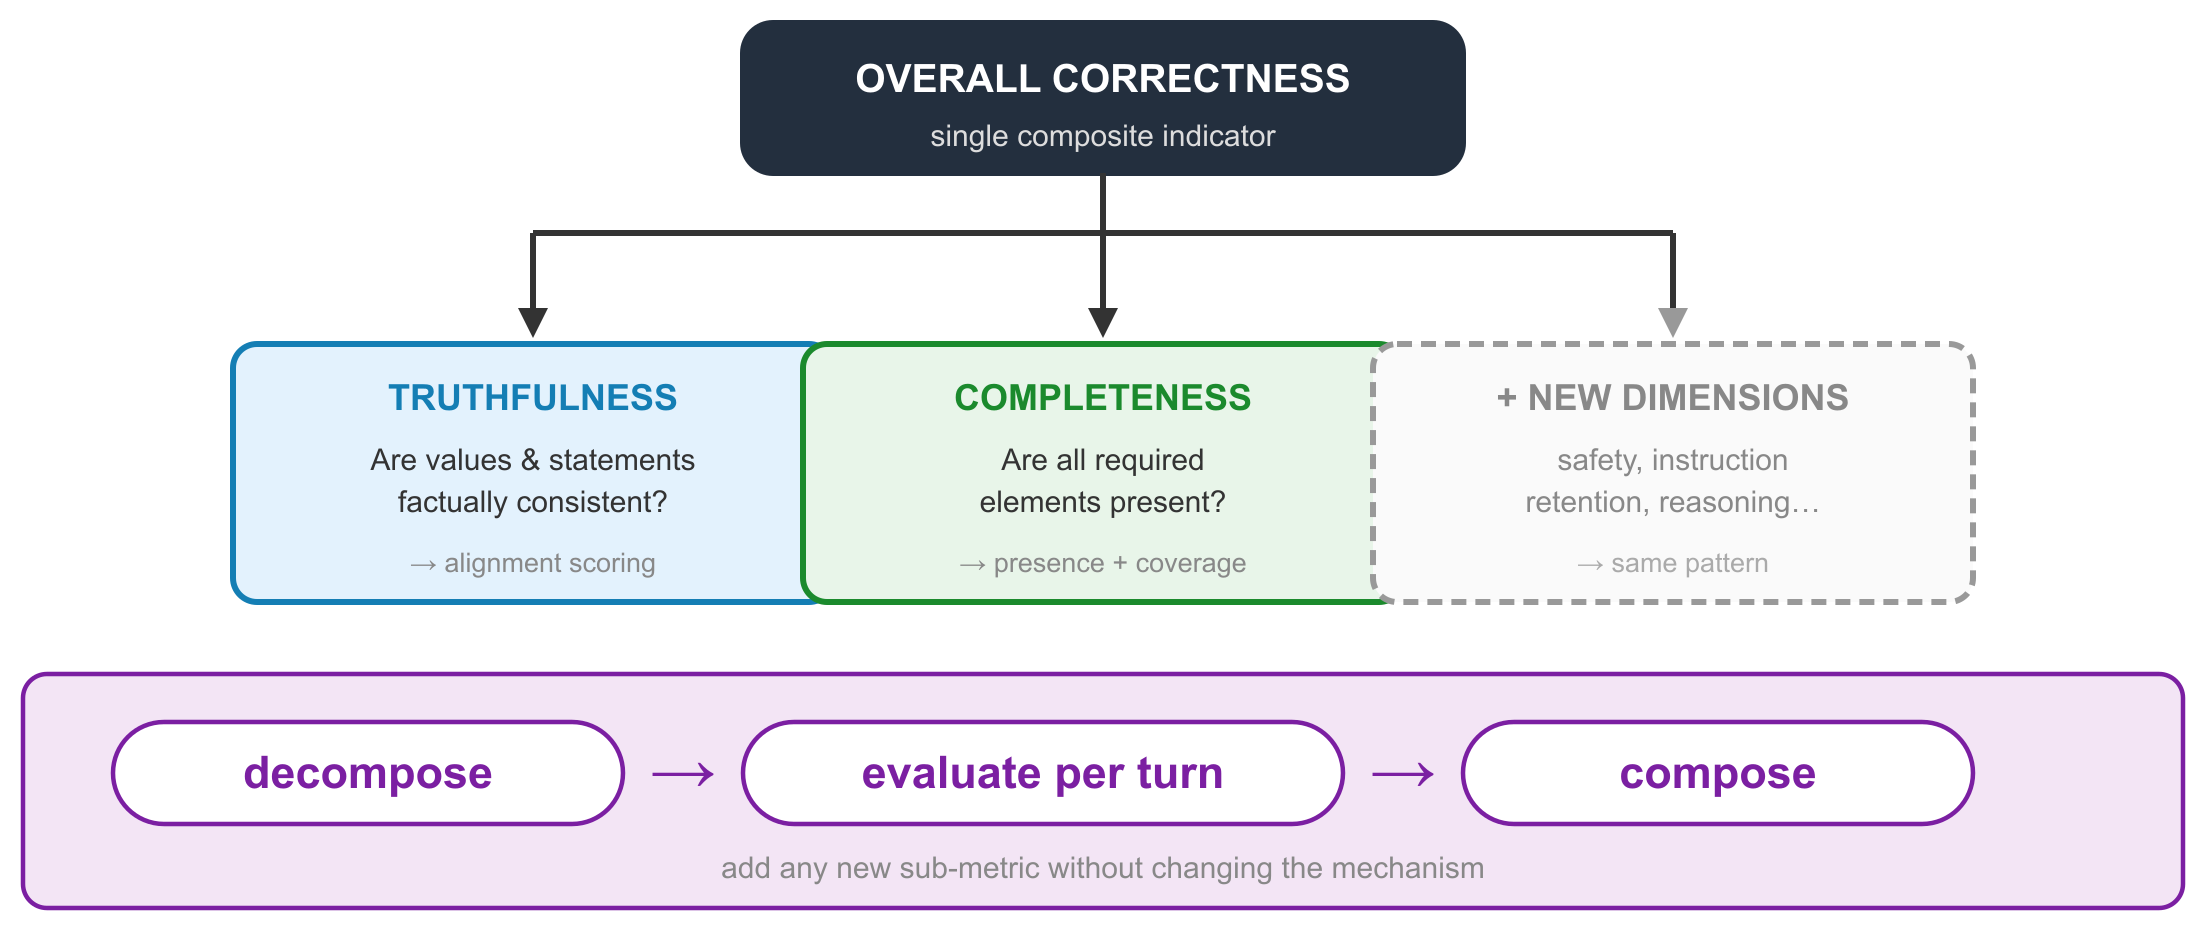
作者提出 Agent Evaluation Metric(AEM),一种可分解的逐轮评估方法,用于衡量多轮智能体的质量。多轮智能体的失败模式是单轮评估无法捕捉的:早期某一轮的错误会污染后续所有轮次。AEM 首个维度为正确性,可定位导致失败的具体轮次,并将其与被动继承错误的后续轮次区分开。
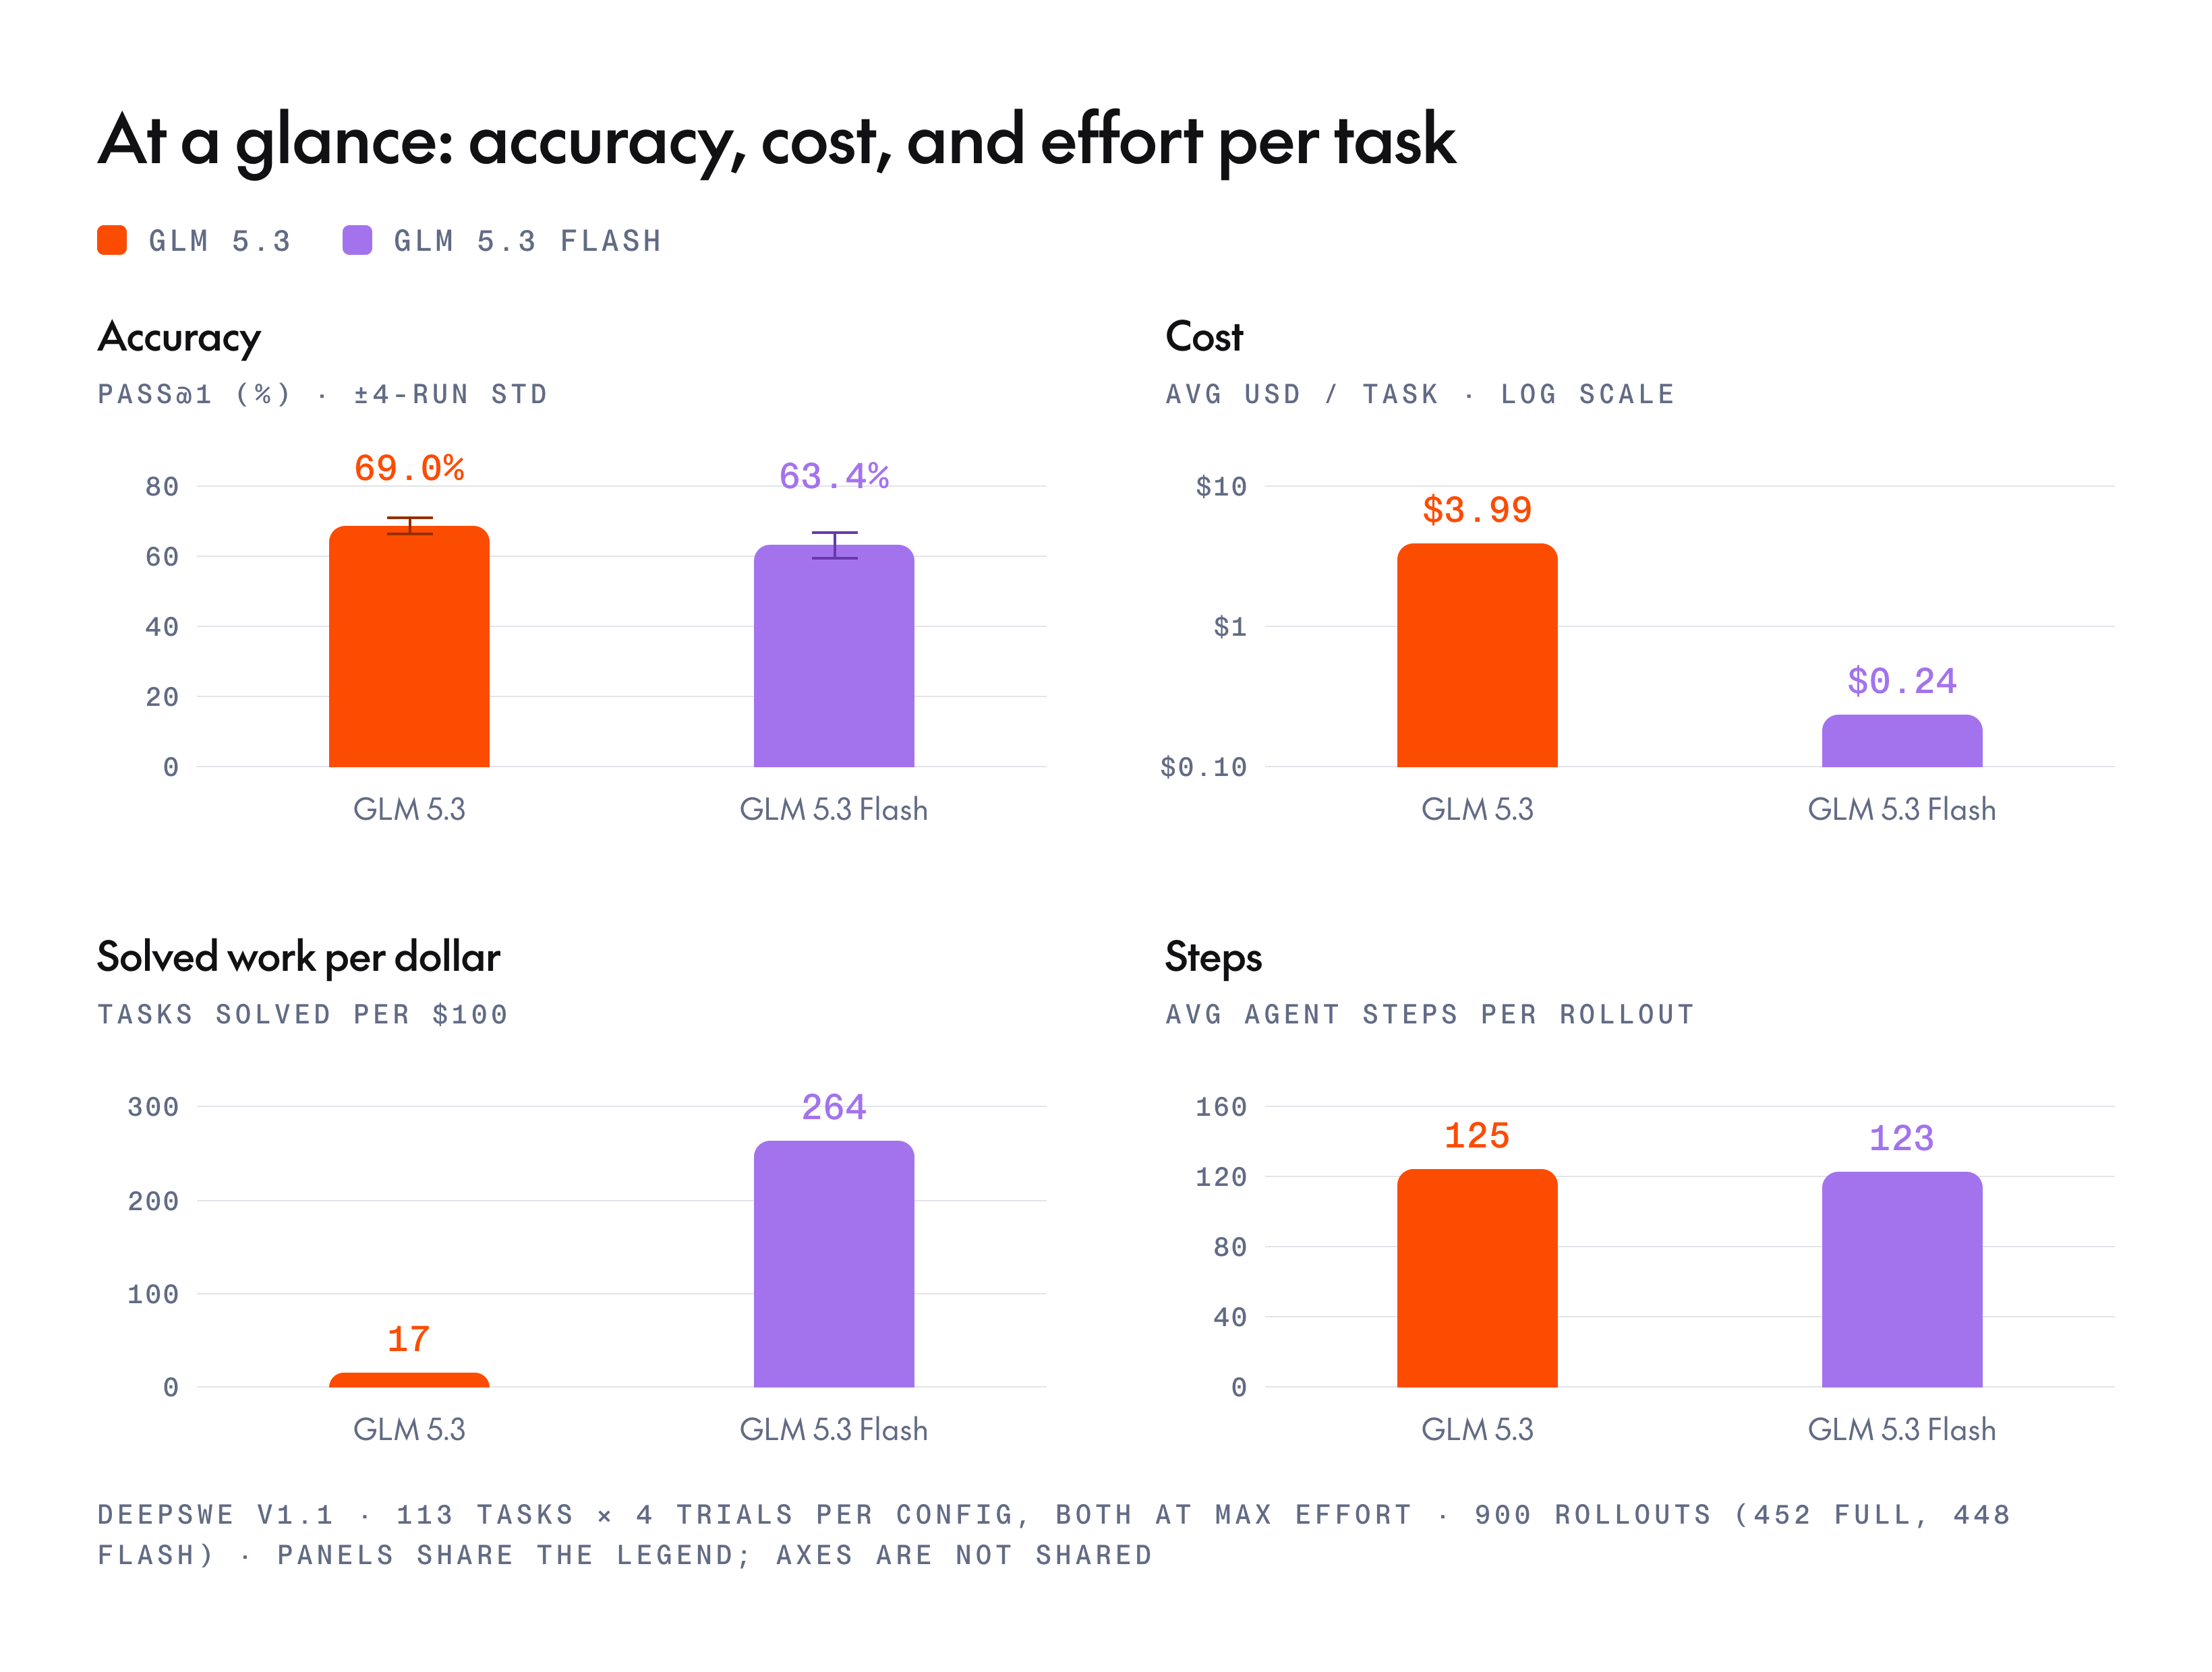
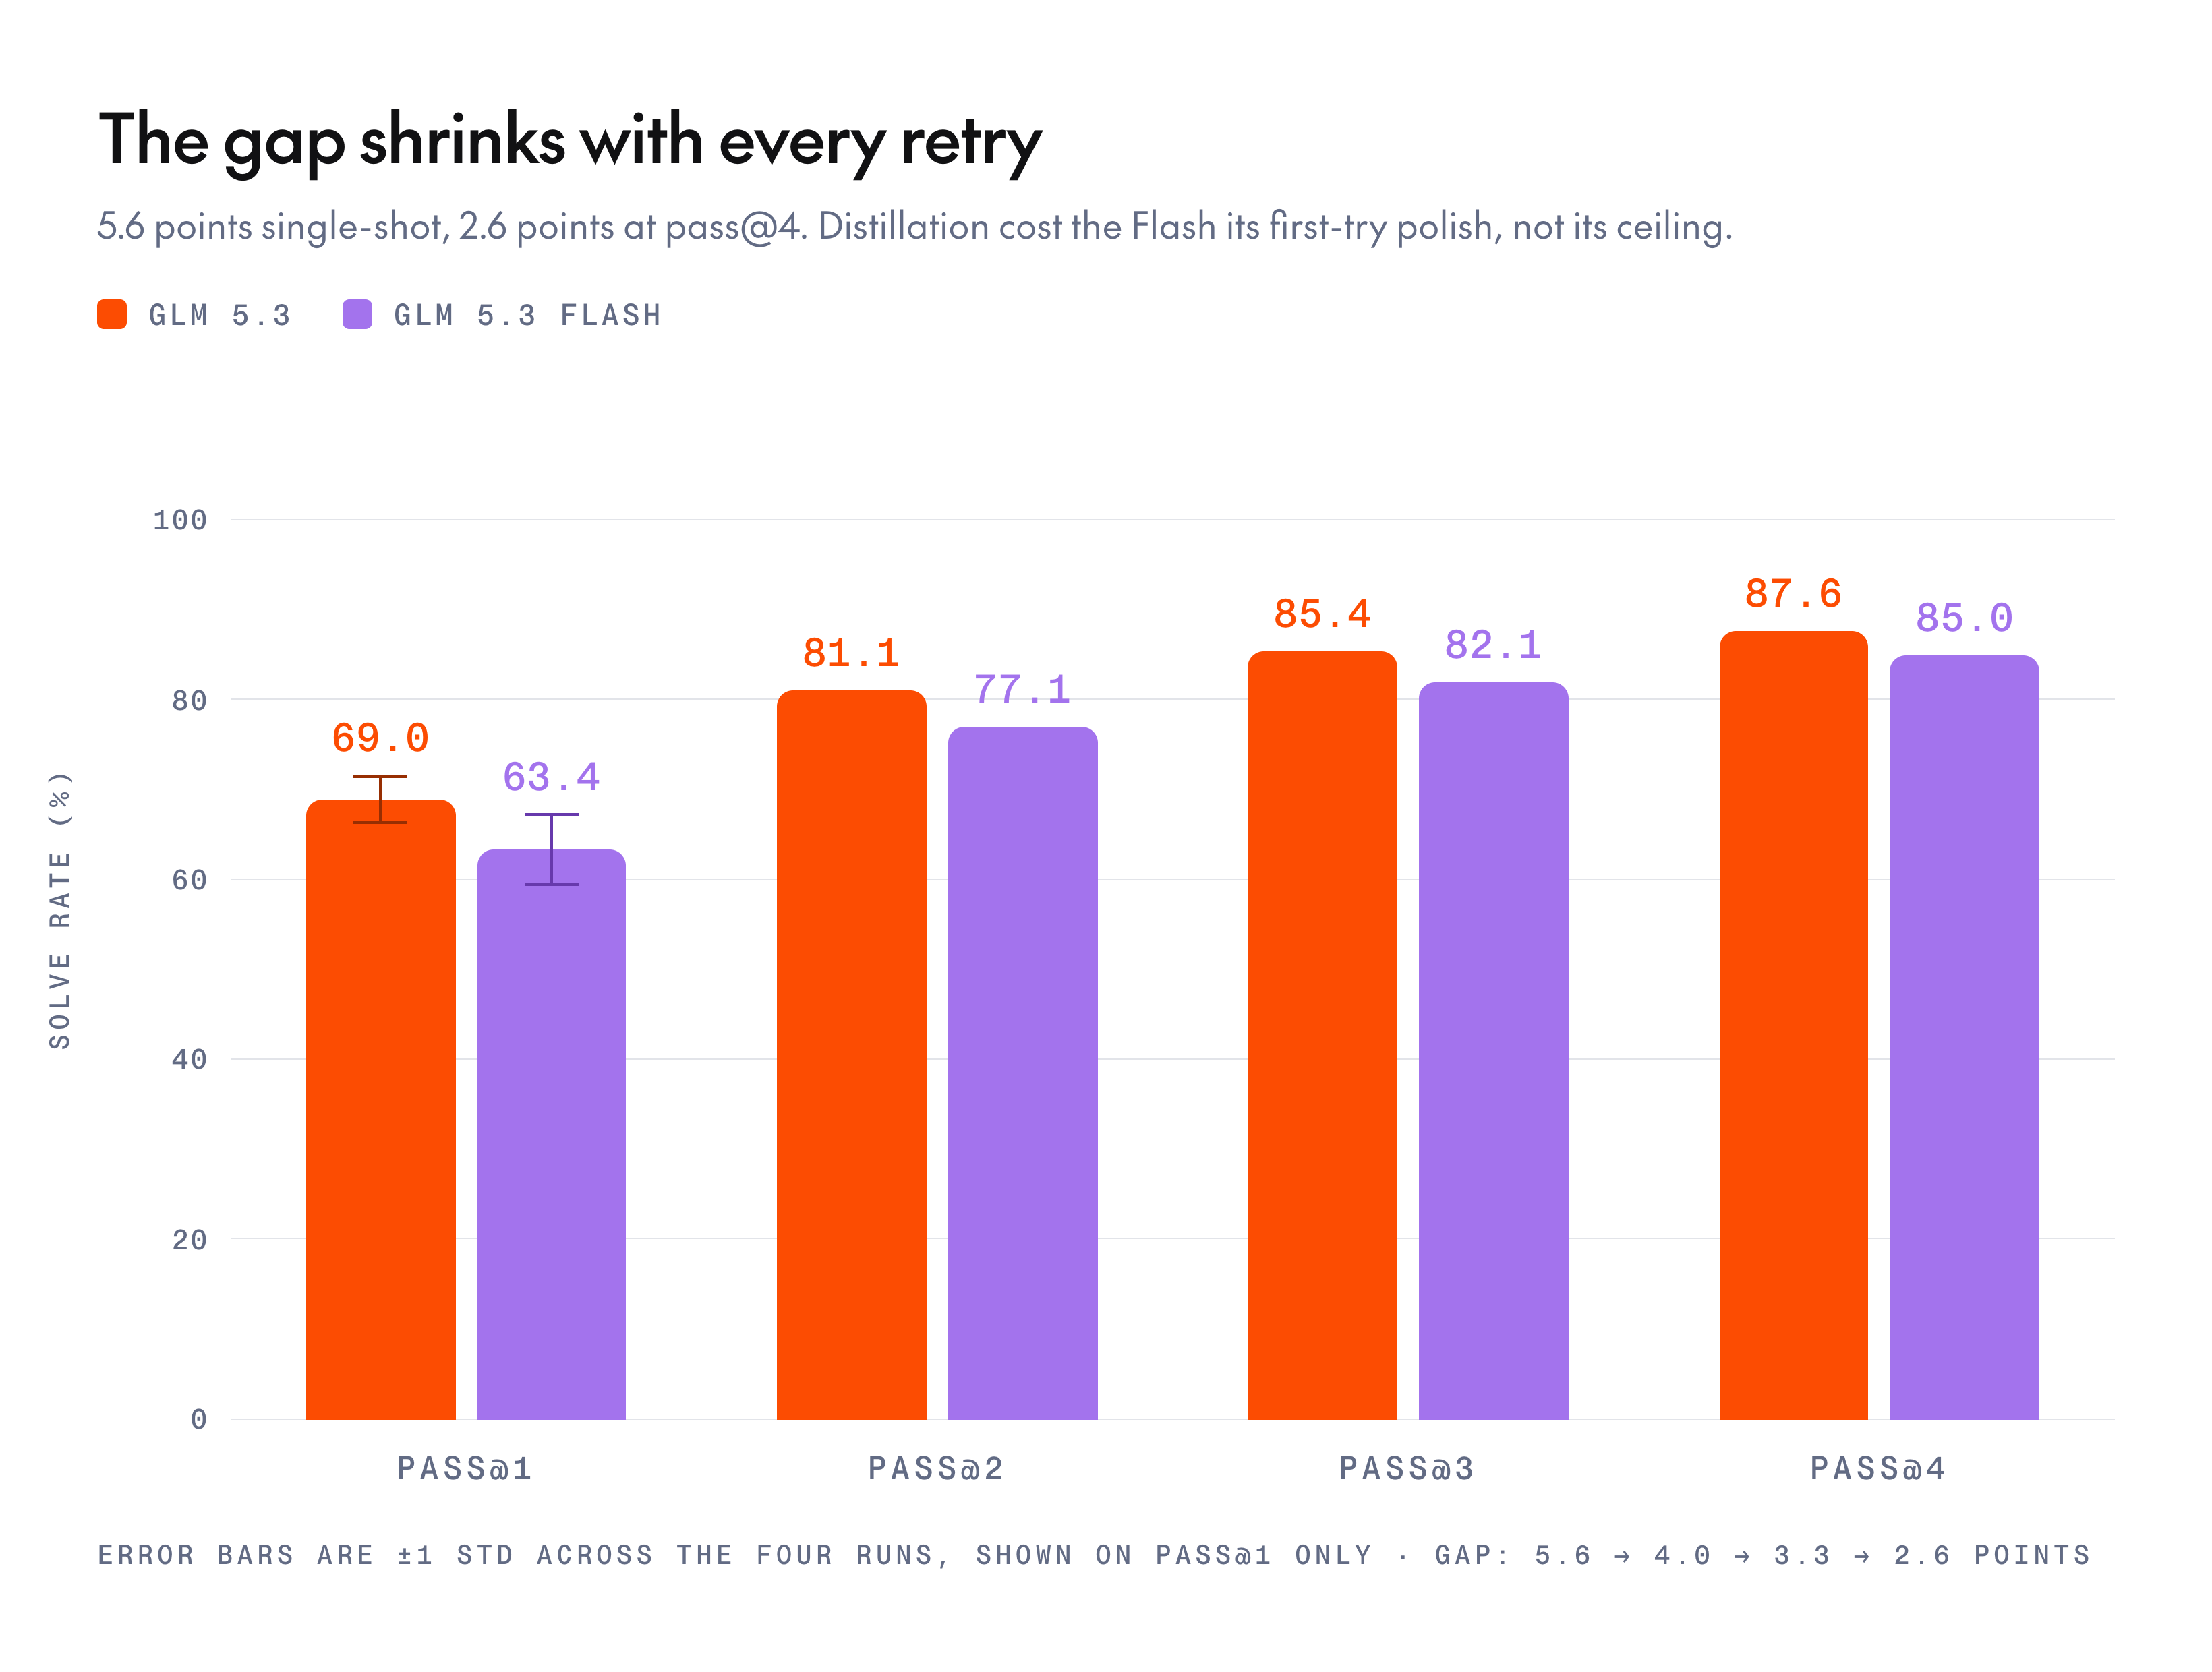
研究团队在 DeepSWE 基准上对 GLM-5.3 和 GLM-5.3 Flash 进行了 900 次测试。结果显示,Flash 在 pass@1 上仅低 5.6 分,但成本降低 17 倍;在 pass@4 上差距缩小至 2.6 分,表明 Flash 在成本效益上具有显著优势。
某机构启动了全球首个双盲AI评估试点,旨在通过隐藏模型身份减少评估偏差,提升AI性能比较的客观性。此举有望为AI评测设立新标准,影响行业评估方法。


AgentX 团队发布了 InferenceXv3,一个面向智能体推理的基准测试,并开源了价值 300 万美元的数据集。该基准支持超过 100 万上下文长度、多轮对话和子智能体,KVCache 命中率超过 95%。测试覆盖 GB300 NVL72、MI355、B200 等硬件,旨在评估 CUDA 生态在智能体推理中的优势是否依然存在。
Qwen 3.8 27B 在 Artificial Analysis 智能指数中得分 52,与 GPT-5.6 Luna(最大)持平,仅比 GLM-5.2(最大)和 DeepSeek V4 Pro 0813(最大)低一分。该模型以 27B 参数达到与更大模型相当的性能,展现了极高的效率。