为 Amazon Bedrock 知识库选择向量存储
AWS 发文对比 Amazon OpenSearch Service、Aurora PostgreSQL(pgvector)与 S3 Vectors 三种向量存储在 Amazon Bedrock 知识库 RAG 应用中的表现,覆盖三类 RAG 场景,给出基准测试结果与选型框架,帮助开发者在性能与成本之间做取舍。
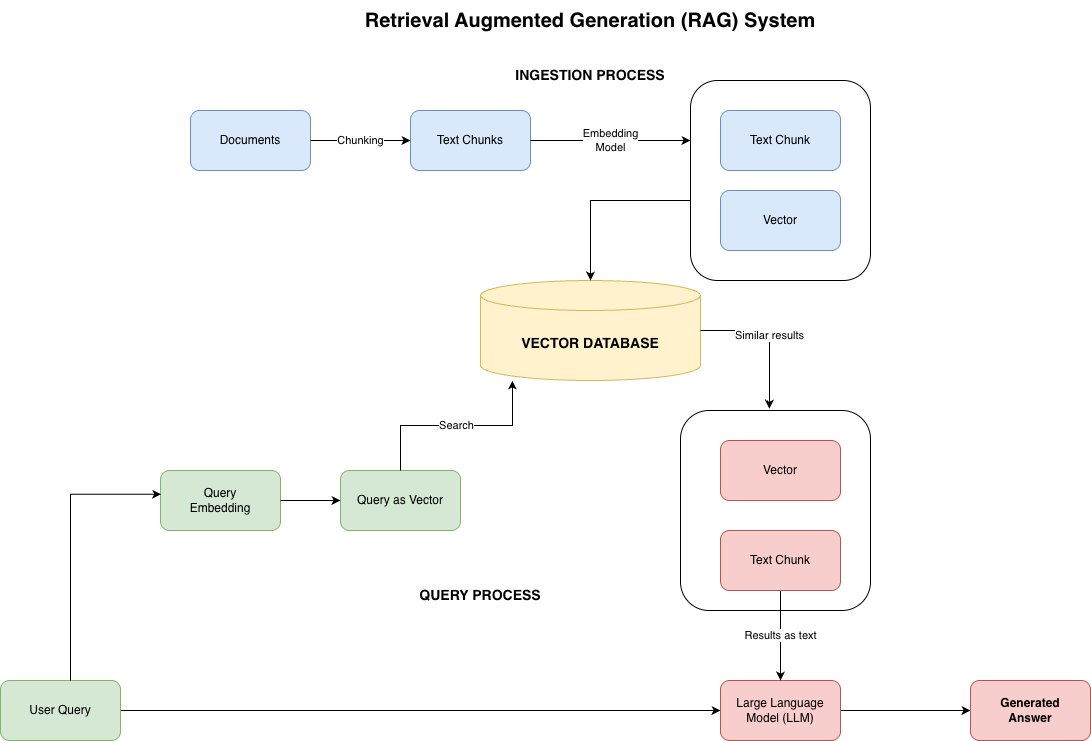
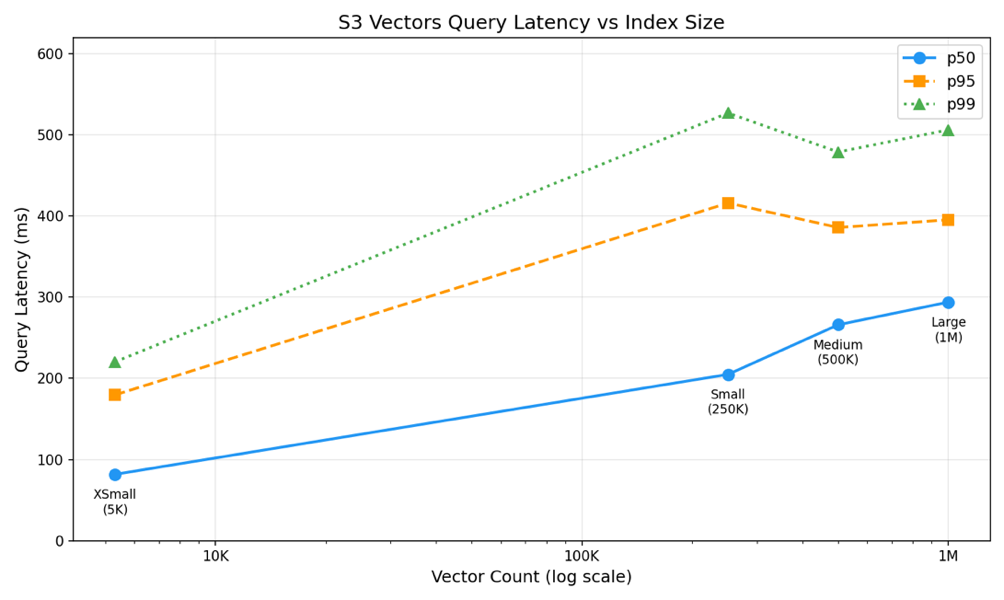
AWS 发文对比 Amazon OpenSearch Service、Aurora PostgreSQL(pgvector)与 S3 Vectors 三种向量存储在 Amazon Bedrock 知识库 RAG 应用中的表现,覆盖三类 RAG 场景,给出基准测试结果与选型框架,帮助开发者在性能与成本之间做取舍。

GitHub 将 Copilot 智能体运行时迁移到 Rust,涉及 80 万行生产代码。官方称如此规模的改写在过去成本过高,正是借助 AI 智能体才得以完成,并分享了迁移过程中的实际经验。
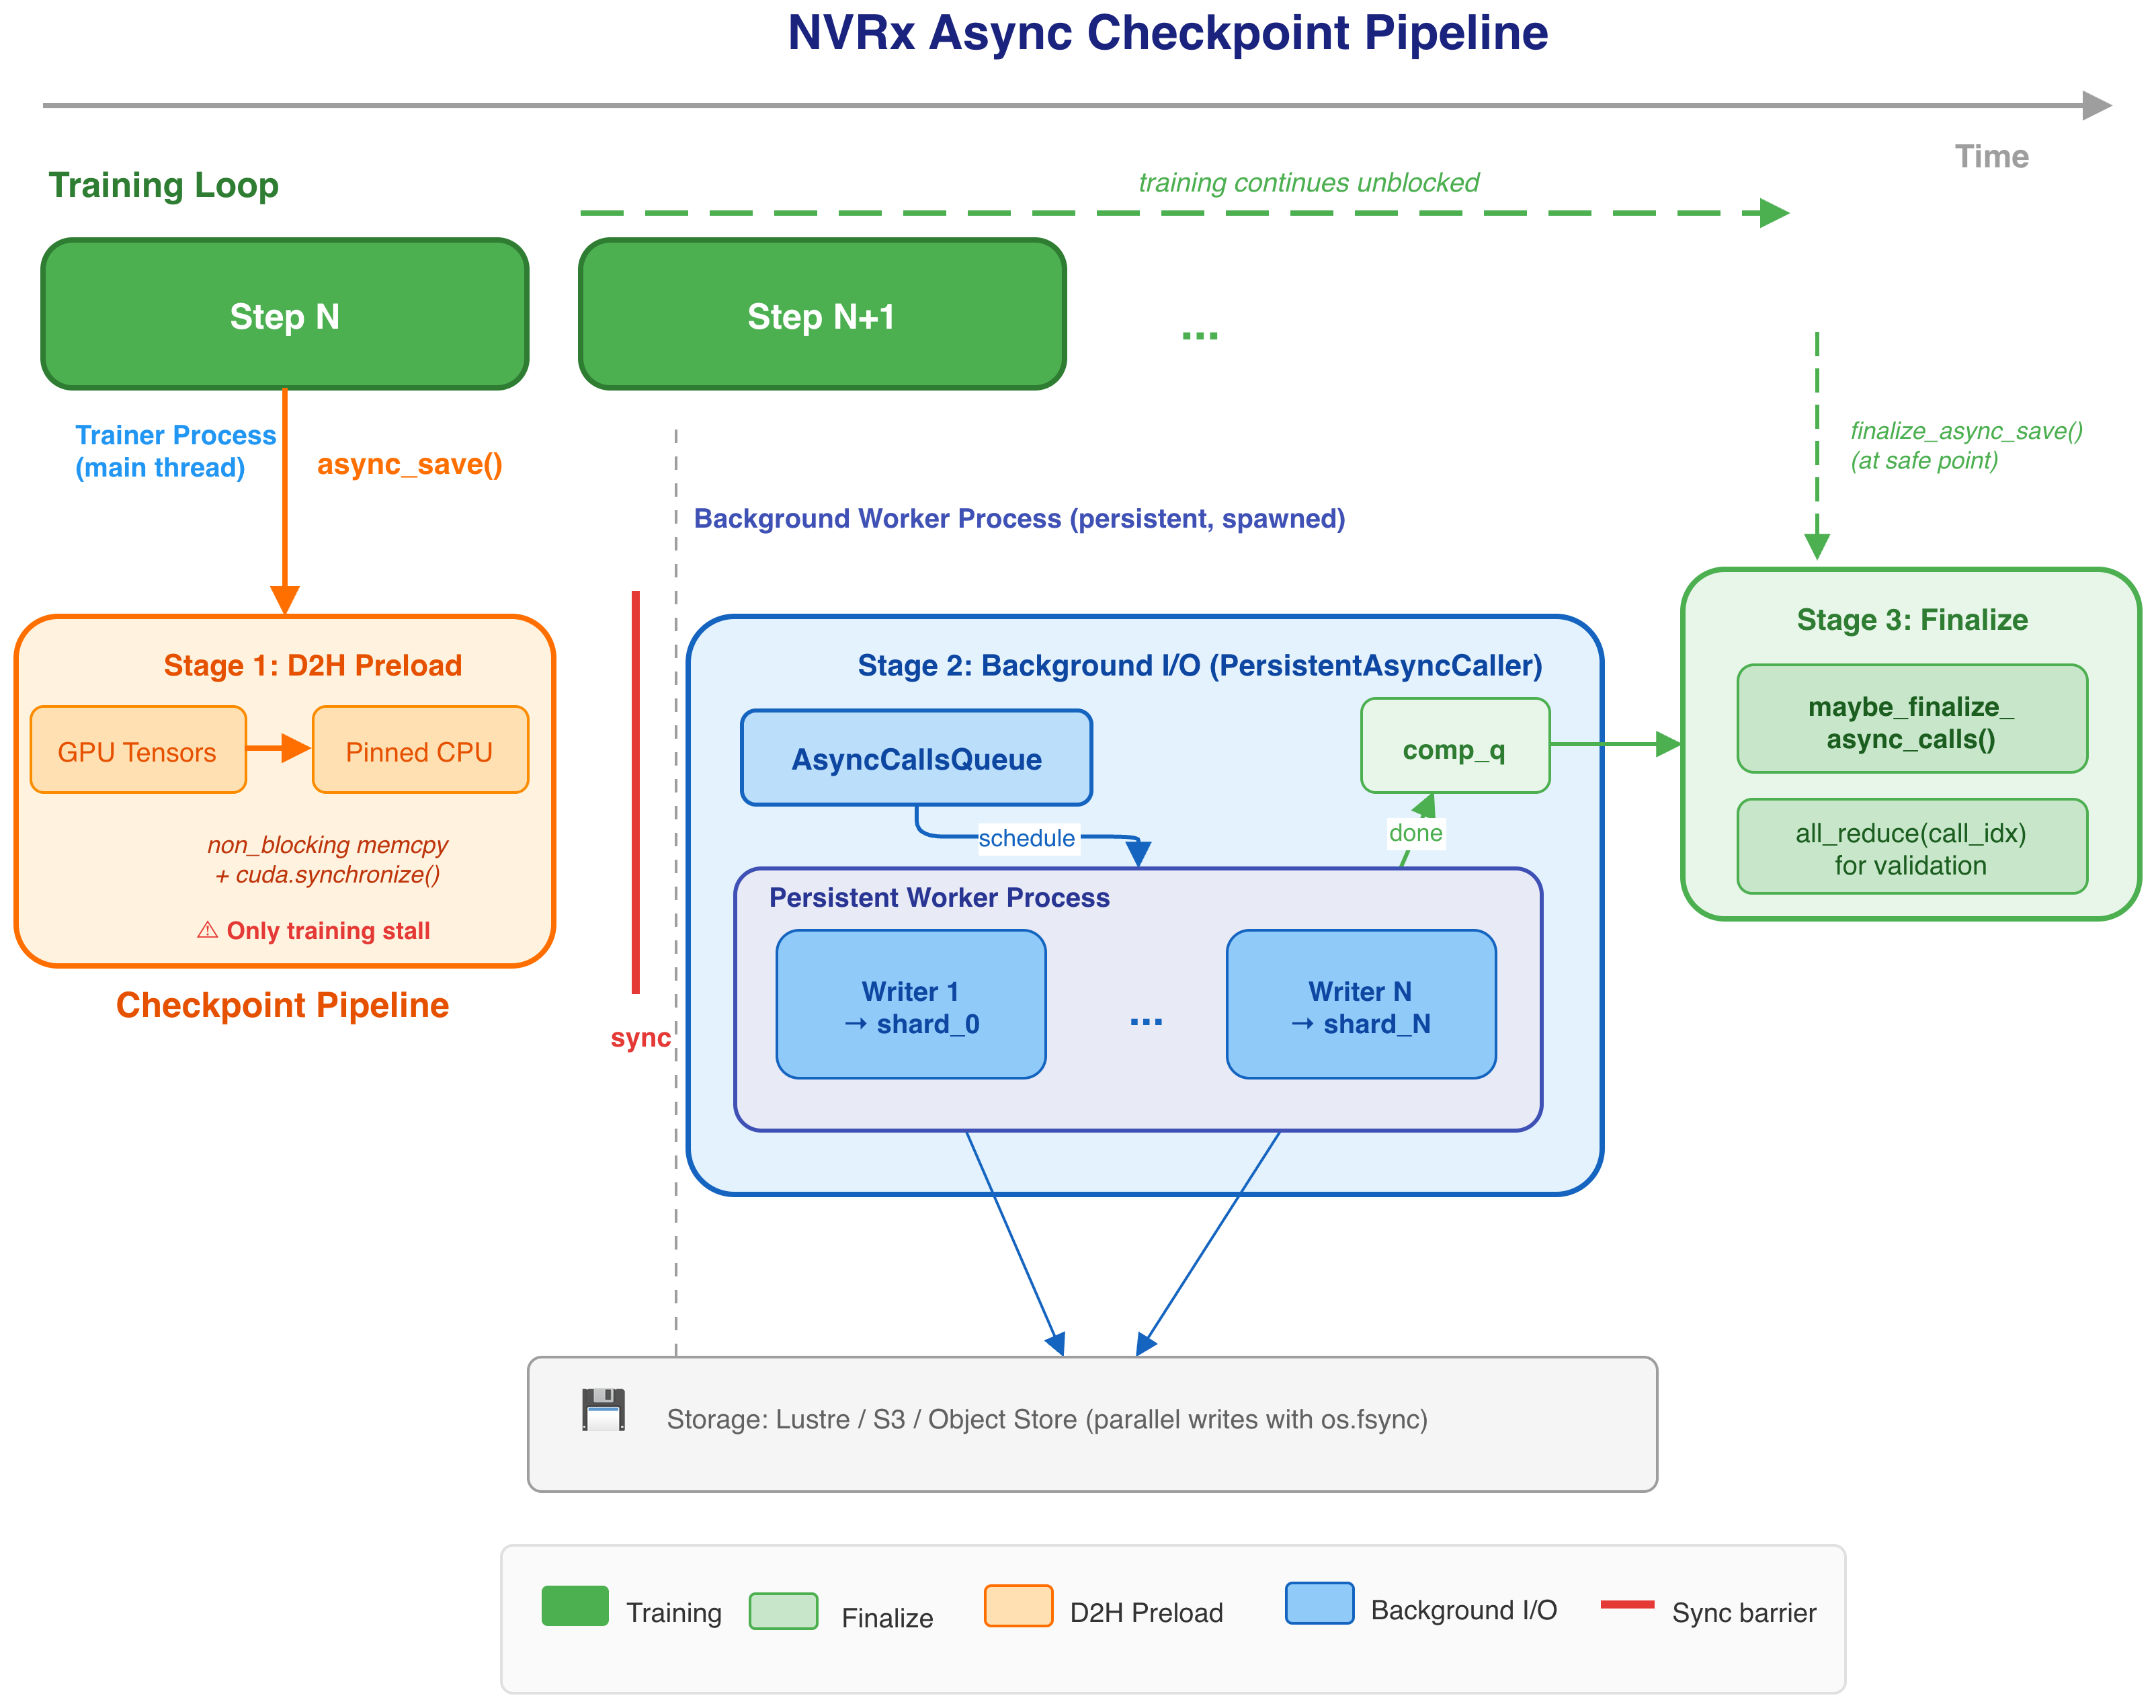
该教程介绍如何将 NVIDIA Resiliency Extension(NVRx)集成到 Amazon EKS 上的 PyTorch FSDP 训练中,通过异步检查点、进程内重启和 ft_launcher 作业内重启,让检查点 I/O 与训练重叠,并在数秒内从 GPU 故障中恢复。在 2 至 8 节点 H100 上的基准测试显示训练效率超过 99%,恢复时间达到秒级。

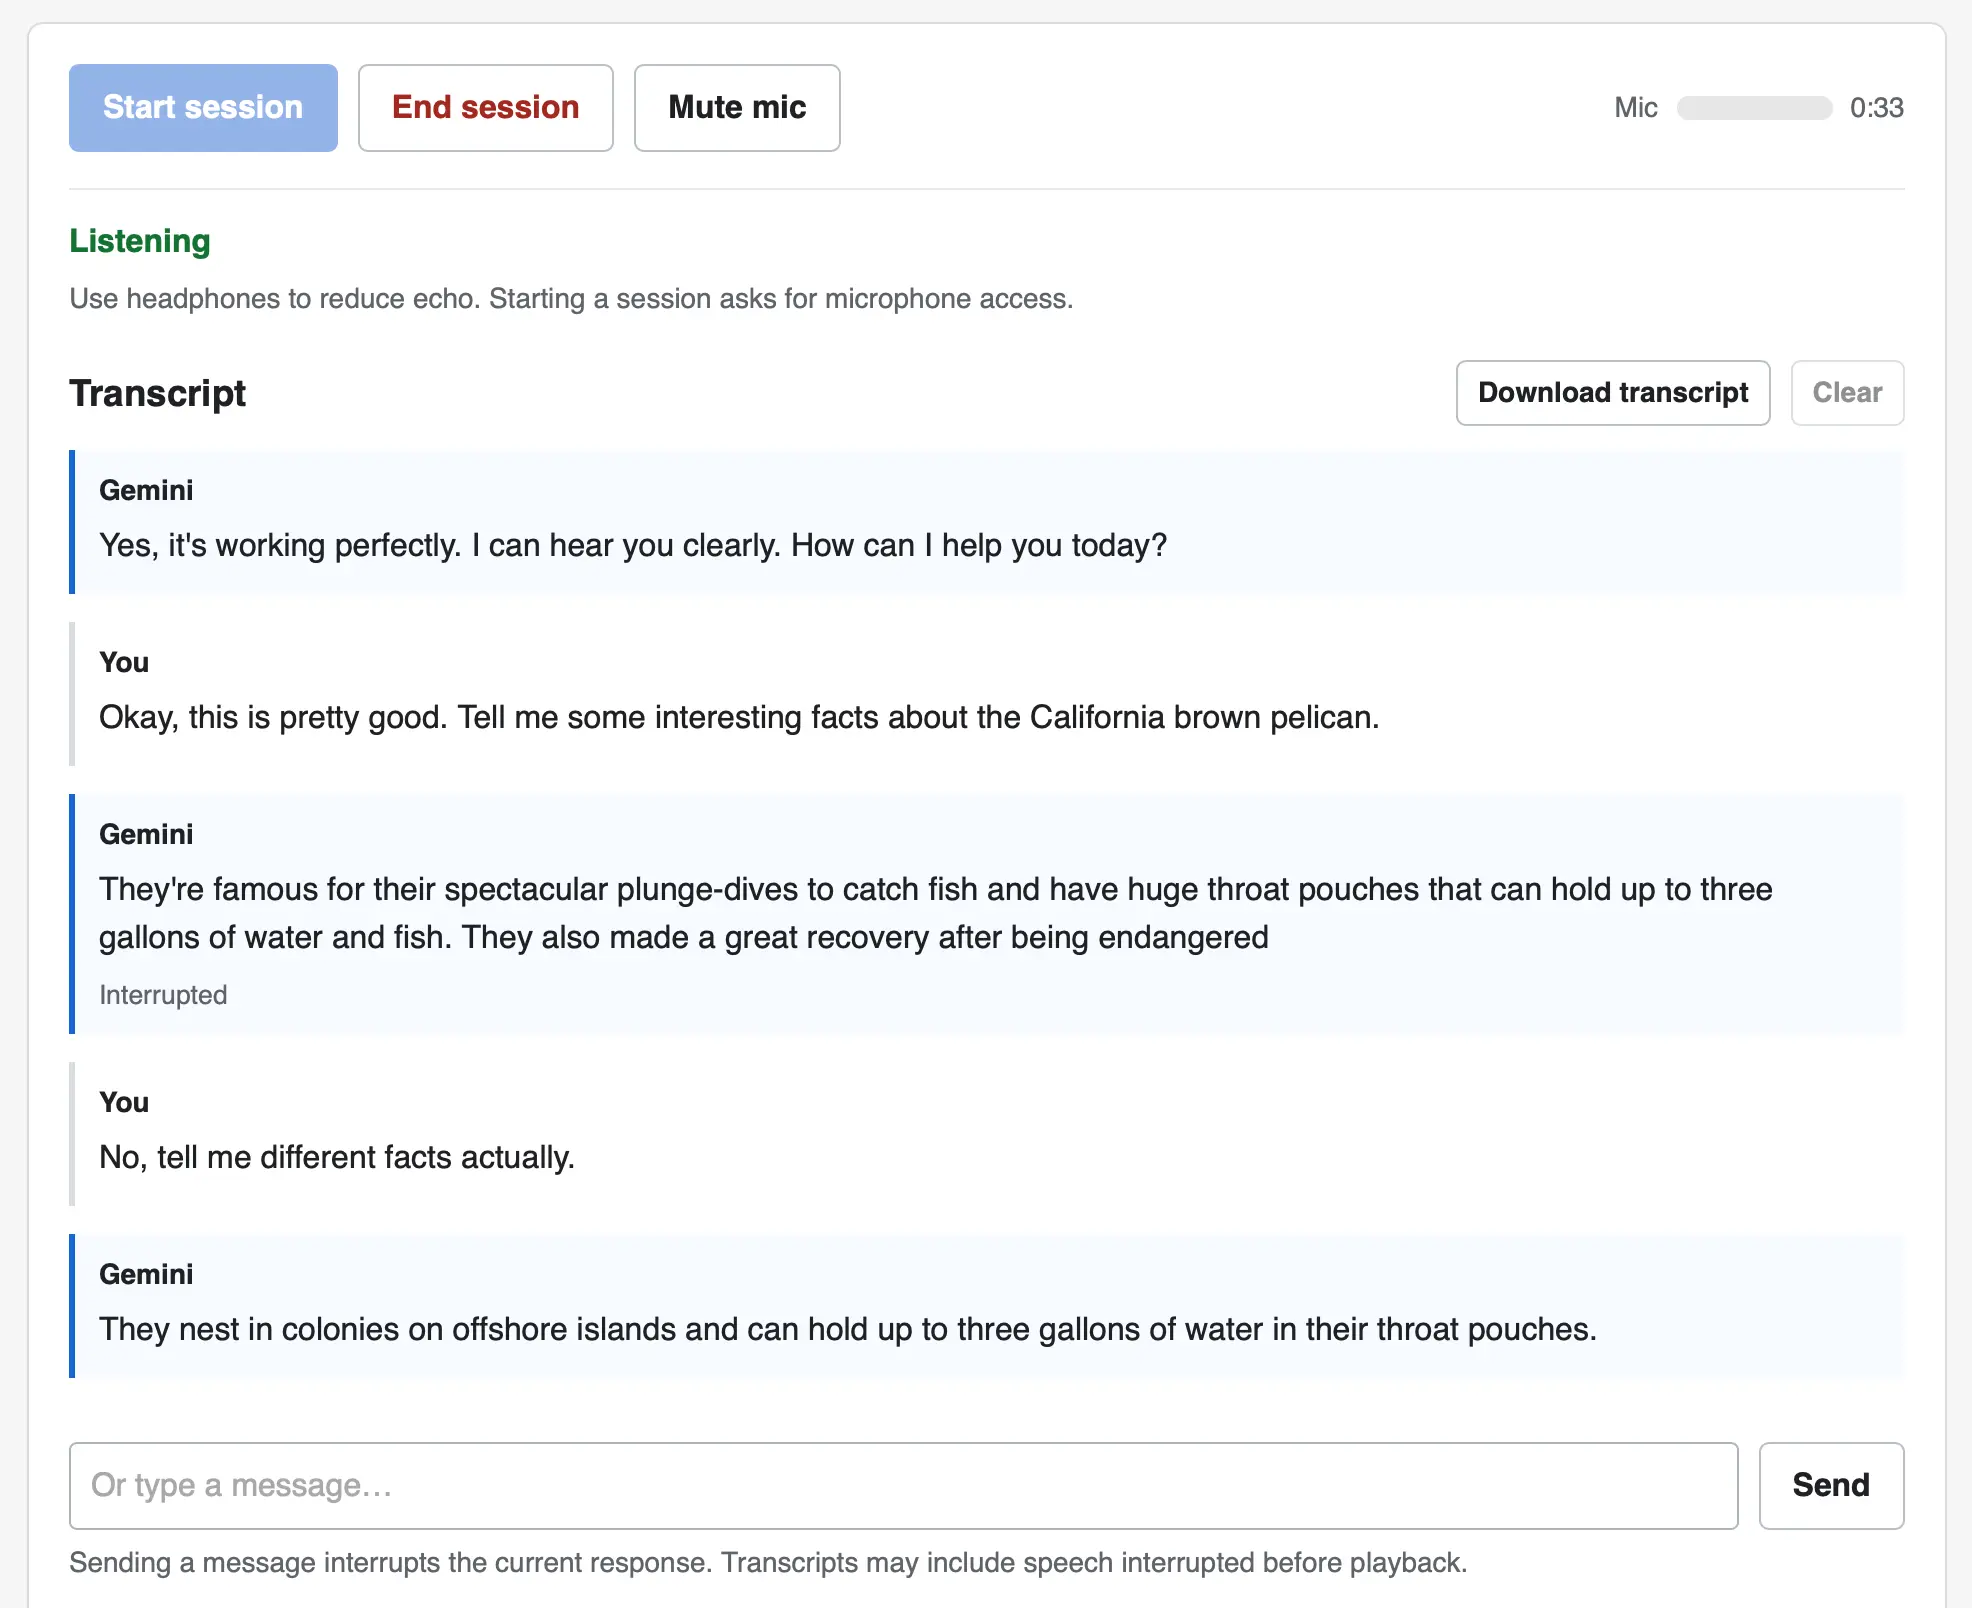
谷歌今天发布 Gemini 3.8 Live 和 3.8 Live Extended Thinking 两个语音到语音模型,形态类似 OpenAI 的 GPT-Live 系列。作者让 GPT-6 Astra Extra High 根据文档生成了一个网页 UI,可选择模型和语音预设、输入系统提示词,并在浏览器里进行语音对话,还能在模型说话时打断。实现不依赖任何库,直接连接 WebSocket 端点,用 Web Audio API 的 AudioContext 完成采集与播放。

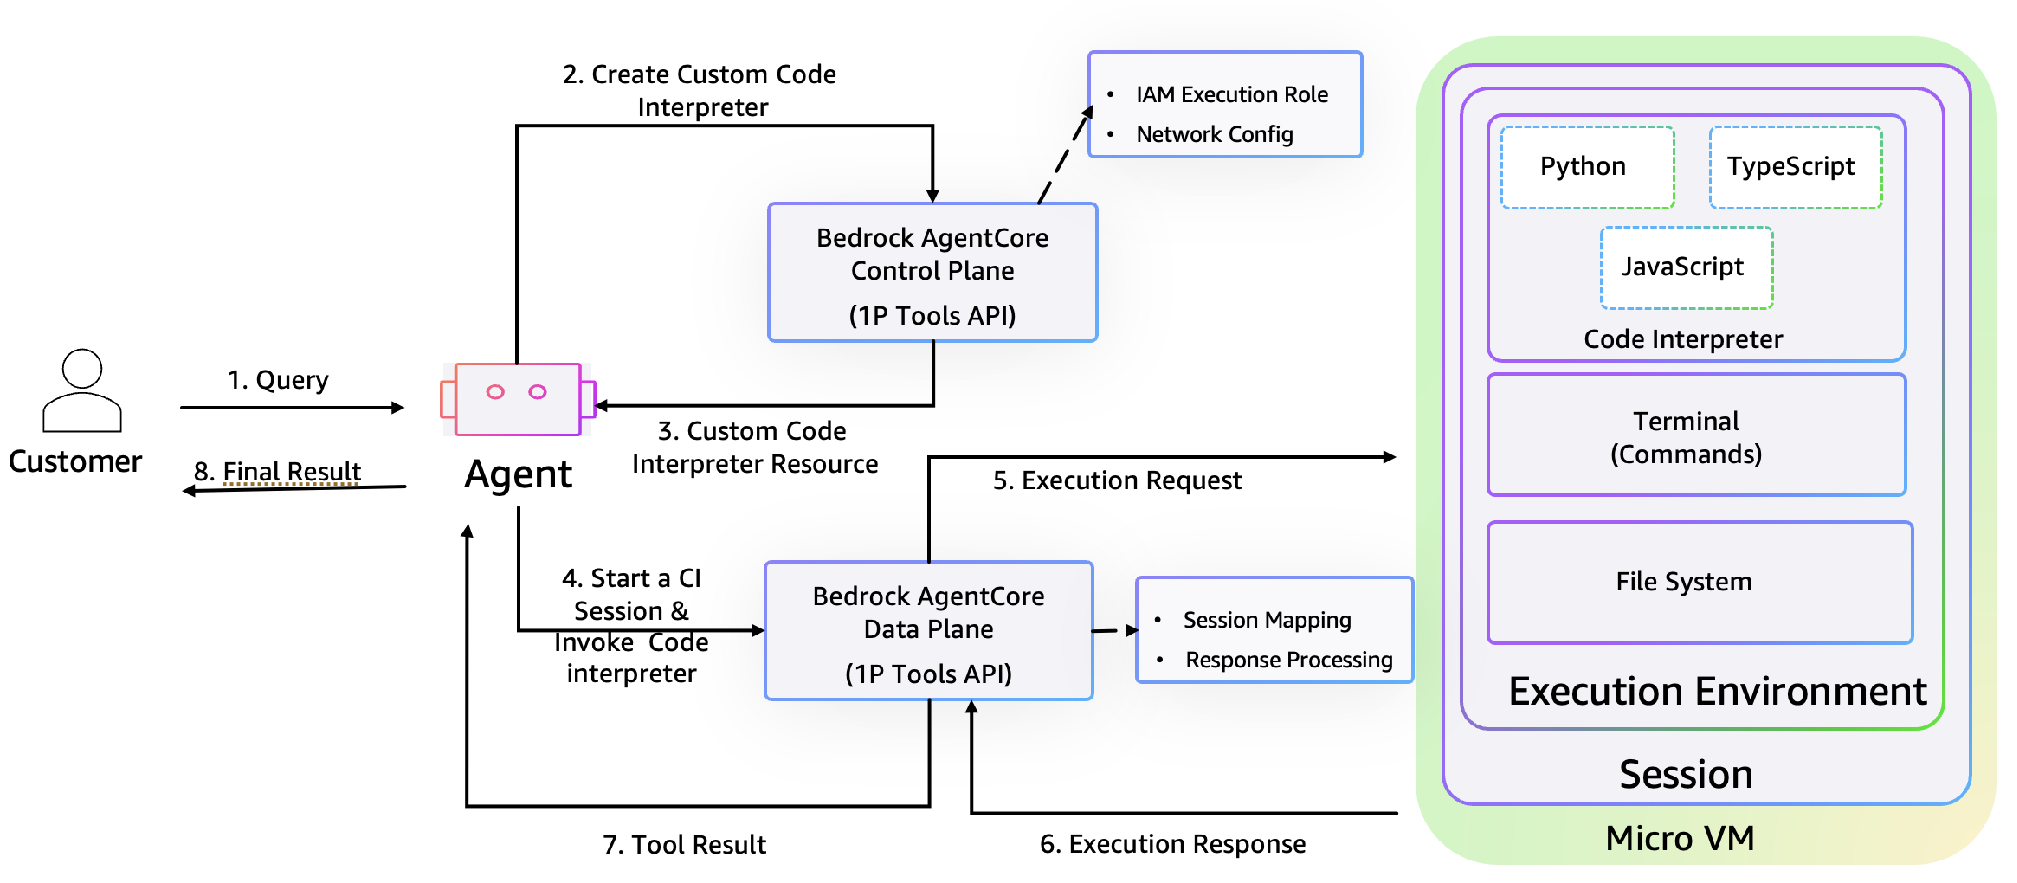
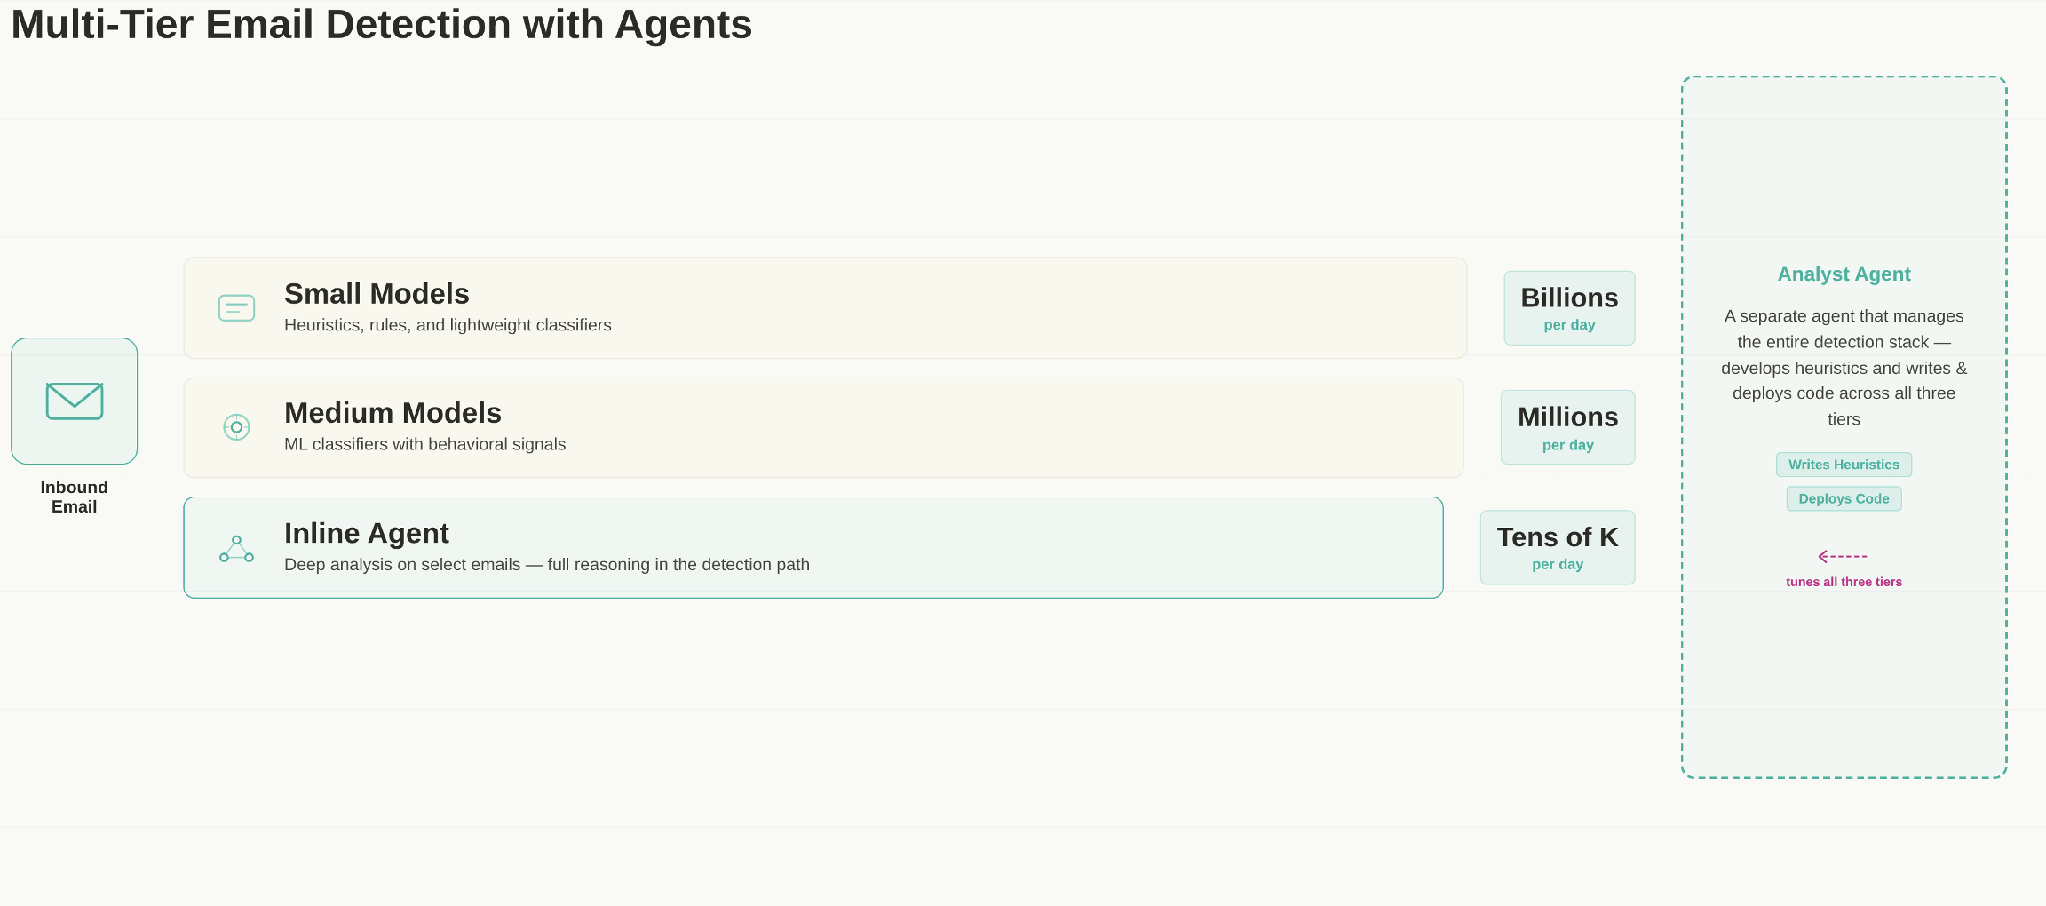
Abnormal AI 将 Amazon Bedrock AgentCore 的 Code Interpreter 用作临时计算沙箱,为其实时邮件威胁检测背后的智能体提供算力支撑,处理规模达十亿级消息。文章还介绍了沙箱设计取舍,以及在生产环境部署 Code Interpreter 的实践经验。


Podium 在 AI 员工智能体的开发生命周期中使用 LangSmith 进行数据集管理和微调,将智能体 F1 响应质量提升至 98%,同时将工程干预需求减少了 90%。
LangChain 团队分享了其聊天机器人的重建经验,采用 Deep Agents 和子图技术,将响应时间缩短至 15 秒以内,并提供精确引用。文章总结了技术选型、架构调整及可复用的实践方法,对构建高效对话系统具有参考价值。
LangSmith 团队分享了其 Engine 的技术实现,该引擎通过大规模分析追踪数据,将重复出现的失败转化为可操作的问题,并自动提出评估器和修复建议,从而帮助开发者改进 AI 智能体。

GitHub 博客分享在生产环境部署 LLM 前进行系统评估的经验,以真实世界的秘密扫描场景为例,总结了评估过程中的关键教训,帮助开发者避免常见陷阱,确保模型在实际任务中的可靠性和安全性。
Anthropic 宣布为 Claude 模型输出添加水印。本视频讲座详细解释了其底层机制:基于 token 采样的水印嵌入、检测与移除方法,并讨论了水印的优缺点。


本文介绍了多向量(晚期交互)嵌入模型,如 ColBERT 风格模型,它们为每个 token 保留向量,通过 MaxSim 操作进行评分,在保持可索引性的同时提升检索质量。文章详细说明了如何加载模型、编码查询和文档、进行语义搜索、索引、视觉文档检索等,并讨论了索引大小和速度的权衡。