精选 UK AI Security Institute产品AI评分:70/100
Transect:让大规模智能体评估更易理解
AISI 联合 Meridian Labs 发布开源 Python 包 Transect,基于 Inspect Scout 构建。该工具将复杂的智能体评估转录转化为交互式报告,帮助审查者直观追踪评估过程、分析信号(如 Token 消耗)并定位关键转录片段,解决传统评估分数无法反映智能体策略和调试过程的痛点。

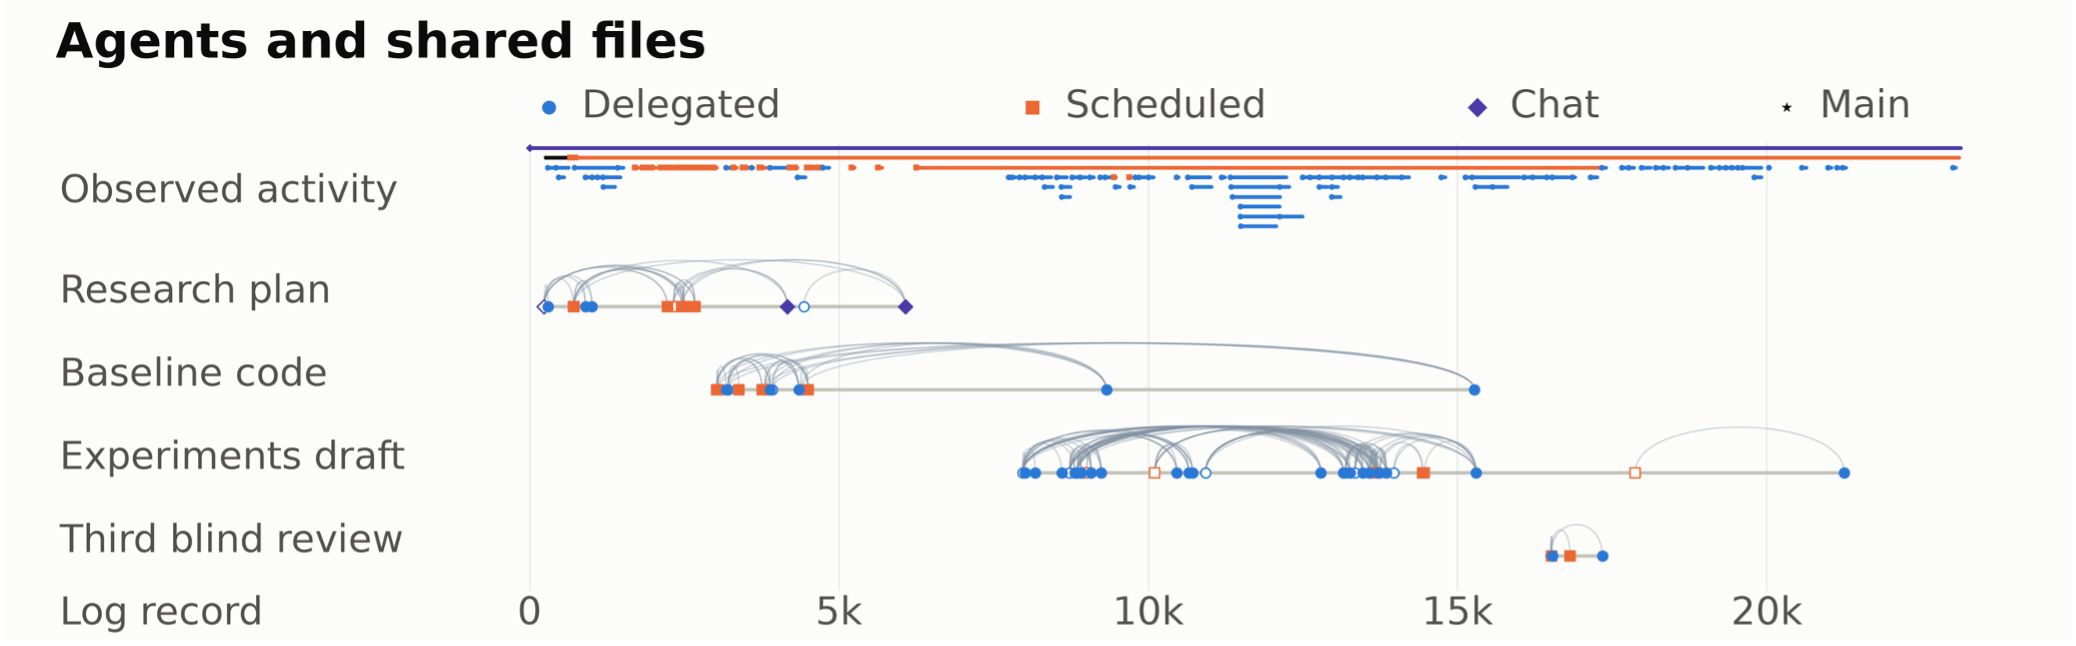
AISI 联合 Meridian Labs 发布开源 Python 包 Transect,基于 Inspect Scout 构建。该工具将复杂的智能体评估转录转化为交互式报告,帮助审查者直观追踪评估过程、分析信号(如 Token 消耗)并定位关键转录片段,解决传统评估分数无法反映智能体策略和调试过程的痛点。
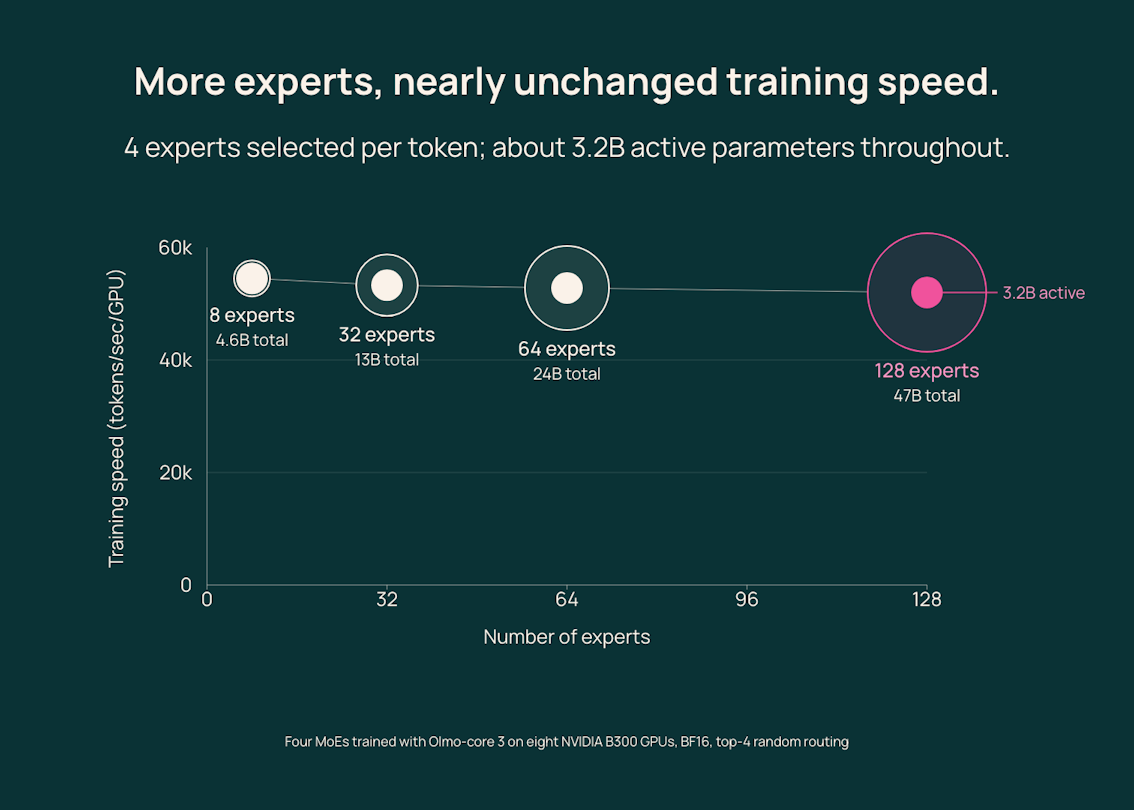
EleutherAI 发布 Olmo-core 3,旨在为大型混合专家(MoE)模型提供开源、可扩展的训练基础设施。

GitHub Blog 发布文章,介绍其开源 AI 安全代理在 Android 应用中发现的 24 个漏洞。内容涵盖针对该任务的特定 AI 工作流、发现的严重 Android Bug 详情,以及如何让用户在自己的应用中运行该开源代理。
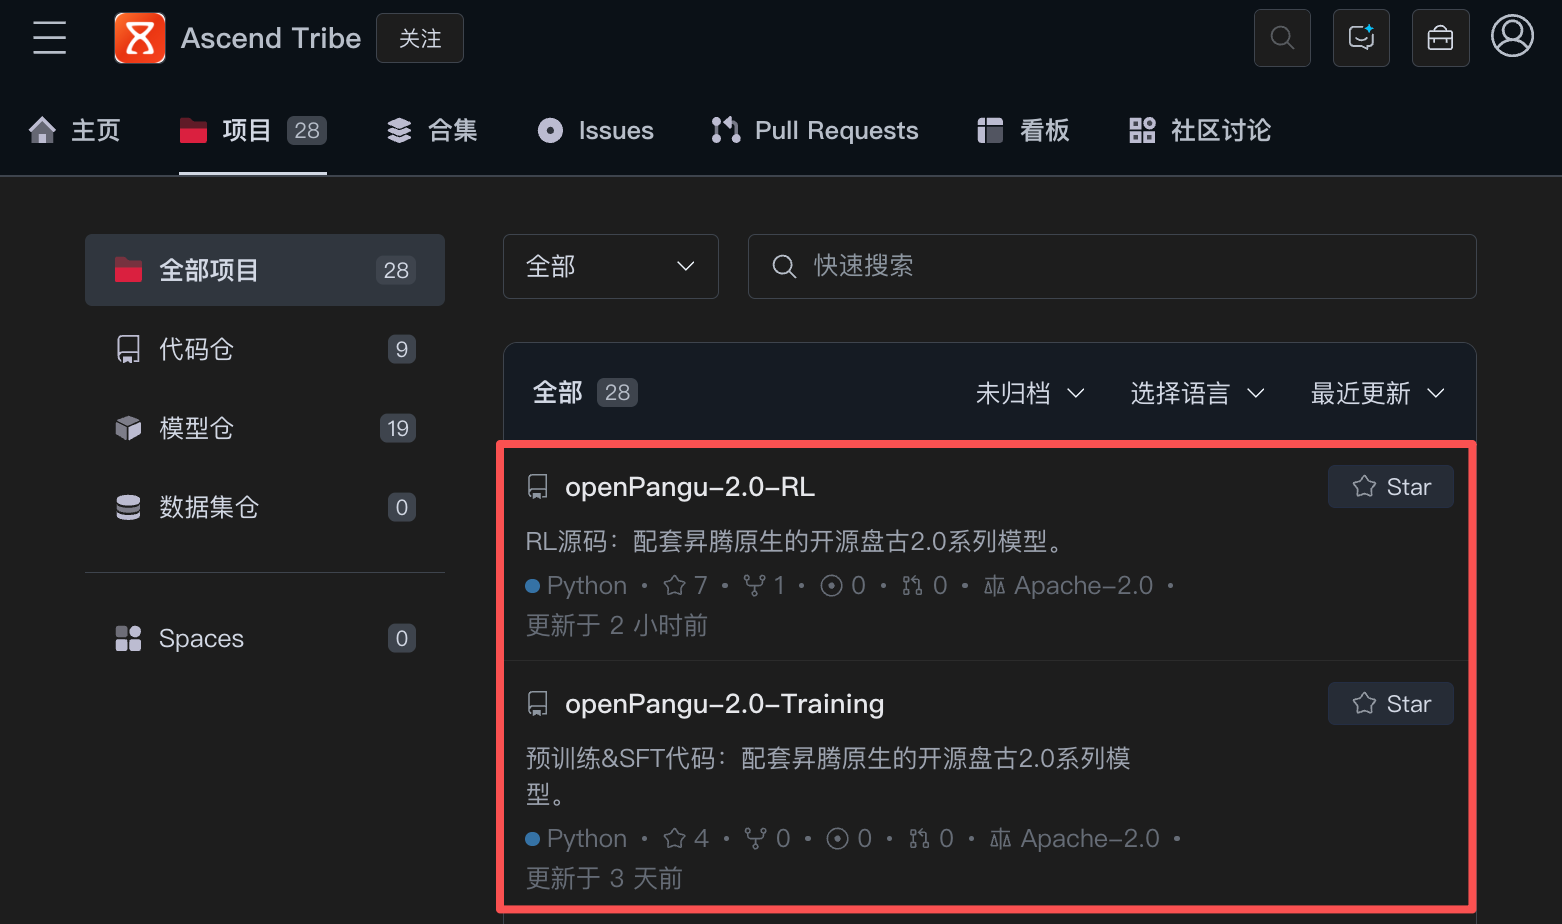
华为宣布盘古大模型2.0开源版openPangu-2.0正式上线,提供预训练、SFT监督微调及后训练RL强化学习的完整代码。配套框架支持大规模分布式训练、长上下文处理、指令对齐及昇腾加速,覆盖从基础模型开发到持续优化的全流程能力。

 AWS AI Blogby Michael Hsieh · 新闻AI评分:70/100
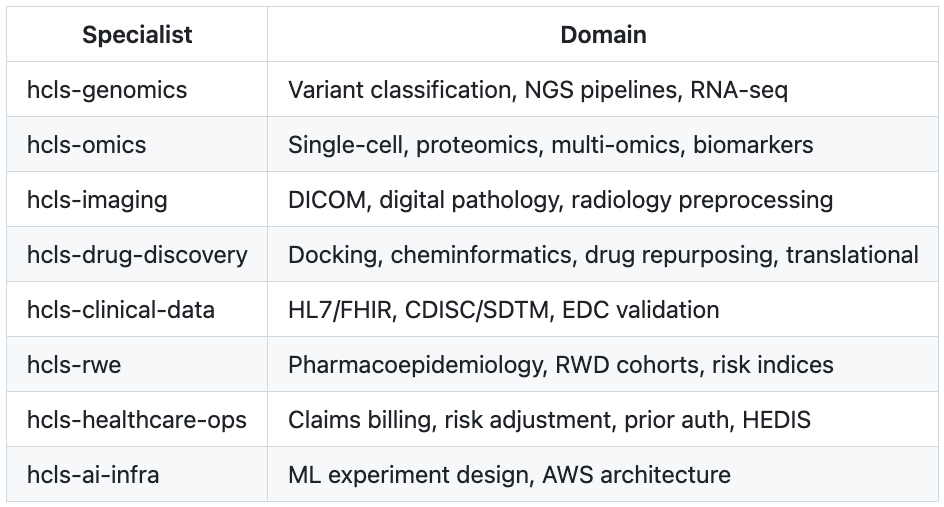
针对基础模型智能体在医疗与生命科学(HCLS)决策中常引用正确指南却错误应用的问题,作者开源了覆盖 11 个 HCLS 领域的 38 个智能体技能,并给出安装步骤、三个实际用例,以及基于 410 条提示词的评测,显示胜率达 70%–86%。
蚂蚁AI安全实验室在2026国家网络安全宣传周期间开源大模型内生式安全护栏SingProbe,同步开放代码、模型与评测基准。该护栏与模型生成过程同步运行,无需外置审核模型,可降低计算与部署成本。目前已适配Ling-3.0系列、GLM-5.2/5.3、Qwen、DeepSeekV4等29个主流开源模型,并接入SGLang、vLLM推理框架,开发者可在现有推理流程中集成安全防护。


研究指出主流智能体评测只报告平均成功率(Mean@k),掩盖了可靠性问题。在 AppWorld 上,GPT-4.1 驱动的 ReAct 智能体平均成功率 77.4%,但五次重复全部成功的任务仅占 53.0%,一致性差距达 24.4 个百分点,困难任务上更达 30 点。作者提出 Consistency Analyzer,通过重采样轨迹定位易翻转的决策点,并生成一致性指南,将差距从 24.4pp 降至 12.0pp,且不损失平均准确率。


RunningHub 针对 MiniMax 开源视频模型 H3 推出并开源加速方案 H3 Lightning。在 5 秒视频对照测试中,生成耗时从 348.8 秒降至 28.7 秒,推理速度约为基础方案的 12 倍,等待时间减少约 92%。技术方案与复现说明已在 GitHub 公开,有算力者可本地部署,普通创作者可直接在 RunningHub 使用。


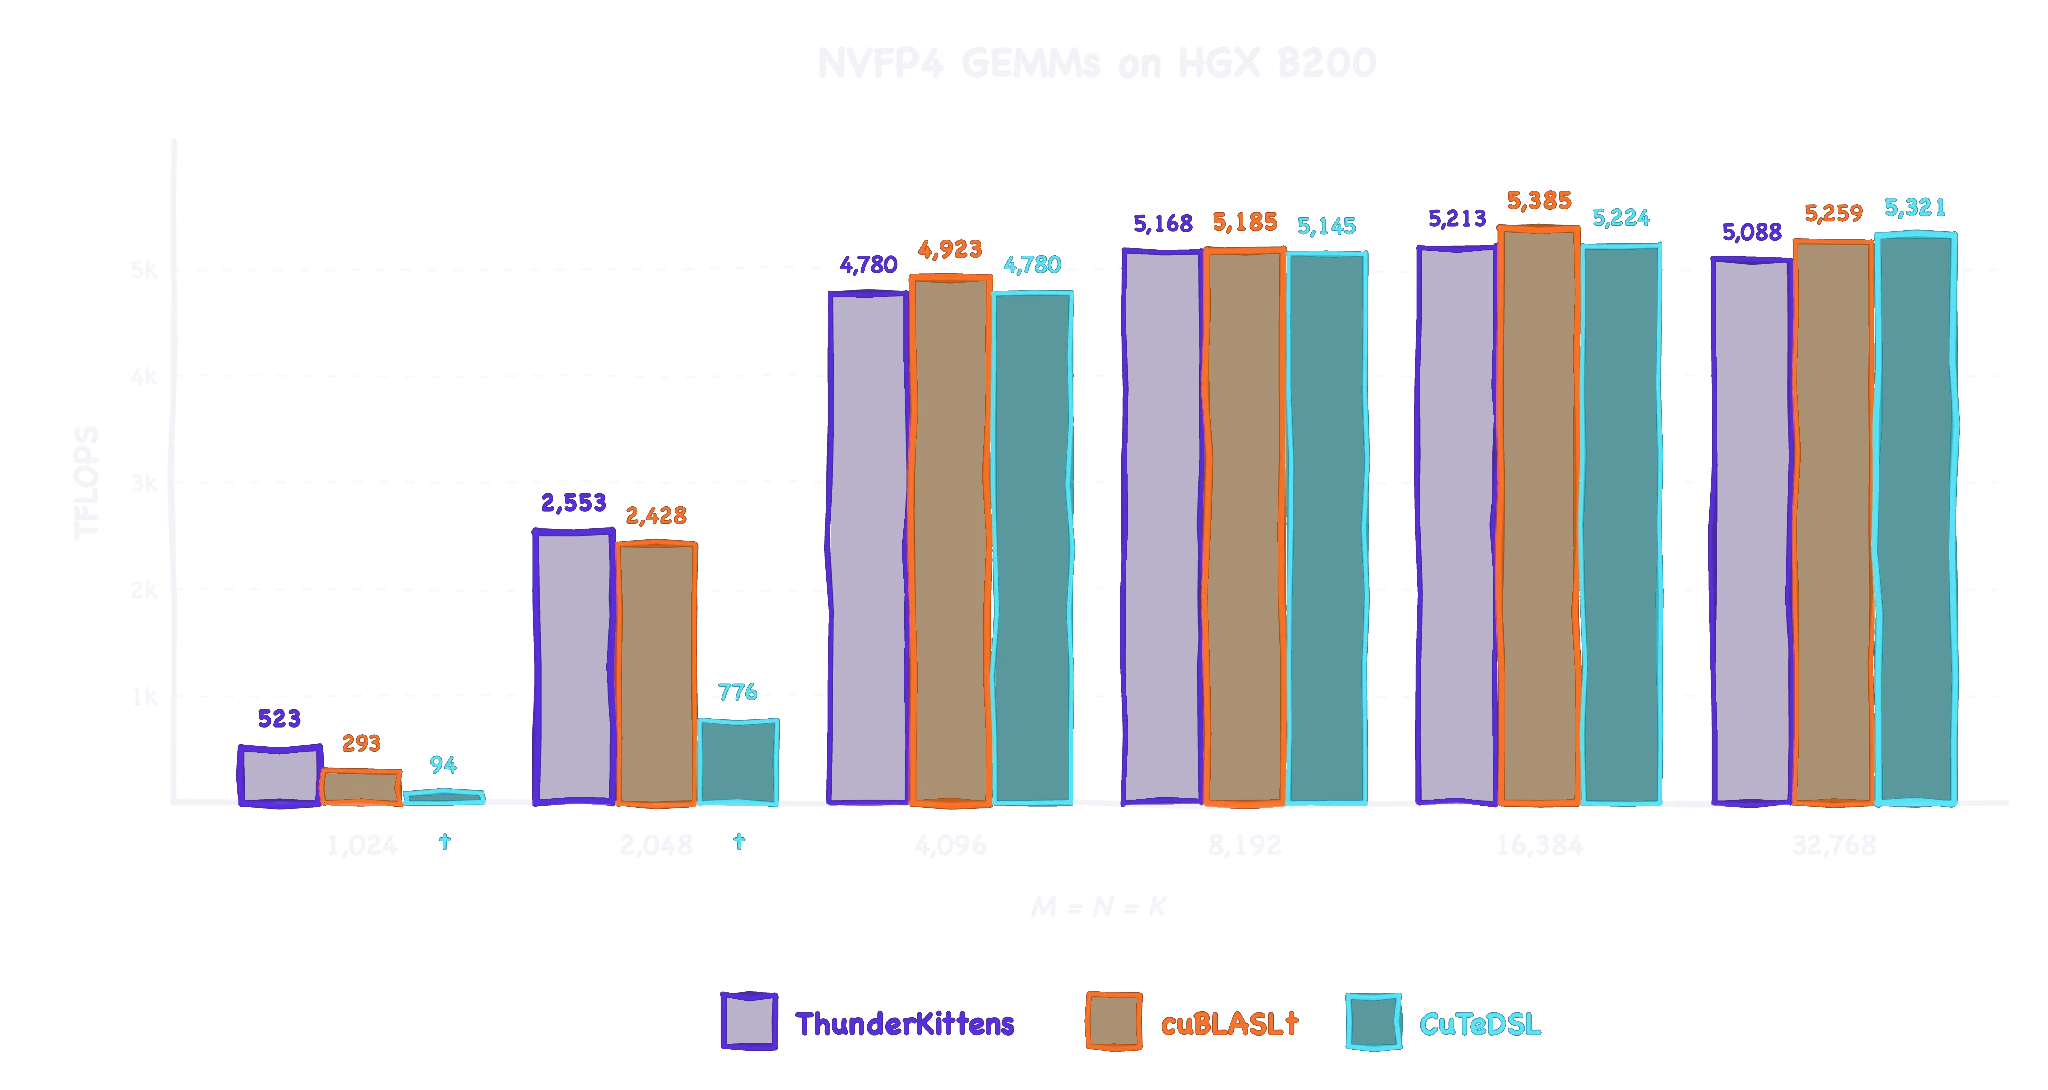
ThunderKittens 团队将其内核库移植到 NVIDIA Vera Rubin NVL72,并围绕新硬件重写 NVFP4 GEMM,性能从 roofline 的 42% 提升到超过 22 PFLOPS,与 cuBLAS 和 CuTe DSL 相当。文章还介绍了 ISA 的变化及适配方式。

Hugging Face 推出了 @huggingface/kernels 库,包含 200 多个 WebGPU 内核,旨在提升浏览器端 AI 推理性能。该库为开发者提供了优化的计算内核,可加速本地模型运行,减少延迟,推动端侧 AI 应用发展。


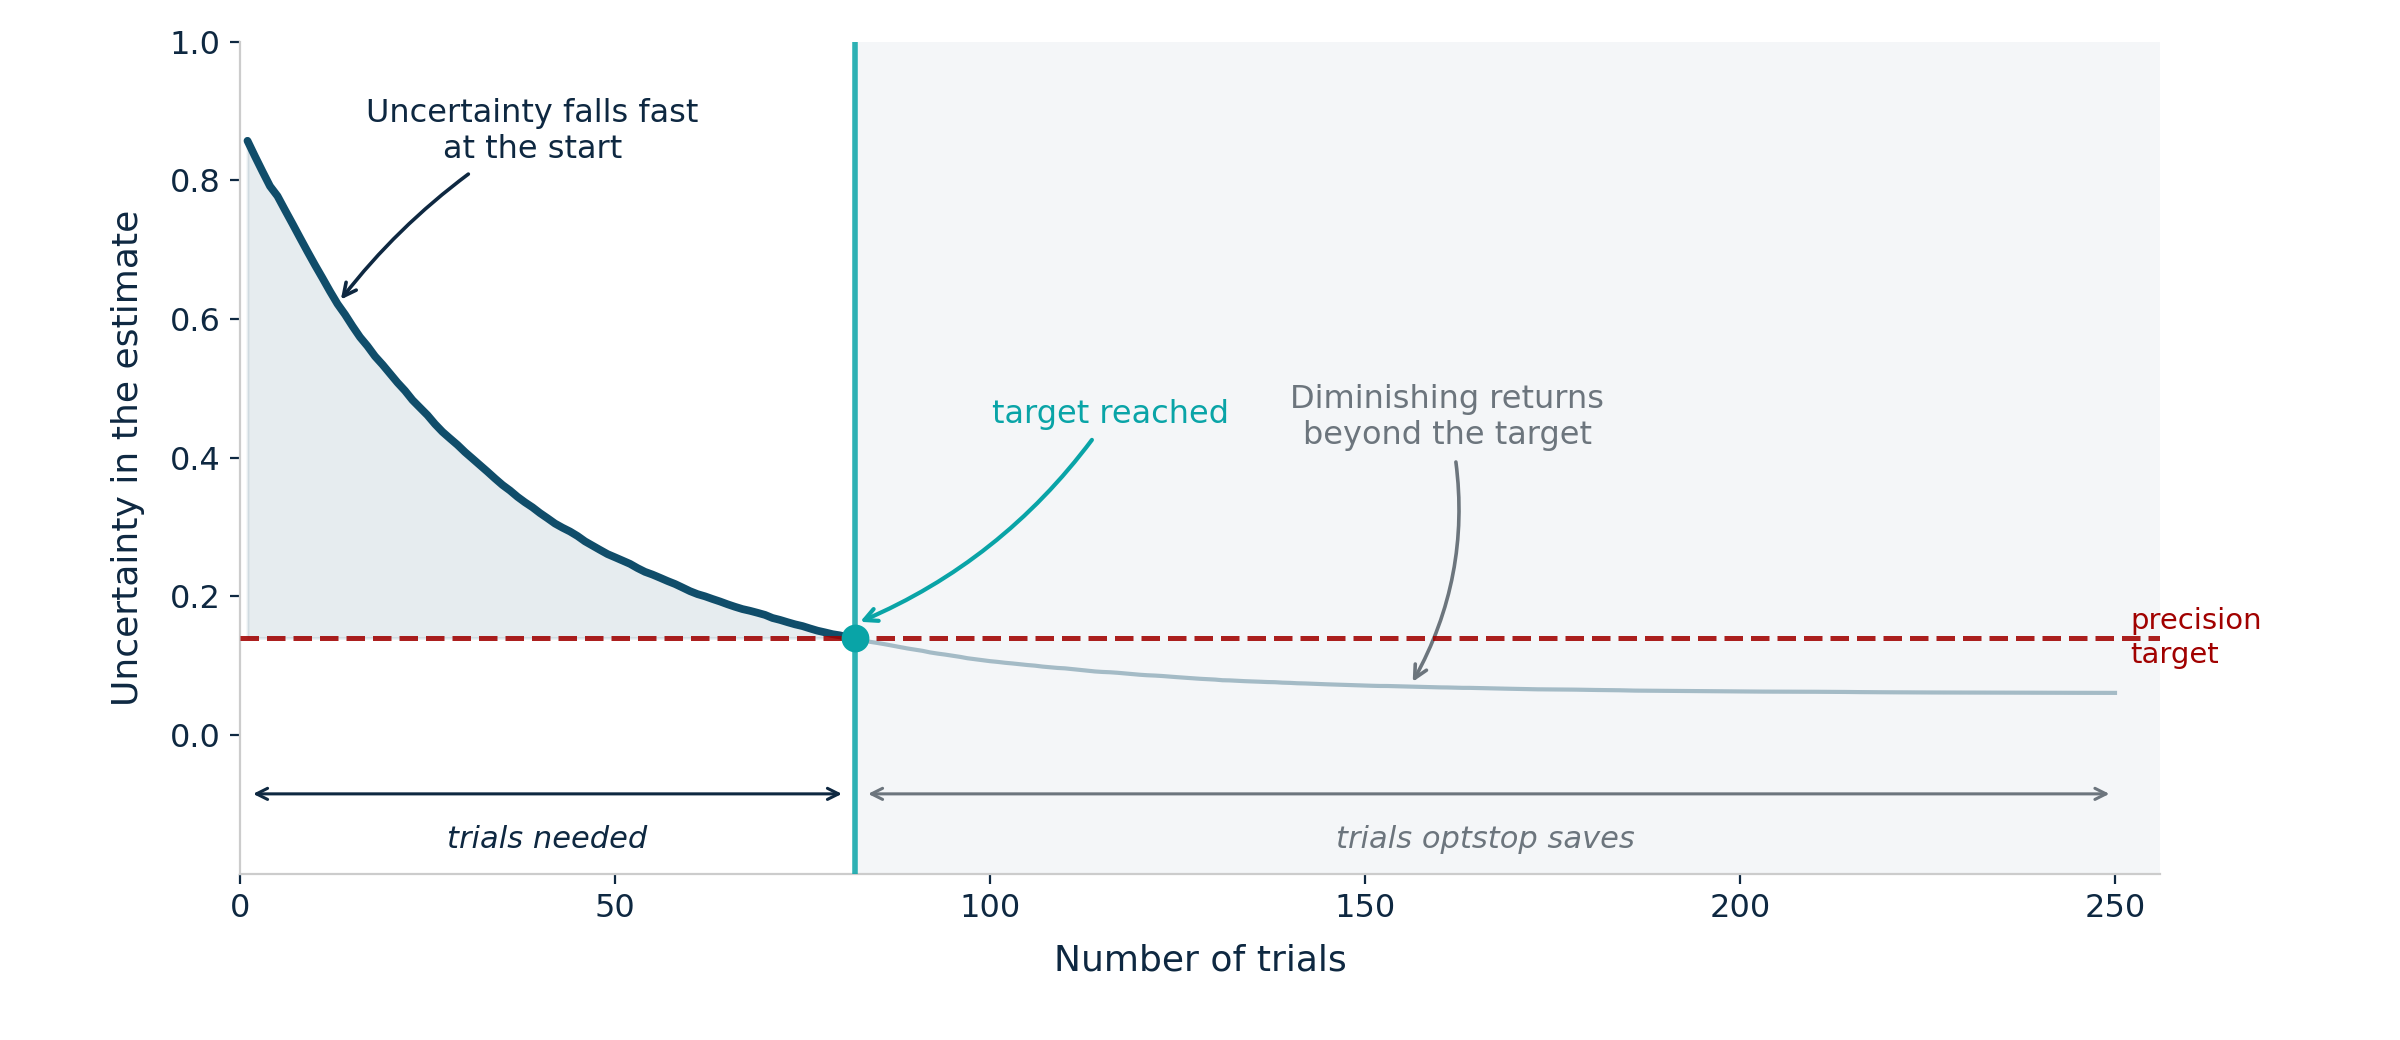
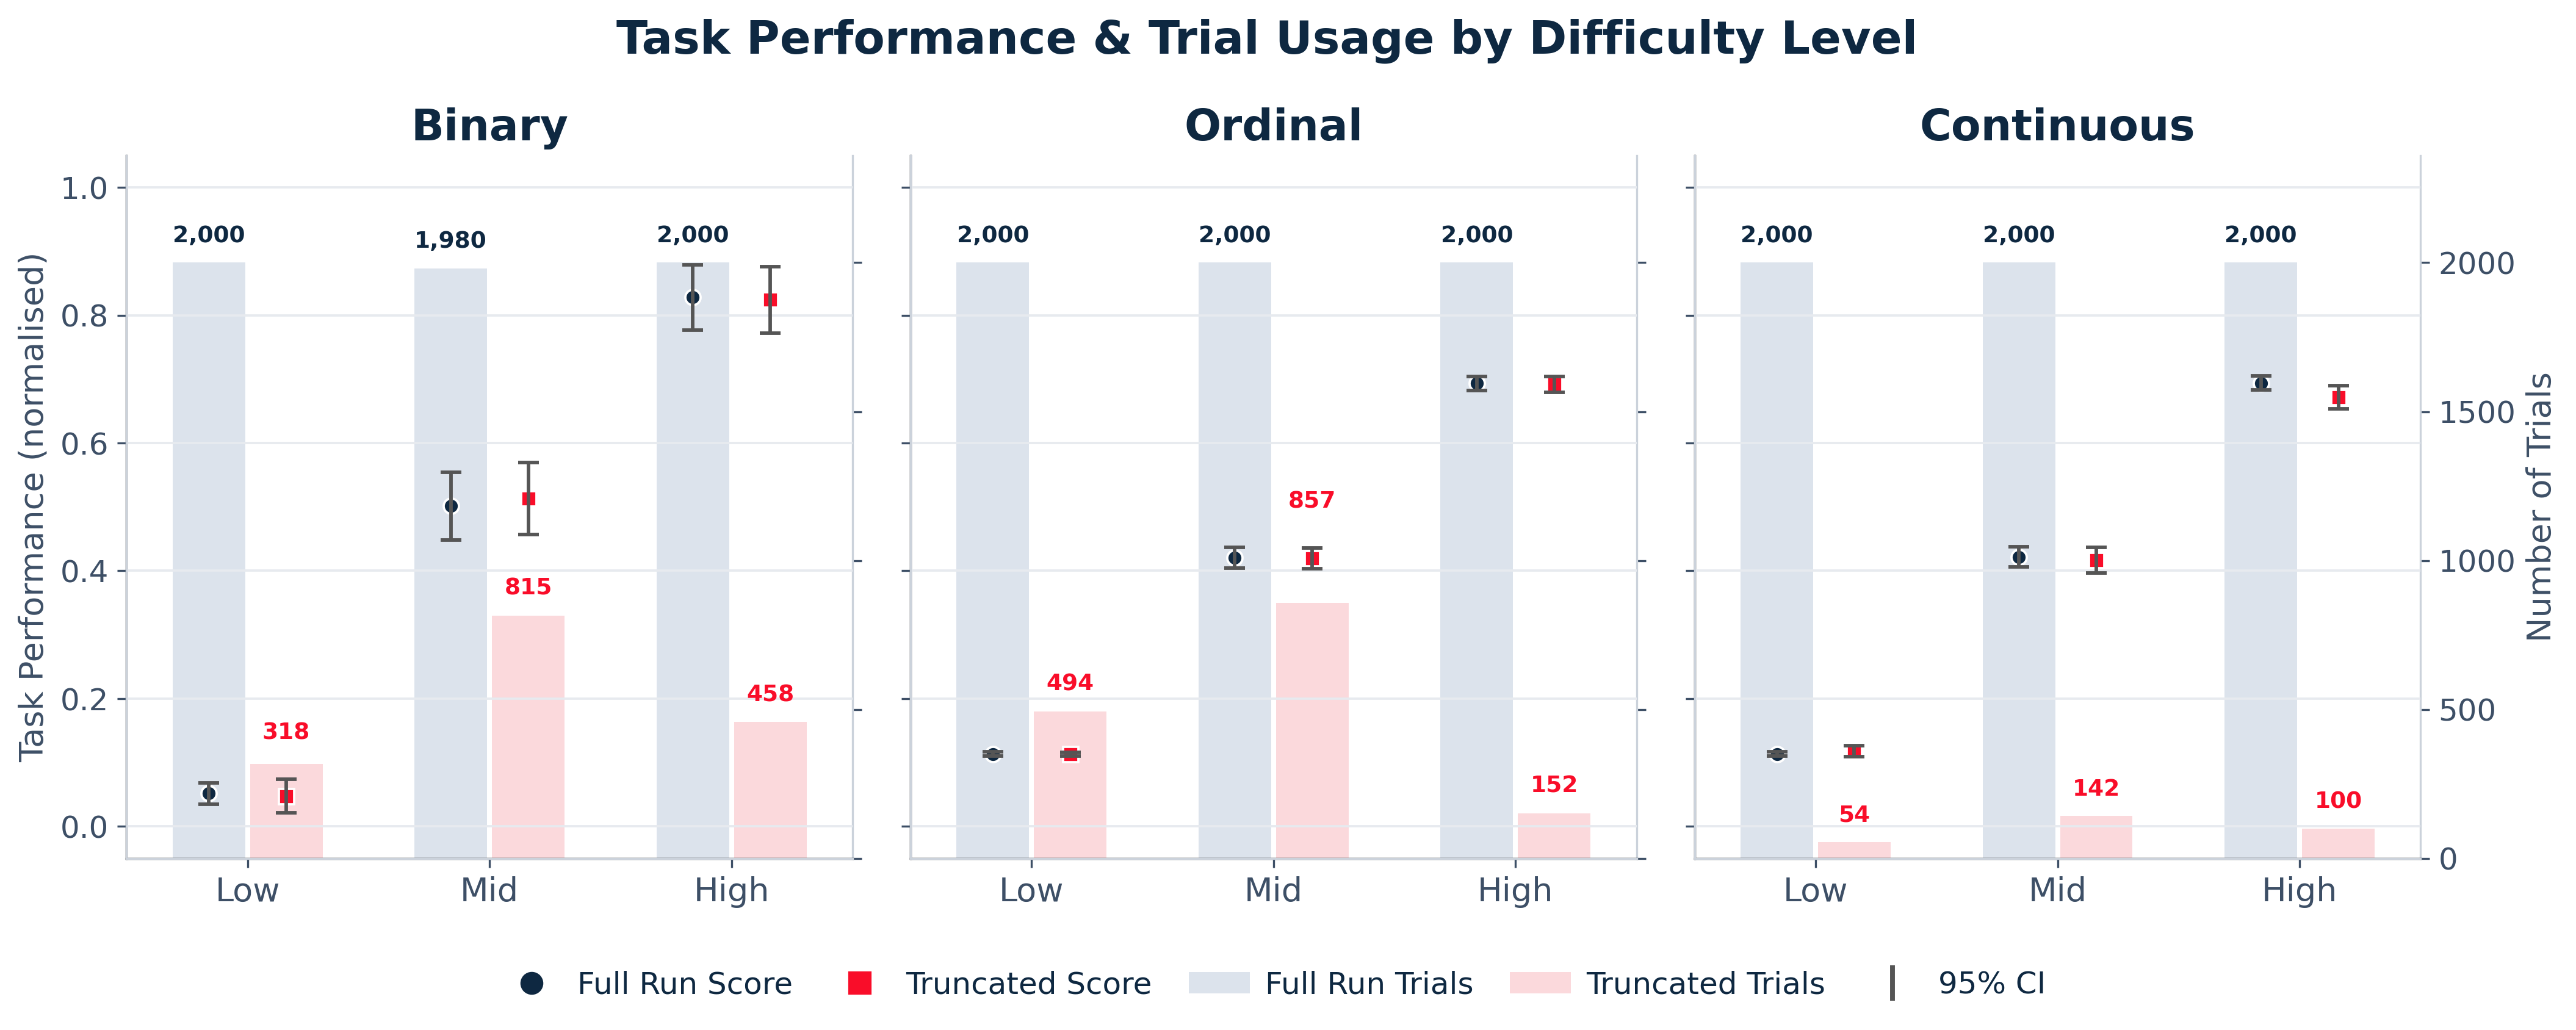
英国AI安全研究所(AISI)开发并开源了Python包optstop,用于在模型评估中动态停止计算,当性能估计足够精确时提前终止,从而节省57%至97%的计算资源。该方法解决了固定预算评估低估智能体能力的问题,提高了评估效率。
Mojo 编程语言于 2023 年 5 月承诺开源,上周发布 1.0 版本后,本周兑现承诺,将编译器和工具链以 Apache 2 许可证开源。Mojo 最初目标是成为 Python 的超集,但 2025 年 8 月调整方向,不再强求完全兼容 Python,而是专注于 GPU 编程,利用 AI 辅助编码工具帮助迁移。